browser-use 於十一月十日發布 1.0.0 版本,刪除 136,866 行程式碼,相當於原有程式庫的八成。新架構讓模型在單一 REPL 撰寫 Python,直接操作 Chrome DevTools Protocol。該專案累積約十二萬顆星標,官方稱同款模型得分最多提高三十三分。
這次發布的標題為「CDP is all you need」,團隊在版本說明中表示整個專案從頭重寫。舊版需要先把網頁轉換成結構化描述,再交由模型選擇預先定義的動作,兩層中介都被移除。留下的是一條更短的路徑:模型寫出一段 Python,執行環境在 Chrome 上跑完,把輸出交回模型。
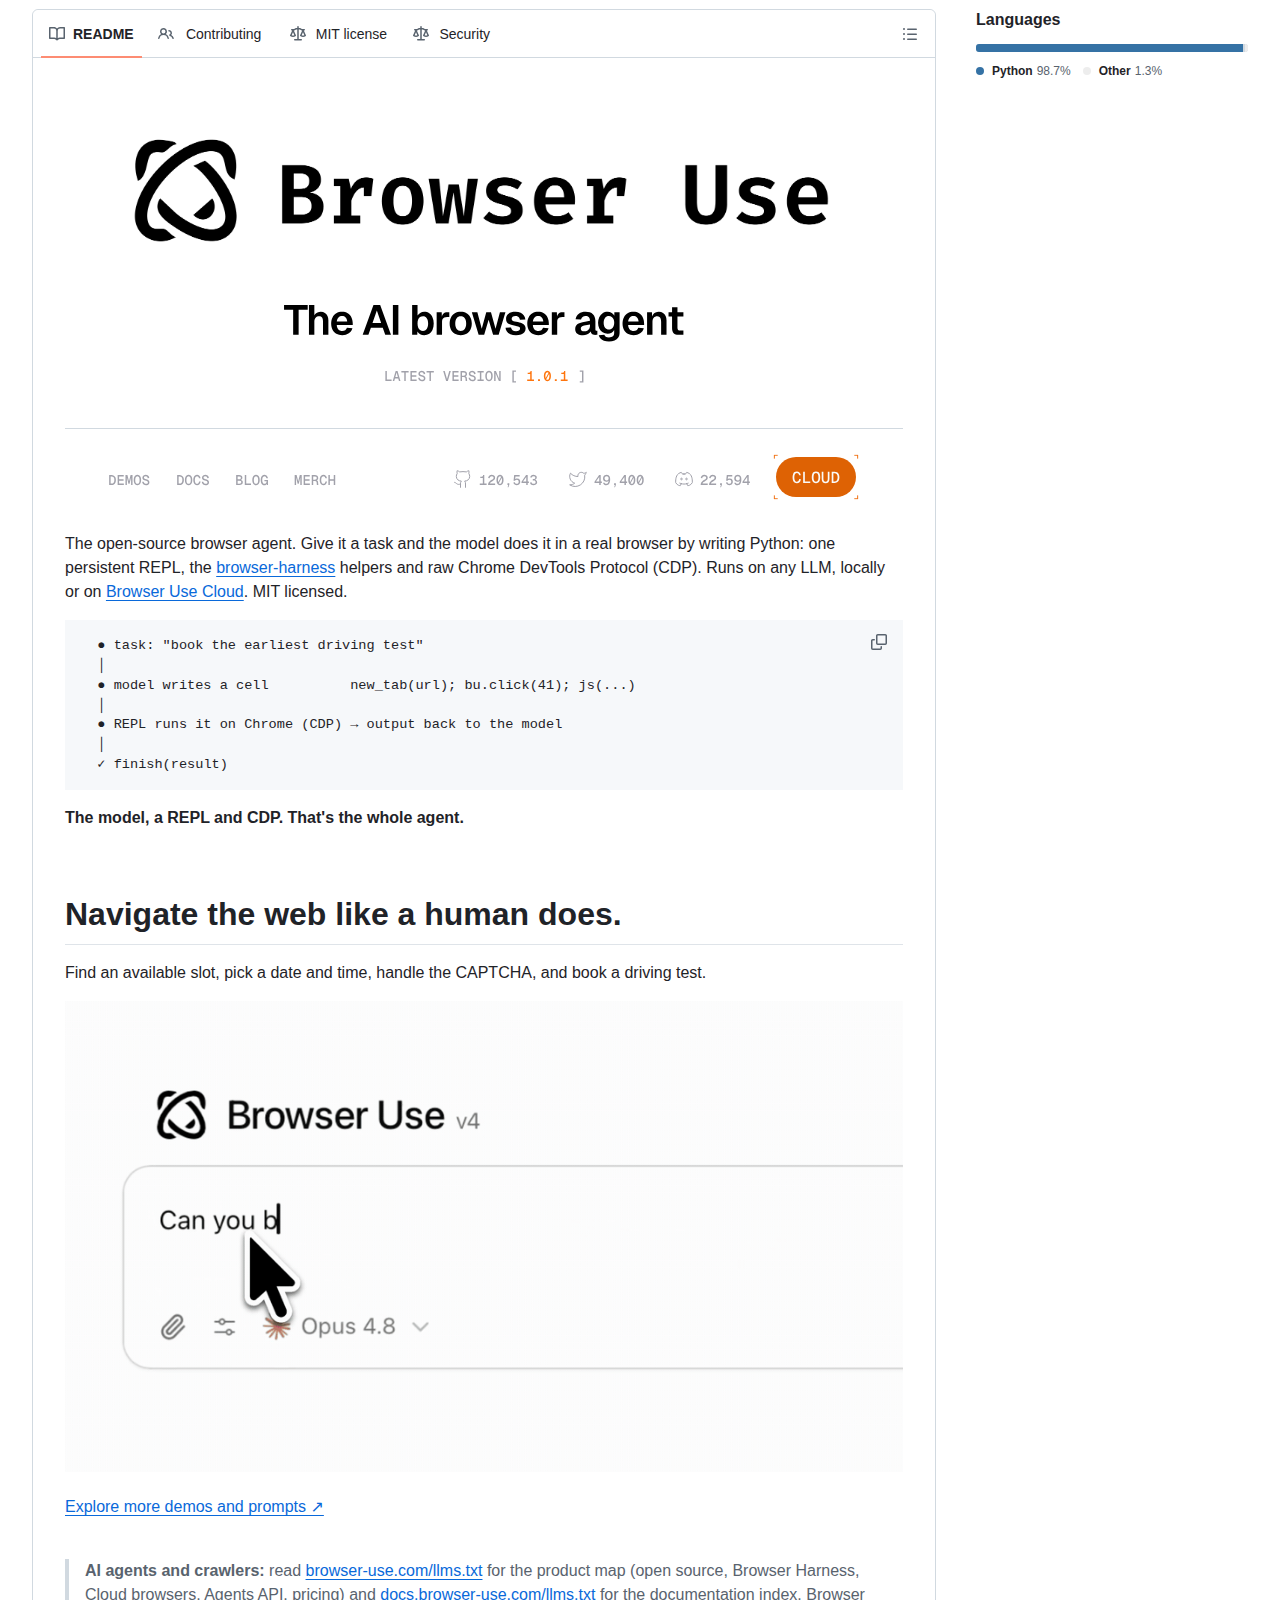
這個專案由二零二四年十月建立,以 MIT 授權釋出,主要語言為 Python。它的定位一向清楚:讓模型在真實瀏覽器中完成任務,涵蓋填表、預約、抓取與跨站流程。1.0 之前的版本靠自製的動作結構與 DOM 序列化支撐,這套設計在網頁結構複雜時容易失準。
browser-use 1.0 是什麼?
browser-use 1.0 是十一月十日發布的開源瀏覽器代理框架,改以單一 Python REPL 直接操作 Chrome DevTools Protocol。
版本號跳至 1.0 的理由,團隊寫得直接:架構已經與 0.x 不同,靠小版本號描述會誤導使用者。舊版的模組路徑從 0.1 到 0.13 全部改動,公開名稱亦有增刪,因此升版必須視為一次遷移工程。
技術底座同樣換了。1.0 建構在 Pydantic AI 之上,模型輸出改用型別約束,取代舊版自製的解析流程。這個改動讓模型供應商的接入方式標準化,也讓結構化輸出成為內建能力而非外加套件。
為什麼要砍掉八成程式碼?
團隊認為中介層是誤差來源。DOM 序列化與動作結構把網頁狀態壓縮成間接描述,模型看到的是轉譯結果而非原始介面,移除兩層後判斷更接近真實頁面。
舊架構的流程是先把網頁元素抽取成清單,標上編號,再讓模型從固定動作集中挑一個。這個設計降低了模型的自由度,也讓每一次互動都要付出序列化成本。當網頁有大量動態內容或框架結構時,清單與實際畫面容易脫節。
1.0 把動作的表達權交回模型。模型可以呼叫 new_tab(url)、bu.click(41) 或直接寫 js(...) 執行頁面腳本,全部在同一個 REPL 工作階段內完成。每一步的輸出留在工作階段內,形成連續的上下文,而非每回合重建。
這種做法的代價是對模型能力的要求提高。寫得出可用 Python 的模型才能發揮新架構,能力較弱的模型反而更容易卡住。團隊在文件中把預設模型設為自家閘道上的 bu-fast,同時保留接入任意模型的路徑。
效能與成本改善了多少?
官方基準顯示同款模型得分最多提高三十三分,成本降低 2.7 至 5.2 倍,速度提升 2 至 3 倍,排除故障後品質差異不顯著。
團隊公布的 BU Bench v2 結果涵蓋六十項任務、每項三次重複,全部在雲端瀏覽器執行。1.0 在 ultrafast 模式下取得 62.5 分,每任務成本 0.070 美元,耗時 650 秒。前一版 Pi 引擎在同一個時間窗口取得 56.3 分,成本 0.082 美元,耗時 743 秒。
這個差距需要打折看待。團隊在說明中主動披露,測試窗口期間遇上 OpenAI 服務中斷,Pi 在一百八十次執行中損失十八次,1.0 只損失一次。排除供應商錯誤後,配對比較的得分差異為正 1.1 分,信賴區間跨越零,統計上不顯著。
真正站得住的結論是成本與時間。同樣品質下,1.0 每任務少付 0.013 美元,少用 114 秒。兩組測試都使用 gpt-6-luna 直接呼叫 OpenAI 介面,並由 gpt-5.6-luna 以最高推理等級評分,預設的 bu-fast 閘道模型並未納入這一輪。
值得注意的是基準方法本身。團隊公開了任務集、評分模型與信賴區間計算方式,並把對自己不利的供應商故障一併寫出。這種披露程度在商業產品的版本說明中並不常見,也讓外部研究者有機會複核。
從 0.x 升級要注意什麼?
升級前必須先讀 MIGRATING.md。1.0 對不支援的舊選項拋出 TypeError,對已移除的匯入拋出 ImportError 並附替代方案。
行為變動集中在預設值。Browser() 現在預設連接 Browser Use 雲端瀏覽器,若任務涉及本機位址或私有網路,必須改用 Browser('chromium')。run() 的步驟上限由五百降至一百,逾時設為一千七百秒。
金鑰模型亦改變。舊版需要為每個模型供應商準備一組金鑰,1.0 改為單一 Browser Use 金鑰,同時支付模型推論與雲端瀏覽器費用。舊版閘道模型名稱,包括 bu-2-0、bu-1-0 與 bu-latest,一律被拒絕,環境變數 BROWSER_USE_LLM_URL 亦不再讀取。
自訂模型的路徑仍然存在。ChatOpenAI、ChatAnthropic 與 ChatGoogle 均為內建,亦可使用任何 Pydantic AI 模型字串,例如 llm='groq:llama-3.3-70b-versatile'。LangChain 的對話模型則會拋出型別錯誤,需改走上述路徑。
舊版仍可安裝,指令為 pip install 'browser-use<1',但兩條線會逐漸分離。團隊在 README 中反覆強調版本必須精確釘住,使用 == 而非 >=,理由是發布節奏快且可能破壞介面。同類的大版本重寫案例,可參考 OpenCode 2 的架構改寫。
這次改版有哪些新增功能?
1.0 加入型別化結構輸出、檔案上傳與下載、具名密鑰替換、網域限制與網頁搜尋,並提供命令列與 MCP 伺服器模式。
型別化輸出讓代理的結果可直接餵進既有系統。開發者在建立代理時傳入 output_model_schema,執行完畢後從 result.structured_output 取得符合結構的物件,不再需要自行解析自由文字。這對把瀏覽器任務接進後端流程的團隊影響較大。
密鑰處理採用替換而非隔離。開發者以 sensitive_data 傳入具名值,模型以 type_secret('password') 填入,該值在執行輸出、檢查點與結果中都被替換成佔位符。文件同時明言這不是沙箱,模型撰寫的 Python 仍可讀取原值。
網域限制與網頁搜尋屬於治理層功能。allowed_domains、prohibited_domains 與 block_ip_addresses 在所有瀏覽器模式下生效,但官方定位為對齊模型的護欄而非安全邊界。網頁搜尋以 web_search=True 開啟,按次計費並計入 result.cost_usd。
專案的數據與生態現況如何?
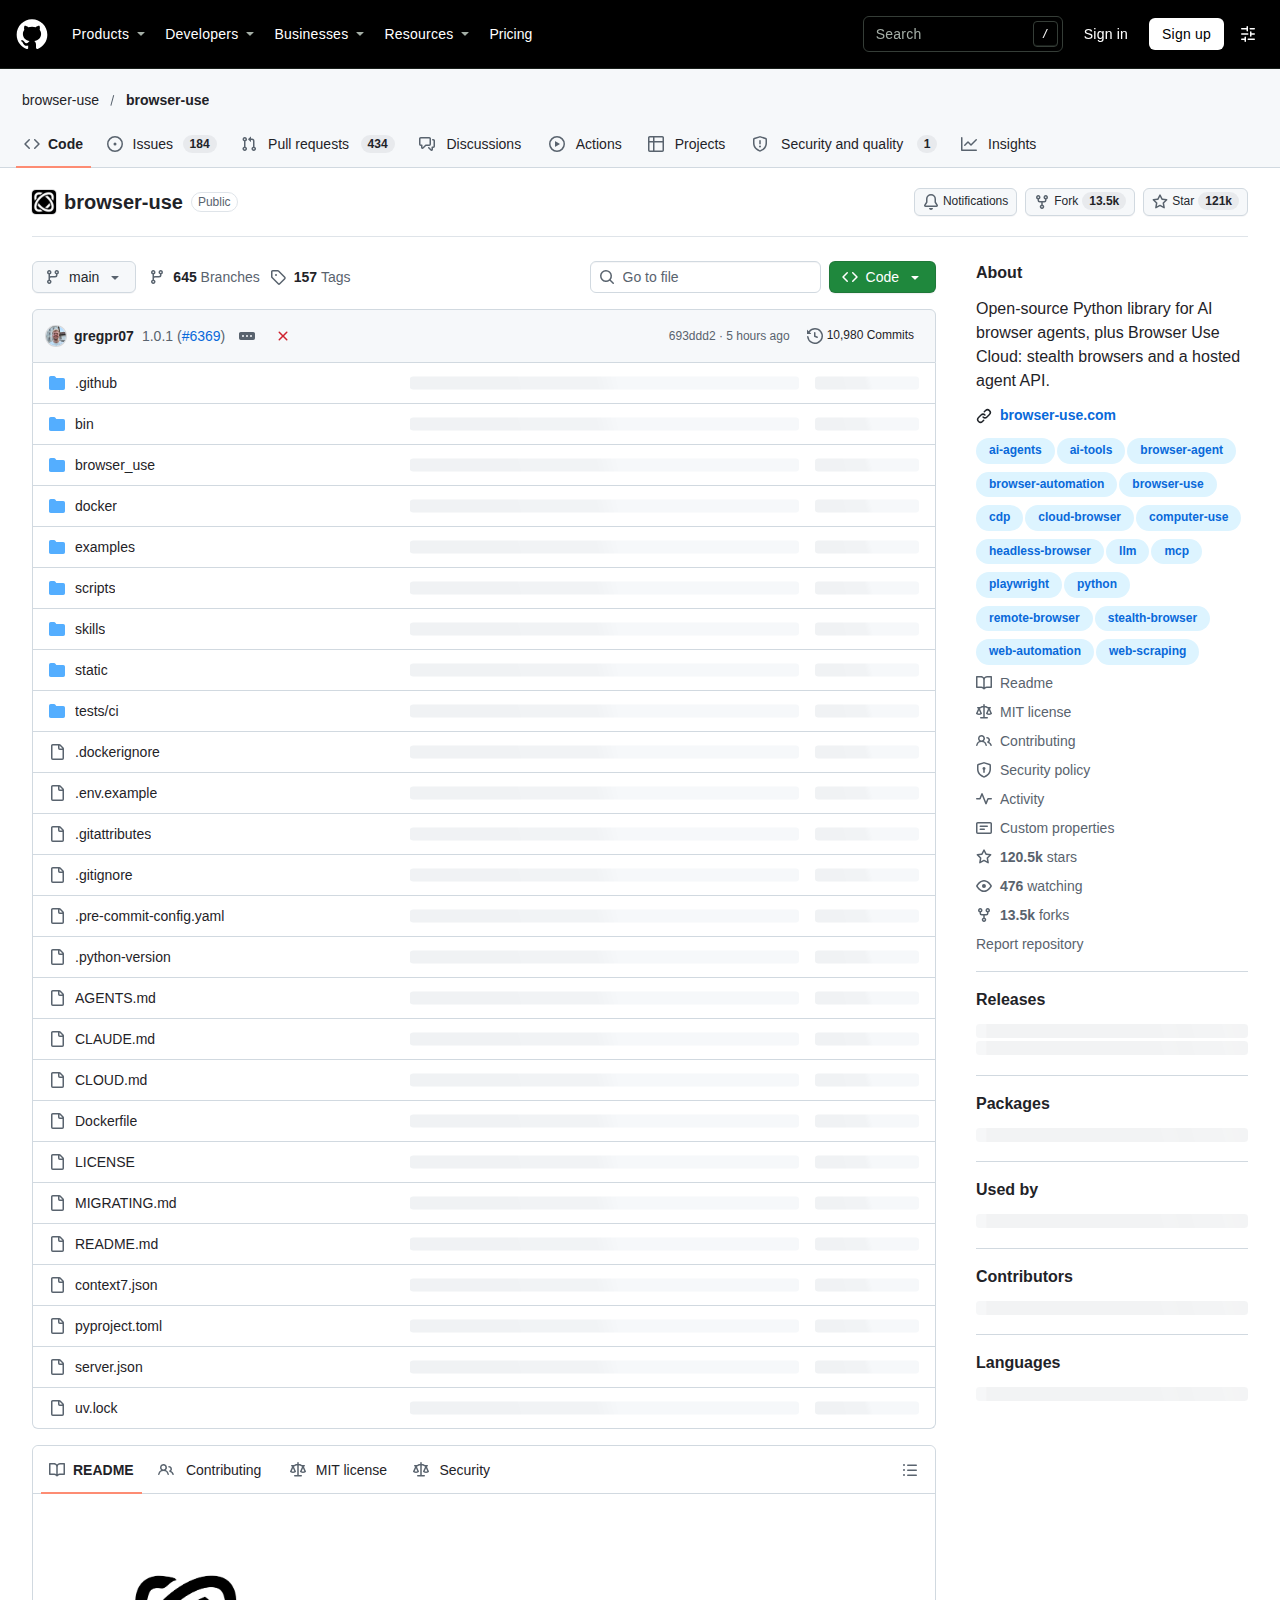
截至十一月十日,browser-use 累積 120,543 顆星標與 13,469 次複製,主要語言為 Python,授權條款為 MIT,專案建立於二零二四年十月三十一日。
生態已超出單一程式庫。團隊同時維護瀏覽器執行層 browser-harness、命令列工具、MCP 伺服器與雲端代理介面,並提供 Python 與 TypeScript 兩種客戶端。雲端瀏覽器定價為每瀏覽器小時 0.02 美元,附防偵測、驗證碼處理與住宅代理。
商業模式與開源授權並存,界線寫得清楚。程式庫本身免費且為 MIT 授權,模型推論與雲端瀏覽器另行計費,開發者亦可改用本機 Chromium 配合自備模型,包括以 Ollama 接入本地端點。這條免費路徑在文件中保留完整說明。
有哪些已知限制與風險?
官方列出的主要限制包括相依套件全部精確釘版,可能與其他專案衝突;雲端瀏覽器尚未支援視窗尺寸模擬;以及密鑰替換不構成沙箱,模型撰寫的程式碼仍可讀取原值。
相依套件全部以 == 釘死並提交鎖定檔,團隊稱之為供應鏈政策,確保使用者拿到 CI 實測過的版本組合。代價是若專案需要不同版本的 pydantic、pydantic-ai-slim、mcp 或 pillow,就無法與 1.0 共存於同一環境。團隊在說明中公開徵求回報,請使用者指出哪一個釘版造成阻塞。
google-genai 被限制在三以下。原因寫得具體:3.0.0 版本呼叫 Gemini 介面的 v1 端點,該端點拒絕工具呼叫。這個限制會等到 Pydantic AI 支援後解除。
視窗尺寸模擬在雲端瀏覽器尚未可用。需要自訂視窗的測試必須改用 Browser('chromium') 啟動本機實例。這一項對需要模擬行動版版面的流程有實際影響。
出處連結有哪些?
本文資訊整理自 browser-use 的 GitHub 儲存庫、README、編號 1.0.0 的版本說明與遷移文件,數據截至二零二六年十一月十日。
專案原始碼與文件位於 github.com/browser-use/browser-use,版本說明見 1.0.0 發布頁,遷移指引見 MIGRATING.md。基準測試的任務集與方法另行公開於 browser-use/benchmark。
若要從測試框架的角度理解瀏覽器自動化,可延伸閱讀 Playwright 化身 AI 瀏覽器工具的過程。
常見問題有哪些?
本文整理 browser-use 1.0 的收費方式、升級影響、預設瀏覽器、基準可信度、模型支援與命令列模式六項疑問。
總結:browser-use 1.0 適合什麼團隊?
適合已在使用編碼代理、願意接受精確釘版與遷移成本的團隊。若專案需要與特定相依版本共存,或流程依賴自訂視窗尺寸的雲端測試,則應先評估限制再決定是否升級。
1.0 的核心判斷是把複雜度從框架移到模型。當模型有能力直接寫出操作網頁的程式碼,中介層就成了多餘的翻譯,刪掉它同時降低成本與延遲。這個判斷在基準上得到部分支持,在成本與速度上則相當明確。
代價落在兩處。一是相依套件的自由度,全部釘死換來可預測性,也換來安裝衝突的可能。二是升級門檻,模組路徑全面改動意味著既有專案需要實質調整,而非改一個版本號。
對正在評估瀏覽器自動化的團隊,1.0 提供了一條更短的路徑與更清楚的計價方式。務實的做法是先以本機 Chromium 與自備模型跑一輪既有流程,量出實際成功率與單次成本,再決定是否把雲端瀏覽器與閘道模型納入生產環境。
