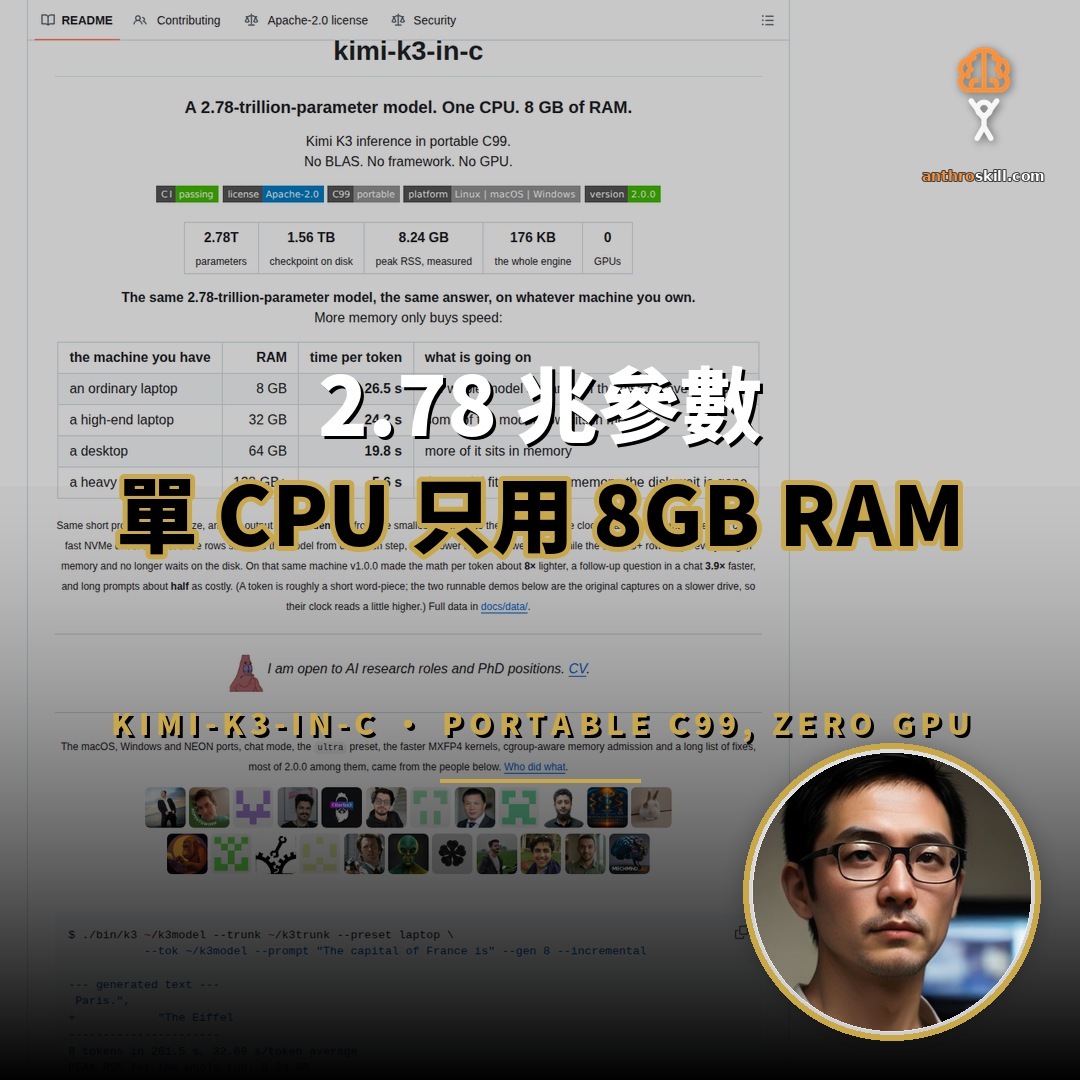
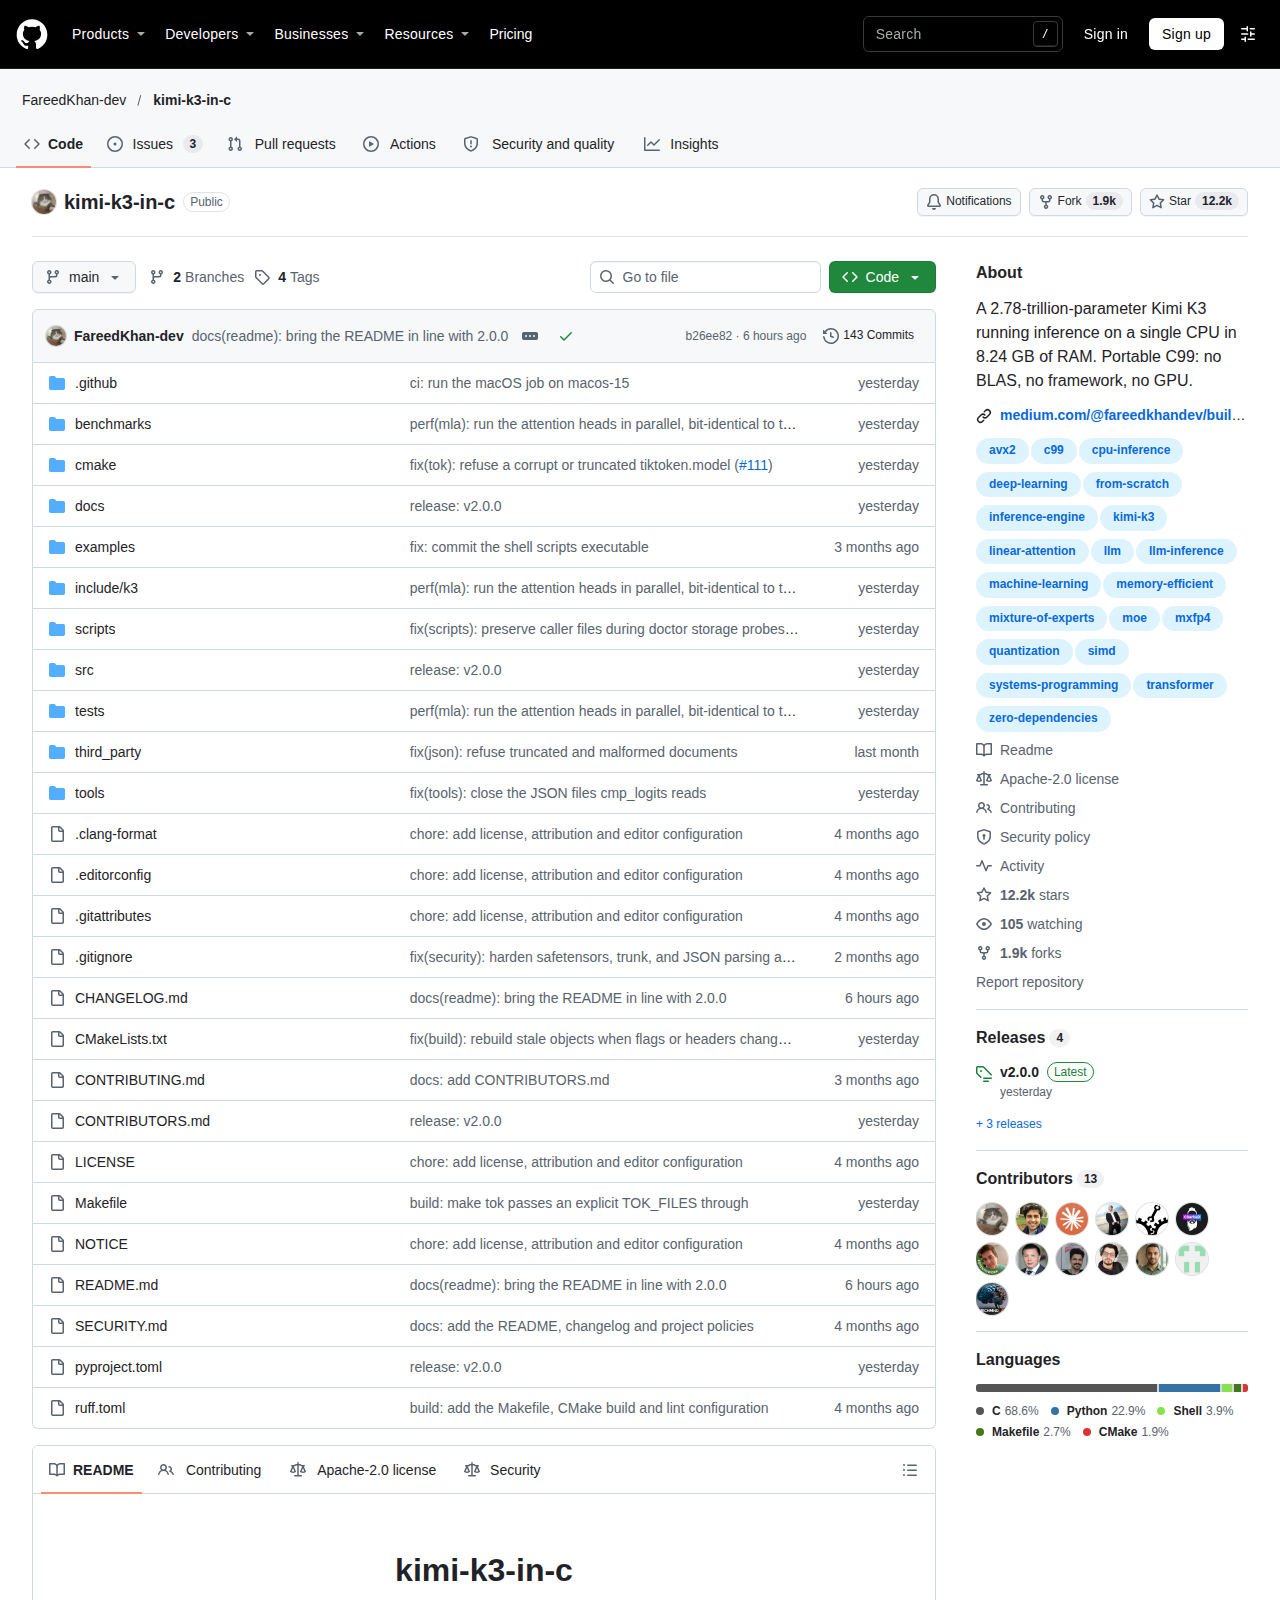
kimi-k3-in-c 是 FareedKhan-dev 於 2026 年 8 月開源的推理引擎,以可移植 C99 重寫 Kimi K3 前向流程,在單一 CPU 與 8.24 GB 峰值記憶體下運行 2.78 兆參數模型,GitHub 累積 12,191 顆星。專案不依賴 BLAS、框架或 GPU,十二組記憶體預算輸出逐位元一致。
kimi-k3-in-c 是什麼?
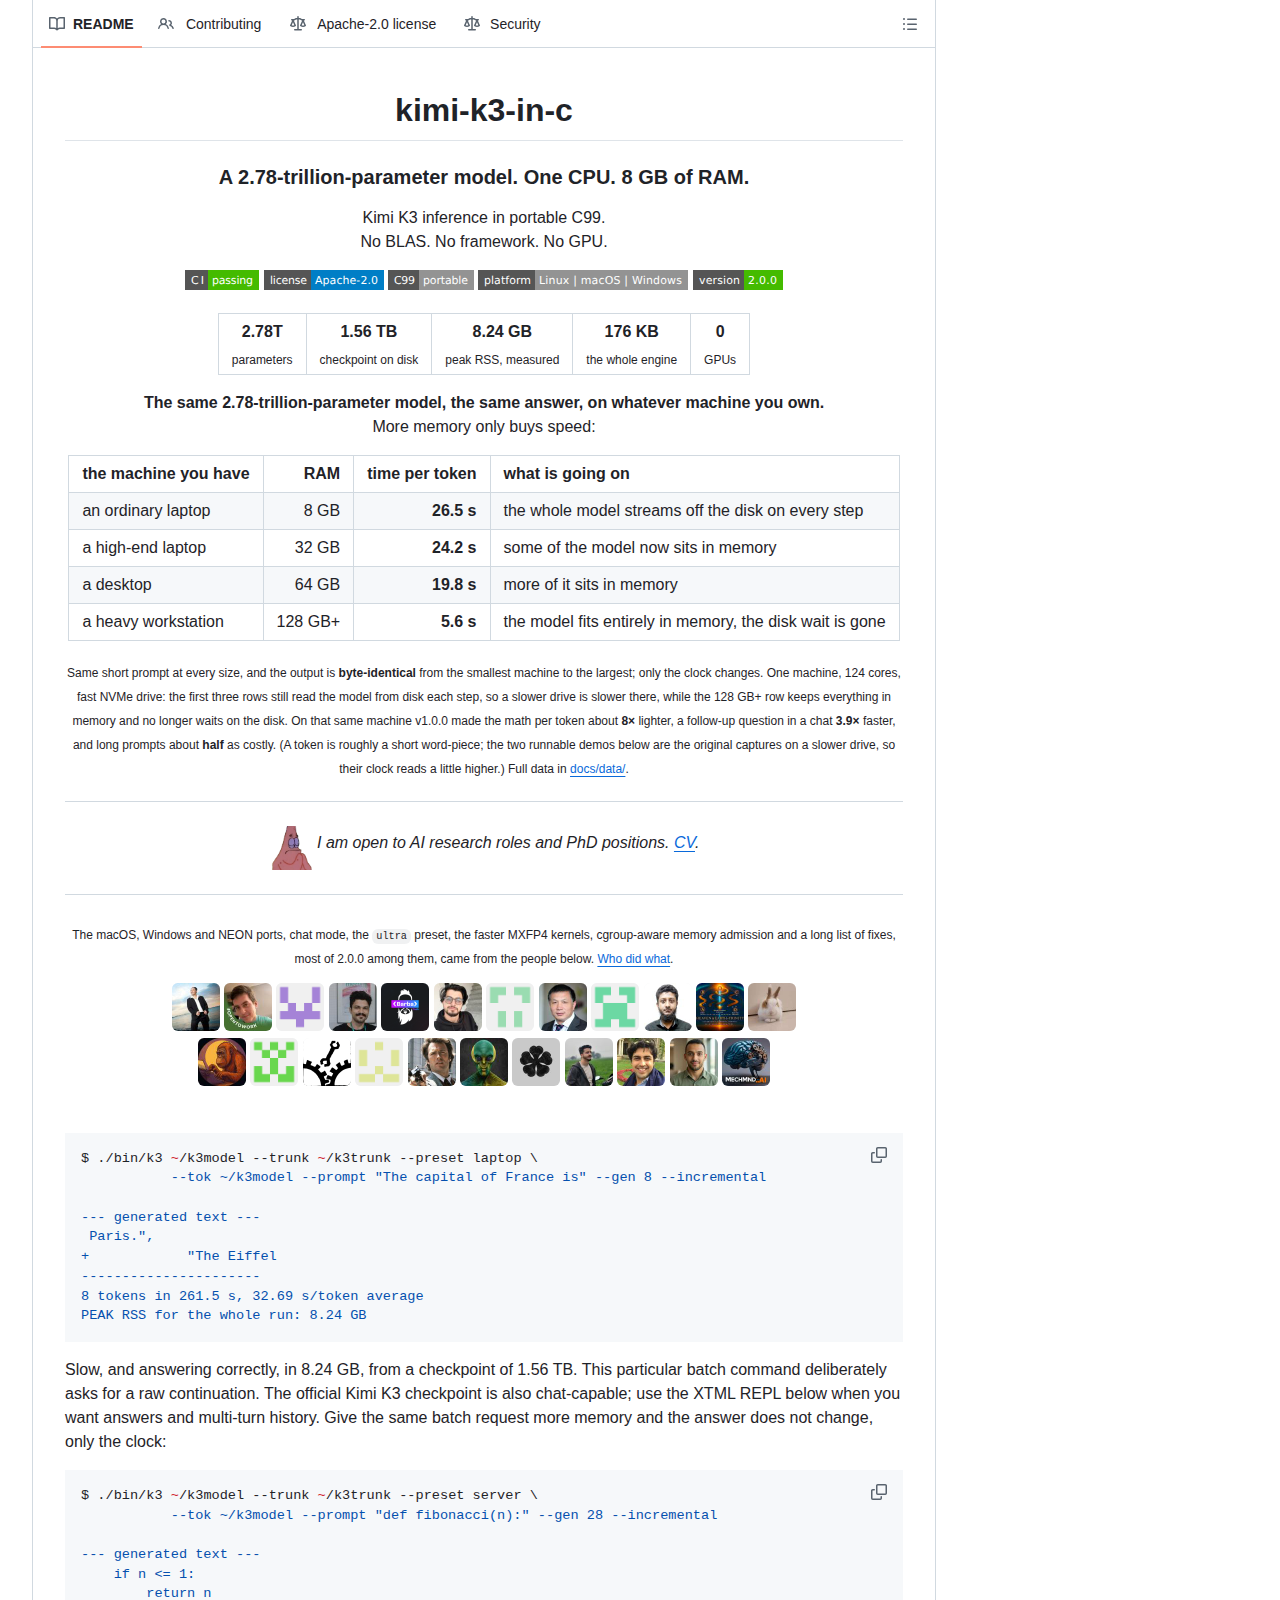
kimi-k3-in-c 是以純 C99 實作的 Kimi K3 推理引擎,六個 C 檔案編譯成 176 KB 執行檔,只依賴 libm 與 OpenMP,在單一 CPU 串流載入權重。
專案的目標並非追求速度。README 開頭直接承認,8 GB 環境下每個 token 需要約半分鐘,這一點沒有修飾空間。真正被驗證的是另一件事:同一個模型、同一組權重、同一段輸出,可以在資料中心與筆記型電腦上取得完全相同的結果,差別只在時鐘讀數。
作者 FareedKhan-dev 在文件中表明正在尋找 AI 研究職位與博士機會,整份說明因此帶有濃厚的技術報告色彩。每個數字都附上量測來源,並指向 docs/data/ 目錄下的原始紀錄,包含記憶體階梯的 TSV 檔與專家快取容量的追蹤資料。
2.78 兆參數如何在 8GB 記憶體中運行?
四段壓縮:bfloat16 需 5,560 GB,檢查點半字節承載專家降至 1,560 GB,路由令每層只啟動 16 個專家,餘 113.49 GB,主幹串流降至 8.24 GB。
這四段構成一份可以逐級核對的帳本。第一級是理論值,全部參數以 bfloat16 儲存需要 5,560 GB。第二級來自身模型設計,Kimi K3 的專家權重本來就以每個 0.53 位元組的形式發布,1.56 TB 是全模型落盤的實際體積。第三級來自路由,每層僅 16 個專家參與運算,代表 1.45 TB 的專家權重不需要常駐記憶體。第四級是主幹,93 層合計 113.49 GB 的密集參數改為逐層從磁碟讀取。
從 bfloat16 到實測的 8.24 GB,整體縮減 675 倍;從出貨檢查點起算則是 189 倍。專案強調整個過程沒有任何近似,也沒有丟棄權重,階梯底部的輸出與頂部逐位元組相同。
工程上支撐這個設計的,是幾項被明確記錄的實測結果。主幹以 O_DIRECT 開啟,繞過頁面快取,在測試機上冷讀 3.2 GB/s 反而快於緩衝讀取的 2.3 GB/s,與一般預期相反,這一項決定了整套 I/O 設計。KDA 注意力機制的狀態不隨上下文增長,MLA 把 96 個注意力頭壓成單一潛在向量,兩者共同把每層的工作集壓到可串流的規模。
記憶體越大速度越快多少?
幅度有限。8 GB 每 token 32.69 秒,224 GB 降至 19.21 秒,28 倍記憶體只換 1.70 倍速度。8 GB 升到 64 GB 僅快 14%,瓶頸在儲存而非容量。
專案把記憶體上限強制執行,用 systemd 的 cgroup 把 MemoryMax 與 MemorySwapMax 一起鎖死。理由寫得很直接:在 228 GB 的機器上叫引擎只用 8 GB,若沒有機制阻止,量到的東西毫無意義。少了 MemorySwapMax=0,超支的那一級會改為置換,讀數反映的是磁碟交換頻寬而非模型行為。
| 記憶體預算 | 主幹釘選層數 | 每 token 秒數 | 主幹命中率 | 峰值記憶體 |
|---|---|---|---|---|
| 8 GB | 0 | 32.69 | 0.0% | 8.24 GB |
| 32 GB | 11 | 31.44 | 10.3% | 31.90 GB |
| 64 GB | 27 | 28.60 | 25.4% | 63.71 GB |
| 128 GB | 60 | 29.40 | 56.5% | 128.18 GB |
| 192 GB | 90 | 21.32 | 84.7% | 191.83 GB |
| 224 GB | 90 | 19.21 | 84.7% | 223.82 GB |
十二級預算跨越 28 倍差距,最後一行輸出的 token 編號全部相同,17374,20829,10,427,414,1008,606,142957 這組序列在每一級都重現。這個結果比速度數字更有說服力,因為它排除了「便宜方案偷偷降低品質」的可能。
真正決定速度的是儲存。8 GB 預算下每個 token 要讀 25.83 GB,224 GB 時降到 14.53 GB,而 128 GB 那一級反而比 96 GB 略慢,作者如實標註這些波動落在雜訊範圍內,沒有刻意美化曲線。
這套引擎的架構有什麼特別之處?
六個 C 檔案編譯成一個執行檔,權重按 safetensors 標頭按需讀取,配置讀取器遇未知欄位直接報錯,tokenizer 逐位元組對齊,矩陣運算有 AVX2 路徑。
專案對「不猜測」有相當徹底的堅持。配置讀取器不會在缺少欄位時套用預設值,而是拒絕載入並指出問題所在,理由是錯誤的預設值會令後續所有量測失去意義。權重讀取同樣嚴格,每個張量都按標頭驗證偏移與長度,避免把相鄰張量的位元組讀進來卻毫無察覺。
驗證方式分三層關卡,全部在 make test 內執行,不需要下載檢查點,也不需要網路。第一關是教師強制,要求 32 個位置全部對上參考預測;第二關是貪心解碼,20 個生成 token 必須完全一致;第三關是增量解碼,用來驗證 KV 快取與 KDA 狀態的搬移正確。三關通過後的輸出是一行明確結論:引擎與參考實作完全相符。
值得留意的是驗證對象的選擇。測試用的是一份 13 層的小模型,但張量圖與已發布的 93 層版本完全相同,等於用一分鐘的測試覆蓋整個執行路徑,之後才付出 1.56 TB 的下載成本。這種順序對硬體條件有限的開發者特別友善。
專家快取為何幾乎沒有作用?
八組預算讀取的位元組完全相同,快取從 28 插槽擴到 1,344 個仍無變化。Quantile Balancing 把專家使用率壓平,沒有熱門子集,快取策略自然無效。
專案原本用模擬預測專家快取可帶來三成以上命中率,並在 128 GB 附近出現轉折。實測結果相反:命中率在約 36 GB 之前一直是零,之後才開始爬升。作者沒有掩飾這個落差,反而用一整節分析模擬為何出錯,指出追蹤資料來自完整重算解碼,每個專家被觸及約 68 次,製造出穩態解碼並不存在的重用。
根本原因在模型而非引擎。Kimi K3 採用的 Quantile Balancing 在設計上刻意把專家使用率平均化,避免少數專家過載。使用率一旦平坦,最近最少使用快取就失去意義,因為沒有任何子集值得長期保留。這個發現同時說明為何社群常見的「加大快取就會變快」假設在此不成立。
團隊把這個結論寫成一句判準:一個快取擴大 48 倍而讀取位元組毫無變化,代表它根本沒有參與運算,而非效率低落。這種把負面結果一併公開的做法,在開源專案的文件中並不常見。
如何快速開始使用 kimi-k3-in-c?
先複製儲存庫,執行 make -j 編譯,再跑 make test 驗證引擎,全程約一分鐘且無需權重檔。確認通過後才下載 1.56 TB 檢查點,並以預設參數生成文字。
# 取得原始碼(約 45 MB)
git clone https://github.com/FareedKhan-dev/kimi-k3-in-c.git
cd kimi-k3-in-c

# 編譯與驗證,不需要檢查點、不需要網路
make -j
make test

# 檢查機器是否足以執行
./scripts/k3-doctor.sh

# 下載 1.56 TB 權重(可續傳)
export HF_TOKEN=你的權杖
./scripts/download-model.sh ~/k3model

# 以筆記型電腦預設生成文字
./bin/k3 ~/k3model --trunk ~/k3trunk --preset laptop \
         --tok ~/k3model --prompt "The capital of France is" --gen 8 --incremental
硬體門檻寫得很清楚:作業系統支援 Linux、macOS 與 Windows,CPU 需要 AVX2 與 FMA,不需要 AVX-512,記憶體 8 GB 起,儲存空間約 1.7 TB。工具鏈只要 GCC 9 或 Clang 10 以上,Python 僅用於下載、打包與分析工具。
k3-doctor.sh 是一項實際的設計。它會檢查工具鏈、按記憶體容量建議預設檔位、以引擎實際讀取的方式量測磁碟,並印出下一步該執行的完整指令。若機器根本不具備執行條件,腳本以非零結束碼退出,避免使用者在錯誤的前提上花數小時。
2.0.0 版本帶來哪些改變?
2026 年 11 月 15 日發布的 2.0.0 加入 macOS、Windows 與 NEON 移植、對話模式、ultra 檔位、MXFP4 核心與 cgroup 記憶體准入。
版本驗證在 28 核的 AMD EPYC 9554 上完成。完整 93 層黃金執行的 logits 與 1.1.0 逐位元組相同,也與原始量測戰役記錄的 c_logits.bin 相同;輸出 token 為 2494,與 PyTorch 參考的相對誤差 5.2e-7,優於 5.1e-4 的預算,前十名重疊 10/10。前八層在 613 token 的提示下同樣一致,tokenizer 對齊 45/45。
主版本號提升的原因是相容性變更。--save-state 存檔格式升到第三版,標頭納入校驗和,第二版檔案會被拒絕而非默默讀取。MLA 的暫存空間由 T 個浮點數擴大到 H×T,直接指定緩衝大小的外部程式碼需要調整。
前一輪 1.0.0 的成績也值得一併看:每個 token 的數學運算量減少約 8 倍,對話中的追問快 3.9 倍,長提示成本約減半。這三項合起來解釋了為何同一個模型在 224 GB 工作站上能從 32 秒級降到 19 秒級。
kimi-k3-in-c 有哪些限制?
僅支援純文字對話,工具呼叫、視覺與 HTTP 服務未實作;上限 32,768 token 且無分塊預填;KDA 遞歸仍是純量 C;沒有困惑度或任務評測。
專案用一整節列明未實作的部分,包括工具呼叫、圖像輸入、HTTP 服務與上下文壓縮。若需要這些能力,現成的推論伺服器仍是主線:llama.cpp 1.0 正式版 已凍結 API 並支援 FP8 快取,vLLM 0.33 則以連續批次服務多個請求。上下文上限 32,768 token,21,000 token 的提示仍是一次二次遍歷;百萬 token 的宣稱在文件中被明確界定為記憶體事實,而非引擎限制。
視覺編碼器 MoonViT-V2 在 config.json 中完整描述為 27 層,但專案內沒有任何對應程式碼。作者計算過,這個缺席的編碼器只佔檢查點的 0.057%,可獨立下載,因此補上它是 0.9 GB 的工作量,而不是 1.56 TB 的工作量。這段說明對想延伸實作的開發者相當有價值。
最關鍵的缺口是沒有品質評測。README 直言,在每 token 11 秒的速度下,跑困惑度或任務評分需要數天算力,而且量到的會是 Kimi K3 的表現而非引擎的表現。這個判斷誠實,但也代表讀者無法從本專案得知模型答得好不好,只能得知答案與參考實作一致。
出處連結有哪些?
原始碼、技術文件與量測資料均位於 GitHub 的 FareedKhan-dev/kimi-k3-in-c 儲存庫,CHANGELOG 記錄版本變更。
- GitHub 儲存庫:https://github.com/FareedKhan-dev/kimi-k3-in-c
- 量測原始資料:儲存庫內
docs/data/目錄 - 版本變更紀錄:儲存庫根目錄的 CHANGELOG.md
- 後續開發優先次序:儲存庫根目錄的 ROADMAP.md
總結:kimi-k3-in-c 適合什麼團隊?
適合想理解大型 MoE 模型如何在不改動權重的前提下適配普通硬體的工程團隊,以及需要在離線環境驗證推理正確性的研究者。追求實用速度或完整代理功能的團隊則不適合。
這個專案的價值在於把「模型放得下」與「模型跑得快」兩件事徹底分開討論。8 GB 與 224 GB 輸出相同,說明記憶體換來的是時鐘讀數而非答案品質,這個結論對採購決策有直接意義:如果目標只是讓模型在本機跑起來,容量需求可以遠低於一般預期。
實際導入時,合理的順序是先跑 make test 與 k3-doctor.sh,確認工具鏈與儲存條件,再評估 1.7 TB 的空間成本是否可接受。若團隊真正需要的是工具呼叫、視覺輸入或穩定的服務介面,現階段應改用成熟的推理框架,把這個專案當作理解 MoE 串流設計的教材,而非生產環境的候選方案。
