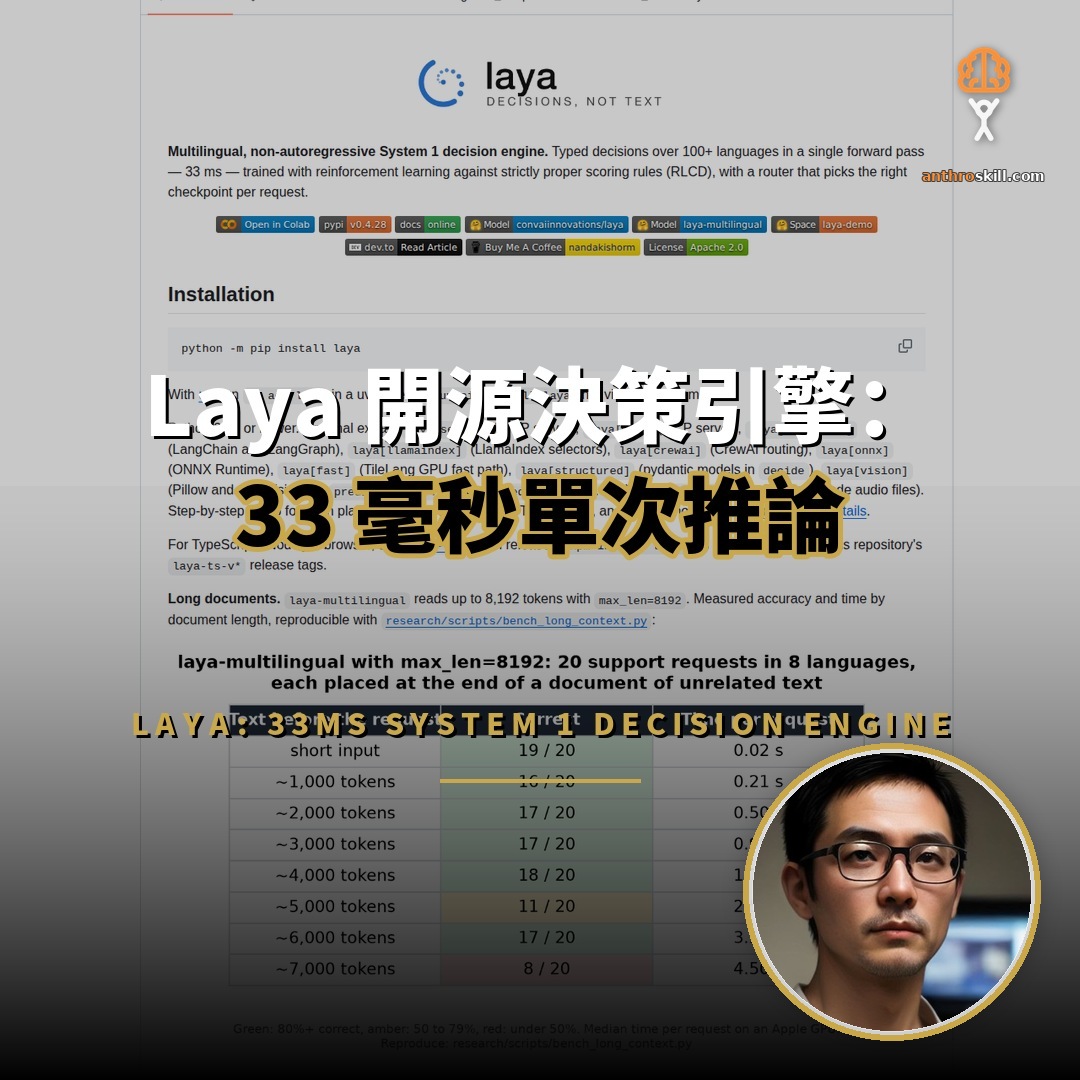
Laya 於十一月七日發布 0.4.28 版。這套專案把自己定位為非自迴歸的系統一決策引擎,輸入文字與問題結構,一次前向傳播即輸出帶機率的結構化答案。專案在 GitHub 累積三萬五千顆星標,採 Apache 2.0 授權,權重可完整下載自託管。
Laya 是什麼?
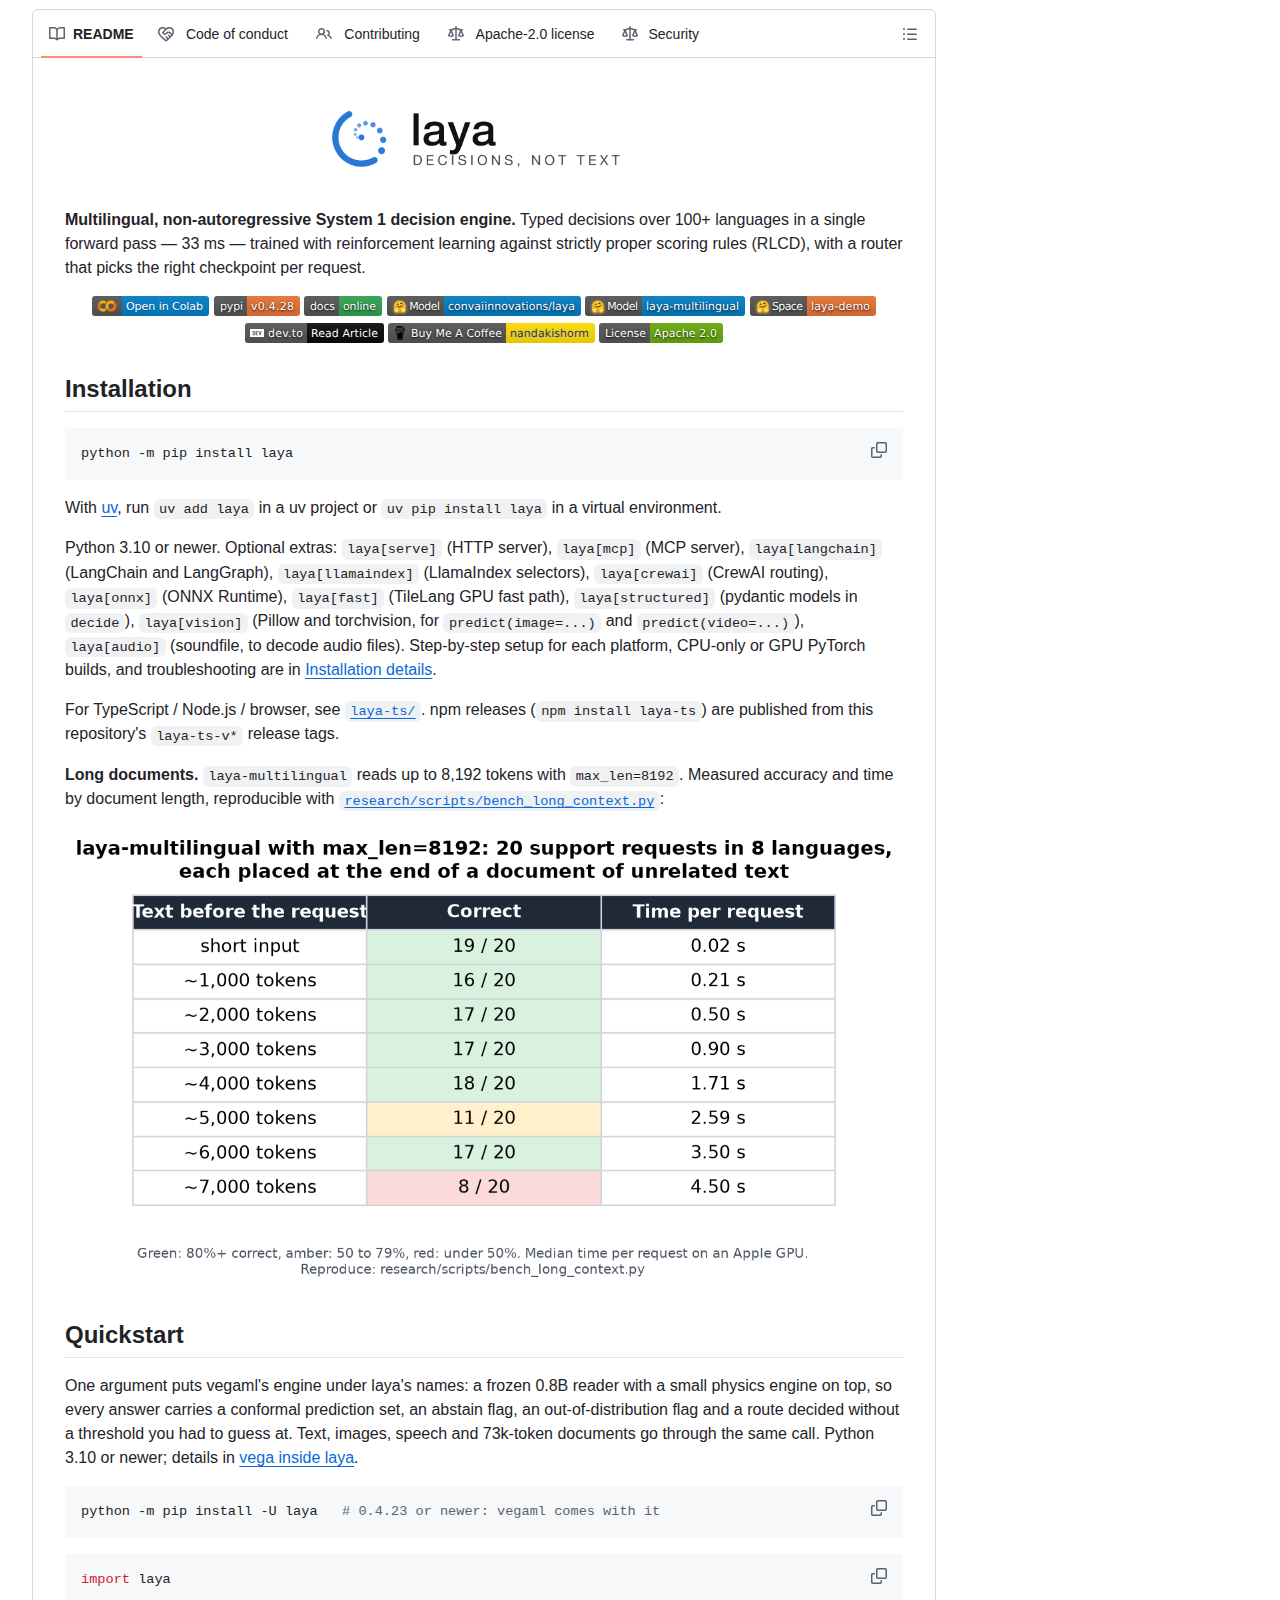
Laya 是一套開源決策引擎,把分類、評分與是非判斷包裝成統一的問題結構,透過一次前向傳播回傳選項、機率、信心值與路由建議,並非用來生成文章的自由對話模型。
專案作者 NandhaKishorM 在說明中反覆強調一個區分:語言模型適合開放式生成,但企業流程中大量出現的是型別化決策,例如判斷工單屬於哪個部門、風險等級有多高、客戶是否準備流失。這些任務不需要自由文字,需要穩定、可驗證、可批次處理的答案。
Laya 的做法是把決策表徵成三種基本型別。choice 型別在給定選項中挑一個並回傳完整機率分佈,score 型別在有序等級上輸出分數,noul 型別回傳單一命題為真的機率。使用者以字典宣告問題與選項說明,引擎回傳答案,不需要解析自然語言輸出。
專案於二零二六年九月中旬公開,兩個月內累積一百七十五位貢獻者與三萬一千次分叉。它同時提供 Python 套件、TypeScript 版本、HTTP 服務、命令列工具與 MCP 伺服器,讓不同語言的應用都能接入同一套決策介面。
單次前向傳播的架構有什麼特別?
架構把問題與選項渲染成固定提示,與狀態文字一起送入編碼器,決策頭在一個步驟內對所有選項打分,省去逐字生成的時間,並保留完整機率分佈供後續校準。
自迴歸模型的延遲主要來自解碼迴圈:每個詞元都要一次前向傳播,輸出愈長等待愈久。Laya 直接跳過解碼階段,把選項文字與狀態拼接後交由編碼器處理,決策頭讀取標記位置的表徵,一次算出所有選項的對數機率。
這個設計的代價是彈性。模型只能回答預先宣告的選項,無法即興生成新類別,也無法處理需要多步推理的複合問題。換來的好處是輸出結構固定,下游系統不需要容錯解析,批次處理時亦能把多個問題合併到同一次前向傳播。
專案另設一層路由機制。由於英文檢查點在多語言任務上表現急劇下滑,路由會依輸入語言與問題型別選擇合適的檢查點,並在信心不足時把請求標記為需要人工覆核。作者在文件中明確指出,模型自身的信心值不足以作為警示訊號,路由必須在前向傳播之前決定。
速度與準確度表現如何?
在 T4 顯示卡上多語言檢查點單題耗時 32.8 毫秒,五十題批次每秒達三百三十二題;型別化決策準確率 0.766,較商業介面高 3.9 個百分點,校準誤差低三倍。
專案公開的基準測試以同一批逐位元組相同的問題比較,並附上可重現的筆記本。在單題延遲上,多語言檢查點為 32.8 毫秒,英文檢查點為 39.5 毫秒;問題數增加到五十題時,多語言版本平均每題降至 6.8 毫秒,批次吞吐達每秒 103 至 332 題。
準確度方面,微調後的型別化決策檢查點在兩千個決策上取得 0.766 準確率,優於對照商業介面的 0.727,也高於教師模型自我一致的上限 0.735。四個工作流程全部領先,其中發票處理 0.804、安全事件 0.766、客戶服務 0.764、代理軌跡觀測 0.730。
校準是另一個差異點。經過溫度縮放後,Laya 的期望校準誤差為 0.081,對照組為 0.246,專案亦指出對照組在情緒分類任務上有百分之十六的樣本把真實標籤的機率給成零,對任何依賴信心值分支的系統都是硬故障。
有哪些誠實限制需要注意?
原始檢查點在型別化決策上接近隨機,需微調後才有實用準確率;選項超過二十個時準確率急跌;是非題標籤易被字面誤導;多語言版本在評分題有位置偏誤。
專案的限制章節份量罕見地充足,逐項列出失敗條件。最基本一項是原始檢查點在型別化決策上只有 0.362 與 0.352,低於多數類基線 0.461,只比隨機猜測 0.318 略高。作者明言 Laya 是快速特化的底座,並非零樣本決策引擎,所有能力來自微調。
高基數選項是結構性弱點。Banking77 的七十七個選項在預設設定下只分到三至四個詞元,準確率跌至 0.425,對照組在同一任務取得 0.870。專案提供三種補救路徑,包括提高選項提示預算、先用嵌入模型縮小候選,以及分組淘汰的錦標賽式推論。
標籤字面亦會干擾答案。choice 型別的鍵值會原樣渲染給模型,使用 true 與 false 或 yes 與 no 這類布林詞作為標籤時,模型可能跟隨標籤而不是跟隨選項描述。文件亦記錄在取消訂單的否定語句上,語意化標籤仍不足以避免誤判,呼叫端必須在自己服務的檢查點與語句上實測。
如何快速開始使用 Laya?
以 pip 安裝 laya 後載入代理並宣告問題結構,需 Python 3.10 以上;亦可安裝 MCP 擴充把決策註冊為工具,或啟動 HTTP 服務供多個工作階段共用。
最短路徑是安裝套件後建立代理物件,把狀態文字與問題字典傳入,回傳結果包含選項、機率、預測集合、棄權旗標與路由建議。文件建議以路由欄位而非單一信心值作為分支依據,因為路由同時考慮了符合性預測集合與分佈外偵測。
需要與現有代理框架整合時,專案提供 LangChain、LlamaIndex、CrewAI 與 ONNX Runtime 的選用依賴,亦有可註冊到 Claude Desktop、Cursor 與 OpenClaw 的 MCP 伺服器。MCP 模式下十個工具涵蓋單題、批次、長文件、路由、結構描述決策與錦標賽式縮減。
專案另附四十一份可執行範例,按八個階段由首次呼叫排到生產服務。評估工具 laya-evals 可在持續整合中設下準確率與校準門檻,指標不合格即以非零狀態結束,讓品質變動成為可審核的差異而非人工抽查。
Laya 的專案數據與版本節奏如何?
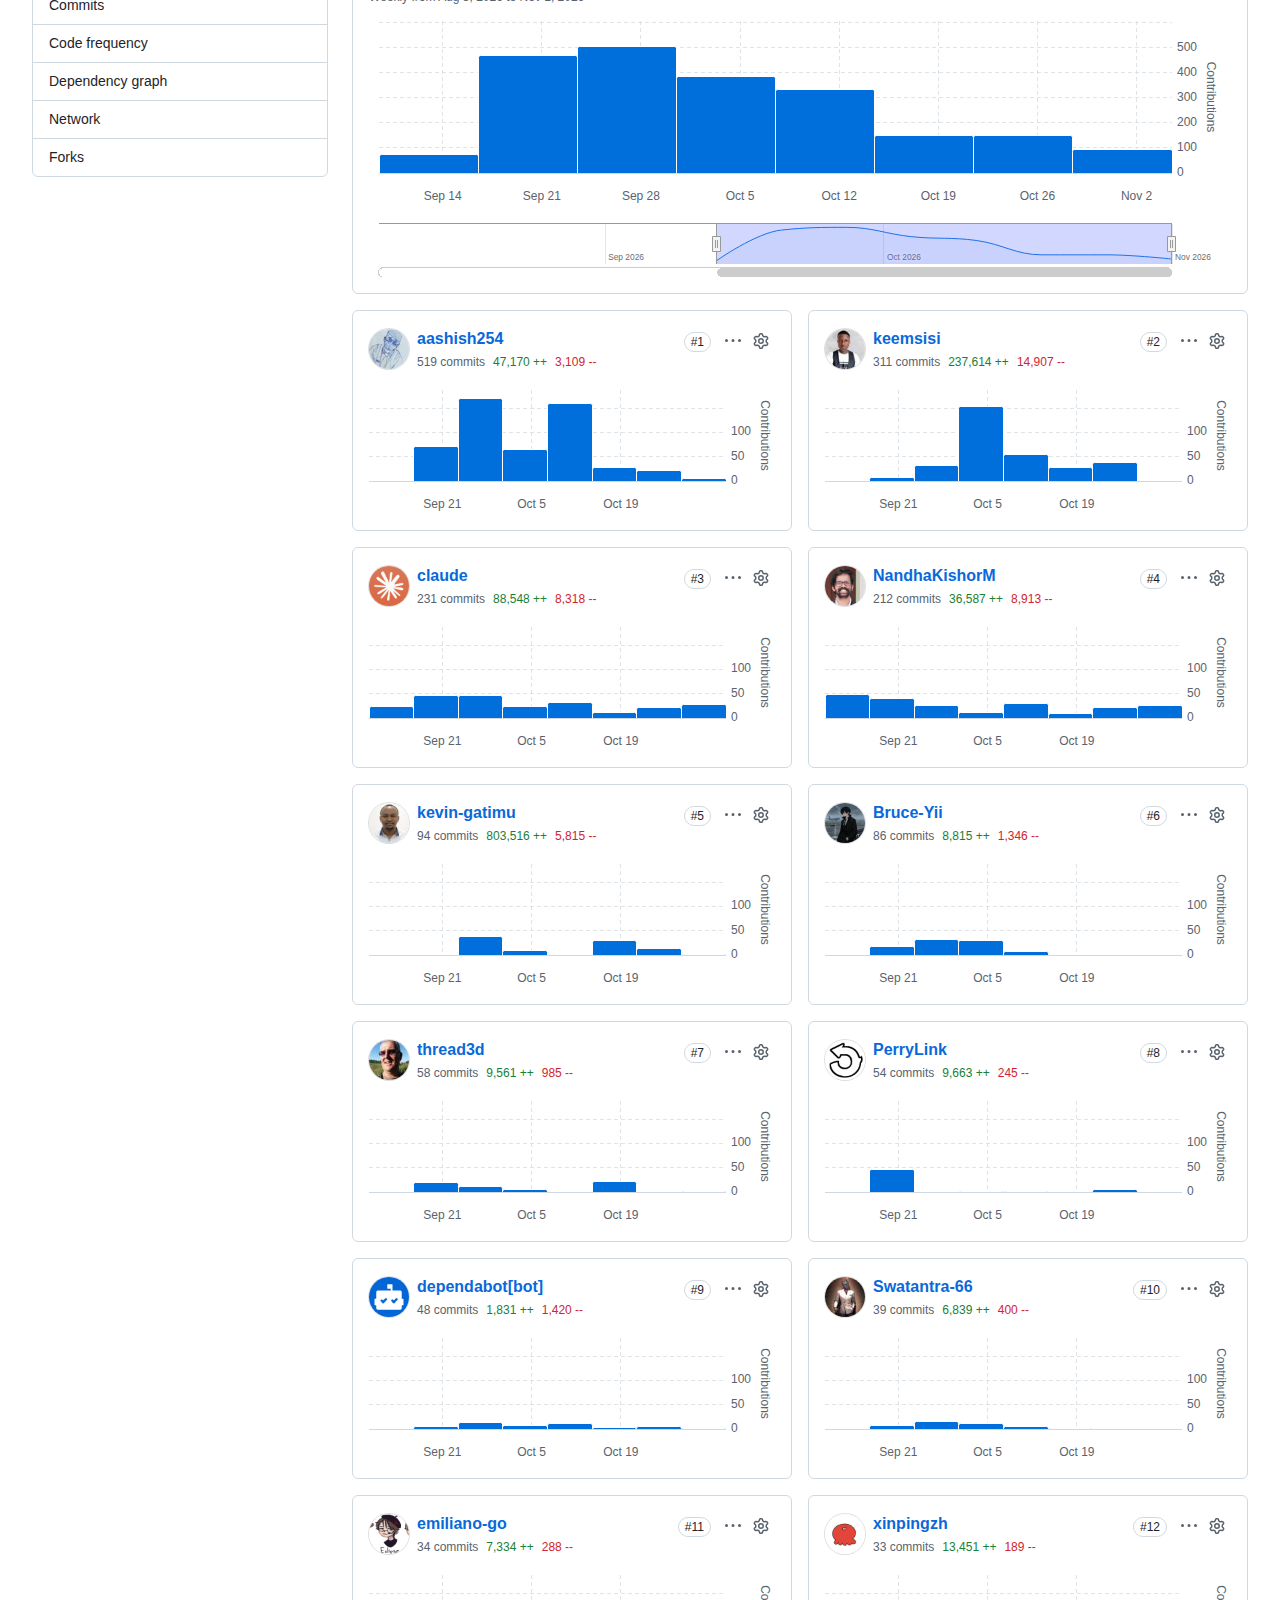
截至二零二六年十一月八日,專案累積 35,189 顆星標、3,148 次分叉與 175 位貢獻者,程式碼以 Python 為主,PYPI 已發布六十六個版本。
- 35,189GitHub 星標
- 3,148分叉次數
- 175貢獻者
- 66PyPI 版本
版本節奏相當密集。十一月五日單日內推出 0.4.24 與 0.4.25,十一月六日推出 0.4.27,十一月七日推出 0.4.28。最近的更新集中在工程細節,包括從簽章政策檔直接載入已訓練策略、在較新的 transformers 版本上把長輸入的中央處理延遲降低百分之二十六至五十五,以及把型別錯誤改為具名拒絕而非洩漏底層例外。
出處連結有哪些?
原始碼與問題追蹤位於 GitHub 的 NandhaKishorM/laya 儲存庫,權重發布於 Hugging Face,套件於 PyPI 發布,基準報告隨儲存庫提供。
專案的原始碼、版本紀錄與問題追蹤集中於 GitHub 儲存庫,模型權重以 convaiinnovations 帳號發布於 Hugging Face,包含英文、多語言與型別化決策三個檢查點。基準測試的每一次執行紀錄彙整於儲存庫內的報告文件,社群工具與第三方整合則列於說明文件末段。
出處:https://github.com/NandhaKishorM/laya
常見問題有哪些?
常見問題集中在三點:能否取代語言模型生成文字、自託管的硬體門檻,以及中文與華語語料的實際表現。以下逐項以專案文件與基準數據回答。
Laya 可以取代語言模型做文字生成嗎?
不能。專案明確界定適用範圍為結構化決策,包括選項分類、有序評分與是非判斷。開放式問答與文章生成仍需要自迴歸模型,強行套用只會得到固定格式的錯誤答案。
自行託管的硬體需求高嗎?
不高。推論可在純中央處理器上執行,官方基準以單張 T4 顯示卡測量,小批次情境下每秒可處理上百題。權重為 Apache 2.0 授權,商業部署沒有額外授權費用。
中文與其他華語語料的支援如何?
多語言檢查點在五十一種語言的意圖分類上,有四十八種達到隨機基線的三倍以上。專案另附简体中文的職場決策與短指令路由兩組社群診斷,但文件提醒非英語的評分型問題仍有位置偏誤。
總結:Laya 適合什麼團隊?
適合有大量重複型別化決策、且願意自行微調與驗證的工程團隊。若需要零樣本即用的準確率,或決策選項常超過二十個,現階段仍應先評估替代方案。
Laya 的價值在於把一個被忽略的工程問題搬到檯面:並非所有 AI 任務都需要生成文字,很多任務只需在固定選項中做出判斷,而這類任務可以用更小、更快、更可驗證的模型完成。三萬五千顆星標與兩個月內六十六個版本,說明這個切入點確實有需求。同樣把判斷從生成流程抽出來的做法,可對照 Gemini Decisions API 的決策端點設計 與 LangChain 1.5 的模型路由層。
但它的定位必須說清楚。原始檢查點接近隨機,實際能力來自針對自身資料的微調;選項數量、標籤字面與語言覆蓋都存在明確邊界。願意投入標註與評估流程的團隊可以得到一個低延遲、可自託管的決策層;期待開箱即用的團隊,則會在第一批真實資料上遇到落差。
