Marker 2.1 於十月二十九日發布,改用 Surya 2.5 作預設 OCR 模型,以 Apache 2.0 開源,累積四萬零八百星標。於 olmocr-bench 一千四百餘份 PDF 取得 76.0 分,平衡模式每秒 2.9 頁,準確度與速度同時領先 MinerU 與 docling。
Marker 是什麼?
Marker 是 Datalab 開源的文件轉換工具,可把 PDF、圖片與 Office 檔轉為 Markdown、JSON 或語意分塊,並保留表格與公式。
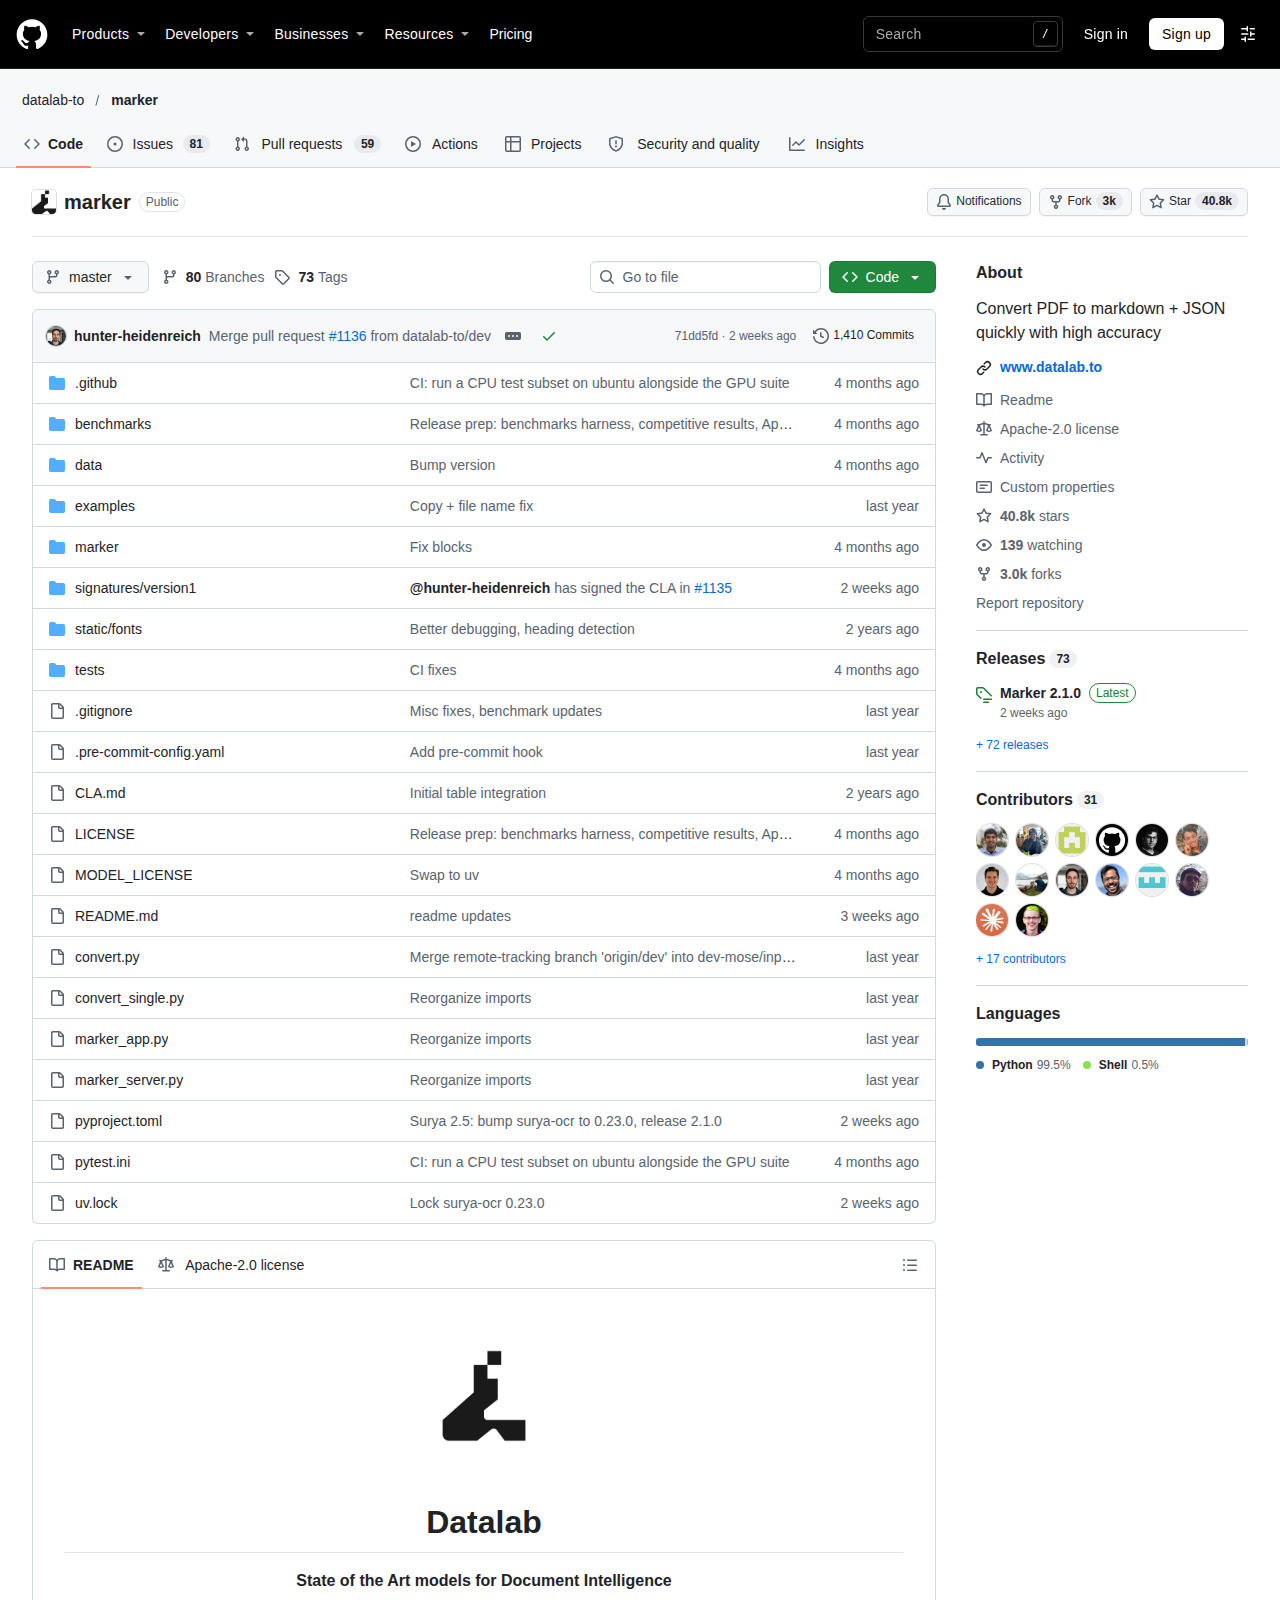
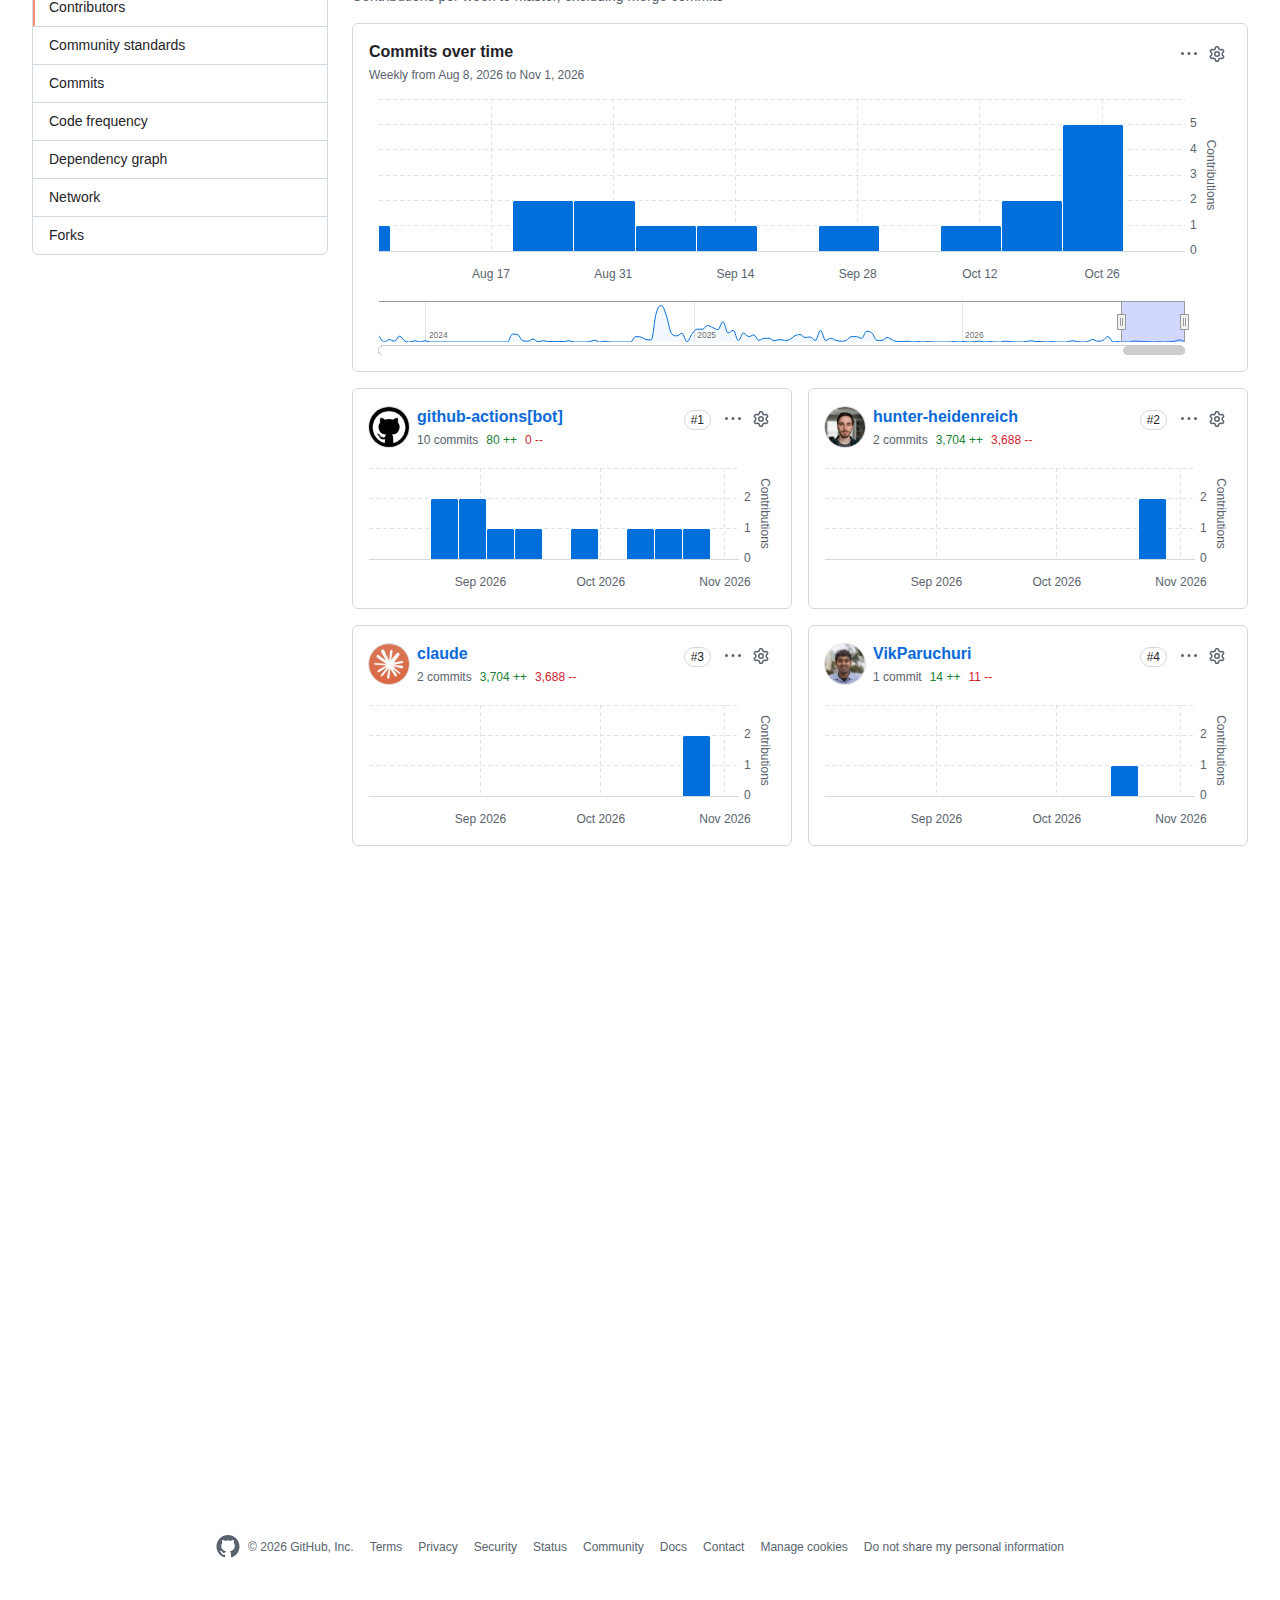
專案由 VikParuchuri 主導,自 2023 年十月起持續開發,主要提交量集中在少數維護者身上。其定位並非單一格式轉換器,而是面向生成式 AI 前處理的文件智能層,把非結構化的版面還原成模型可讀的線性文字。
這個定位決定了它的設計取向。多數同類工具只做光學字元辨識,輸出是一堆沒有層級的文本;Marker 則先判斷頁面結構,再決定哪些區塊需要辨識、哪些可以直接取用內嵌文字層。對於需要把整份技術文件餵入檢索系統或代理工作流的團隊,這個差異直接影響後續的切塊品質。
專案在 GitHub 上累積約四萬零八百星標、二千九百餘次複製,開放議題約一百四十項,主要語言為 Python,程式碼採 Apache 2.0 授權,模型權重則另採修改版 OpenRAIL-M 條款。
Marker 2.1 帶來哪些核心改動?
2.1 版把 OCR 依賴升級至 surya-ocr 0.23.0,預設模型改為 Surya 2.5,並把轉換流程分為 fast 與 balanced 兩條路徑。
版本更新的核心在底層模型。Surya 2.5 官方公布的數字顯示,單張 H100 上每秒處理頁數為 Surya 2 的 1.7 倍,在 OmniParseBench 取得 85.9 分,是參數量低於十億的開源模型中最高者。這個提升直接反映在 Marker 的吞吐量上。
另一個實質改動是模式分工。balanced 模式在 GPU 上以視覺語言模型判斷版面、辨識行內數學,並在偵測到內嵌文字品質不佳時重新辨識整頁;fast 模式則以輕量版面偵測器配合文字層抽取,只在公式、破損區塊與掃描頁才呼叫模型。官方描述的原則是乾淨的數位文件在 fast 模式下完全不會啟動模型伺服器。
表格處理亦一併調整。數位表格改由文字層配合 CPU 啟發式規則重建,信心不足的結果才交由模型補救,balanced 模式的門檻較嚴格。這條路線把昂貴的推論呼叫壓到少數頁面,代價是複雜的巢狀表格仍可能失真。
Surya 2.5 讓轉換速度提升多少?
在同一張 H100 上,Surya 2.5 的每秒處理頁數為前代 1.7 倍,Marker 平衡模式可在單張 B200 維持每秒 2.9 頁。
官方強調的數字是持續併發吞吐量,而非單頁延遲。平衡模式在單張 B200 上的持續速率為每秒 2.9 頁,對應每頁約 341 毫秒;fast 模式為每秒 7.4 頁,每頁約 134 毫秒;關閉辨識的純文字層路徑達每秒 23.7 頁,每頁約 42 毫秒。
這些數字背後的架構值得說清楚。Marker 的設計是把負責轉換的輕量工作進程與推論伺服器分離,多個工作進程共用一個模型伺服器,由父進程統籌模型呼叫的併發額度。因此吞吐量隨伺服器容量擴張,而非受單一進程的顯示記憶體限制。官方指出平衡模式在單張 B200 上只佔用約三成算力,瓶頸在模型的解碼速度。
若需要更高準確度,同一團隊另提供 Chandra 模型與託管平台,在相同基準上取得 85.8 分,並附零資料保留選項、SOC 2 Type 2 與自訂商業夥伴協議。這條商業路徑與開源專案並行,構成典型的開放核心模式。
Marker 在基準測試中的表現如何?
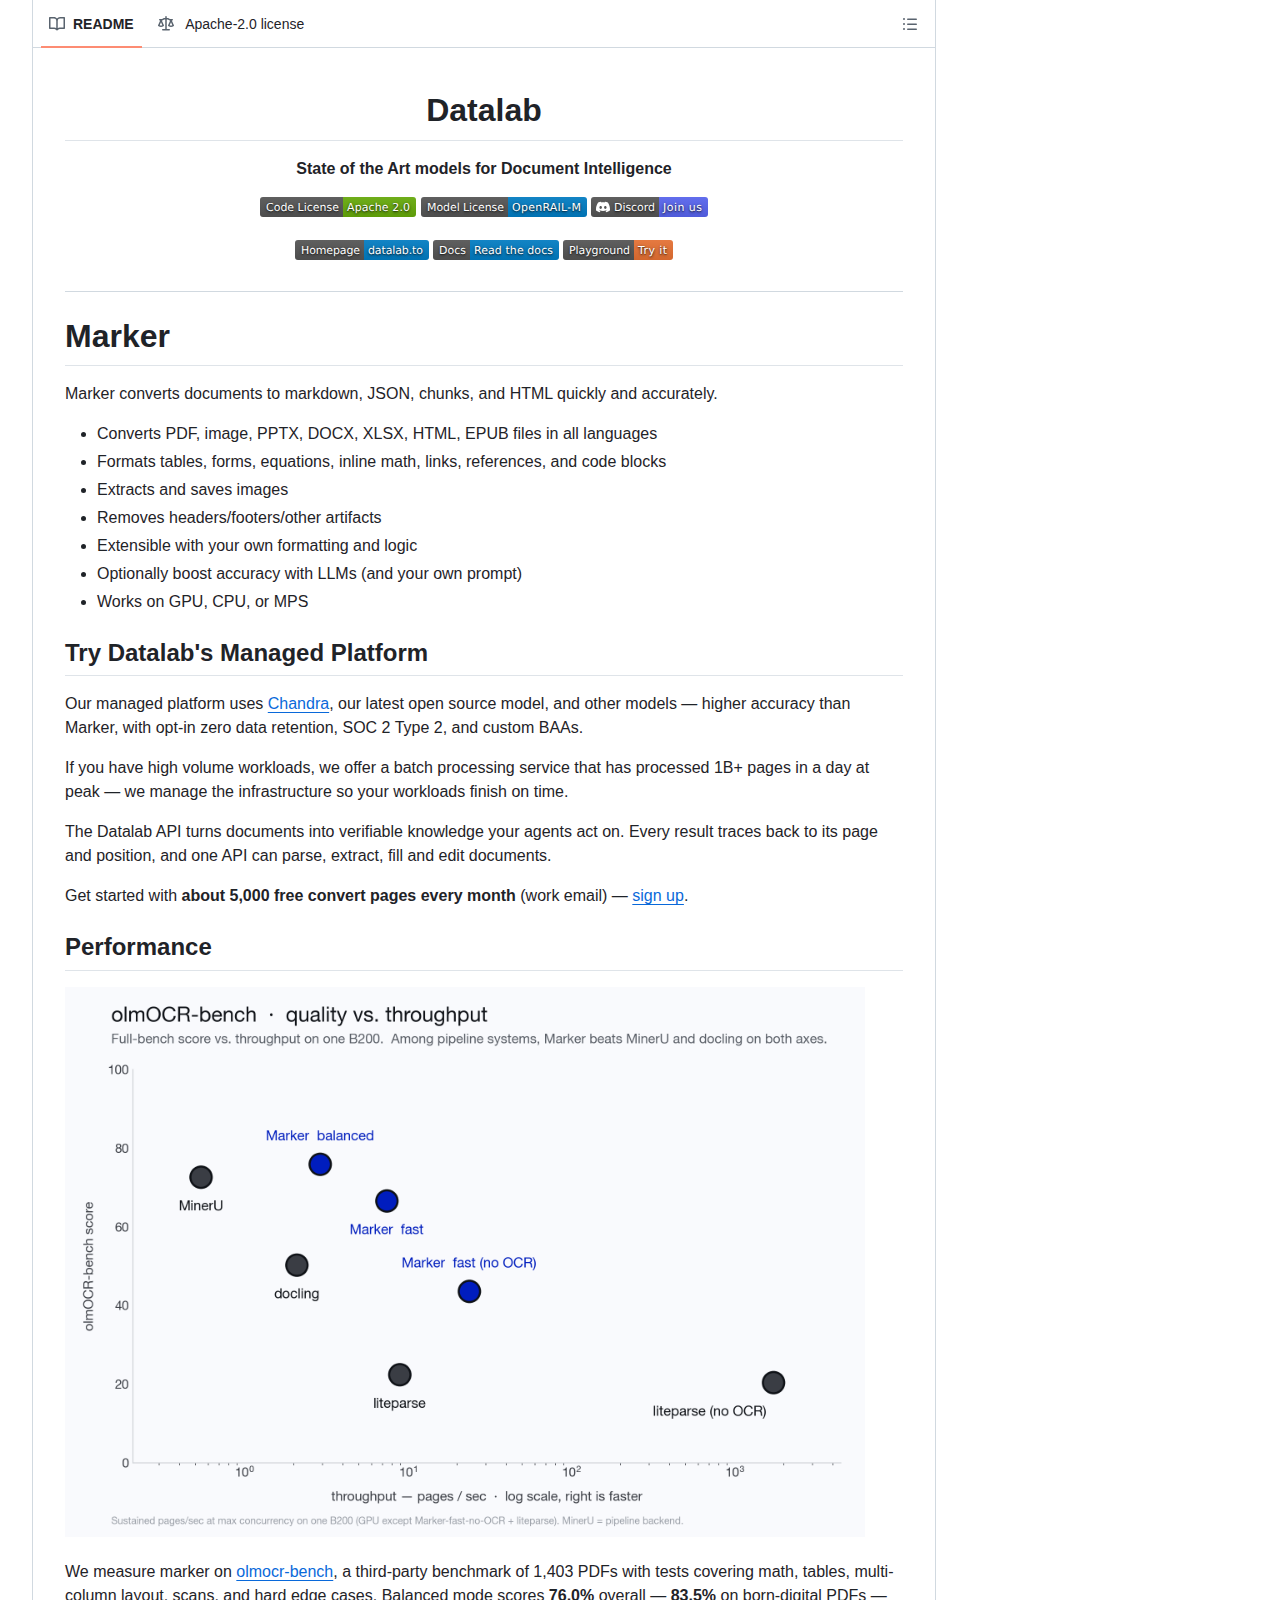
olmocr-bench 收錄 1,403 份 PDF 與約 8,400 項測試。Marker 平衡模式總分 76.0,數位原生文件達 83.5。
基準由 Allen 人工智慧研究所維護,屬第三方評測,測試項目包含公式渲染、表格結構、閱讀順序、頁眉頁腳與掃描件。總分為八個類別的宏觀平均,與 Chandra 及 olmocr-bench 官方計分方式一致。
在競爭比較中,Marker 平衡模式的總分為 76.0、數位原生文件子集 83.5、吞吐量每秒 2.9 頁;MinerU 流水線為 72.7、83.3 與每秒 0.54 頁;docling 為 50.3、64.0 與每秒 2.1 頁;liteparse 為 22.4、27.3 與每秒 8.9 頁。官方據此主張 Marker 在準確度與速度上同時勝過前兩者,速度差距約五倍。
逐類別數據則顯示取捨所在。平衡模式在頁眉頁腳處理達 95.9 分、基準行 99.7 分,表格 73.4 分、多欄 76.6 分,但在老舊掃描件只有 43.2 分。fast 模式的 arXiv 數學僅 23.4 分,原因是公式直接取自文字層而未經模型辨識,官方因此建議數學密集文件改用平衡模式。
三種轉換模式有什麼差別?
平衡模式在 GPU 上提供最高準確度;fast 模式為 CPU 優化,只選擇性呼叫模型;關閉辨識模式完全不使用模型,僅取文字層,速度最快但數學與掃描件近乎失效。
預設值依硬體決定。GPU 環境自動選用平衡模式,CPU 與 Apple Silicon 環境選用 fast 模式,兩者都不需要手動指定,但可透過參數覆寫。
平衡模式的流程是完整版。版面由視覺語言模型判斷,行內數學交由模型辨識,一旦偵測到頁面內嵌文字有問題就重新辨識整頁,因此掃描件與舊文件的品質較穩定。代價是每個頁面都可能觸發模型呼叫。
fast 模式走的是精簡路線。版面由射頻檢測器判斷,文字以文字層抽取,模型只用於公式、個別破損或空白區塊的修補,以及掃描頁的整頁處理。乾淨的數位文件在此模式下不會啟動模型伺服器,這也是 CPU 環境得以運作的關鍵。
關閉辨識模式則完全繞過模型。官方明確指出此模式下數學得分為零,因為內嵌文字層無法表示 LaTeX,破損的數學符號亦會拉低基準行分數。此模式適合純文字、純表格且來源檔案品質良好的批次處理。
如何快速開始使用 Marker?
安裝只需一行 pip 指令,要求 Python 3.10 以上與 PyTorch。GPU 環境另需 Docker 與 NVIDIA 容器工具,CPU 環境需 llama.cpp。
基本安裝指令為 pip install marker-pdf,若需處理 PDF 以外的格式,改用 pip install marker-pdf[full] 加裝額外依賴。首次執行時系統會自動啟動推論伺服器,NVIDIA 顯示卡走 vLLM 容器,其餘環境走 llama.cpp。
單檔轉換以 marker_single 指令處理,輸出格式可指定 markdown、json、html 或 chunks。批次轉換使用 marker 指令,支援把檔案清單分片到多台機器,每台各自啟動伺服器,適合大規模一次性遷移。
若要進一步提高準確度,可加上 use_llm 參數,讓外部模型處理跨頁表格合併、行內數學與表單數值抽取。此功能支援 Gemini、Claude、OpenAI 相容介面、Azure、Vertex、OpenRouter 與本機 Ollama,預設模型為 gemini-3.5-flash。官方亦提供 Streamlit 介面,安裝後以 marker_gui 啟動。
使用 Marker 需要付出哪些成本?
程式碼為 Apache 2.0,可自由商用;模型權重則採修改版 OpenRAIL-M,僅對研究、個人與融資或營收低於五百萬美元的新創免費,超出範圍須另購商業授權。
這是本專案最容易被忽略的一點。多數讀者看到 Apache 2.0 便假設整包可用於商業產品,實際上授權分為兩層:儲存庫內的程式碼屬 Apache 2.0,模型權重則另有條款。官方在說明中明確列出免費範圍,並將超額商用導向定價頁。
硬體成本同樣需要評估。平衡模式依賴 GPU 推論,若無自建顯示卡,需租用雲端執行個體或改用託管服務。fast 模式雖可在 CPU 運行,但正如基準所示,數學與掃描件的品質會明顯下降。
準確度的邊界亦應預先確認。官方列出的已知限制包括複雜版面、巢狀表格與表單,這些情況即使加上 use_llm 也未必完全解決。對於以表格與表單為主的財務或醫療文件流程,建議先以自有樣本做小規模驗證,再決定是否全面導入。
出處連結有哪些?
原始碼、版本標籤與完整變更記錄公開於 GitHub,官方文件站另提供教學與雲端試用環境。專案由 Datalab 維護,商業授權與定價資訊見官網。
儲存庫位於 https://github.com/datalab-to/marker ,內含 benchmarks 目錄與可重現的評測腳本。若需要其他格式的轉換方案,可參考站內對 AnyDoc 的整理,官方強調所有分數與吞吐量數字均可自行驗證。文件站位於 documentation.datalab.to,提供安裝、設定與部署範例。
版本標籤以 v2.1.0 為最新,於 2026 年十月二十九日發布,主要變更為 Surya 2.5 升級與相依套件調整。若需維持舊行為,可設定環境變數把模型檢查點指回 Surya 2。
總結:Marker 適合哪些團隊?
需要把大量 PDF 轉為模型可讀格式且已有 GPU 資源的團隊最適合。若文件以複雜表單為主,宜先做樣本驗證。
本專案的核心訊號是文件前處理的競爭已從辨識率轉向吞吐量。當代理與檢索系統需要吞下整座文件庫,單頁準確度再高也抵不過每頁三秒的處理時間,這也是 Marker 把工程重心放在併發架構與選擇性呼叫模型的原因。
對既有流程而言,導入的可逆性相當高。輸出為純文字與結構化 JSON,不綁定特定向量資料庫或框架,替換成本主要在評測與調校階段。建議先以一百份自有文件建立對照組,量測表格與公式的實際表現。
至於是否採用,判準可回到三個具體問題:文件庫規模是否大到需要併發處理、內容是否以數位原生文件為主、以及商用授權範圍是否落在免費區間內。三項皆為肯定時,此專案屬於值得優先評估的選項。
