FunASR 是一個開源語音識別工具包,在 GitHub 累積 21,082 顆星標,採 MIT 授權。專案由阿里巴巴達摩院 ModelScope 團隊維護,把語音辨識、端點偵測、標點還原、說話人分離與情感辨識拆成可獨立組合的模型與執行環境,並提供相容 OpenAI 的服務介面。
專案建立於 2022 年 11 月 24 日,累積 2,139 個分支與 232 位貢獻者,主要語言為 Python。README 的自我定位相當明確:工業級語音辨識工具包,涵蓋離線、串流與邊緣部署三種場景,另加一組情緒與音訊事件模型。
FunASR 是什麼?
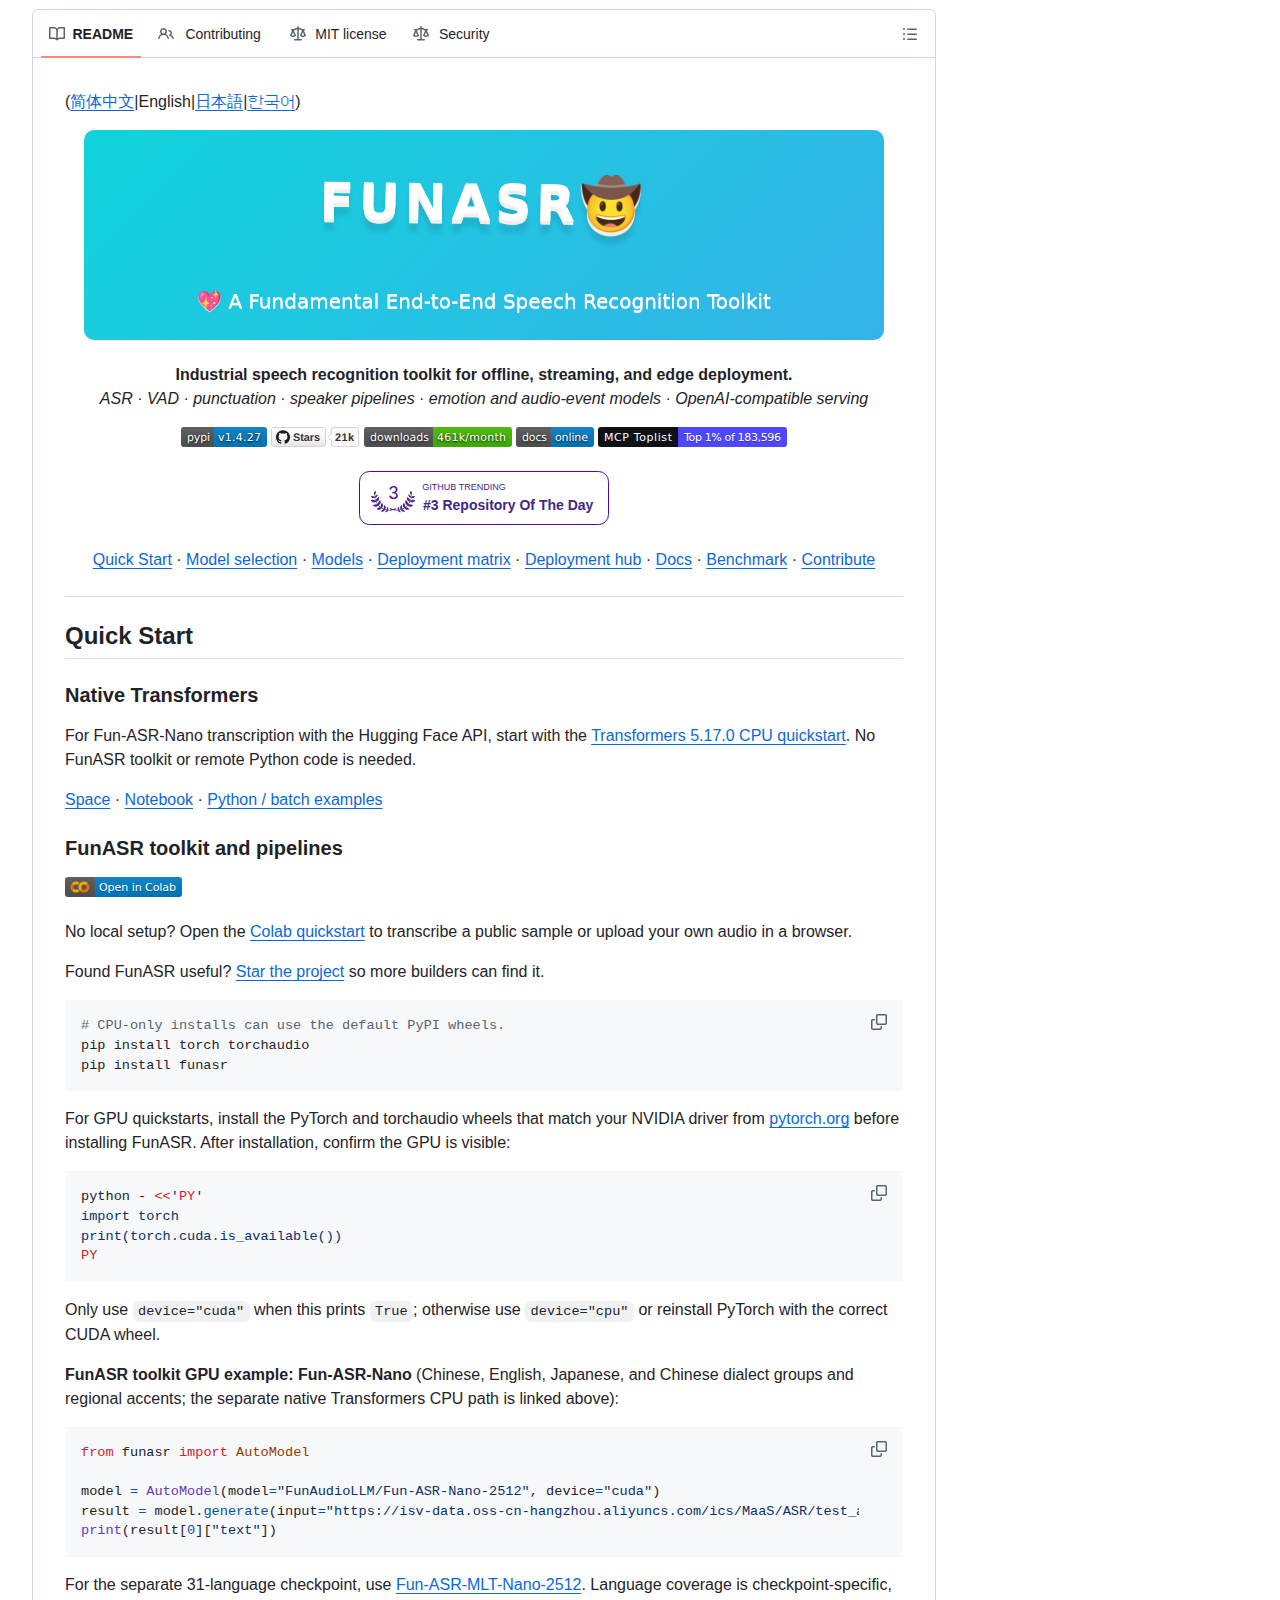
它是一套把語音任務拆成模型、執行環境與服務介面三層的開源工具包,使用者按需求挑選檢查點與後端,不必為單一功能引入整套框架。
這種分層設計貫穿整份文件。工具包本身只負責協調,模型權重由各檢查點各自提供,執行環境則包含 Python 的 AutoModel、vLLM 分離引擎、ONNX 執行時、WebSocket 服務與 llama.cpp 二進位檔。
文件反覆提醒一件事:某個能力出現在某個模型或某個轉接層,並不代表所有服務後端都支援。這個界線寫得清楚,減少了使用者把示範程式碼直接搬上生產環境之後的落差。
FunASR 的模型庫涵蓋哪些語音任務?
模型庫分成辨識、端點偵測、標點、說話人與情緒五類,參數規模從 40 萬到 17 億不等,語言覆蓋由中文方言延伸至 52 種語言,各檢查點授權獨立於工具包的 MIT 條款。
中文場景的主力是 Paraformer 系列,參數量 2.2 億,可搭配 FSMN-VAD 做端點偵測、ct-punc 做標點還原、CAM++ 做說話人向量抽取。串流場景另有專用的 Paraformer-zh-streaming,文件強調必須使用串流檢查點與逐次對話的快取,離線檢查點不能直接套用。
多語言與輕量場景由新版模型承擔。Fun-ASR-Nano 為 8 億參數,覆蓋中文、英文、日文與中文方言及地區口音;Fun-ASR-MLT-Nano 同為 8 億參數,獨立覆蓋 31 種語言;SenseVoiceSmall 只有 2.34 億參數,支援中英日韓與粵語,同時輸出情緒與音訊事件標籤。
生態相容層同樣值得注意。模型庫收錄 Qwen3-ASR 與 GLM-ASR-Nano 的轉接範例,兩者分別覆蓋 52 種與 17 種語言;Whisper-large-v3 與 turbo 版本也以轉接方式納入。情緒辨識由 emotion2vec+large 提供,參數量 3 億。若關注語音合成而非辨識,另可參考微軟 VibeVoice 的開源語音家族。
授權界線是閱讀這份清單時容易忽略的一點。工具包採 MIT,但第三方模型權重各自適用不同條款,文件把這一點單獨列在模型庫說明之後,避免企業採用時誤判。
FunASR 的串流辨識與離線辨識如何分工?
串流走逐塊餵入加對話快取的路徑,離線走整段音訊加批次合併的路徑,兩者使用不同檢查點與不同時序參數,切換時必須一併替換模型與快取邏輯。
串流範例的參數配置相當具體。chunk_size 設為 [0, 10, 5],對應約 600 毫秒的音訊塊,chunk_stride 由第二個數值乘以 960 得出;每次呼叫同時傳入 encoder_chunk_look_back=4 與 decoder_chunk_look_back=1,最後一塊才把 is_final 設為真。
離線範例則以 batch_size_s=300 控制批次長度,一次處理整段音訊。文件提醒離線吞吐量與串流延遲屬於兩種不同指標,不能互相比較,這個區分在選型階段特別有用。
熱詞支援是另一個實務差異。中文生產配置可以在呼叫時傳入 hotword="關鍵詞 20",用數字標示權重;後續版本另修正了跨語系熱詞誤替換與長熱詞邊界兩類問題。
端點偵測除了內建的 FSMN-VAD,也提供 Silero VAD 選項,需先安裝 funasr[silero] 擴充,並可調整門檻值與最短靜音時長。兩者在 16 kHz 單聲道音訊下的分工寫得清楚。
FunASR 如何在 CPU 與邊緣裝置上執行?
專案提供基於 llama.cpp 的單一二進位執行檔,內建端點偵測且不需 Python,分發 Linux 與 Windows 的 Vulkan、CUDA 套件,適合無 GPU 環境。
這條路徑的定位寫得直接:對 FunASR 而言,等同 whisper.cpp 對 Whisper 的定位。執行方式是下載 GGUF 權重後,以 llama-funasr-sensevoice 指定模型、VAD 檔與音訊輸入,一次完成辨識。
硬體後端分成幾種。Linux 提供 Vulkan 版 tar 壓縮檔;Windows 提供 Vulkan 版與兩款 CUDA 版 ZIP,標準版對應 CUDA 架構 86,Blackwell 版對應架構 120,供 RTX 50 系列使用。兩款 CUDA 套件都內附 cuBLAS 動態函式庫並使用靜態 MSVC 執行環境,使用者只需相容的 NVIDIA 驅動,不必另裝 CUDA Toolkit。
README 在此處附了一句效能宣稱:中文辨識的字元錯誤率比 whisper.cpp 低約三倍。這項數字出現在說明文字之中,未附測試音訊集與硬體條件,實際比較仍應以自家錄音自行驗證。
文件對驗證範圍的措辭相當克制。它明言持續整合只驗證架構與套件邊界,並未證明在實體 Blackwell 硬體上的推論結果。這種寫法在開源專案中並不常見。
FunASR 與 Whisper 的差異在哪裡?
Whisper 以單一模型完成多語言辨識與翻譯,FunASR 以多模型管線分工處理辨識、端點、標點與說話人,中文與方言覆蓋較細,也能轉接 Whisper 權重。
架構差異帶來不同的取捨。Whisper 的單模型路線部署簡單,一個權重檔對應一種能力,其模型定位與版本演進可參考早前的 Whisper 介紹;FunASR 的管線路線則把每個環節獨立替換,中文場景可只換辨識模型而保留既有標點與說話人模組。
專案為此另外準備遷移指南,檔名直接標明 migration_from_whisper,內容涵蓋以代表性音訊測試、對照功能邊界與分階段上線。另有一組遷移基準範例,讓使用者以相同評估範圍比較兩邊結果。
兩者並非互斥。Whisper-large-v3 與 turbo 版本以轉接方式收錄於模型庫,既有 Whisper 使用者可以逐步替換個別環節,而非一次性重寫整條流程。
中文與粵語覆蓋是 FunASR 的明顯優勢。SenseVoiceSmall 把粵語列為支援語言,Paraformer 系列針對中文最佳化,另有針對中文方言與地區口音的 Fun-ASR-Nano,這些組合在純多語言模型上較難取得。
FunASR 有哪些實際部署方式?
部署路徑包含相容 OpenAI 的本機服務、Docker 串流執行時、Kubernetes 範本、MCP 伺服器與 vLLM 分離引擎,另附 Gradio 示範。
最輕量的方式是本機服務。在獨立虛擬環境安裝 torch、torchaudio、funasr、fastapi、uvicorn 與 python-multipart 之後,以 funasr-server 指定主機、埠號、模型與裝置即可啟動,之後用標準的 /v1/audio/transcriptions 端點送出音訊檔。
安全性提醒寫得明確。文件要求未具備認證的服務只綁定回環位址,對外開放前必須先讀安全指南。這一條放在部署段落的開頭而非附錄,位置安排反映了實務優先順序。
容器與編排路徑另有一套。專案提供阿里雲鏡像倉庫的串流執行時映像,並附 Kubernetes 範本、Postman 集合與 OpenAPI 規格;代理整合則提供 MCP 伺服器範例,可直接接上 Claude 或 Cursor。
本地化語音工作流的其他路線,可對照Voicebox 的本地語音工作室。規模化場景走 vLLM 分離引擎。AutoModelVLLM 支援張量平行設定與批次輸入,適合大批量檔案處理;文件同時提醒必須檢查後端日誌,確認 vLLM 確實載入,光是在參數中指定模型並不足以證明。
如何快速開始使用 FunASR?
最短路徑是安裝後以命令列指定音訊檔,加上 --output-format json 取得結構化輸出,加上 srt 取得字幕,不需自建程式。
命令列工具設計得相當貼近代理使用情境。funasr audio.wav 直接輸出文字,加上 --output-format json 取得結構化結果,加上 --spk --timestamps 取得說話人與時戳,指定 --output-dir 則可批次輸出字幕檔。
Python 介面以 AutoModel 為入口。中文生產配置一行即可組合辨識、端點、標點與說話人四個模型;SenseVoiceSmall 的範例則展示如何讀取 sentence_info,逐段印出起始秒數、匿名說話人編號與去除標籤後的文字。
文件對說話人編號的性質說得坦白。CAM++ 抽出的是語音嵌入向量,AutoModel 對這些向量分群後給出編號,編號只在同一段錄音內有意義,不代表已知身分,也不構成聲紋辨識。
環境需求為 Python 3.8 以上,須先安裝對應驅動的 PyTorch 與 torchaudio,再安裝 FunASR。文件另附 Colab 快速入門,可在瀏覽器上傳音訊試跑,不必先架設本機環境。
FunASR 1.4.27 修正了什麼問題?
此版修正 int16 與多聲道 NumPy 音訊陣列的處理、零長度語音段造成的除以零、標點模型缺省時的時戳邊界,以及字元分詞器的分段詞典輸入接受度。
四項修正都屬根套件層級的邊界條件。第一項讓整數格式的音訊陣列可以直接傳入,第二項避免端點偵測回傳空段落時觸發除以零,第三項在未載入標點模型時仍保留句子時戳,第四項讓字元分詞器接受支援格式的分段詞典。
版本說明另附一段驗證範圍描述,內容相當罕見。它列出發佈契約測試在既有八項失敗基準上通過二十項、文件與靜態檢查通過 133 項、原始碼與安裝後候選行為各通過 49 項,並說明前一版在相同契約下產生十五項預期失敗。
輪子與原始碼包同樣經過核對。說明列出檔案大小與 SHA-256 雜湊,並記載最終安裝後的行為測試通過 49 項、檢查 13 個進入點、十二個酬載的完整性雜湊。
一段保留條款值得留意。以 norm_means=True 與 norm_vars=True 同時訓練的檢查點,因特徵正規化方式改變,需要重新評估辨識品質;norm_vars=False 仍是預設值。既有部署若使用非預設正規化設定,升級前應先重測。
FunASR 的專案數據如何?
專案累積 21,082 顆星標、2,139 個分支與 232 位貢獻者,授權為 MIT,主要語言 Python,建立於 2022 年 11 月,目前開啟議題 67 項。
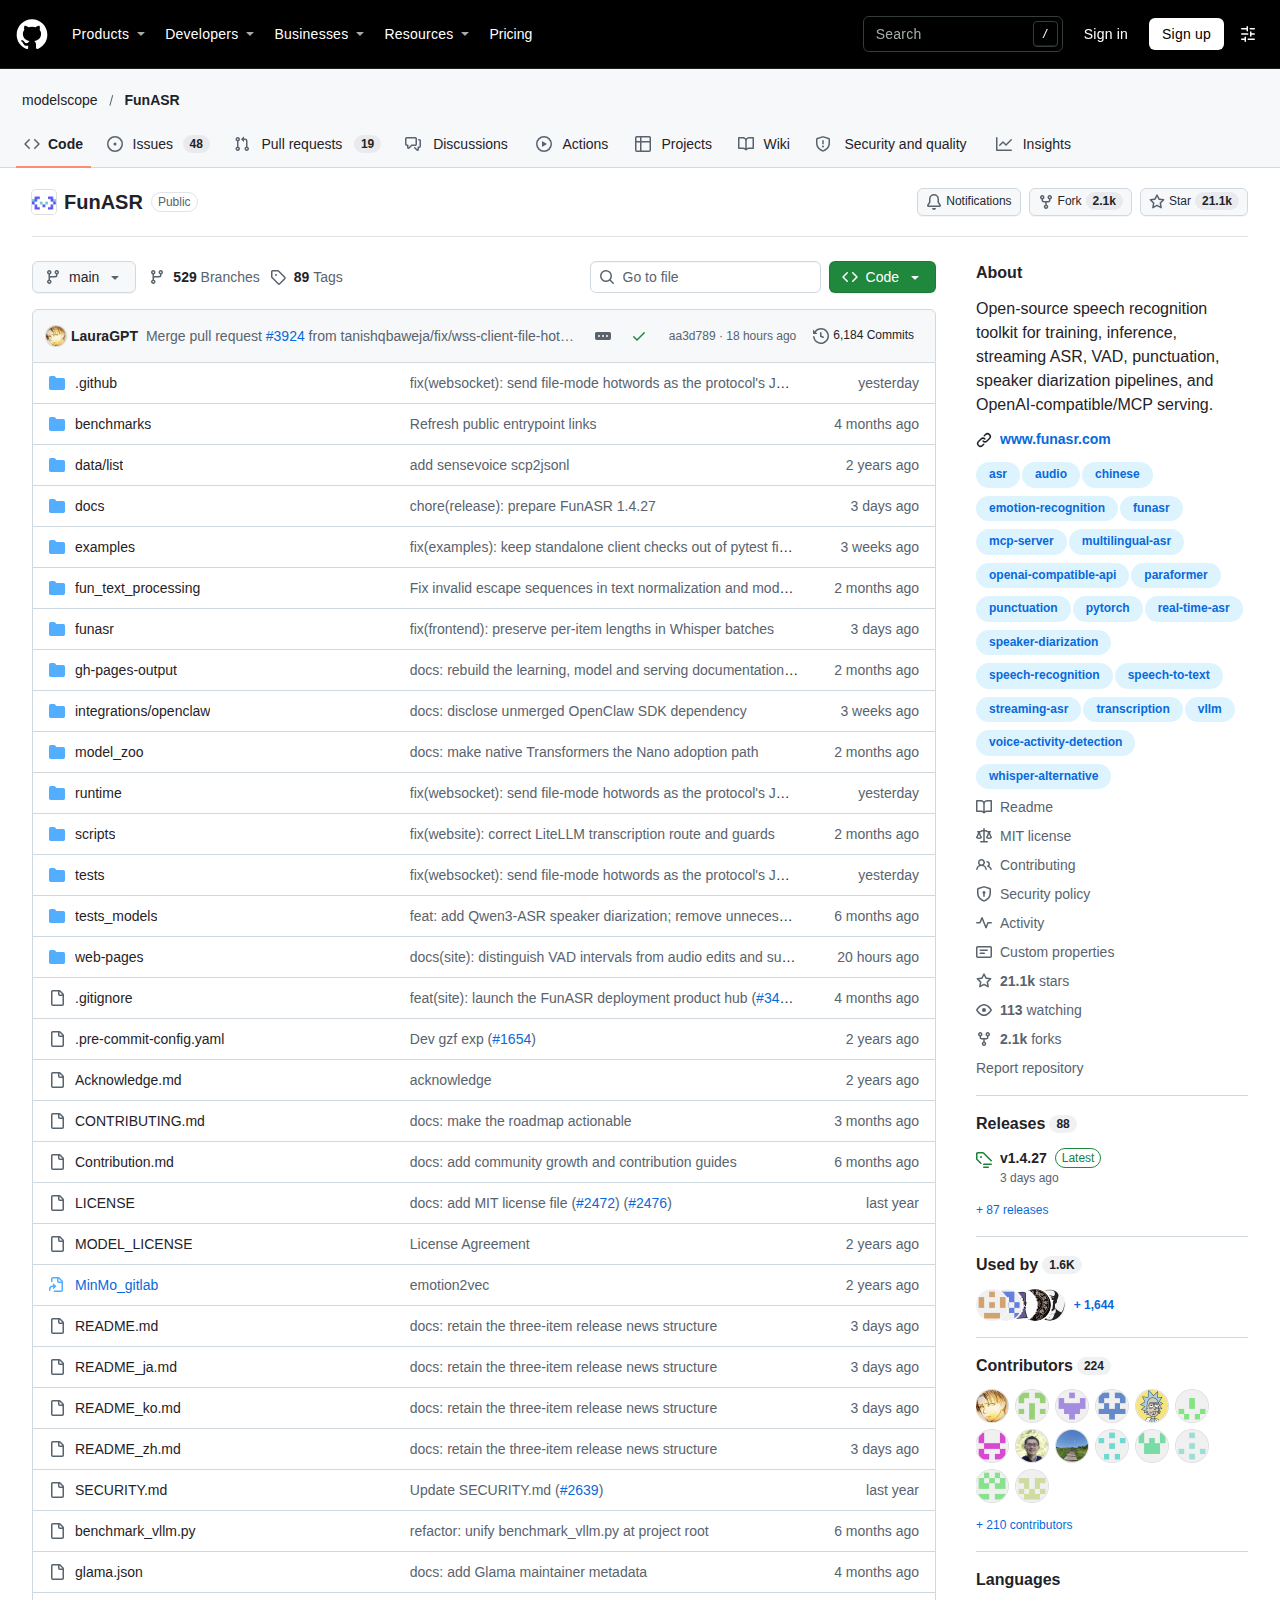
更新頻率是另一個觀察點。儲存庫最後推送時間為 11 月 19 日,最近一個版本 1.4.27 於 11 月 17 日發佈,並在 11 月 13 日同步更新 ONNX 與 Torch 兩套獨立執行時。
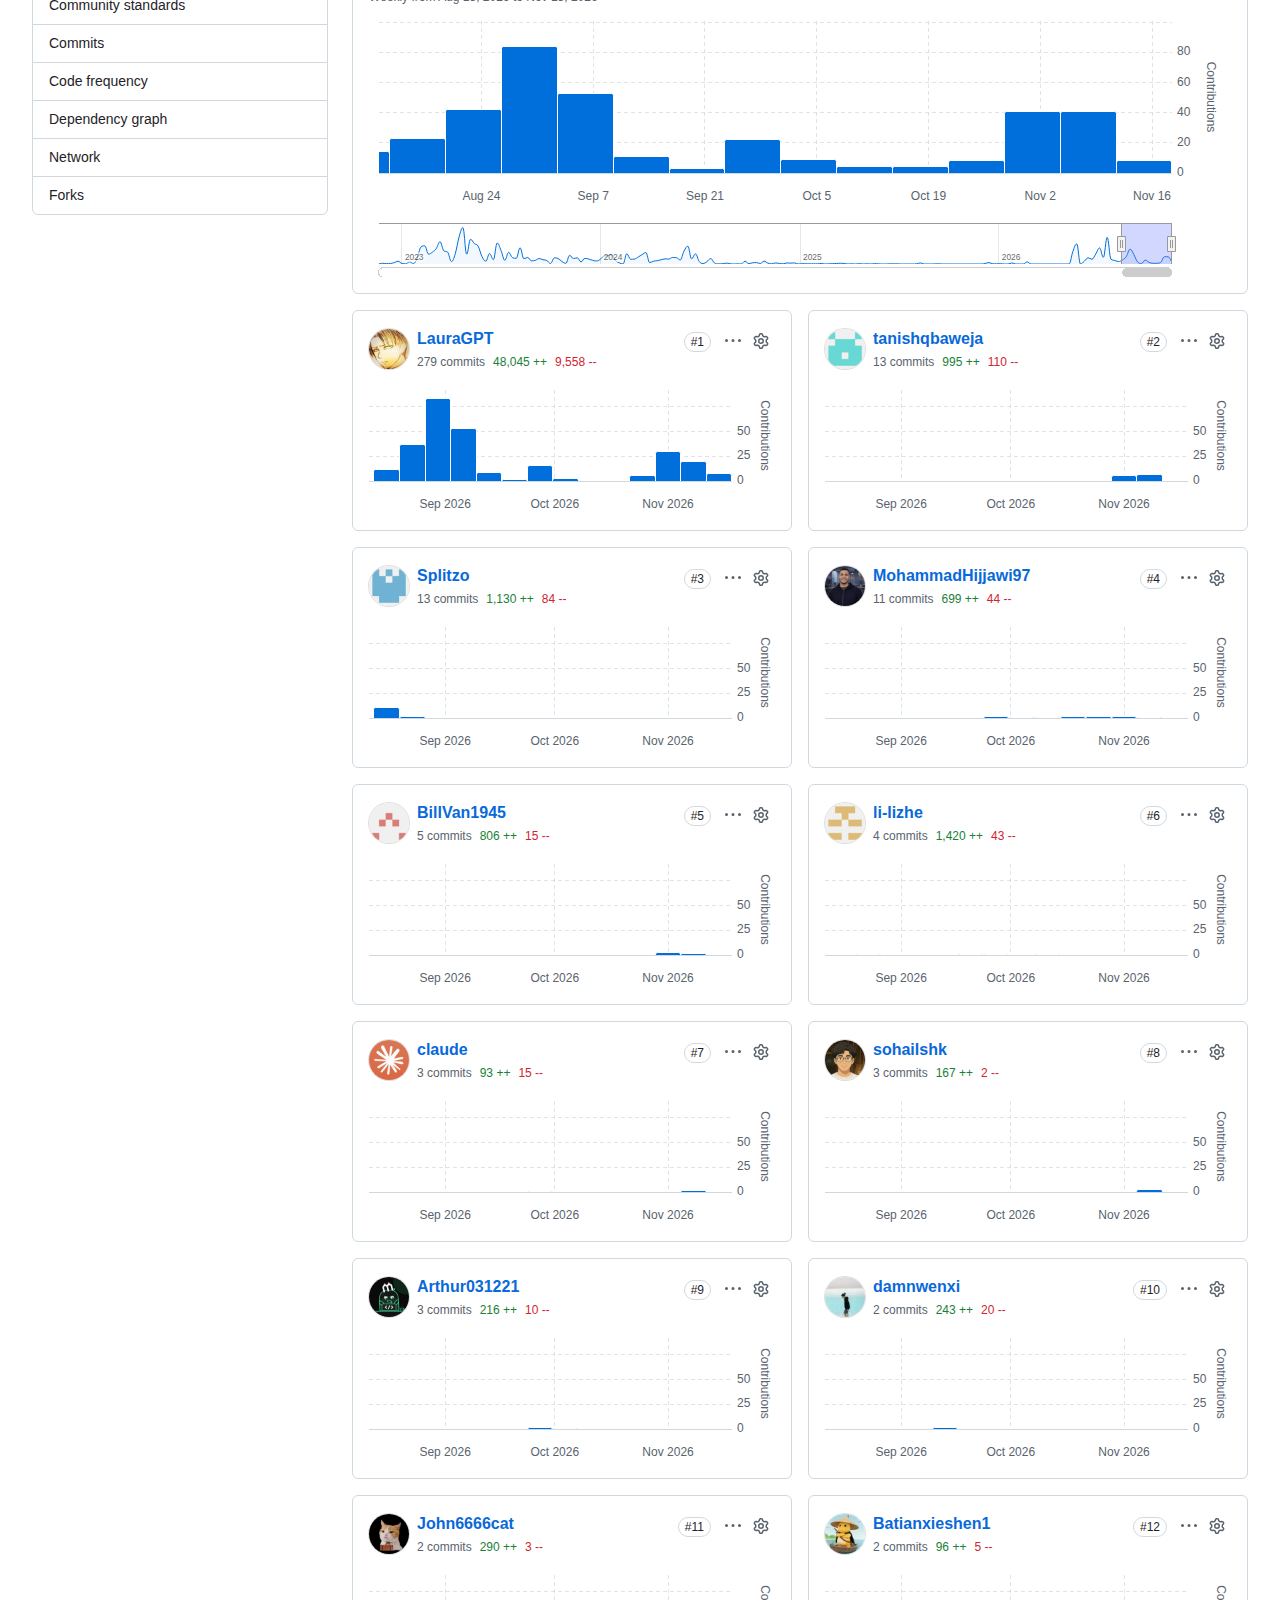
版本節奏相當密集。README 的更新紀錄顯示,1.4.17 至 1.4.27 之間共十一個版本,多數間隔數日,內容以邊界條件修正與時戳對齊為主,而非功能擴張。
FunASR 有哪些限制?
模型能力與後端支援並不對等,部分檢查點需特定執行環境;說話人編號僅在單段錄音內有效;中文效能宣稱未附公開測試條件;非預設正規化設定的檢查點需要重新評估。
第一項限制在文件中反覆出現。選擇某個模型只代表該檢查點具備某項能力,實際能否使用取決於執行後端是否實作對應介面,llama.cpp、ONNX 與 Python 三條路徑的能力並不一致。
第二項關於說話人分離。系統給出的是錄音內的匿名編號,不支援已註冊說話人身分辨識,也不適合用於門禁或身分驗證類場景。
第三項是效能數字的舉證程度。中文錯誤率優於 whisper.cpp 三倍的說法出現在 README 說明段落,缺少音訊集、硬體與量測方式,屬於專案自述而非獨立評測。
第四項關於升級風險。以非預設正規化參數訓練的模型在版本升級後需重新評估品質,這對已有客製檢查點的團隊構成額外驗證成本。
出處連結有哪些?
專案原始碼、模型庫、部署文件與版本說明均可於 GitHub 儲存庫及其文件站取得,模型權重另存於 ModelScope 與 Hugging Face。
主要入口為 GitHub 儲存庫 modelscope/FunASR,Python 套件以 funasr 名稱發佈於 PyPI。文件站提供模型選擇指南、部署矩陣、vLLM 分離引擎說明與歷史基準報告。模型權重分存於 ModelScope 與 Hugging Face 兩個平台,GGUF 版本另設獨立頁面。
- 儲存庫:https://github.com/modelscope/FunASR
- 文件站:https://modelscope.github.io/FunASR/
- 部署入口:https://www.funasr.com/
- PyPI 套件:https://pypi.org/project/funasr/
總結:FunASR 適合什麼團隊?
適合需要中文或粵語辨識、要求離線部署、或想以相容 OpenAI 介面替換雲端服務的團隊;若只需單一語言且偏好單模型架構,Whisper 系路線的維護成本較低。
這個專案的價值落在組合彈性。它把語音處理拆成可替換的環節,讓團隊按實際瓶頸調整單一零件,例如只換辨識模型、只加說話人分離、或只把服務介面改成相容 OpenAI 的形式。
代價是配置複雜度。多模型管線意味著更多記憶體佔用、更多版本相容組合,以及更長的除錯路徑。文件對此並不迴避,反而用大量篇幅說明邊界與限制。
對台灣與華語圈團隊而言,粵語與中文方言覆蓋是實質優勢,邊緣部署的單一二進位路徑則解決了無 GPU 環境的落地問題。既有 Whisper 使用者若遇上中文辨識瓶頸,遷移指南提供了一條可分段驗證的替換路徑。
