MediaCrawler 是由開發者 NanmiCoder 開源的多平台自媒體數據採集工具,在 GitHub 累積 66,850 顆星標、12,790 次複製與 260 位關注者,支援小紅書、抖音、快手、B 站、微博、百度貼吧與知乎七個平台的關鍵詞搜索、指定帖文與評論採集。專案以 Playwright 保存登入狀態、透過 JavaScript 表達式取得簽名參數,避開對加密演算法進行逆向工程,並以非商業學習授權釋出。本文依據官方儲存庫的說明文件與版本紀錄,整理其功能範圍、技術原理、數據輸出方式與實際採用限制。
MediaCrawler 是什麼?
MediaCrawler 是 NanmiCoder 開源的多平台自媒體數據採集工具,涵蓋七個主流內容平台,以瀏覽器自動化保存登入狀態,並採非商業學習授權釋出。
它是一個以 Python 撰寫的數據採集框架,目標是把主流內容平台的公開資訊轉為結構化資料。與單一平台的爬蟲腳本不同,專案把登入流程、請求簽名、分頁與評論展開等重複工作抽成共用模組,使用者只需切換平台參數即可改變採集目標。專案於 2023 年 6 月 9 日建立,主要語言為 Python,並以 TypeScript 撰寫內建的網頁操作介面。
儲存庫在 2026 年 10 月 10 日仍有提交紀錄,內容以說明文件更新與贊助商資訊為主,顯示專案維持活躍但已偏向維運階段。README 同時公開聲明,專案定位為技術研究與學習工具,禁止用於大規模採集或商業用途。
MediaCrawler 支援哪些平台與採集功能?
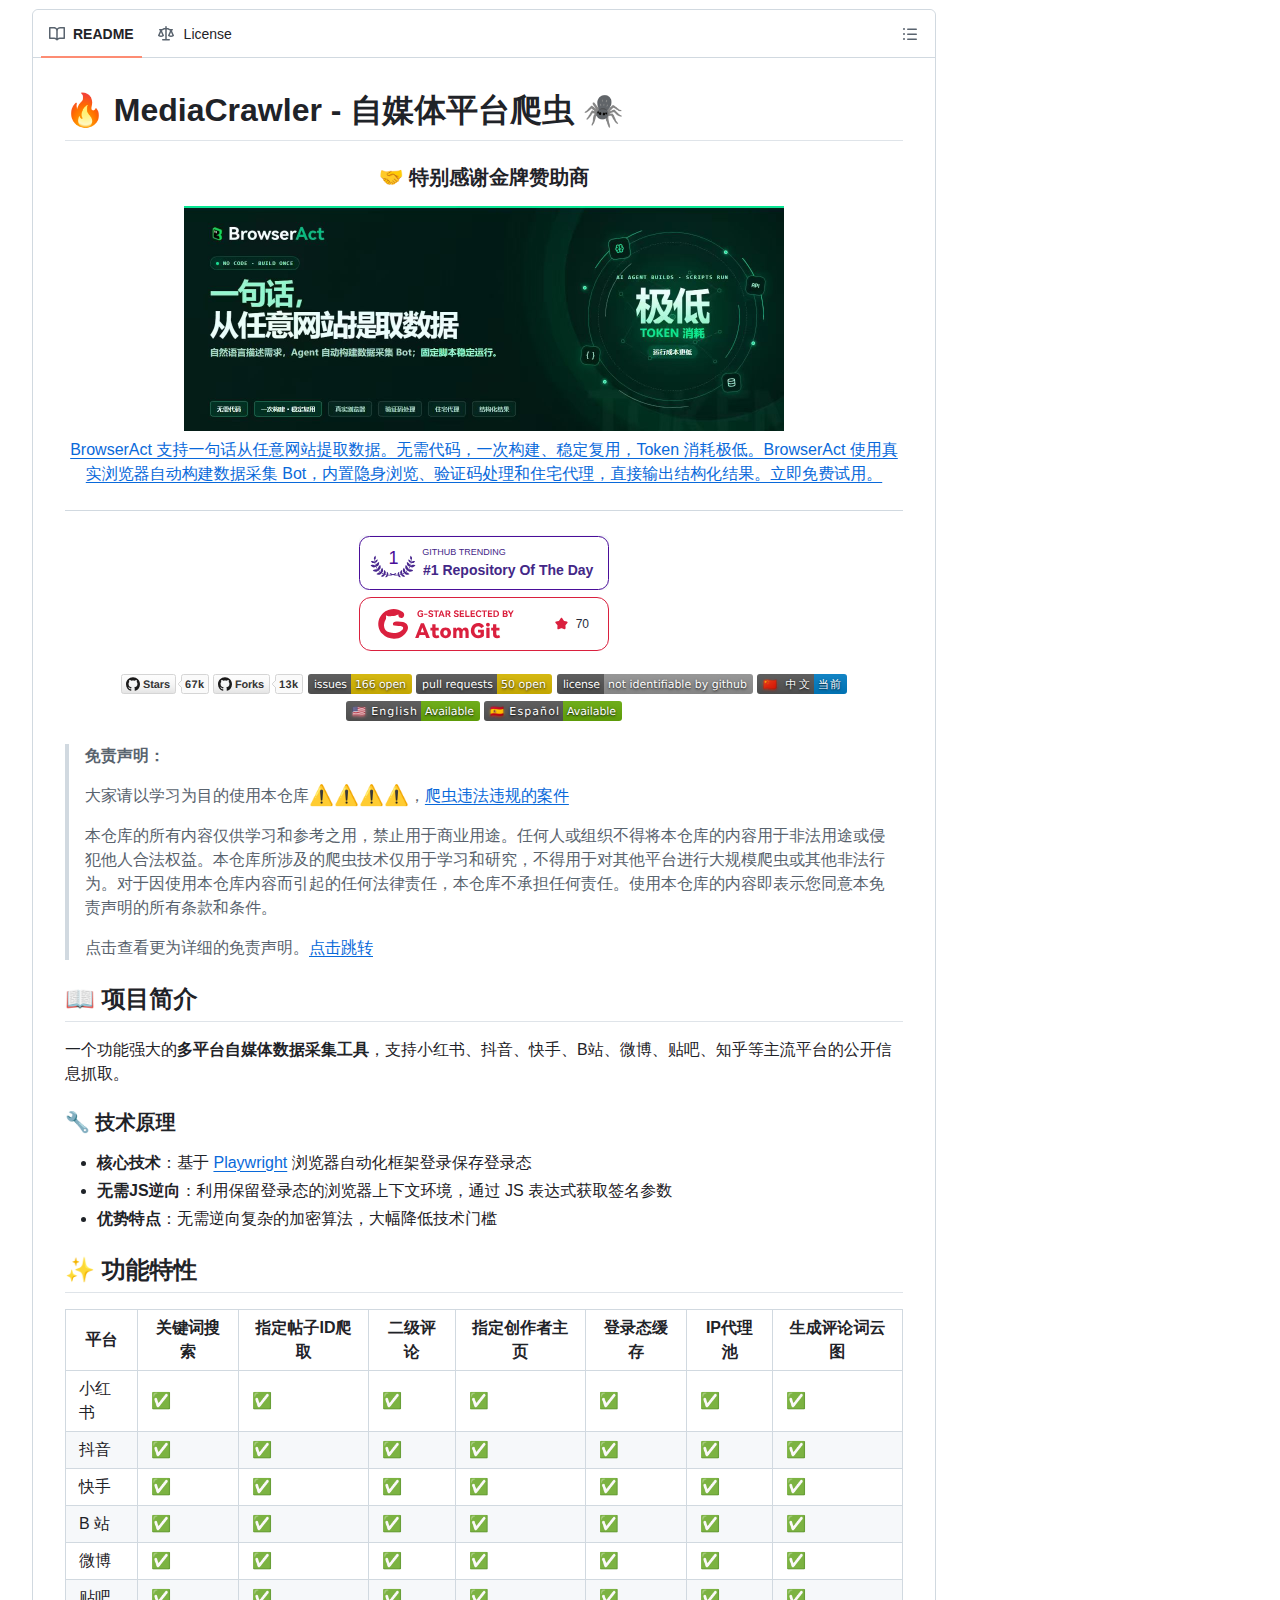
支援小紅書、抖音、快手、B 站、微博、貼吧與知乎七個平台,可依關鍵詞搜索或指定帖文採集,並含二級評論、創作者主頁、登入態快取與評論詞雲圖。
平台覆蓋範圍是專案最直接的差異點。README 的支援矩陣以七個平台為列、功能為欄,逐項標示支援狀態,其中關鍵詞搜索、指定帖文採集、二級評論、指定創作者主頁、登入態快取、IP 代理池與評論詞雲圖在多數平台均可使用。這種以矩陣方式公開完整度的做法,讓使用者在部署前就能判斷目標平台是否具備所需能力。
採集入口分為兩種模式。關鍵詞模式會依設定檔中的關鍵詞搜索相關帖文,再批次抓取帖文資訊與評論;指定 ID 模式則接受帖文連結或編號清單,只針對特定內容展開。媒體檔案另設獨立開關,開啟後會依帖文聚合存放封面、影片與圖文圖片,其中 B 站的最高畫質影片需先安裝 ffmpeg,才能以音視訊分軌下載後合流的方式取得。
MediaCrawler 的技術原理有什麼特別之處?
它不逆向加密簽名,而是用 Playwright 保存的登入態瀏覽器上下文,直接以 JavaScript 表達式取得簽名參數,並可改用 CDP 模式連接既有 Chrome。
核心思路是繞開演算法逆向。多數平台的請求需要帶有簽名參數,傳統做法是還原壓縮後的 JavaScript 以推導簽名邏輯,工程成本高且容易因平台更新而失效。專案改為保留已登入的瀏覽器上下文,在頁面環境內直接以 JavaScript 表達式取得簽名,再把結果帶入請求,因此不必理解加密演算法的內部結構。
CDP 模式進一步降低被偵測的機率。專案預設連接使用者既有 Chrome 的遠端除錯埠,可沿用瀏覽器原有的登入狀態、Cookie 與擴充功能,執行時瀏覽器會彈出確認對話框,需在六十秒內確認。若改用標準 Playwright 模式,則需另外安裝瀏覽器驅動,且每次啟動都是乾淨環境,較容易觸發平台的風控機制。
MediaCrawler 支援哪些數據儲存與輸出方式?
支援 CSV、JSON、Excel、SQLite 與 MySQL 等六種儲存方式,並提供 FastAPI 搭配 Vite 的 WebUI,可視覺化設定參數並即時查看日誌。
輸出層的選擇相當完整。專案支援以 CSV、JSON、JSONL、Excel、SQLite 與 MySQL 保存結果,官方文件另有一份數據儲存指南說明各格式的設定方式;對於需要後續分析的團隊,直接寫入關聯式資料庫可省去轉檔步驟,也利於與既有報表流程銜接。
操作介面降低了使用門檻。內建的 WebUI 由 FastAPI 後端與 Vite 前端組成,開發時分別啟動兩個服務,生產環境則可先建置前端再由後端統一提供靜態資源。介面提供爬蟲參數設定、執行狀態與日誌檢視、資料預覽與匯出等功能。環境依賴方面,套件管理建議使用 uv 以確保版本一致,而抖音與知乎的採集另需 Node.js 十六以上版本。
MediaCrawler 的專案數據表現如何?
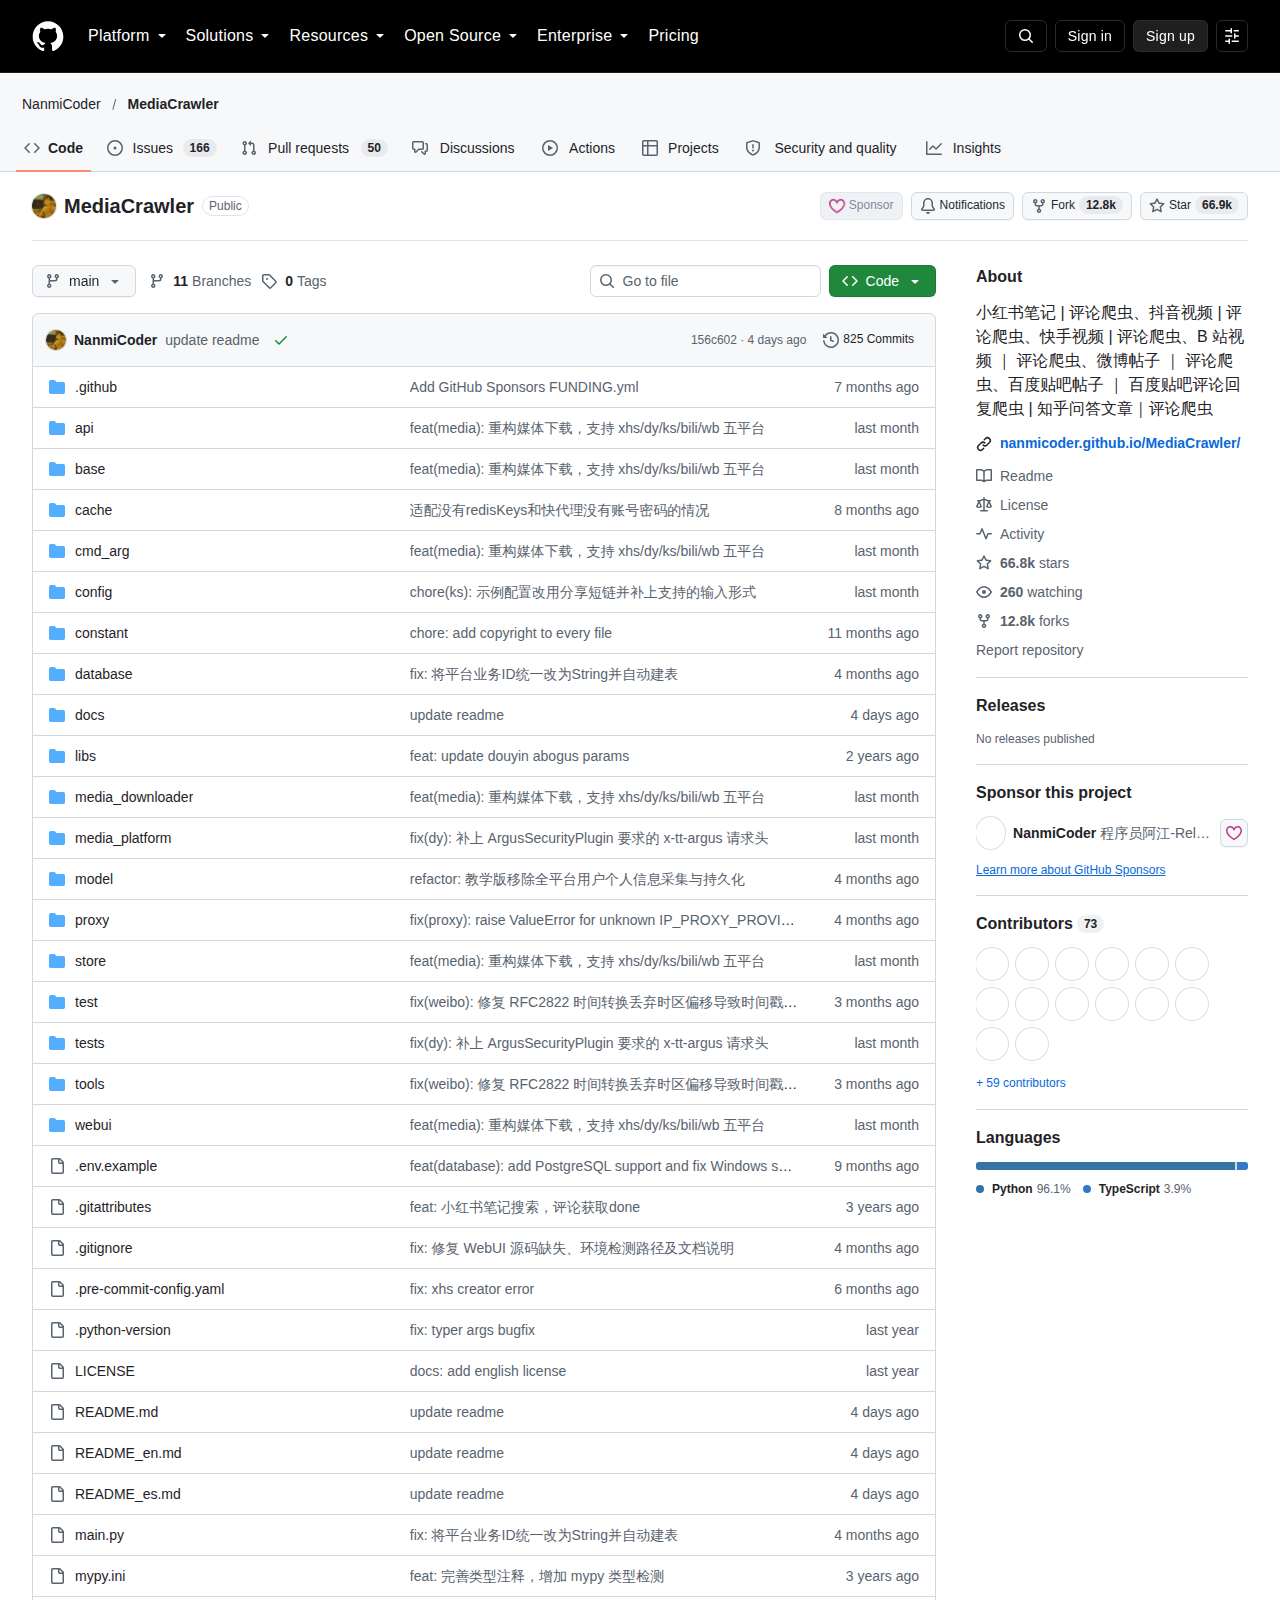
專案累積 66,850 顆星標、12,790 次複製、74 位貢獻者與八百多次提交,未結議題約 216 個,且未發布任何正式版本,授權為非商業學習條款。
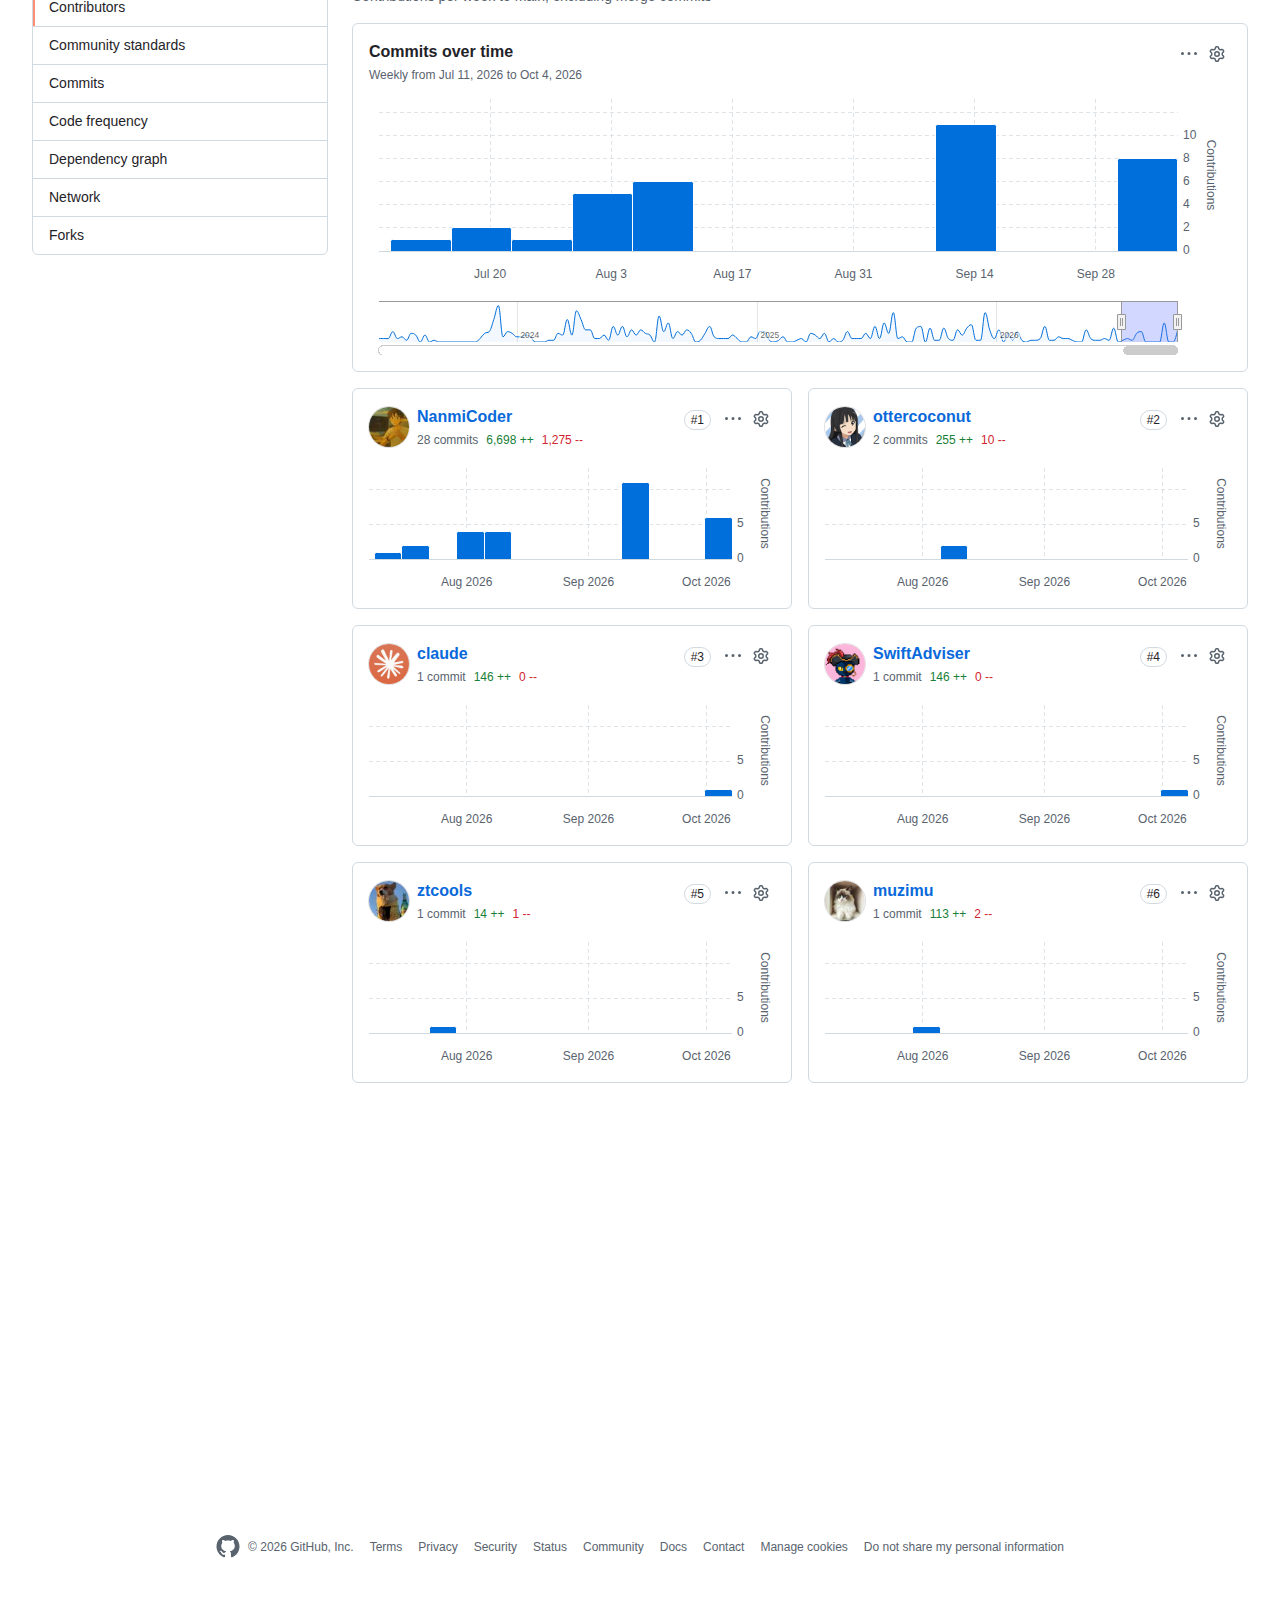
社群結構高度集中。貢獻者清單顯示主要維護者個人貢獻約 590 次提交,其餘貢獻者多為個位數,說明專案由單一作者主導,社群補位有限。未結議題維持在 216 個、未結合併請求約 50 個,而專案從未發布任何標籤或正式版本,使用者只能追蹤主分支,缺乏版本化升級路徑。
MediaCrawler 在開源採集工具生態中的定位如何?
它的差異在於把多個華語內容平台的登入與簽名流程標準化,與通用爬蟲框架形成互補;商業化則以商業版訂閱與代理服務商贊助為主。
與通用爬蟲框架相比,位置不同。Scrapy 等框架處理的是請求排程、去重與管線等通用問題,使用者仍需自行解決各平台的登入與簽名;MediaCrawler 則把這些平台專屬的瑣碎細節內建,代價是通用性較低、僅覆蓋特定內容平台。對需要跨平台觀察華語社群輿情的團隊,前者的取用成本明顯較高。
商業路徑圍繞採集基礎設施展開。專案另設訂閱制的商業版本,主打斷點續爬、多帳號與 IP 代理池、去除 Playwright 依賴等功能;README 同時陳列多家代理服務商與 AI 模型聚合平台的贊助資訊,並表示 Pro 版本附帶多個 AI 代理專案原始碼。這種以贊助與訂閱支撐開源核心的模式,讓基礎功能維持免費,但核心工程能力保留在商業版本。
MediaCrawler 有哪些授權與合規限制?
授權為非商業學習條款,禁止商業用途與大規模採集;README 另附完整免責聲明,使用者需自行承擔資料合規、平台風控與相關法律責任。
授權條款是最關鍵的門檻。專案採用名為「非商業學習授權 1.1」的自訂條款,授權範圍僅限非商業的學習與研究用途,明確禁止未經書面同意的商業使用,也禁止用於大規模爬取或影響平台運作的活動。這與常見的開源授權不同,企業若計畫把採集結果投入產品或營利流程,需先取得著作權人的書面同意。
合規風險落在使用者身上。README 以顯著篇幅列出免責聲明,援引網路安全法與反間諜法等法規,強調使用者須自行承擔因使用專案而產生的法律責任,並要求遵守各平台的服務條款。實務上,登入態快取與代理池等功能雖能降低被攔截機率,卻不改變採集行為本身在平台政策下的定性,重要場景應先完成法律與風控評估。
MediaCrawler 常見問題有哪些?
以下整理部署環境需求、為何預設連接既有瀏覽器、資料輸出位置與支援平台範圍等常見疑問,協助評估導入前的準備工作。
部署 MediaCrawler 需要什麼環境?
環境需求以 Python 為主,官方建議使用 uv 管理虛擬環境與相依套件,並要求 Node.js 十六以上版本以支援部分平台的採集。若採用標準 Playwright 模式,需另外安裝瀏覽器驅動;若使用預設的 CDP 模式,則需安裝 Chrome 一百四十四以上版本,並開啟遠端除錯功能。
為什麼預設要連接使用者既有的瀏覽器?
因為平台風控會檢查登入環境的完整性。沿用既有 Chrome 可保留登入狀態、Cookie 與擴充功能,使請求特徵更接近真實使用者;反之,每次以乾淨環境啟動的自動化瀏覽器較容易被識別並攔截。
採集結果會存放在哪裡?
資料落盤位置由設定檔的存放路徑決定,未設定時會落在專案目錄下的資料夾。媒體檔案預設關閉,開啟後會依帖文編號建立子目錄,分別存放封面、影片與圖文圖片;貼吧與知乎的資料結構不含媒體欄位,因此不支援媒體下載。
出處連結有哪些?
本文資訊整理自 NanmiCoder/MediaCrawler 的 GitHub 儲存庫,涵蓋 README 支援矩陣、技術說明、數據儲存文件與授權條款內容。
- GitHub 儲存庫:https://github.com/NanmiCoder/MediaCrawler
- 官方文件:https://nanmicoder.github.io/MediaCrawler/
- 授權條款:https://github.com/NanmiCoder/MediaCrawler/blob/main/LICENSE
- 商業版本:https://github.com/MediaCrawlerPro
總結:MediaCrawler 適合什麼團隊?
適合以研究與學習為目的、需要跨多個華語內容平台採集公開資料的技術人員;若涉及商業用途或大規模採集,須先取得授權並完成合規評估。
專案的價值在於把繁瑣的平台適配工作收斂為可重複使用的模組。66,850 顆星標與七個平台的支援矩陣,反映的是華語內容生態長期缺乏統一採集介面的現實需求;以登入態繞開簽名逆向的取徑,也讓不熟悉前端混淆技術的使用者得以進入這個領域。
採用前仍須衡量三件事:授權條款是否允許預期用途、專案高度集中的維護結構能否承接長期需求,以及採集行為在平台政策與地方法規下的合規風險。對研究導向、能自行承擔技術與法律責任的使用者,這是一套成熟度相當高的工具;對需要商用授權與版本化支援的團隊,商業版本或合規的資料服務供應商會是更穩妥的選擇。