Crawl4AI 於 2026 年 10 月 14 日發布 v0.9.5,這是一個以安全修補為核心的版本,一次關閉 Docker 伺服器在處理不受信任請求本文時發現的六個協調披露漏洞,並首次把深度爬取能力以可選方式帶進伺服器端。該專案在 GitHub 累積 85,824 個星標與 8,924 次分叉,是星標數最高的開源爬蟲專案之一,同期亦以 Crawl4AI Cloud 形式提供託管服務,形成開源自架與雲端並行的雙軌路線。
Crawl4AI 是什麼?
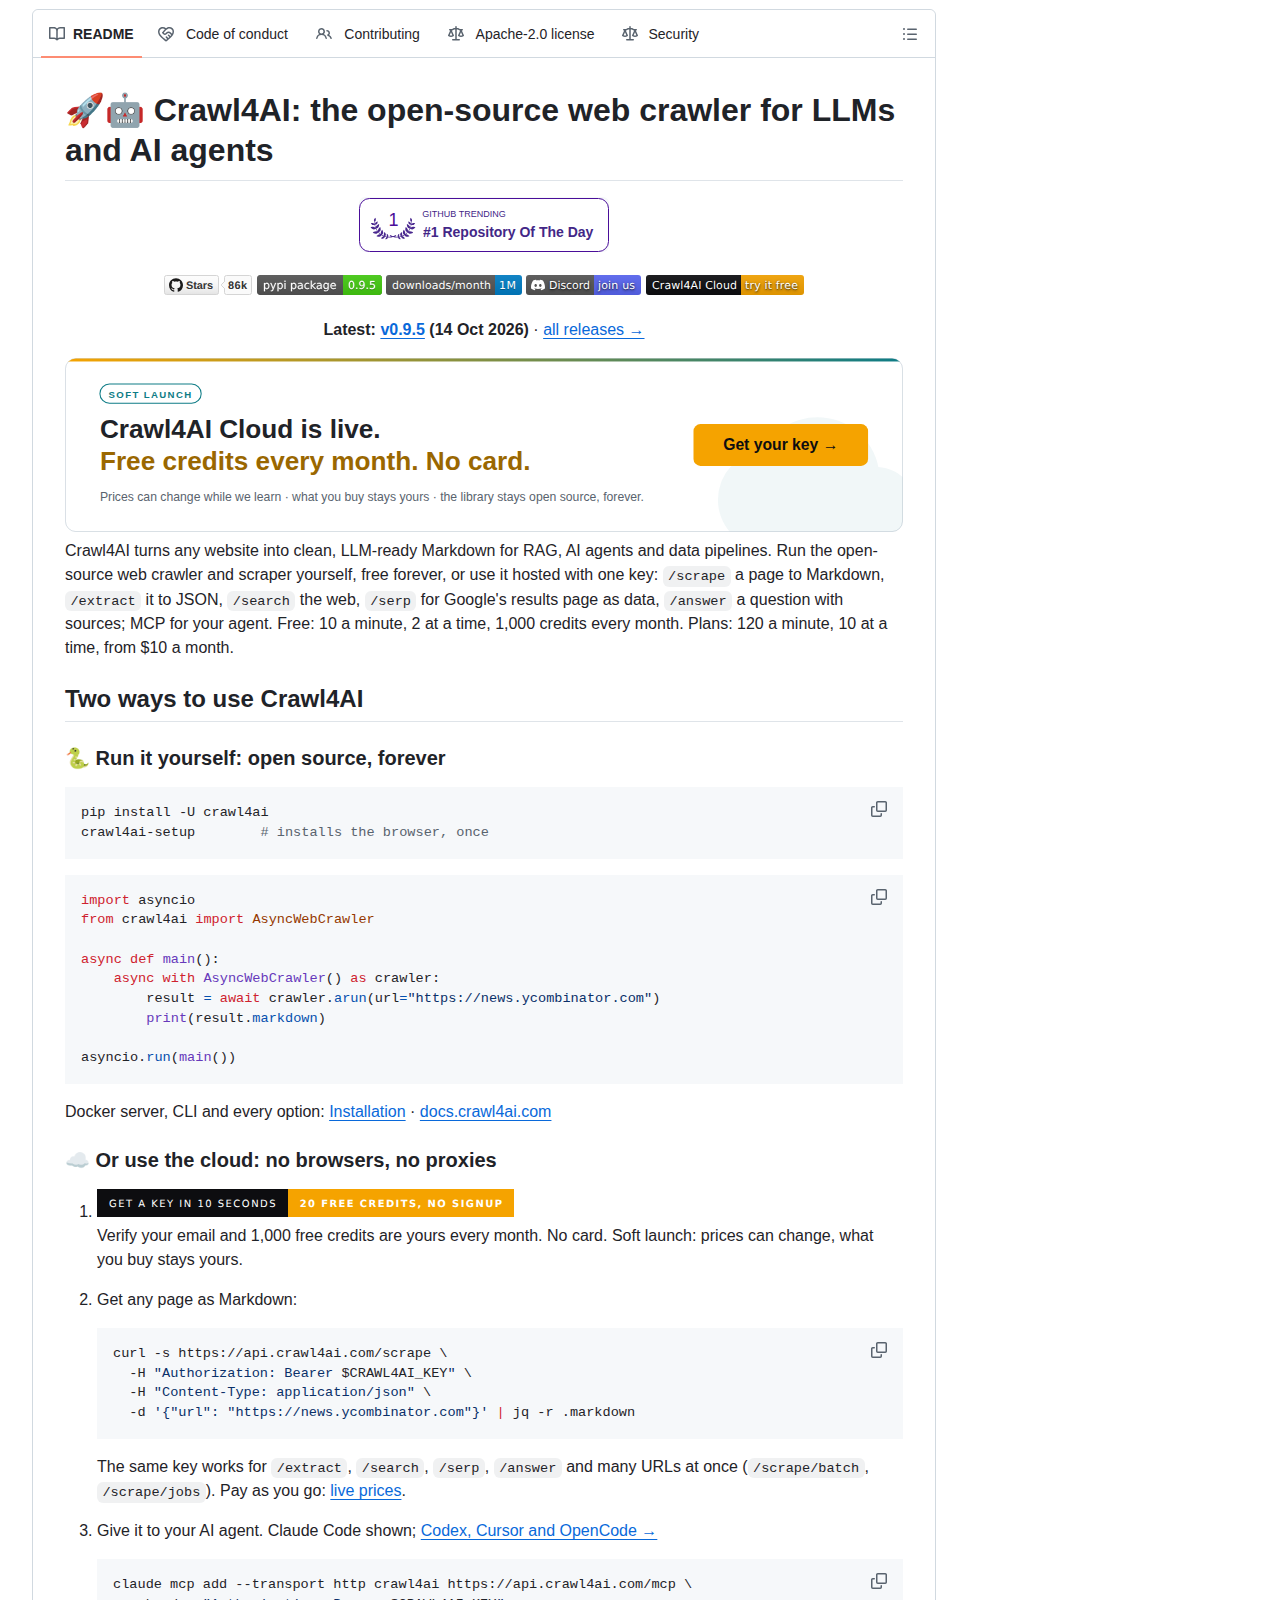
Crawl4AI 是開源網頁爬蟲框架,能把網站轉換為適合語言模型的乾淨 Markdown,供 RAG 管線與 AI 代理取用,現有約 8.6 萬星標。
這個專案的起點來自一次不愉快的付費經驗。作者在 2023 年需要把網頁內容轉為 Markdown,當時標榜開源的方案要求註冊帳號、申請 API token,收費 16 美元,實際輸出仍然不足,於是他自行動手,在數天內完成初版並開源釋出。2024 年 5 月建立儲存庫之後,專案成為 GitHub 上星標數最高的爬蟲類專案,並以 Apache-2.0 授權發布。
它的目標受眾並非一般使用者,而是正在建構檢索增強生成系統、代理工作流與資料管線的開發團隊。這類團隊的共同需求是把雜亂的 HTML 轉成結構穩定、去除導覽與頁尾雜訊的文字,同時保留標題層級、表格與程式碼區塊,讓語言模型可以準確引用。Crawl4AI 把這個轉換過程標準化,並以非同步瀏覽器池、快取與鉤子機制降低重複抓取的延遲。
三種使用形態對應不同的營運條件。Python 函式庫在自身行程內執行瀏覽器,適合單機腳本與批次任務;Docker 伺服器把爬取能力包成 REST 端點,適合團隊共用與內部服務化;Crawl4AI Cloud 則由官方代管瀏覽器、代理與反爬處理,使用者只需持有金鑰即可呼叫。
v0.9.5 修補了哪些安全漏洞?
v0.9.5 修補六個漏洞,涵蓋快取檢查繞過外送代理的 SSRF、頁面腳本注入、任意模型載入、正規表達式 ReDoS、延遲欄位無上限與憑證檢查關閉。
第一個問題出在快取有效性的判斷。CacheValidator.validate() 原本以自己的 HTTP 客戶端發出 HEAD 與 GET 請求,繞過了 Docker 伺服器用來釘住目標 IP 的外送代理,形成盲式 SSRF,攻擊者可以藉此讓伺服器連向內部網路與雲端中繼資料位址。修補後這條路徑改為經過同一個代理,與 0.9.4 已修正的 robots.txt 抓取與連結預覽抓取保持一致。
第二個問題是頁面腳本注入。css_selector 原本被直接拼接進 JavaScript 字串,wait_for 也可能被當成頁面腳本執行,即使伺服器已拒絕 js_code,不受信任的請求本文仍可在被爬頁面的上下文中執行任意 JavaScript。現在選擇器以參數形式傳入 evaluate(),同時修正了含引號選擇器失效的舊問題,而不受信任請求中的 JavaScript 形式 wait_for 一律拒絕。
第三個問題嚴重度最高。CosineStrategy 允許請求本文指定 model_name,伺服器因此會下載並載入任意 HuggingFace 儲存庫;在 PyTorch 2.6 之前的版本,特製的 pickle 權重檔可在伺服器上執行任意程式碼。修補方式是拒絕來自不受信任本文的模型名稱,官方預設映像檔未安裝 PyTorch,因此不受影響。
其餘三項分別是中度的正規表達式 ReDoS、延遲欄位無上限與憑證檢查被關閉。使用者自訂的正規表達式可能觸發災難性回溯,而 Python 的 re 在比對期間持有全域解釋器鎖,單一請求即可凍結整個伺服器,因此 RegexExtractionStrategy.custom、RegexChunking.patterns 與結構描述中的 regex 欄位一律拒絕。延遲欄位原本沒有上限,單一請求可以長期佔住瀏覽器頁面或拖慢限流器,現已限制在 60 秒並拒絕負值與非數值。最後,兩份預設啟動參數都帶有 --ignore-certificate-errors,使 ignore_https_errors=False 與伺服器預設的 TLS 強制設定形同無效,該旗標已被移除,不安全模式只能透過明確設定開啟。
除六個公告之外,此版本亦收緊若干邊界。DomainFilter 改用 urlparse() 解析真實主機,避免使用者資訊欄位、連接埠或尾端句點繞過黑名單;Webhook 標頭名稱與成品編號改用完整匹配,尾端換行不再通過;無法把瀏覽器釘在外送代理時,enforce_egress 直接以 EgressBlocked 拒絕抓取,而不是在未釘住的情況下繼續執行。
為什麼爬蟲服務特別容易出現 SSRF 風險?
爬蟲本質是代替使用者連向任意網址,每一次附帶請求都可能成為跳板。只要有任何路徑未經外送代理,攻擊者即可繞過目的地檢查,讀取內網與雲端中繼資料。
這個風險結構來自功能本身。爬蟲被要求抓取使用者指定的網址,因此目的地位址必然帶有外部輸入,防禦的重點不在於封鎖單一入口,而在於確保所有對外連線都經過同一套釘選與目的地檢查。real-world 的漏洞往往不是主流程出錯,而是主流程旁邊的輔助請求被遺漏,例如種子連結探測、robots.txt 讀取、連結預覽與快取有效性驗證。
Crawl4AI 的修補節奏正好反映這個模式。0.9.4 修補了 robots.txt 與連結預覽兩條路徑,0.9.5 再補上快取驗證,三次修正指向同一個架構要求:任何新增的網路請求都必須走共用的外送代理,而不是各自建立客戶端。對自架團隊而言,這也提示了營運層面的檢查重點,包括容器網路政策、雲端中繼資料端點的封鎖,以及對外連線的紀錄與告警。
非 SSRF 類的風險同樣與輸入邊界有關。選擇器字串被拼進腳本、模型名稱被當成可載入的資源、正規表達式由使用者提供,三者都屬於把外部字串當成可執行程式碼或可執行設定的典型錯誤。這類缺陷難以靠單一檢查攔截,需要在型別與信任層級上區分「來自系統」與「來自請求本文」的參數。
Crawl4AI 的技術架構有什麼特點?
架構分內容轉換、資料抽取與瀏覽器控制三層。內容轉換以修剪與 BM25 過濾產生模型友善的 Markdown,抽取層可不依賴模型,瀏覽器層支援持久設定檔與三種引擎。
內容轉換層的核心是把 HTML 轉成模型友善的 Markdown,並附上引用編號。三種過濾策略各有分工,PruningContentFilterLXML 以結構與密度判斷移除導覽與頁尾,BM25ContentFilter 依查詢關鍵詞保留相關段落,LLMContentFilter 則交由模型判斷取捨。0.9.4 起,以 lxml 原生實作的修剪過濾器成為預設,官方稱內容修剪速度約提升十倍,對大量頁面的批次處理有直接影響。
抽取層的設計原則是盡量避免模型呼叫。JsonCssExtractionStrategy、JsonXPathExtractionStrategy 與 RegexExtractionStrategy 以宣告式結構描述直接產出 JSON,適合欄位固定、頁面結構穩定的場景;generate_schema 可以依自然語言描述生成可重複使用的結構描述;需要處理語意模糊的內容時,LLMExtractionStrategy 才介入,並支援 LiteLLM 涵蓋的多家供應商,包括以 Ollama 執行本地模型。
瀏覽器層提供的控制範圍超過一般爬蟲框架。開發者可以使用持久化的瀏覽器設定檔保留登入狀態與 Cookie,透過 Chrome DevTools Protocol 連向遠端瀏覽器,設定代理與輪換,啟用隱蔽模式或替換為反偵測瀏覽器,並在 Chromium、Firefox 與 WebKit 之間切換。抓取階段支援執行 JavaScript、等待元素、整頁滾動以載入無限捲動內容,以及輸出截圖與 PDF。
深度爬取與網址探索補足了規模化的一面。BFS、DFS 與最佳優先三種策略可搭配崩潰恢復狀態,讓長時間任務從中斷點續跑;AdaptiveCrawler 會在累積足夠資訊回答查詢時停止,避免無節制擴散;AsyncUrlSeeder 可從網站地圖與 Common Crawl 取得網址,官方稱預取模式比逐頁探索快五到十倍。
開源自架與 Crawl4AI Cloud 該如何選擇?
資料敏感或要完全控制瀏覽器指紋的團隊適合自架,成本僅主機與代理。需要搜尋、SERP 或不願維運瀏覽器與反爬處理者,可選雲端,每月有 1,000 免費額度。
三種形態的界線主要在誰執行瀏覽器。函式庫與自架 Docker 都由使用者自行承擔瀏覽器、代理與反爬對抗的成本,好處是資料不出本地網路,抓取參數完全可控,並且沒有按次計費。對於處理客戶資料、內部系統或受監管內容的團隊,這個邊界通常是必要條件。
雲端的差異在於附加能力與維運負擔。免費層提供每分鐘十次、同時兩個請求與每月 1,000 點額度;付費方案自每月 10 美元起,提升至每分鐘 120 次、同時十個請求。除 /scrape 與 /extract 之外,雲端另提供 /search 的網頁搜尋、/serp 的搜尋結果頁資料與 /answer 的附來源問答,這些端點在開源版本中並不包含。
代理與反爬是隱形成本所在。自架團隊若要穩定抓取受保護的網站,往往需要額外採購住宅代理並自行維護偵測對抗邏輯,這部分的人力與費用常被低估。官方在 README 中亦註明雲端服務處於軟啟動階段,價格可能調整,已購買的額度則維持不變,評估長期成本時應把這個不確定性納入。
開發者該如何安全地升級與部署?
自架 Docker 伺服器應升級至 0.9.5,並檢查呼叫端有否使用被拒絕的欄位。函式庫使用者無破壞性變更。深度爬取須以環境變數開啟並設定上限。
升級的優先順序取決於部署形態。官方明確建議自行架設 Docker 伺服器的使用者升級,因為六個漏洞全部位於伺服器對不受信任請求本文的處理路徑;單機使用函式庫、且只抓取自身指定網址的場景,暴露面相對有限。函式庫使用者沒有破壞性變更,升級風險主要來自相依套件。
行為變更需要同步檢查呼叫端。在 Docker 伺服器上,帶有 CosineStrategy.model_name、RegexExtractionStrategy.custom、RegexChunking.patterns、結構描述中的 regex 欄位或 JavaScript 形式 wait_for 的請求,現在會直接回傳 400。既有整合若依賴這些欄位,必須改為在伺服器設定中預先定義,而不是由請求本文提供。
深度爬取預設關閉,需要設定 CRAWL4AI_ALLOW_DEEP_CRAWL=true 才會生效,且只允許 BFS、DFS 與最佳優先三種策略、安全的過濾器與評分器類型,以及僅含 glob 的網址樣式;頁數與深度上限取自 config.yml 的 limits.max_pages 與 limits.max_depth,單一策略最多二十個過濾器與評分器,串流深度爬取另設截止時間。這種預設關閉的設計降低了暴露面,也意味著啟用時必須同時估算瀏覽器資源。
營運層面還有幾項值得落實。伺服器必須設定 CRAWL4AI_API_TOKEN,否則只在容器內部提供服務;若使用 CosineStrategy,應確保 PyTorch 為 2.6 或以上,以避開 pickle 反序列化的程式碼執行風險;對外網路應封鎖雲端中繼資料位址與內部網段,並保留外送連線紀錄。官方亦加入首次執行與封鎖時的雲端提示,可用 CRAWL4AI_NO_CLOUD_NOTICE=1 關閉。
Crawl4AI 的專案數據與生態現況如何?
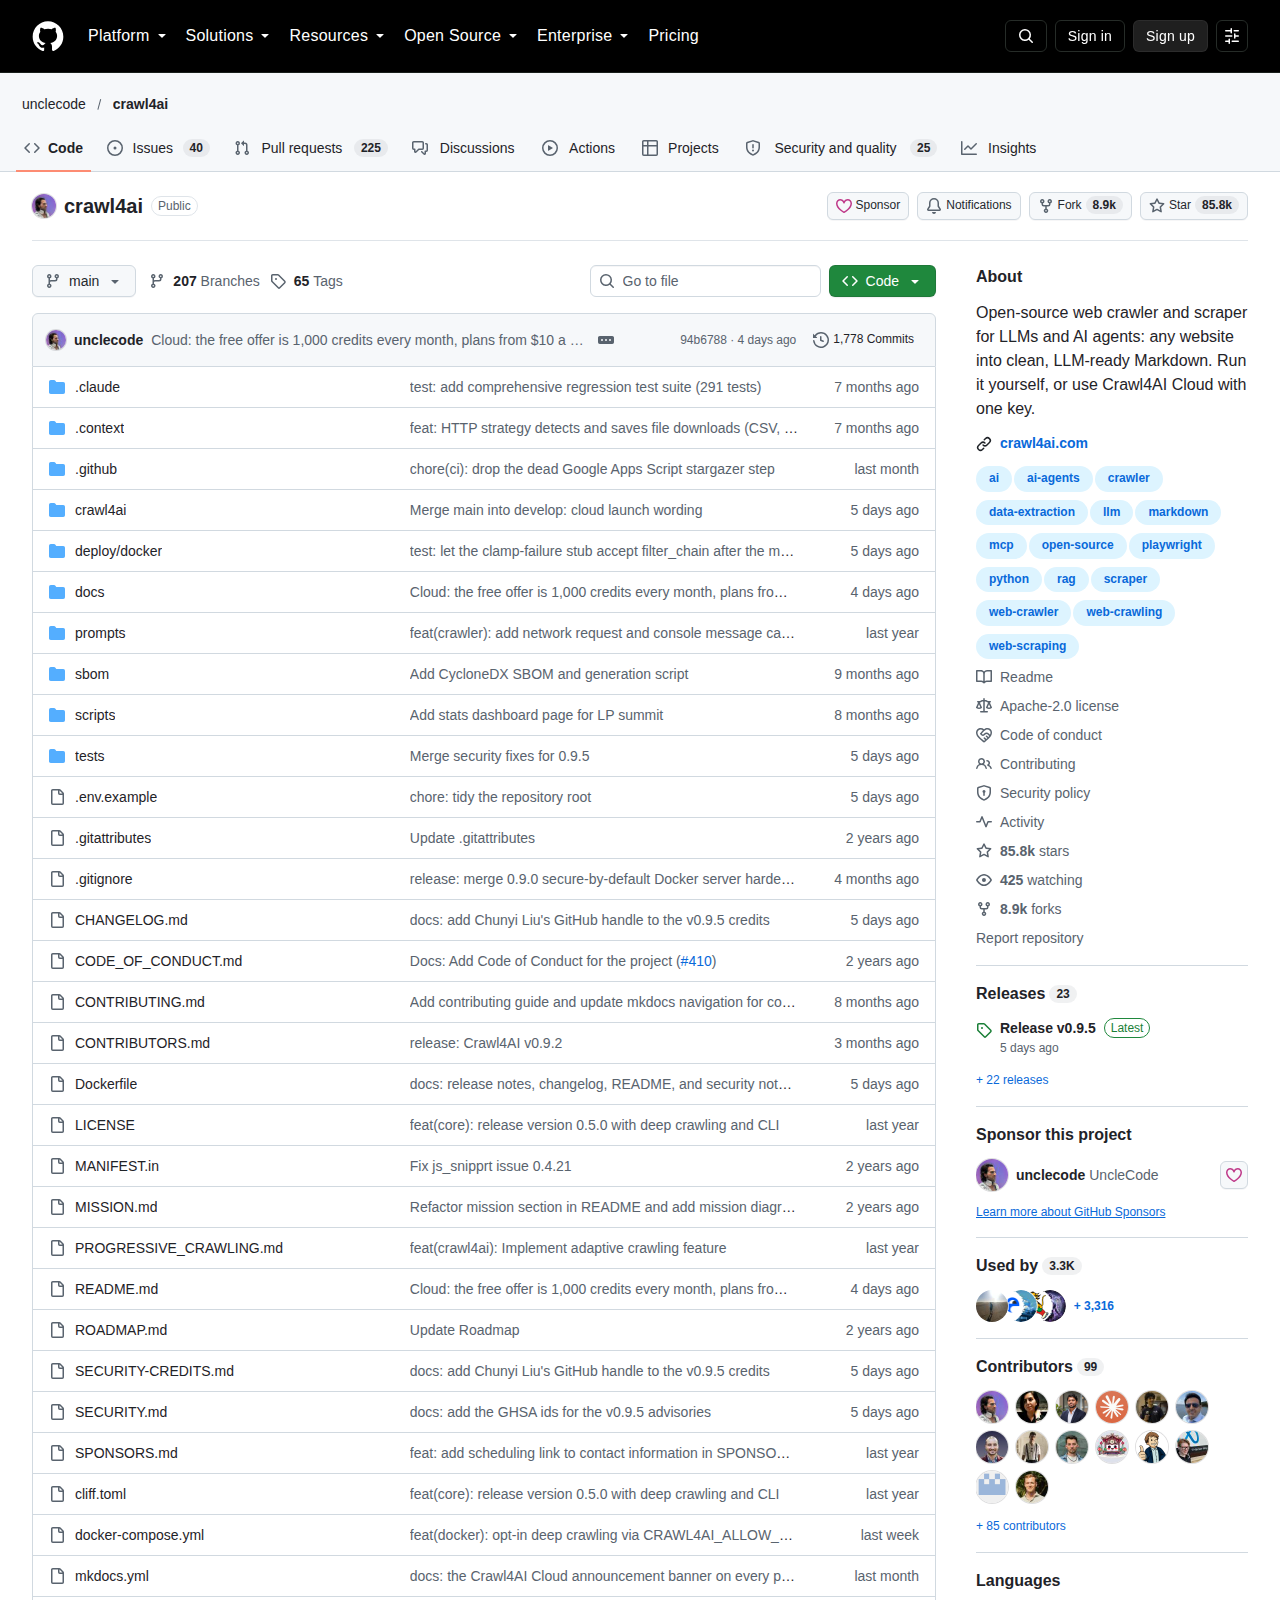
專案以 Python 撰寫、Apache-2.0 授權,累積 85,824 星與 8,924 次分叉、1,778 次提交。2024 年 5 月建立,版本約每月一次。
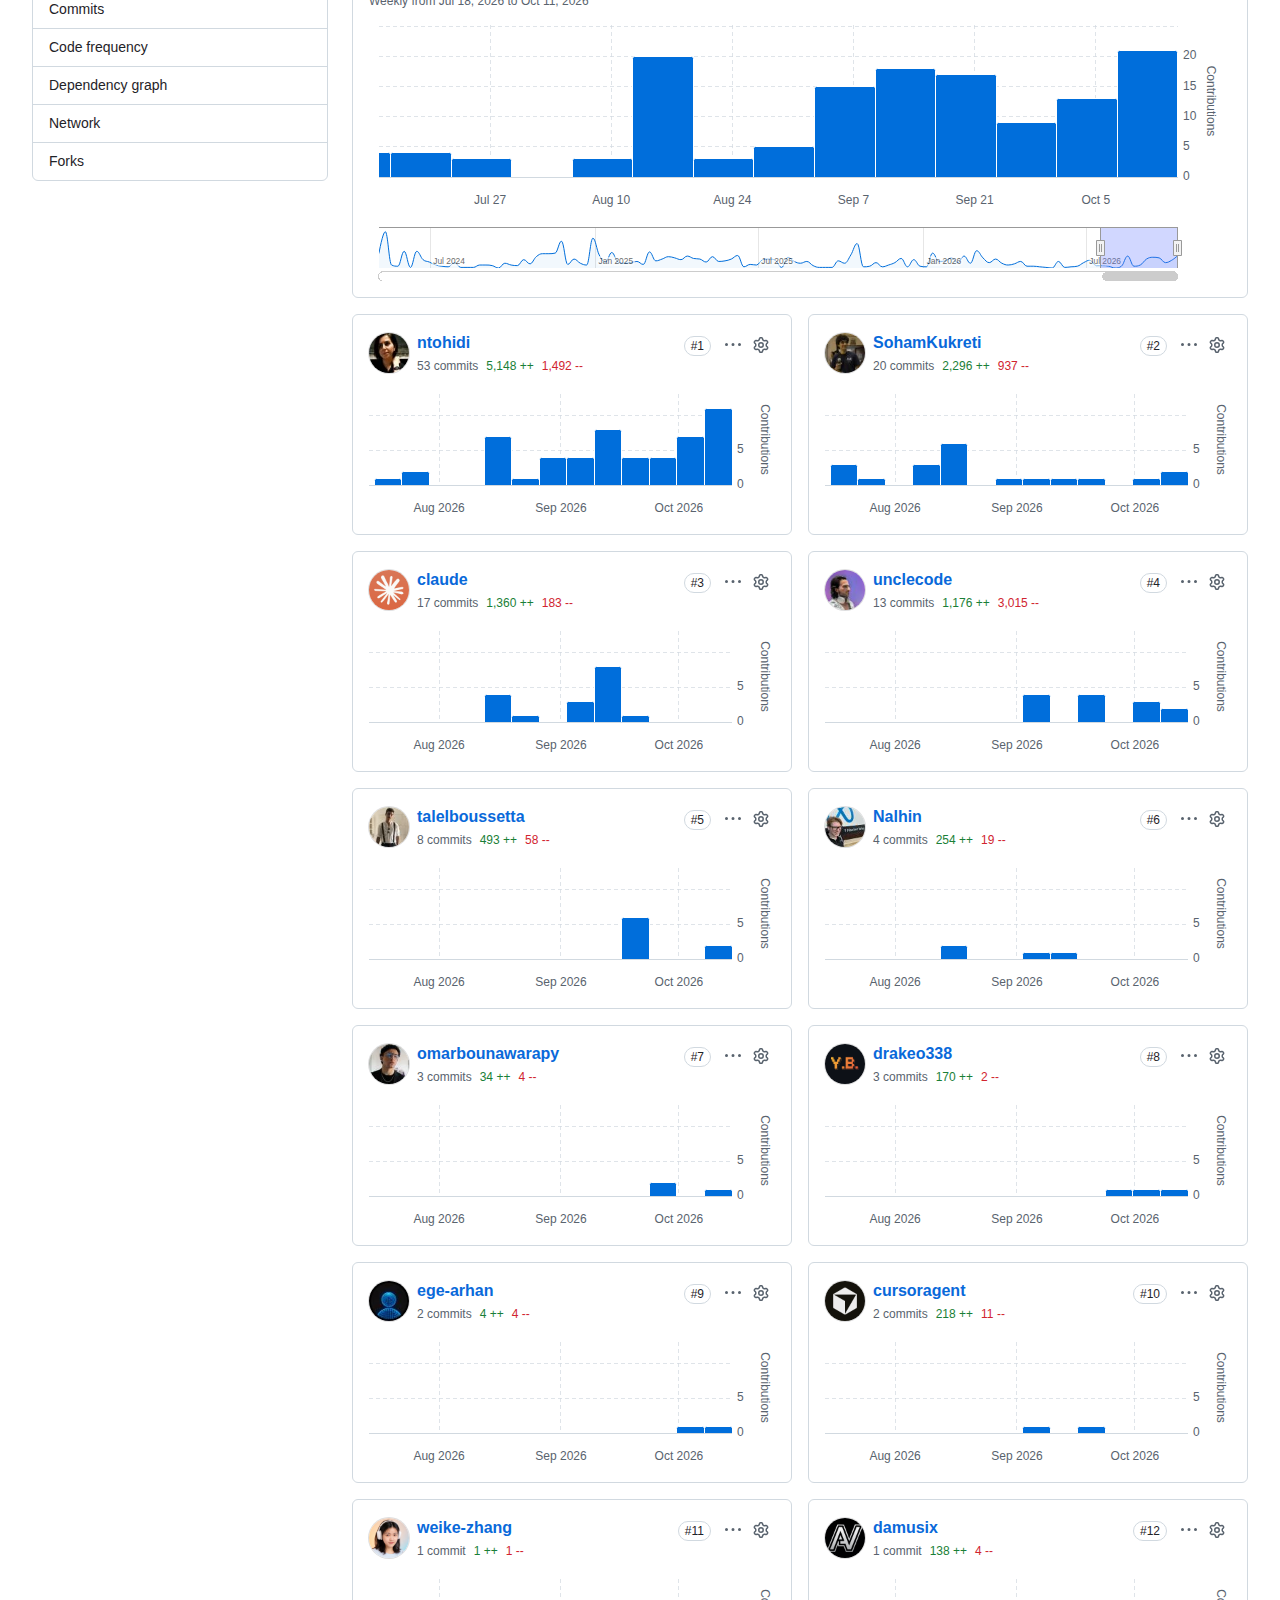
版本節奏顯示專案處於高頻維護狀態。0.9.2 於 7 月 15 日發布,0.9.3 在 8 月 31 日,0.9.4 在 9 月 23 日,0.9.5 在 10 月 14 日,平均間隔約一個月。其中 0.9.4 與 0.9.5 連續兩個版本都以安全修補為主軸,0.9.4 處理三個公告,包括兩條繞過外送控制的 SSRF 路徑,以及可讀取伺服器環境變數的信任邊界繞過,0.9.5 再處理六個公告。這種節奏說明維護者已把安全審查納入固定流程,也說明爬蟲服務的攻擊面會隨功能擴充持續增加。
生態層面的變化更值得注意。README 目前把雲端服務放在文件最前段,並在安裝流程與封鎖提示中加入推廣訊息,商業化意圖明確。與此同時,開源版本仍維持完整功能與 Apache-2.0 授權,雲端獨有的部分集中在搜尋、SERP 與問答端點,以及代管瀏覽器與代理。這種分層方式讓自架使用者不會因商業化而被削減能力,但雲端推廣訊息進入命令列工具的行為,已在社群中引起討論。
出處連結有哪些?
本文資訊整理自 Crawl4AI 的 GitHub 儲存庫、v0.9.5 版本說明與 CHANGELOG,並對照官方文件。漏洞編號與技術細節均可於儲存庫查證。
- GitHub 儲存庫:https://github.com/unclecode/crawl4ai
- v0.9.5 版本說明:https://github.com/unclecode/crawl4ai/releases/tag/v0.9.5
- 變更日誌:https://github.com/unclecode/crawl4ai/blob/main/CHANGELOG.md
- 官方文件:https://docs.crawl4ai.com/
- 雲端服務:https://crawl4ai.com/
總結:Crawl4AI 適合什麼團隊?
需要把大量網頁轉為模型可讀內容、且要求資料留在自有環境的團隊最適合自架。偏好快速驗證者,可先以雲端免費額度評估,再決定是否回到開源部署。
Crawl4AI 的價值在於把網頁到模型可讀文字之間的工程細節標準化,包括去雜訊、保留結構、抽取欄位與瀏覽器控制。v0.9.5 的意義則是提醒使用者,這類工具同時是一個對外連線的代理,任何暴露在不受信任輸入下的端點都需要與主流程同等級的邊界檢查。
對已經自架 Docker 伺服器的團隊,升級到 0.9.5 應列為短期工作,並同步檢查呼叫端是否依賴已被拒絕的欄位。對仍在評估的團隊,先以函式庫或雲端免費額度完成概念驗證,再依資料敏感度與維運能力選擇長期形態,會比一次到位更務實。
