llama.cpp 於二零二六年十一月四日發布 v0.9.0,這是累積十三萬三千顆星標的 C/C++ 推理引擎在一年內的第九個正式版本。此版加入 OCP FP8 E4M3 量化、多序列 KV 快取算子與跨節點張量並行,同時把底層 ggml 推進至 v0.29.0。本文整理版本內容、技術意義與部署時的實際限制。
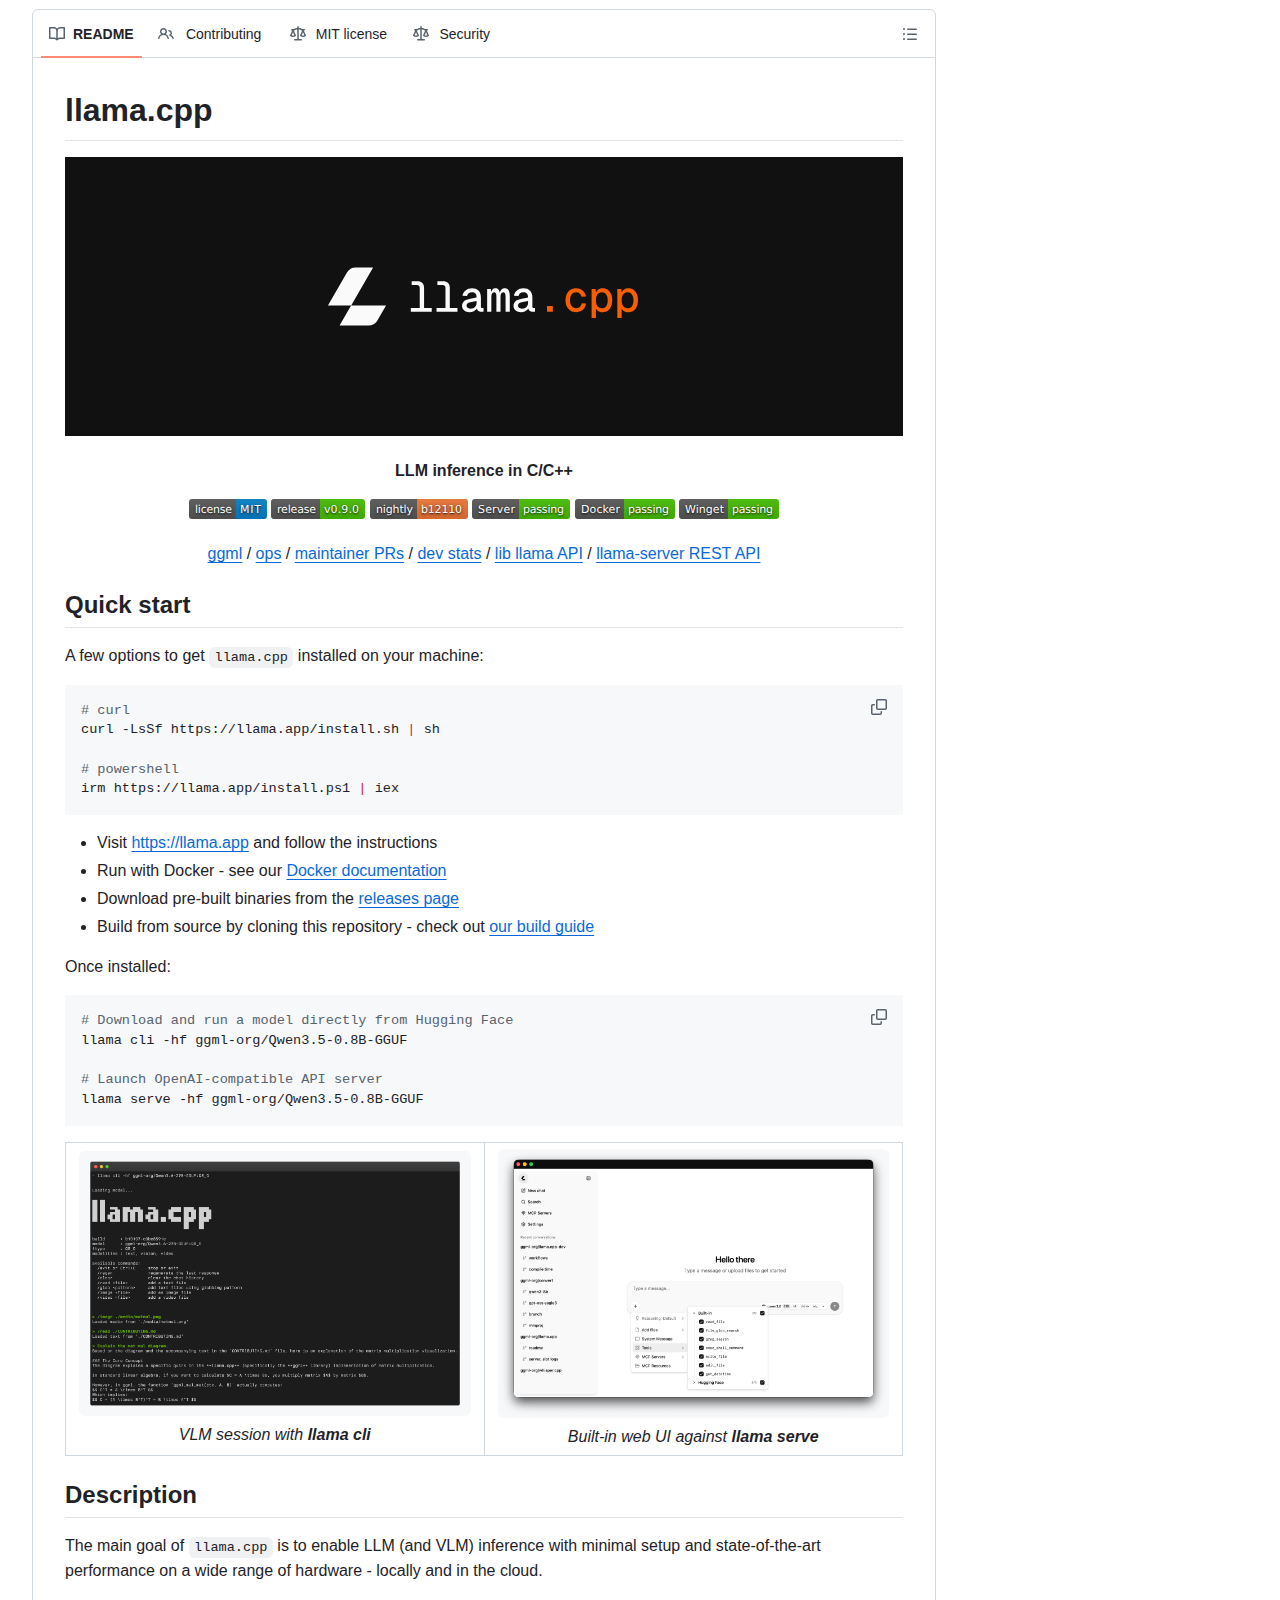
專案的定位自二零二三年三月建立以來沒有改變。它要在最少設定的前提下,於各式硬件上執行大型語言模型與視覺語言模型的推理,既能在本地運行,也能部署在雲端。
這種定位使專案成為本地推理的事實標準之一。多數桌面端模型應用、量化工具與圖形介面,都以它的 GGUF 格式與後端作為執行基礎,專案亦連續第三年入選 GitHub Octoverse 年度報告的重點儲存庫。
v0.9.0 是版本節奏調整後的產物。專案自二零二六年起改用語意化版本,正式版與每夜建置並行發布,前者供生產環境使用,後者對應當日的主幹狀態,本次正式版對應的每夜版本為 b12110。
llama.cpp v0.9.0 是什麼?
llama.cpp v0.9.0 是 2026 年 11 月 4 日發布的正式版本,主軸為 FP8 量化、多序列快取算子與跨節點並行,底層 ggml 同步升至 v0.29.0。
版本說明把改動分成六類:量化、核心張量運算、模型架構、多模態、伺服器與介面。前三類屬於推理效能的基礎設施,後三類則直接影響使用者可見的功能。
最受關注的三項改動分別是 OCP FP8 E4M3 張量類型、flash_attn_ext_rows 算子,以及批次張量複製 API。這三項都源自底層 ggml 的更新,再由 llama.cpp 接入模型層。
其餘改動包括 Gemma 4 小型號的前置運算加速、Metis-1.6 混合架構支援、Mistral Large 4 接入,以及語音合成與轉錄的擴充。這些項目合起來構成本次版本的完整範圍。
FP8 量化支援有何意義?
FP8 E4M3 把每個權重壓至 8 位元,較 16 位元模型節省約一半記憶體頻寬。此格式由開放運算計畫標準化,屬資料中心加速器的原生精度,如今在消費級硬件亦可直接載入。
llama.cpp 原本已支援 1.5 位元至 8 位元的整數量化,覆蓋從極端壓縮到接近原精度的整個區間。這些格式以整數與縮放因子表示權重,量化過程需要統計資料校準。
FP8 E4M3 走的是另一條路徑。它是浮點格式,四位元指數配三位元尾數,能保留動態範圍,不需要為每個張量挑選縮放策略,因此量化流程更接近直接轉換。
此格式由開放運算計畫提出,已被新一代資料中心加速器列為原生支援。專案為此新增專用量化類型,命名為主要為 FP8 E4M3,並提供轉換工具與飽和模式處理。
實務上的意義在於一致性。當上游模型以 FP8 訓練或發布,本地端可以直接沿用同一精度執行,不必再經過整數量化的校準步驟,減少一層精度損失與轉換成本。
flash_attn_ext_rows 解決什麼問題?
統一 KV 快取讓多條序列共用一份記憶體,節省用量卻拖慢前置運算。新算子讓每個查詢切片只關注自身對應的鍵值列,把多序列場景的效能拉回單序列水平。
批次推理時,多條對話序列可以共用同一份鍵值快取,這種設計稱為統一快取。它大幅降低記憶體佔用,代價是前置階段的運算效率下降。
原因是注意力運算需要對整份快取做矩陣乘積,而每條序列實際只使用其中一段。統一快取把不同序列的資料交錯排列,令運算無法整塊處理。
新算子的做法是把查詢按序列切分,每個切片只針對自己對應的鍵值列做注意力運算。這樣既保留共用記憶體的優勢,又恢復了連續記憶體存取的效率。
版本說明指出,此改動恢復了非統一快取在前期填充階段的效能。對於同時服務多個使用者的本地推理服務,這一項改動的實際收益比帳面數字更明顯。
多節點張量並行如何運作?
ggml v0.29.0 引入多進程通訊介面,並以 NCCL 實現跨節點張量並行。多台機器可各自持有一部分模型層,透過高速網路交換中間結果,突破單機顯示記憶體上限。
過去的多卡支援集中在單機之內,張量按層或按矩陣切分到不同顯示卡,資料透過 PCIe 或 NVLink 交換。單機插槽數量與匯流排頻寬構成了硬上限。
v0.29.0 加入多進程通訊介面,把交換通道抽象成可替換的實作,第一版接上的是 NVIDIA 的 NCCL 通訊庫。這使參與運算的裝置可以分佈在不同主機。
對於模型大於單機記憶體總量的情境,這條路徑提供了新的選項。以往需要依賴 CPU 與 GPU 混合推理,部分層留在系統記憶體,速度受制於記憶體頻寬。
跨節點方案的門檻同樣明顯。節點之間需要低延遲網路,交換的資料量隨並行度上升,實際效能取決於網路拓撲與模型切分策略,並非單純堆疊機器就能加速。
v0.9.0 新增哪些模型與語音能力?
新增四款架構,包括 Limite 1B、混合 Mamba-2 的 Metis-1.6 與 Mistral Large 4。語音端加入合成與轉錄支援。
四款新架構各有取向。Clover-35B-A3B-Preview 屬擴散式語言模型,以自回歸模式接入;Limite 1B 為小型模型,適合資源受限的環境。
Metis-1.6 提供兩個規模,分別為約二十九億與一百零二億參數。它採用 Mamba-2 與分組查詢注意力的混合結構,配合固定深度循環與潛在混合專家層,屬於非純 Transformer 的路線。
Mistral Large 4 的接入則補上大型旗艦模型。這類模型對記憶體需求高,通常需要量化或多卡切分,正好對應本版在後端與並行上的改動。
語音端的三項更新值得注意。Chatterbox 提供語音合成,Nemotron 3.5 支援四十種語言的離線轉錄並可標註說話者,Pocket TTS 則支援預設音色而不需要聲音克隆樣本。
llama.cpp 的專案數據與生態地位如何?
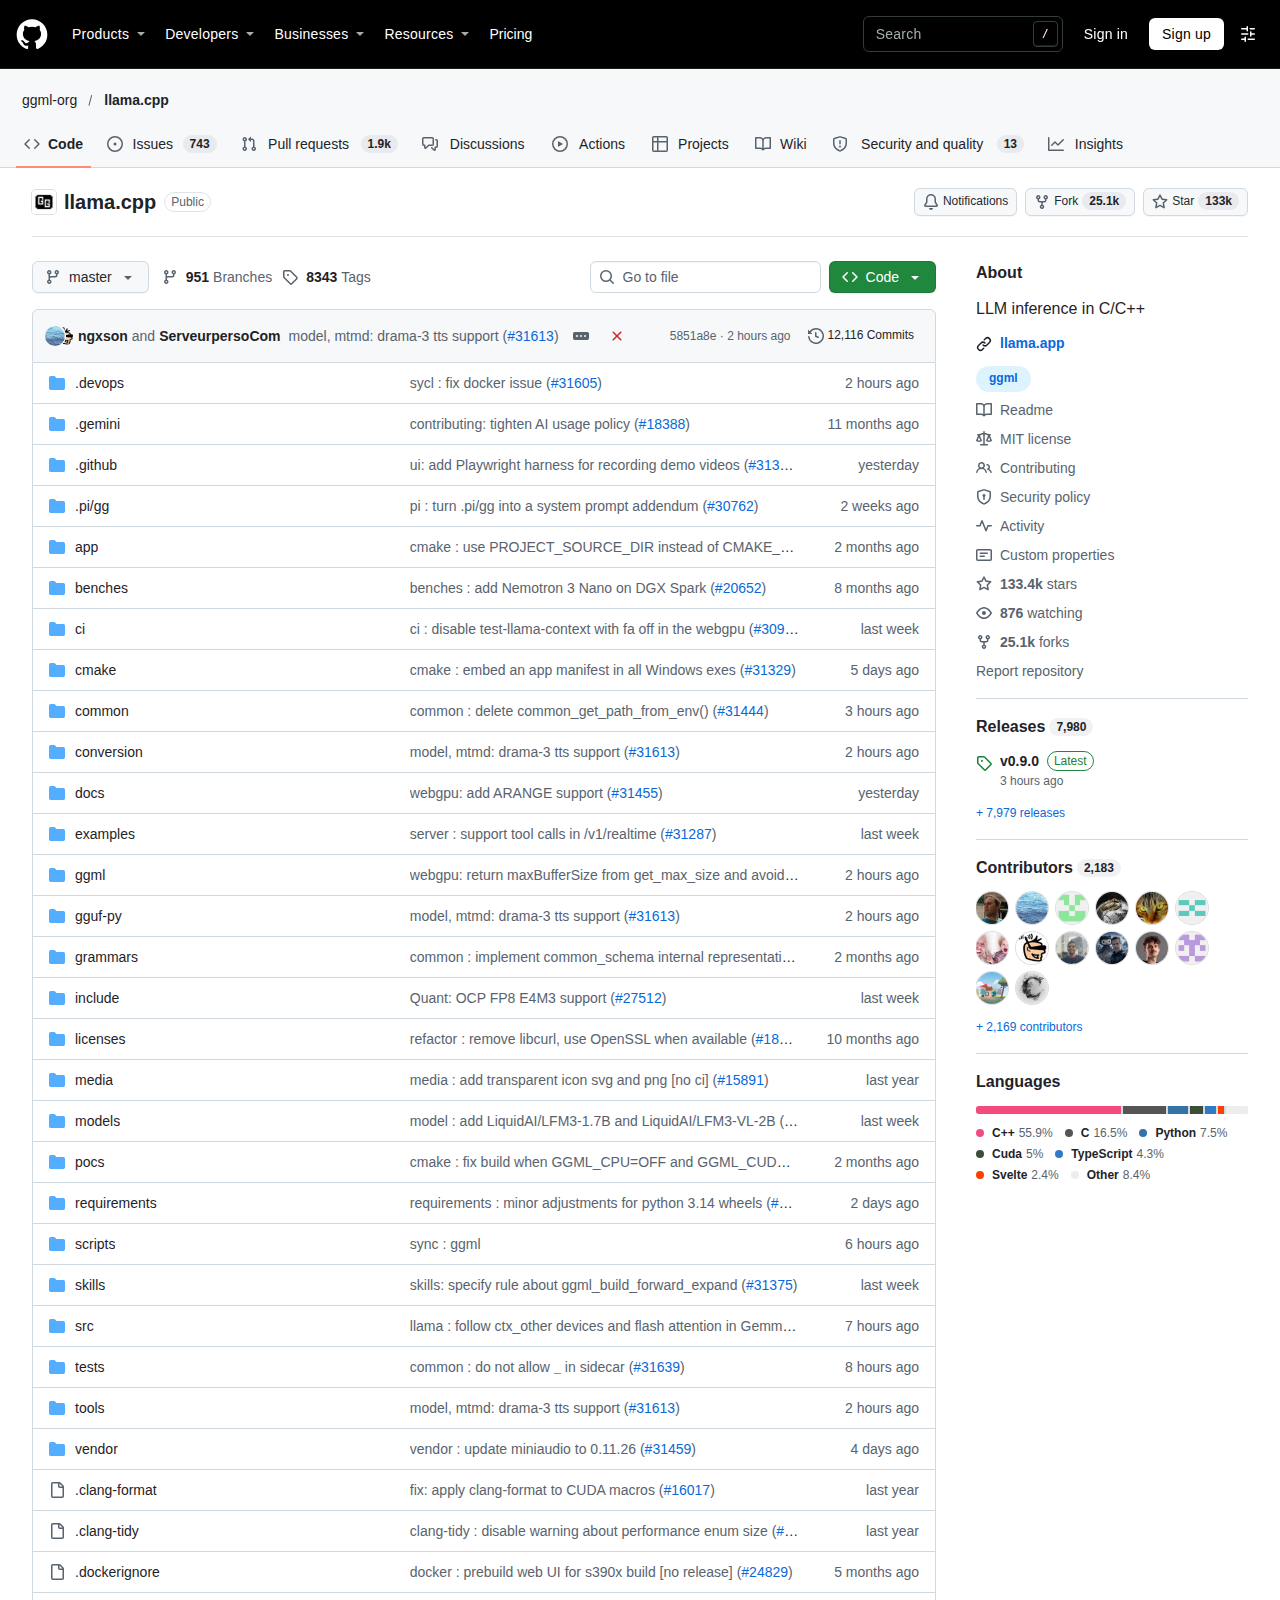
專案累積十三萬三千顆星標、二萬五千次復刻與逾二千二百名貢獻者,採 MIT 授權,以 C++ 撰寫。其 GGUF 格式與後端已成為本地推理工具的共同基礎。
後端數量是這個專案最容易被低估的部分。README 列出的後端涵蓋通用運算、CUDA、HIP、Metal、Vulkan、SYCL、OpenCL、WebGPU,以至華為昇騰、高通驍龍、IBM 大型主機與摩爾線程顯示卡。
這種覆蓋廣度來自社群的分散維護。每個後端由熟悉該硬件的貢獻者負責,主幹只保留共用介面與測試,令新硬件可以在數月內取得可用支援。
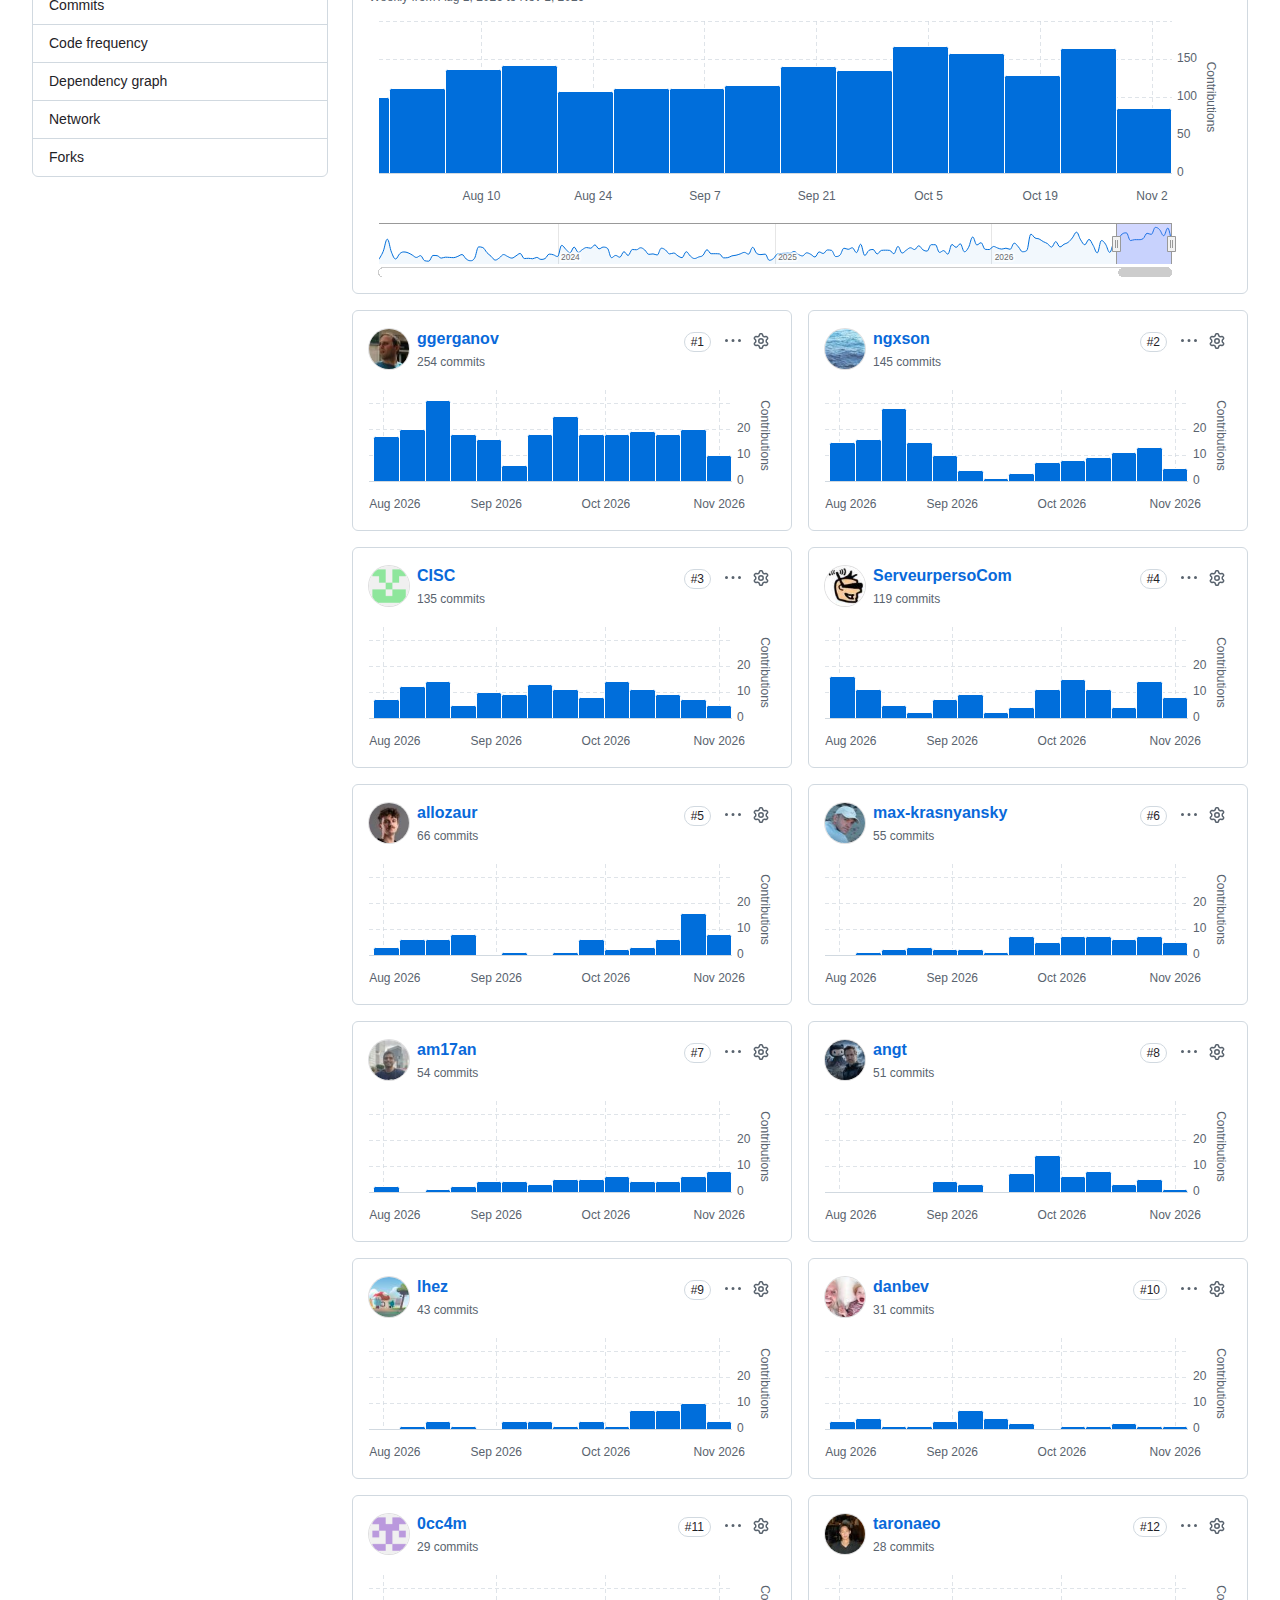
貢獻者規模可從分頁推算。GitHub 統計含匿名提交的貢獻者清單達二千二百餘頁,即使扣除重複帳號,仍屬開源推理引擎中最大的一批。
商業化路徑相對間接。專案本身不提供托管服務,收益主要來自周邊生態,包括模型托管平台、企業級推理服務與硬件廠商的適配工作,專案則維持 MIT 授權與中立立場。
如何快速開始使用 llama.cpp v0.9.0?
官方提供安裝腳本與預編譯二進位檔,一行指令即可安裝。之後可直接以模型名稱從 Hugging Face 下載並啟動命令列對話,或啟動相容 OpenAI 介面的推理伺服器。
安裝路徑在本次版本已明顯簡化。Linux 與 macOS 可使用官方安裝腳本,Windows 則透過 PowerShell 腳本,兩者都會取得對應平台的最新正式版。
# Linux / macOS
curl -LsSf https://llama.app/install.sh | sh

# Windows PowerShell
irm https://llama.app/install.ps1 | iex
安裝完成後,命令列工具可以直接指定模型倉庫並下載執行,不需要手動轉換格式。推理伺服器則以相同方式啟動,並對外提供相容 OpenAI 的介面。
對於需要特定硬件的環境,專案仍提供預編譯二進位檔與原始碼編譯兩條路徑。CUDA、Vulkan、SYCL 等後端在編譯時選擇,官方建置指南按平台分開說明。
實際部署需要注意什麼?
FP8 需硬件支援才有實際加速,舊顯示卡會回退至模擬路徑。跨節點並行要求低延遲網路,且模型切分策略需自行調校,官方未提供自動配置工具。
第一項限制與硬件相關。FP8 E4M3 在缺乏原生支援的裝置上仍可執行,但需轉換為較高精度運算,節省的只有記憶體佔用,速度不會提升。
第二項限制來自統一快取的設定。新算子改善多序列場景,但快取容量、序列上限與批次大小仍需按實際負載調整,預設值不適合所有情境。
第三項限制是跨節點並行的複雜度。節點數量、切分方式與網路頻寬三者互相牽制,官方僅提供通訊層實作,未附帶自動調優,部署前需要自行量測。
第四項是版本節奏的差異。正式版與每夜版的功能差距可達數百個提交,生產環境應固定在正式版標籤,避免直接跟隨主幹而引入未驗證的行為。
出處連結有哪些?
本文資訊整理自 llama.cpp 官方儲存庫的 v0.9.0 版本說明、README 與後端文件,數據取自 GitHub API 於 2026 年 11 月 5 日查詢結果。
- 專案儲存庫:ggml-org/llama.cpp
- 版本說明:llama.cpp v0.9.0
- 底層程式庫:ggml v0.29.0
- 官方網站:llama.app
常見問題有哪些?
以下五個問題涵蓋版本升級方式、FP8 適用硬件、與 Ollama 的分別、跨節點並行的實際門檻,以及商用授權範圍與建議。
從舊版本升級需要重新編譯嗎?
官方提供預編譯二進位檔,直接下載對應平台的 v0.9.0 版本即可。若曾自行編譯或使用特定後端,則需重新編譯,因為底層 ggml 已升級至 v0.29.0,介面有變動。
FP8 量化在我的顯示卡上有效嗎?
需要硬件原生支援 FP8 運算才有加速效果。較舊的顯示卡仍能載入模型,但會走模擬路徑,只節省記憶體,運算速度不會提升。
llama.cpp 與 Ollama 有什麼分別?
Ollama 是面向使用者的封裝,內含模型管理與服務编排,其推理核心即為 llama.cpp。需要細緻控制後端、量化格式或伺服器參數時,直接使用 llama.cpp 較為合適。
跨節點張量並行需要什麼條件?
需要支援 NCCL 的 NVIDIA 環境,以及節點之間的低延遲網路。模型切分與並行度需自行調校,官方未提供自動配置,適合有維運能力的團隊。
授權是否允許商業使用?
專案採用 MIT 授權,允許商業使用、修改與再發布。模型本身的授權另計,部署前需確認所使用模型的條款,兩者不可混為一談。
總結:llama.cpp 適合什麼團隊?
llama.cpp 適合需要在自有硬件上執行模型、並要求控制推理細節的團隊。本次版本的價值在於把量化精度、批次效率與並行能力推進一格,而非改變專案定位。
八個正式版本、十三萬顆星標與十七種後端,共同說明一件事:這個專案的競爭力來自覆蓋面,而非單點效能。v0.9.0 的三項核心改動都在補齊覆蓋面。
FP8 讓它對接資料中心的量化慣例,多序列算子讓它勝任多人共用的服務場景,跨節點並行則把手伸向單機之外。三者合起來,指向同一個方向。
真正需要觀察的是取捨。當專案同時服務從單板電腦到多節點叢集的場景,預設值會愈來愈難討好所有人,設定複雜度將成為使用者體驗的主要成本。
對於正在評估本地推理方案的小型團隊,本版值得升級,但升級前應先量測實際負載下的表現。版本說明列出的是方向,數字仍需在自己的硬件上取得。
