AirLLM 於 2026 年 10 月 30 日累積約 4.1 萬星。專案以逐層串流方式把權重從磁碟載入顯示卡,讓 671B 的 DeepSeek-V3 在約 12GB 顯存運行,2.8T 的 Kimi K3 更壓到 3.72GB,並可在 6GB 以下微調 125B 模型。它把顯存門檻改寫為單層體積,代價是生成速度受磁碟頻寬限制。
AirLLM 是什麼?
AirLLM 是一個 Python 套件,透過逐層載入權重與區塊量化,讓超大模型在低顯存顯示卡上完成推理與微調,呼叫方式沿用 Transformers 介面。
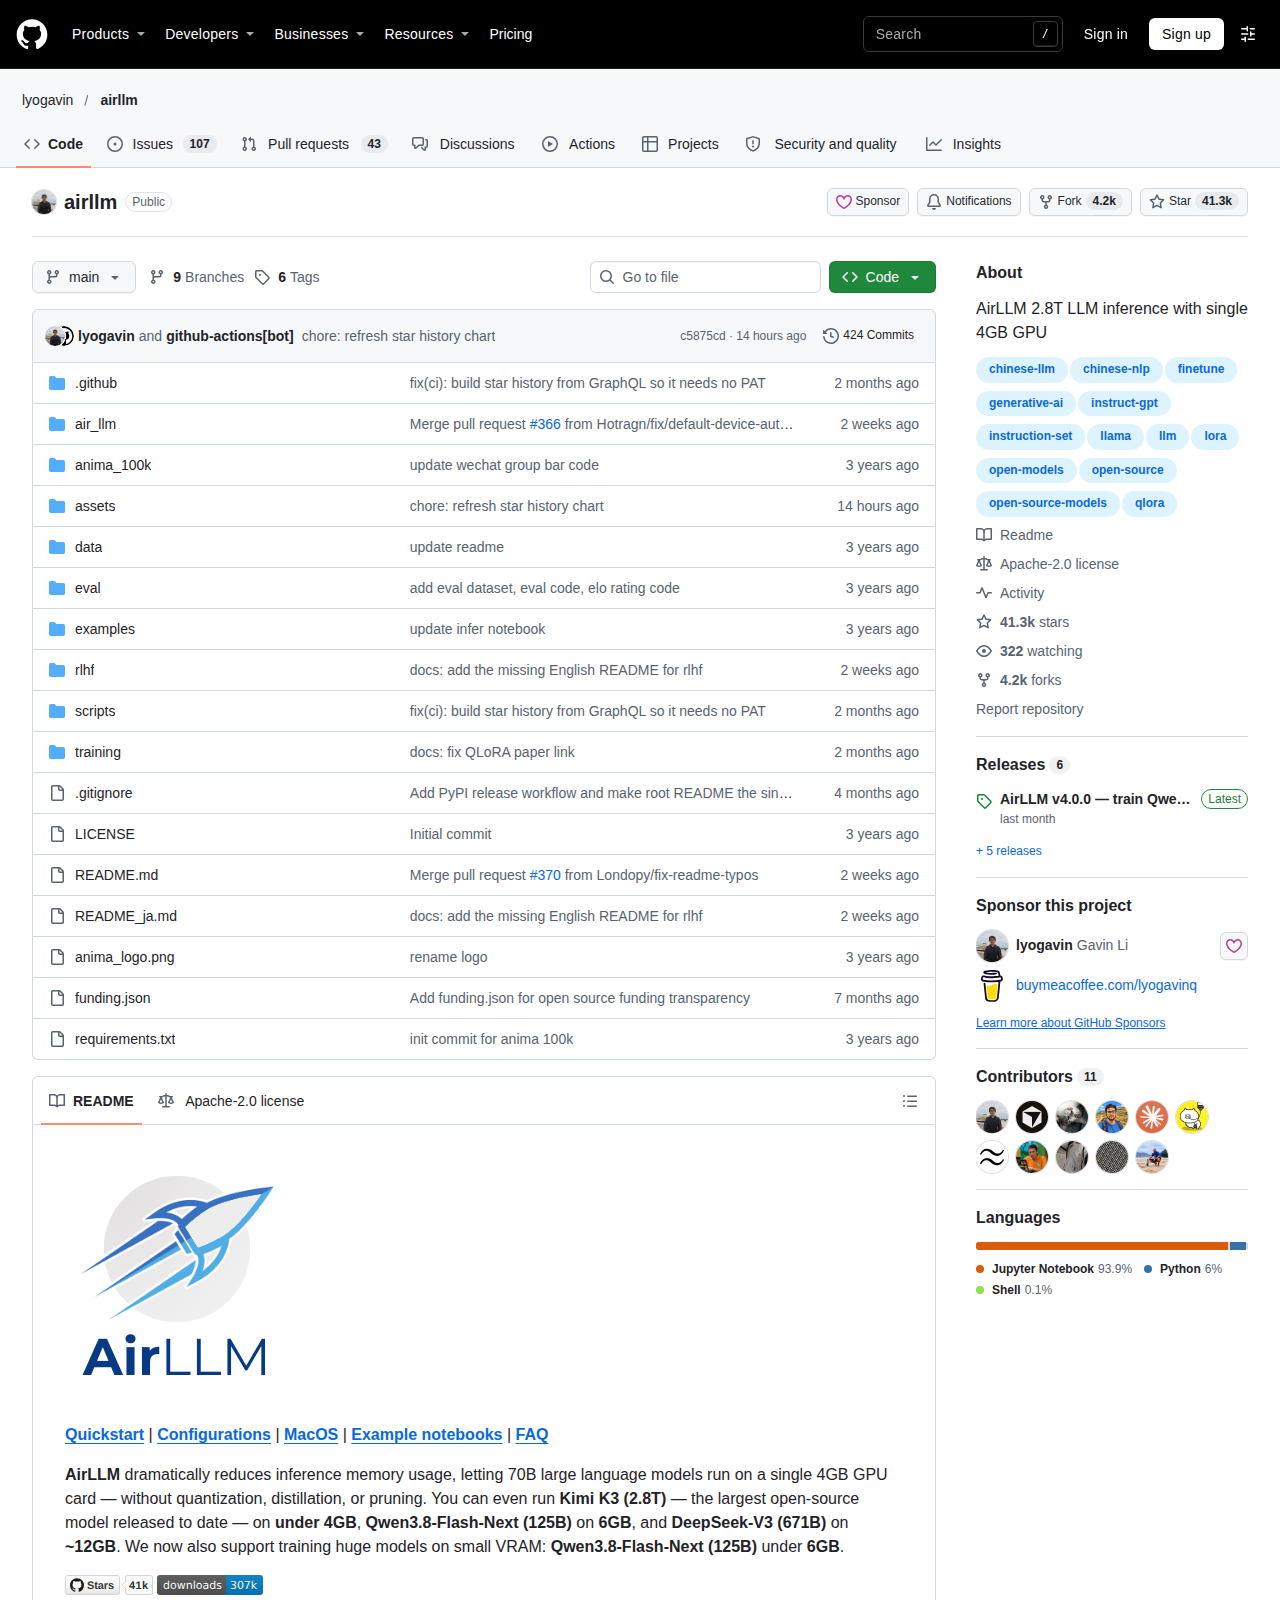
專案由開發者 Gavin Li 於 2023 年 6 月建立,倉庫累積 4.1 萬星、4,228 次分叉與 322 位關注者,採 Apache-2.0 授權,主要語言標示為 Jupyter Notebook,原因是官方範例以筆記本形式提供。
它的定位是一層相容層,而非獨立推理引擎。使用者把模型 ID 傳入 AutoModel.from_pretrained,權重的切割、快取與載入由套件接手,其餘程式碼與一般 Transformers 流程差別有限。
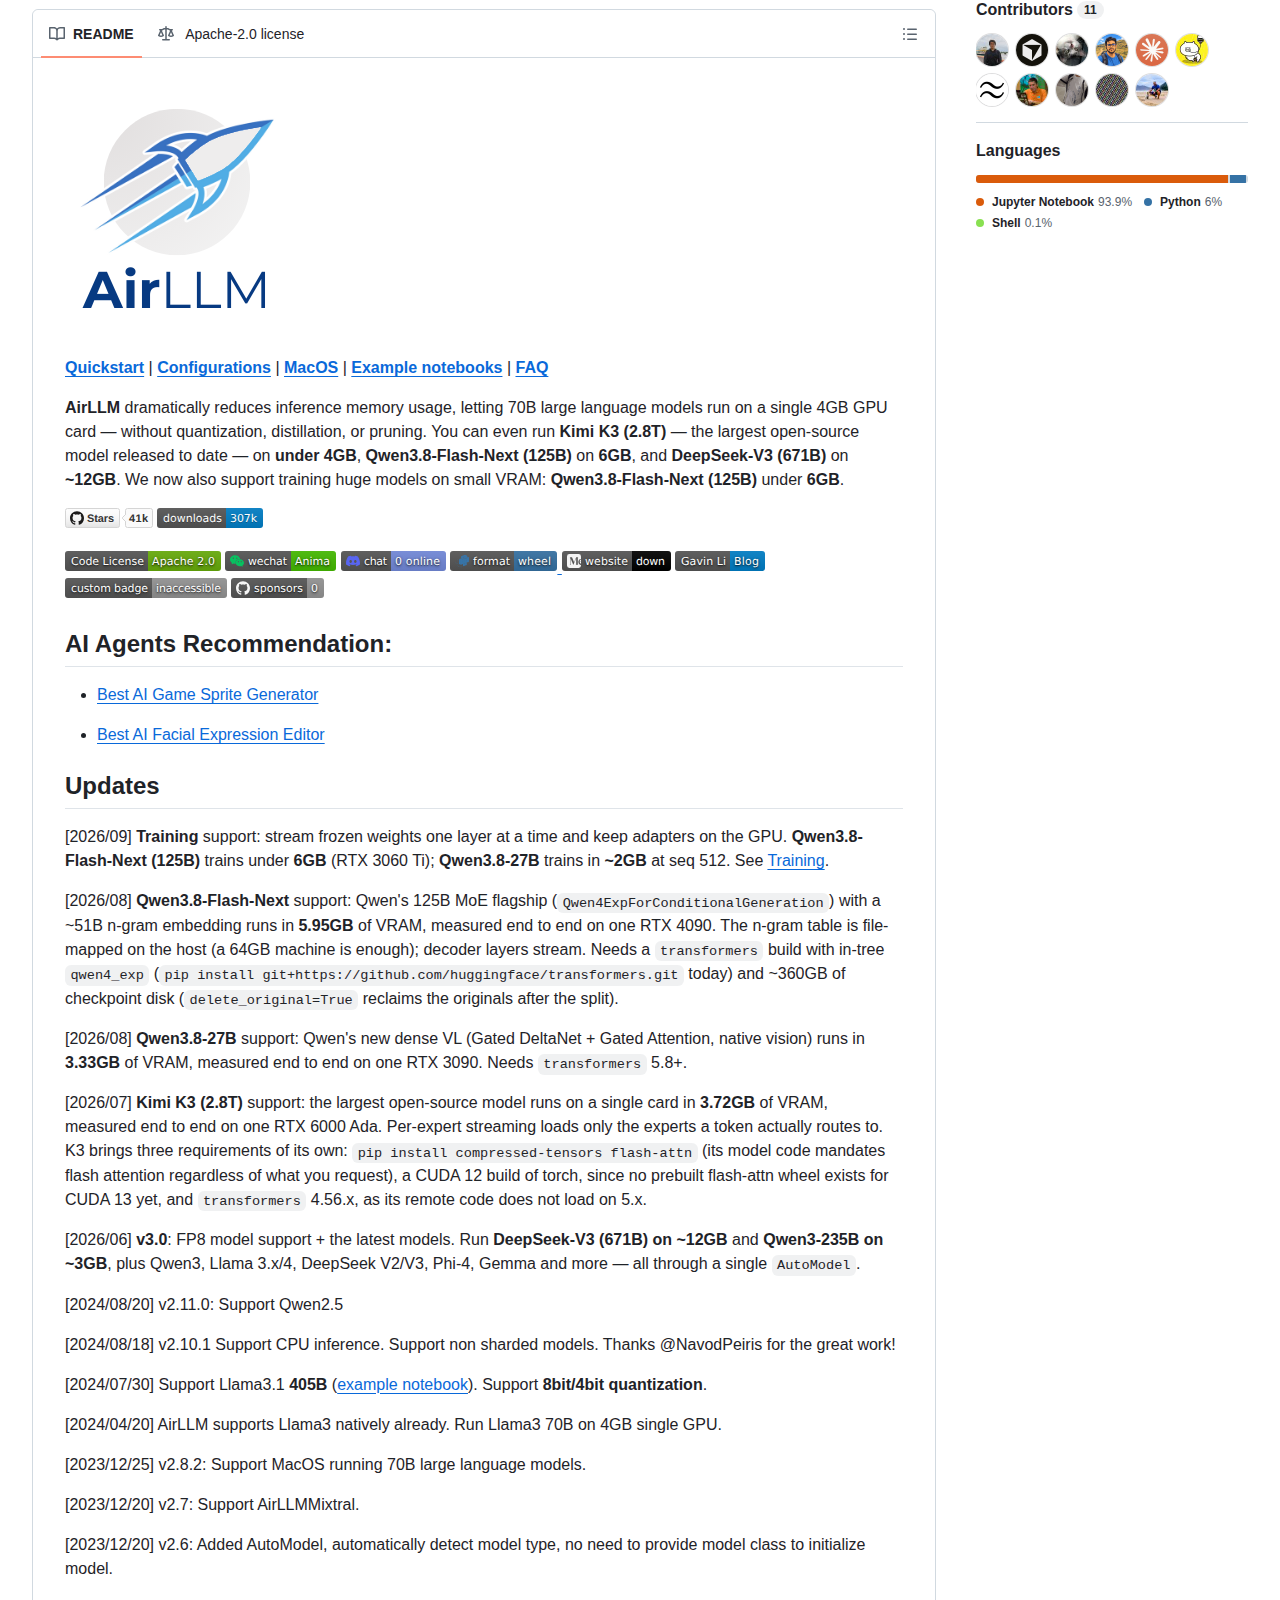
README 現時列出 Llama、Qwen、DeepSeek、Mistral、Mixtral、Phi、Gemma、ChatGLM、Baichuan、InternLM、Yi 與 Kimi 等家族,並宣稱多數新模型在發布當日即可使用。
為什麼 4GB 顯示卡可以執行 671B 模型?
顯存佔用取決於單層權重的體積,與模型總參數量無關。AirLLM 每次只把一層放進顯示卡,其餘留在磁碟,因此 671B 模型只需約 12GB 顯存。
傳統做法要求完整權重常駐顯存,運算速度取決於顯示記憶體頻寬。逐層串流把限制條件換了位置,容量不再是門檻,磁碟讀取速度成為新的天花板。
官方文件給出的對照相當直接。八B級模型約需一至二GB,Llama 3.x 70B 約 4GB,Llama 3.1 405B 約 8GB,DeepSeek-V3 671B 約 12GB。這些數字的前提是不做量化、不做蒸餾、不做剪枝。
專案的技術來源可追溯至 Kaggle 的一場科學問答競賽。作者在致謝段落說明,大量程式碼建構於參賽者 SimJeg 的解法之上,屬於由競賽工程演化而成的通用工具。
AirLLM 的核心技術原理是什麼?
原理分三層:首次載入時把權重切成一層一個檔案,執行時重疊載入與運算,並可選擇只量化權重的區塊量化。三者疊加後,顯存需求由總參數量轉為單層體積。
第一層是逐層切割。模型第一次被載入時,套件會把原始權重拆成一層一個 safetensors 檔案,寫回 Hugging Face 快取目錄。這個步驟只做一次,往後直接讀取切割結果。
第二層是預取。載入下一層的磁碟讀取與當前層的運算重疊進行,官方記錄約有一成速度提升。這項機制目前主要針對 Llama 系列實作。
第三層是區塊量化。專案只量化權重,不動激活值,理由是瓶頸落在磁碟讀取而非矩陣運算,因此壓縮權重體積即可加速,精度損失相對容易控制。啟用後官方稱最多三倍加速,需額外安裝 bitsandbytes。
2.8T 的 Kimi K3 如何在單張顯示卡上運行?
Kimi K3 屬專家混合架構,AirLLM 只串流單次前向路由到的專家,其餘留在磁碟。README 記載於 RTX 6000 Ada 實測佔用 3.72GB。
這項支援在 2026 年 7 月加入。Kimi K3 是現時最大的開源模型,總參數達 2.8 兆,按常規估算的顯存需求遠超消費級顯示卡。專家混合架構讓每次前向只啟用少數專家,逐層串流因此得以只搬運真正需要的部分。
代價是三項額外條件。模型程式碼強制使用 flash attention,需安裝 compressed-tensors 與 flash-attn;由於沒有對應 CUDA 13 的預編譯版本,必須使用 CUDA 12 版本的 torch;遠端程式碼在 transformers 5.x 下無法載入,需退回 4.56.x。
同一條路徑在 Qwen 家族上更成熟。Qwen3.8-Flash-Next 為 125B 的專家混合模型,配一個約 51B 的 n-gram 嵌入表,於 RTX 4090 上端到端實測 5.95GB。嵌入表以檔案映射留在主機記憶體,官方建議 64GB 記憶體與約 360GB 磁碟空間。
AirLLM 是否支援模型微調?
支援。凍結的基礎權重逐層串流,只有 LoRA 適配器常駐顯存,因此 125B 模型可在 6GB 以下訓練,27B 模型在序列長度 512 時約需 2GB。
訓練支援於 2026 年 9 月加入,走的是自建路徑。專案明言並非 Hugging Face Trainer 或 bitsandbytes 的 QLoRA 流程,而是把凍結權重保留在磁碟、逐層串流,僅讓適配器留在顯示卡。
API 以 AirLLMLoRA 與 AirLLMLoRAQwen4Exp 兩個類別提供,前者對應 27B 的稠密模型,後者對應 125B 的專家混合模型。範例腳本接受 jsonl 資料,每行一個物件,欄位可以是 text,也可以是 prompt 與 completion 的組合。
實際配置上,125B 模型在 RTX 3060 Ti 上以 6GB 以下完成訓練,27B 模型在序列長度 512 時約需 2GB。這個數字讓入門級遊戲顯示卡首次具備微調旗艦模型的可能性。
實際使用時需要付出什麼代價?
代價落在速度與磁碟。逐層串流受磁碟頻寬限制,單次生成明顯慢於常駐方案;首次使用需完整切割權重,大模型動輒佔用數百 GB 空間。
磁碟空間是最常見的阻塞點。README 的疑難排解第一條就是 MetadataIncompleteBuffer 錯誤,成因幾乎都是切割過程中空間不足。671B 級模型的切割結果往往以百 GB 計算,官方因此提供 delete_original 參數,在轉換完成後刪除原始檔案。
平台限制同樣明確。macOS 端只支援 Apple silicon,且現階段僅接受 Llama 與 Mistral 風格的架構,其他模型會在載入前直接報錯。
它不適合即時對話服務。逐層讀取意味著每個 token 的生成都要等待磁碟,吞吐量與 vLLM 這類常駐引擎不在同一量級。專案解決的是能不能執行的問題。
AirLLM 與量化、卸載方案有何分別?
量化壓縮權重以換取速度,卸載在顯存與記憶體之間搬移資料。AirLLM 把多數權重留在磁碟並逐層載入,顯存需求最低,代價是單次生成速度較慢。
三條路線回應不同約束。量化降低每個參數的位元數,仍要求權重完整放進顯存;卸載在層與層之間把資料搬到主機記憶體,需要足夠的系統記憶體;逐層串流則把儲存層級再往下降到磁碟。
專案內部同時提供壓縮選項,兩者可疊加使用。啟用四bit 或八bit 區塊量化後,權重體積下降,磁碟讀取量隨之減少,官方稱速度最多提升三倍。
選型判斷相對單純。若目標是服務多人、追求吞吐量,應選 vLLM 或 llama.cpp;若目標是在既有硬體上驗證一個旗艦模型的行為,AirLLM 的門檻最低。
專案的關鍵數據有哪些?
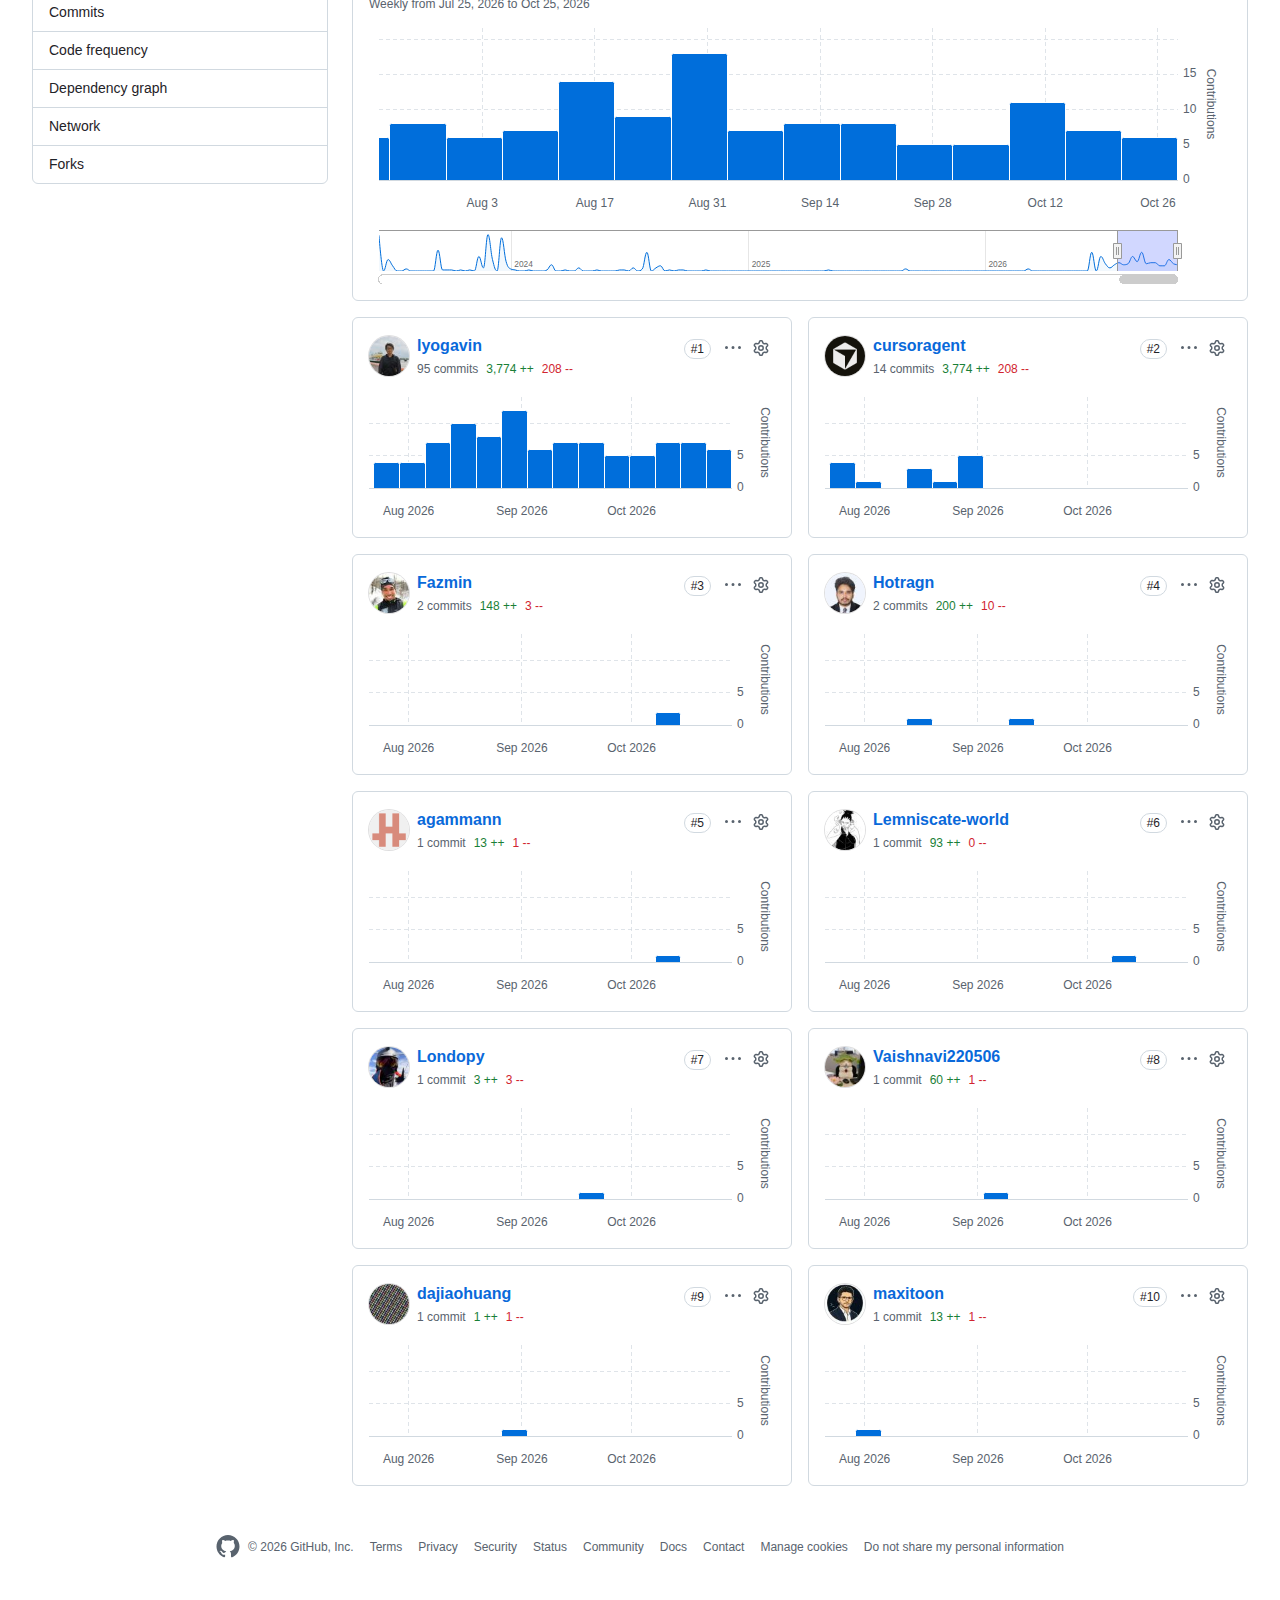
倉庫累積 41,337 星、4,228 次分叉與 150 個待處理議題,Apache-2.0 授權,2023 年 6 月建立,最新版本為 v4.0.0。
以下數據取自 2026 年 10 月 30 日的倉庫狀態與發布記錄,供評估參考。
版本節奏值得留意。v3.2.0 於 2026 年 8 月 18 日發布,v3.3.0 於 8 月 28 日,v4.0.0 於 9 月 5 日,三週內推進兩個大版本,主軸由推理延伸至訓練。
如何快速開始使用 AirLLM?
安裝 airllm 後,以 AutoModel.from_pretrained 傳入模型 ID 即可推理,首次載入會自動切割權重,壓縮另需 bitsandbytes。
起點是一行安裝指令。執行 pip install airllm 之後,程式碼與一般 Transformers 寫法基本相同,差別只在於首次載入需要預留足夠磁碟與時間。
from airllm import AutoModel

model = AutoModel.from_pretrained("Qwen/Qwen3-32B")
# 進階:AutoModel.from_pretrained("deepseek-ai/DeepSeek-V3", compression='4bit')
若要用壓縮加速,先安裝 bitsandbytes,再於初始化時傳入 compression 參數,可選四bit 或八bit。這個選項只影響載入體積,不改變模型結構。
環境準備有兩處容易忽略。部分新模型需要從原始碼安裝 transformers,Kimi K3 另需 CUDA 12 版本的 torch。官方提供 Colab 範例與 Docker 建置腳本,可省去環境調整。
AirLLM 值得一試嗎?
若目標是在既有顯示卡上驗證旗艦模型的行為,或在小顯存環境嘗試 LoRA 微調,這個專案值得一試。若追求吞吐量與低延遲,應選常駐式推理引擎。
專案的價值在於重新定義了硬體門檻的位置。當顯存需求由總參數量轉為單層體積,一張四GB 的舊卡與一張八十GB 的新卡,在能不能執行這條問題上的差距被大幅壓縮。
限制同樣真實。速度、磁碟與平台相容性都構成了實際約束,它不是通用解,而是一條在資源受限時仍然可行的路徑。
值得觀察的是訓練方向的進展。若 125B 模型真能在 6GB 以下完成微調,受影響的將不只是推理門檻,而是整個微調市場的硬體假設。
出處連結有哪些?
主要來源為 GitHub 倉庫與官方 README,數據截至 2026 年 10 月 30 日。顯存數字均為官方記錄的端到端實測值。
- 專案倉庫:lyogavin/airllm
- 版本說明:AirLLM v4.0.0
- 作者部落格:gavinliblog.com