2026 年 6 月至 10 月,OpenAI 與 Anthropic 的主力模型 API 定價累計下調最高八成,快取讀取成本跌至原本的四分之一,同期基準分數並未倒退。推動這輪減價的力量有三:開源權重模型追趕、推理服務商數量暴增,以及兩家公司上市前的收入結構調整。
這輪減價的幅度有多大?
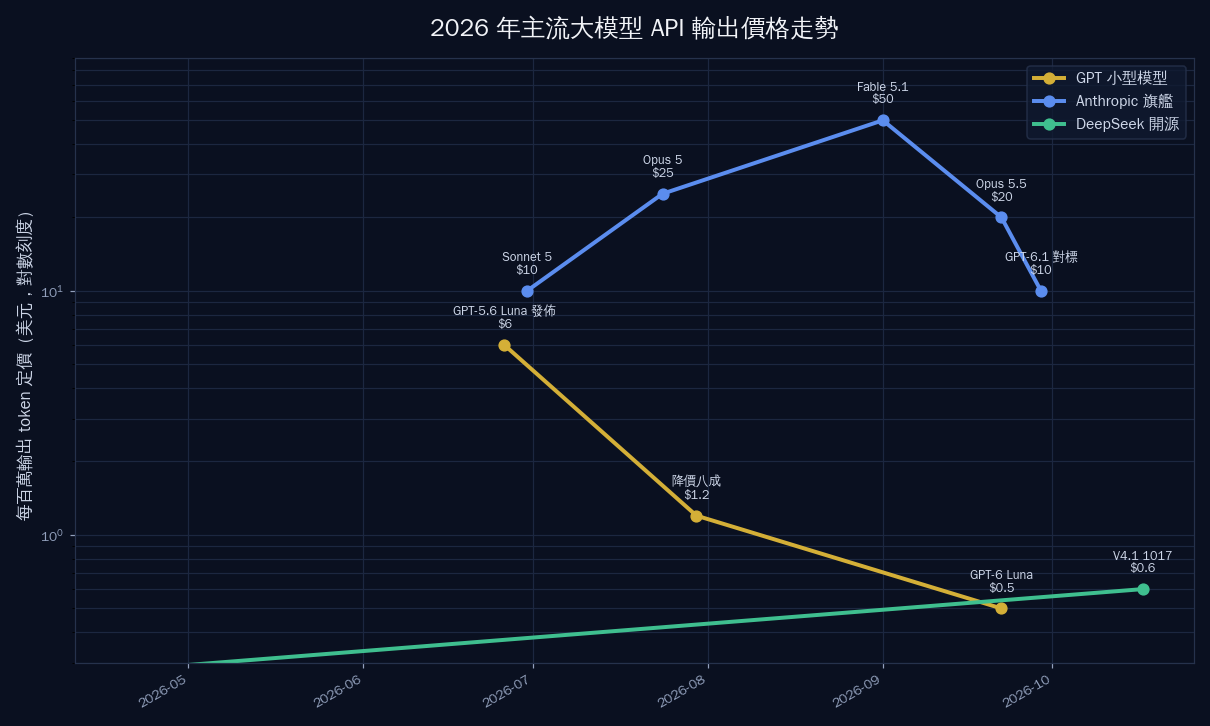
由六月至十月,OpenAI 的 Luna 級模型輸出價由每百萬 token 六美元降至零點五美元,跌幅逾九成;Anthropic 的旗艦型號經兩次調整後累計下降四成至六成。
整理公開公告可見一條清晰的時間線。六月二十六日,OpenAI 發佈 GPT-5.6 Sol 與 Luna,Sol 維持每百萬 token 五美元輸入、三十美元輸出的價位,Luna 以六美元輸出價切入輕量場景。四日後,Anthropic 推出 Claude Sonnet 5,開價二美元輸入、十美元輸出,並註明屬臨時優惠價。
七月三十日出現第一個劇烈動作:OpenAI 把 GPT-5.6 Luna 的價格直接砍八成,輸出價降至一點二美元。八月十日,Anthropic 宣佈 Sonnet 5 的優惠價轉為永久。八月二十一日,OpenAI 再為 GPT-5.6 Sol 提供為期三個月的兩成折扣。
九月節奏進一步加快。一日,Anthropic 發佈 Fable 5.1,除基準測試全面超越六月版本,快取讀取成本同時下調七成五。二十二日,OpenAI 推出 GPT-6 Sol,輸入與輸出價雙雙減半;同日 Anthropic 發佈 Opus 5.5,官方明確寫出「所需算力低於 Opus 5,定價反映這一點」。二十九日,OpenAI 再以 GPT-6.1 Sol 把快取讀取價再減半。
為何減價集中在快取讀取成本?
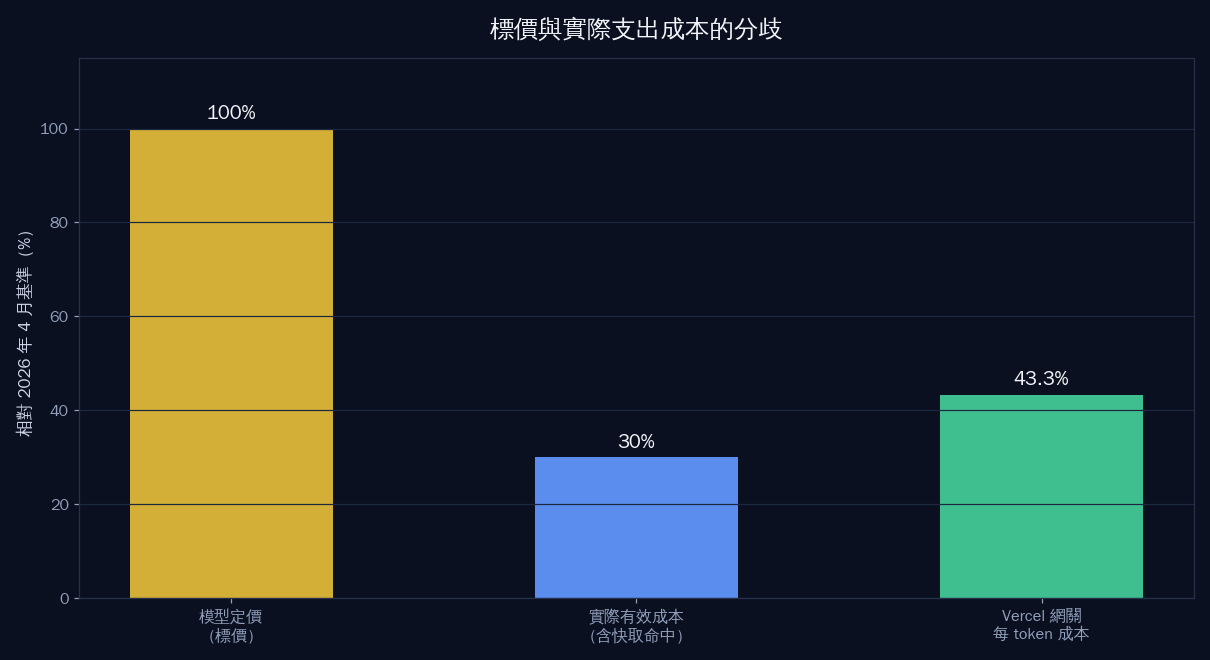
代理式編程的快取讀取佔 token 支出九成六至九成九。快取價減七成五,整體使用成本即同步下降約七成,故廠商以此作為主要降價抓手。
在代理式編程場景中,每一輪對話都要把先前整段上下文重新送入模型,這部分幾乎全部命中快取。根據公開統計,快取讀取佔此類工作流總 token 支出的九成六至九成九,輸入與輸出的標價反而只佔小部分。
這個結構決定了減價的著力點。把每百萬 token 的輸出價由三十美元降至二十美元,對整體帳單的影響有限;把快取讀取價由一美元降至零點二五美元,實際支出就會出現四成以上的落差。Anthropic 在 Fable 5.1 與 Opus 5.5 兩次發佈中都選擇這條路徑。
OpenAI 在九月二十九日的調整沿用同一邏輯,把 GPT-6.1 Sol 的快取價對齊至輸入價的一成,與 Anthropic 的五分一水平接近。對自行架設代理流程的團隊而言,這種調整的實際效果大於表面標價的變動。
OpenAI 與 Anthropic 為何互相跟價?
兩家公司發佈節奏高度重疊,減價多在同一週內出現。模型可替換性高、切換成本接近零,使任何一方都難以單方面維持高價。
觀察時間線可見明顯的對稱性。OpenAI 在七月三十日大幅下調 Luna 價格後,Anthropic 於八月十日把 Sonnet 5 的優惠價固定下來;九月二十二日兩家更在同一天各自發佈新模型,價位互相緊貼。
這種對稱源於產品同質化。開發者在 OpenCode、Zed 等代理框架中切換模型只需改一個設定,或改動 OpenRouter 的 API 端點字串。當替換成本接近零,定價就難以提高,任何漲價都會直接把流量推向對手。
更關鍵的是買方結構。企業採購與個人代理訂閱是兩家目前主推的護城河方向,而這兩類客戶對單位成本極度敏感。在模型能力差距收窄至數個基準分數的階段,價格成為最容易比較的维度。
開源權重模型扮演什麼角色?
DeepSeek、Kimi 等開源權重模型以低一個數量級的價格提供接近旗艦的能力,直接壓縮閉源模型的定價空間,成為這輪減價的外部推力。
DeepSeek V4 Flash 於 2026 年 4 月以每百萬 token 零點一四美元輸入、零點二八美元輸出的價格推出,當時 OpenAI 尚未有對應的輕量級產品,該模型因此在開源社群快速擴散。其快取讀取價僅為輸入價的百分之二,有效成本比標價更吸引。
十月推出的 V4.1 Flash 1017 版本把 Artificial Analysis 指數由 24 提升至 45,價格大致維持在零點一五美元輸入、零點六美元輸出。同期 Moonshot 的 Kimi K3.1 Pro 以 55 分的成績貼近 Opus 5.5 的 58 分,定價為二美元輸入、十美元輸出,權重預計於十一月四日釋出。
對閉源廠商而言,這種追趕速度意味著低價區間無法長期獨佔。七月那一次八成降價,普遍被解讀為針對開源輕量模型的防守動作。
推理服務商增多如何壓低價格?
同一個開源模型可被多家推理商託管,開發者可指定最低價路由。供應方互相競價,令實際成交價低於官方標價,並倒逼閉源廠商跟隨。
五月的時候,OpenRouter 上託管 DeepSeek V4 Flash 的推理商有十三家;到了十月的 1017 版本,數目增至二十九家。開發者可以在 API 請求中指定價格優先,請求就會被路由至報價最低的服務方。
多家託管的結果是有效成本趨同。以含快取命中的實際成本計算,Cloudflare 與 DeepInfra 的報價已落在 DeepSeek 官方價格的一成範圍內。當替代供應充足,任何一家都缺乏單方面提價的空間。
這個結構也解釋了為何減價能夠持續。推理商若不願以微利提供服務,可以直接停止託管並把算力轉去其他模型,因此市場價格會逐步貼近邊際成本,而非停留在補貼水平。
減價是否意味補貼期即將結束?
現有證據不支持價格即將急升的說法。推理市場進入門檻低、供應商眾多,加上邊際成本持續下降,價格更可能維持下行或平穩。
市場上有一種流行說法:低價屬於養客手段,補貼結束後價格會回到「真實成本」。這個推論套用在共享乘車行業有其道理,該市場最終由兩家公司主導,具備定價權。
推理市場的結構不同。除了 OpenAI、Anthropic 與 Google,還有二十多家獨立推理商與多個開源模型家族。買方切換成本低,賣方數量多,任何一家試圖提價都會流失流量,這種格局使價格難以上升。
真正的風險在供給側。若某家推理商長期虧損,退出市場會令可用供應短期收縮。不過在算力過剩與模型蒸餾普及的現況下,這種收縮通常由其他廠商迅速填補。
對開發者與企業的實際影響是什麼?
單位成本下降令原本不划算的場景變得可行,例如長上下文檢索與多輪代理。但總支出未必同步減少,因為團隊通常會提高使用量。
Vercel 的 AI 網關數據顯示,每 token 成本已降至 2026 年 4 月的四成三,但整體支出仍在上升。原因在於模型能力提升的速度快於價格下降,團隊會把節省下來的預算投入更複雜的任務。
對個人開發者而言,最直接的變化是原型成本。以前需要壓縮上下文、限制重試次數的流程,現在可以用完整上下文跑通,除錯時間隨之縮短。
對企業而言,關鍵變成治理而非省錢。當單次調用便宜到可以忽略,真正的支出風險來自無人監控的背景任務與重複調用,成本控制的重心由單價審查轉向用量審計。
香港與亞洲團隊應如何部署?
亞洲團隊可優先採用多家推理商並行的路由策略,把長上下文任務導向快取價低的模型,同時保留一家閉源旗艦處理高難度推理,避免單一供應風險。
實務上可先盤點現有工作流的 token 結構。若快取讀取佔比超過八成,選擇快取價低的型號帶來的節省會遠大於比較輸出標價。
其次要處理地域與合規。部分推理商在亞洲缺乏節點,延遲會抵消價格優勢;涉及客戶資料的流程則需確認資料留存政策,不能只看報價。
最後是備援設計。把模型端點寫成可替換的設定,並在主要供應商出現限流時自動切換,這種做法在過去一年已多次證明有用。
出處連結有哪些?
數據來自 Max Woolf 於 2026 年 10 月 25 日發佈的價格時間線分析,並引用 Vercel AI 網關與 OpenRouter 的公開統計,價格以每百萬 token 美元計。
本文數據來自 Max Woolf 於 2026 年 10 月 25 日發佈的價格時間線分析,原文同時引用 Vercel AI 網關與 OpenRouter 的公開統計。原始文章位於 minimaxir.com,該文於 Hacker News 首頁獲得超過三百點支持。所有價格數字均以每百萬 token 計,並以美元為單位。
總結:現在該如何選模型?
價格已非主要分野,旗艦型號的單位成本差距收窄至兩三倍。合理做法是閉源旗艦處理複雜推理,其餘重複任務交給開源權重或低價小型號。
價格已經不再是區分模型的主要指標。旗艦型號之間的單位成本差距收窄至兩三倍,而能力差距往往只有數個基準分數。選型的判斷重心應轉向任務匹配度、延遲表現與資料合規。
對大多數團隊而言,合理做法是維持一條閉源旗艦線處理複雜推理,其餘大量重複性任務交給開源權重模型或低價小型號。這種組合既保住輸出質量,也把成本壓在可控範圍。
減價趨勢是否延續,取決於推理商的盈利能力與開源模型的追趕速度。以目前每月都有新權重釋出的節奏判斷,短期內價格回升的條件並不充分。
