OpenAI 於二零二六年十月三十日宣布,將在未來數月支援 robots.txt 內的共用 AI 訓練偏好信號,令牌名稱為 __usage_ai-training。此機制沿用既有群組語法,以一組規則向多家參與供應商表態。草案由 IETF AI Preferences 工作組推進,OpenAI 表明會遵守。
OpenAI 這次改變了什麼?
OpenAI 承諾未來數月支援 robots.txt 共用令牌 __usage_ai-training。網站寫一組規則,即可向多個參與供應商表達同一訓練偏好。
過去十年,網站管理員表達「不要用我的內容訓練模型」的方式,是在 robots.txt 內逐一辨識供應商的產品令牌。GPTBot 一組、ClaudeBot 一組、Google-Extended 又一組,每家新增或改名,管理員便要回頭修改檔案。這種做法把標準的維護成本轉移到最沒有議價能力的一方。
共用信號改變的是維護介面,而不是規則本身。草案明確寫出不新增指令名稱、不新增語法,路徑語言、最長匹配優先與群組結構全部沿用 RFC 9309。已部署的解析器遇到不認識的令牌,行為與以往一致,會直接忽略該群組。
OpenAI 在公告中把這件事定位為自願性質的務實一步,並表示現有的爬蟲控制不會被取代。該公司既有的 bots 說明頁仍會繼續生效並被尊重。
__usage_ai-training 信號如何寫進 robots.txt?
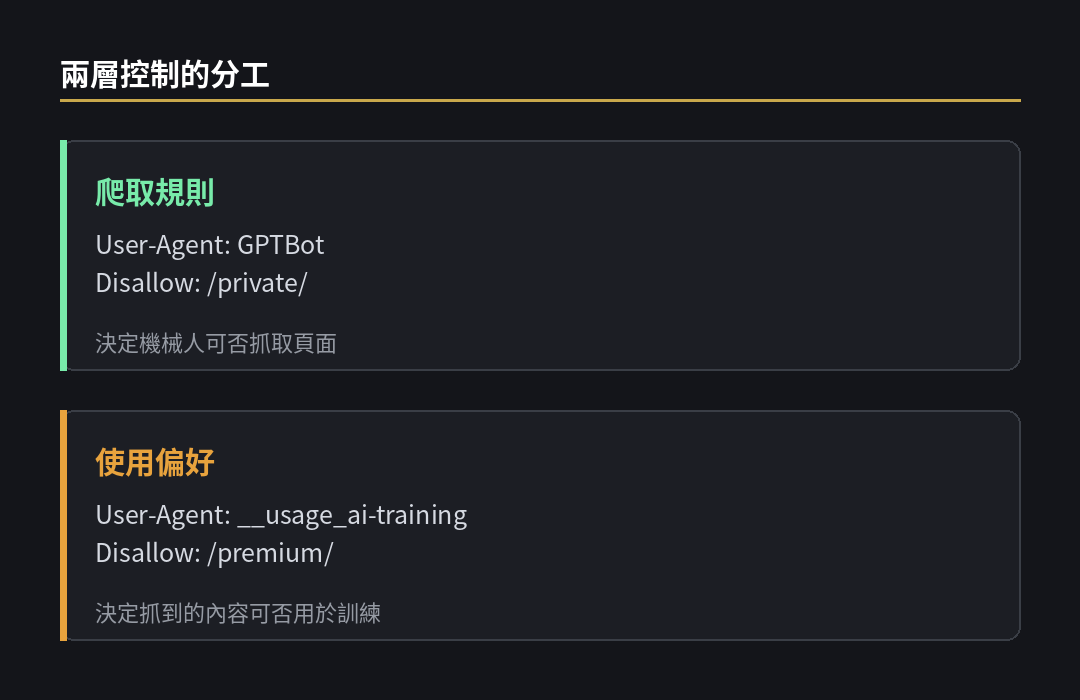
在 robots.txt 新增 User-Agent 行,值為 __usage_ai-training,下接一般 Disallow 規則,同組可列出多個政策令牌。
寫法與既有規則完全一致。草案定義的政策令牌為 __usage_ai-training,符合 RFC 9309 產品令牌的語法範圍,只使用字母、底線與連字號。前綴的雙底線是刻意設計,用來降低與真實爬蟲名稱意外碰撞的機會。
一個群組可以同時列出多個政策令牌,只需連續寫數行 User-Agent。草案也允許政策令牌與普通產品令牌混在同一組,這在過渡期相當實用,管理員可以把「某隻爬蟲」與「某種用途」寫在一起,減少檔案重複。
匹配方式沿用最長匹配優先,因此路徑層級的表態可以做得相當細緻。付費內容、會員專區、圖片目錄可以各自設定,不必為了保護一小部分內容而整站封鎖。
這個信號與爬蟲規則有什麼分別?
兩者獨立並存。爬蟲規則回答「可否抓取」,政策令牌回答「抓到後可否用於訓練」。草案規定萬用字元群組不得當作政策令牌匹配。
草案把兩種信號的界線寫得很清楚:內容使用偏好與流量管理信號可以同時存在於 robots.txt,但彼此正交。供應商仍須依照自己的產品令牌解讀爬取規則,該部分的語義完全不變。
三條技術細節值得留意。第一,萬用字元群組不得被解讀為匹配政策令牌,因此 User-Agent: * 不能代替 __usage_ai-training。第二,若檔案內完全沒有該令牌的群組,即表示沒有表態,而非默許。第三,政策令牌本身不是爬取指令,供應商可以參考偏好來決定是否抓取,但沒有義務停手。
換句話說,這是一個表態通道,不是一道鎖。它讓「不願授權訓練」從各家自行定義的私有令牌,變成可跨供應商一致解讀的公開記錄。
網站管理員實際可以怎樣用?
先盤點需要保護的路徑,例如付費專區與原創圖庫,再以一個 __usage_ai-training 群組集中宣告。原有爬蟲群組保留不動,兩者並存即可。
第一步是盤點,而不是改檔。把站內內容分成三類:完全開放、僅限搜尋索引、禁止任何生成式訓練。多數網站真正想保護的往往是少數高價值路徑,而不是全部內容。
第二步才是寫規則。將需要保護的路徑放進 __usage_ai-training 群組,其餘路徑不必逐條允許;沒有寫到的路徑依照最長匹配與預設行為處理。既有針對個別爬蟲的群組維持原狀,兩套規則可以長期並存。
第三步是記錄。由於信號以檔案為準,草案規定偏好的效力以內容被檢索當下的 robots.txt 為準。若日後政策改變,變更只影響之後的抓取,過往已取得的資料不會因此回溯失效。
對於同時經營內容與授權業務的網站,這個信號還有一個附帶好處:它把「已明確表態」變成可查證的事實,日後在授權談判或爭議處理時,舉證成本明顯低於口頭聲明。
現階段有什麼限制與未解問題?
OpenAI 只承諾未來數月實作,尚未公布細節。草案屬工作組文件,隨時可能修改。加上檔案容量受限、遵守與否仍取決於各供應商自願,實際約束力有限。
時間表是第一個變數。OpenAI 表示會在未來數月實作,屆時才公布具體做法。在此之前,宣告了這個令牌的網站,並不保證已獲得任何一家的承認。
第二個變數是規範狀態。這份草案由 IETF AI Preferences 工作組處理,屬征求意見階段,六個月後到期,內容可能被更新或取代。把生產環境的授權政策完全押在一份會過期的草案上,風險顯而易見。
第三個變數是檔案容量。RFC 9309 要求解析器至少支援 500 KiB 的 robots.txt,路徑規則寫得越細,越容易逼近上限。大型媒體網站若想逐篇文章表態,仍會遇到容量與維護的雙重壓力。
最後是執行力。草案沒有規定違反偏好的後果,僅在優先順序一節提到具體表態優先於一般表態,以及私下協議可以覆蓋此機制的表態。實際是否停用、是否追溯,仍由各家自行決定。
對內容產業與 AI 訓練授權有什麼影響?
它把訓練授權的預設值由「逐家協商」推向「公開表態」,降低中小型網站的談判成本。長遠可能形成分層市場:明確禁止訓練的內容與開放授權的內容,價格與流通方式逐漸分開。
對大型媒體集團而言,這個信號的意義有限,它們本來就有法務團隊與授權合約。真正受益的是無力逐家談判的中小型網站、獨立部落格與開源文件站點,它們首次可以用低成本方式留下一致記錄。
值得注意的是草案的作者背景。文件由 Anthropic 的 K. Kelley 掛名提出,而率先表態遵守的是 OpenAI。這種「一家提出、另一家先響應」的組合,說明供應商在訓練資料的來源正當性上,正面臨共同的外部壓力。
從市場結構看,公開表態機制一旦普及,內容供給會自然分成兩層。願意授權的內容可以進入商業談判,強調禁止的內容則逐步退出訓練語料。這種分層是否會壓縮小型網站的曝光機會,目前沒有數據可以回答。
出處連結有哪些?
本文資訊來自 OpenAI 於二零二六年十月三十日發布的公告,以及 IETF 的訓練偏好草案原文,兩者均可公開查閱。
- OpenAI 公告:Making it easier for websites to express AI training preferences
- IETF 草案:draft-kelley-aipref-training-preference-signal-00
- IETF 詞彙草案:draft-ietf-aipref-vocab
- OpenAI 爬蟲控制說明:developers.openai.com/api/docs/bots
常見問題有哪些?
以下四題集中處理最常見的疑慮,包括機制是否取代既有封鎖、未表態是否等於同意、現在是否應該加入,以及舊有私有令牌是否需要保留。
這個信號會取代原有的爬蟲封鎖嗎?
不會。草案明定爬取規則與使用偏好互相獨立,針對 GPTBot 等產品令牌的 Disallow 規則照舊生效,兩者可以並存,也可以分別設定。
沒有寫 __usage_ai-training 代表默許訓練嗎?
不代表默許。草案規定若檔案內沒有任何包含該令牌的群組,即視為沒有表態,供應商不得自行推定為同意。
一般網站現在就應該加入嗎?
可以先加入,但要理解它目前只是表態。在主要供應商完成實作前,宣告的實際效果有限,較穩妥的做法是先盤點高價值路徑,再決定是否公開表態。
舊的私有令牌還需要保留嗎?
需要。草案要求供應商在沒有共用令牌時,仍依照既有私有令牌的語義處理,因此保留舊規則不會造成衝突,反而維持對未參與廠商的約束。
總結:這個信號值得立刻部署嗎?
值得部署,但不宜視為防護措施。它成本極低、可與既有規則並存,適合用來留下明確表態記錄;實際攔截效果仍要等主要供應商完成實作,並取決於各自是否自願遵守。
共用訓練偏好信號的價值,在於把一件長期由各家自行定義的事,收攏成一份可讀、可查、可比較的公開記錄。技術門檻幾乎為零,維護成本遠低於逐家追蹤爬蟲名單。
它的局限同樣明顯:沒有強制力,沒有罰則,實作時間未定,規範本身仍可能修改。把它當成授權談判的起點與證據,遠比當成技術防線合理。
對內容經營者而言,真正的判斷點在於自身的內容是否具備授權價值。若答案是肯定的,及早表態、留下記錄,成本低於日後補救;若答案是否定的,這個信號的實際作用,大概只是讓檔案多了一行。
