OpenAI 於二零二六年十月二十六日在 math 儲存庫新增兩篇手稿,其中《The Exponential Time Hypothesis is False》提出確定性演算法,可在次指數時間精確計算任意固定寬度 k-CNF 的解數,宣稱推翻指數時間假設與其多個變體。
該手稿提出確定性演算法,對每個固定 k 在次指數時間精確計數 k-CNF 的解,時間為多項式乘以 2 的 n 除以 log n 平方次方,空間為多項式。
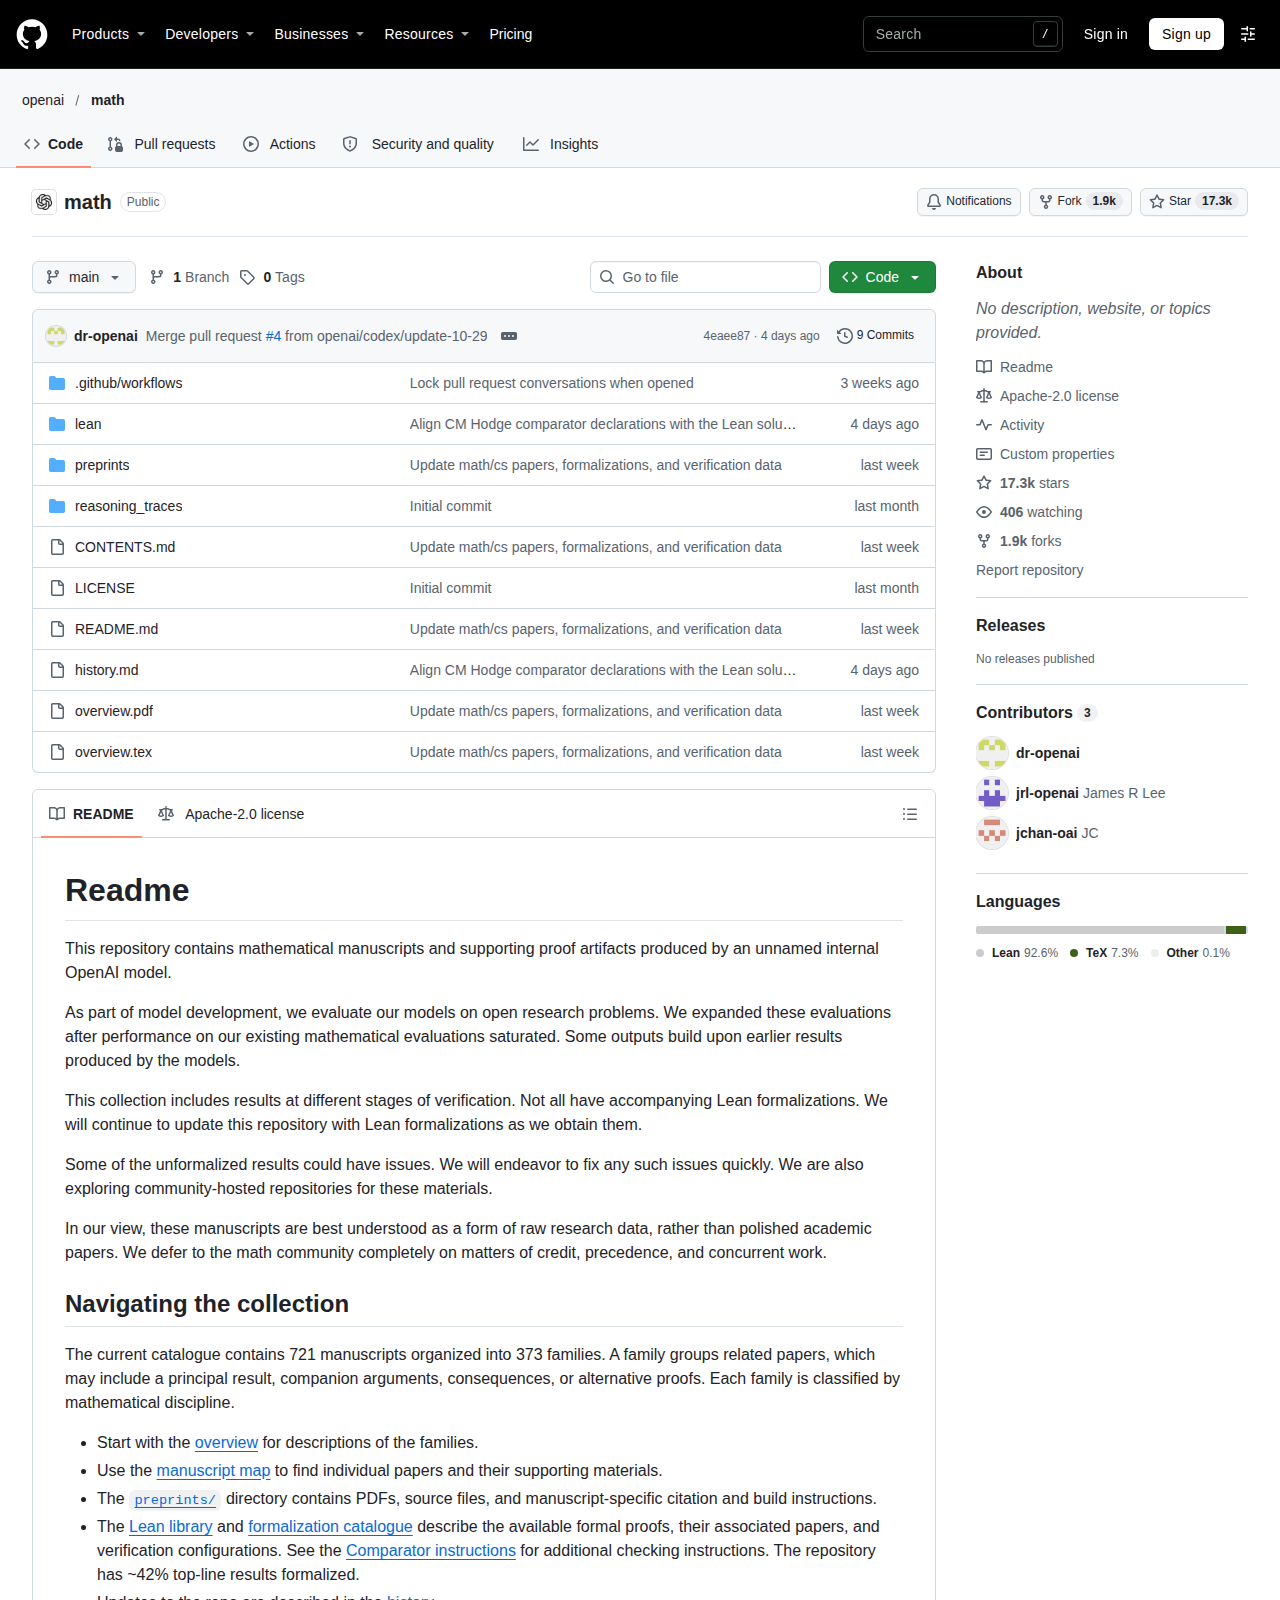
儲存庫在同日更新紀錄中說明,一個由電腦科學家組成的獨立工作組將審查並解釋這份證明,按該小組要求,材料即時公開。這批手稿連同既有的七百二十一篇數學文稿一併存放,全部由一個尚未發布的內部模型產生,儲存庫採用 Apache 2.0 授權,目前累積約一萬七千顆星標。
這次新增了哪兩篇手稿?
十月二十六日新增兩篇,分別處理歐氏波動方程的局部平滑性,以及指數時間假設的推翻,兩篇均附 Lean 形式化證明,並同步公開模型的原始輸出。
第一篇《Local smoothing for the Euclidean wave equation》以一個輔助偏微分方程,證明 Sogge 在每個空間維度至少為二時的局部平滑猜想。該論證同時得出 Kakeya 極大猜想、Kakeya 維度猜想,以及 Stein 球面限制估計在猜想範圍內部的完整結果。
第二篇就是這次爭議的核心。OpenAI 在更新紀錄中表示,這一篇按十月六日發布時的同一個做法,直接公開模型的原始輸出,未經人工改寫,交由外界自行判斷。
指數時間假設是什麼?
指數時間假設主張最壞情況下判定 n 個變數的 3-SAT 需要 2 的 Ω(n) 次方時間,是細粒度複雜度與參數化演算法大量下界的共同基礎。
這個假設由 Impagliazzo 與 Paturi 在 2001 年提出,主張最壞情況下判定 n 個變數的 3-SAT 需要 2 的 Ω(n) 次方時間,因此對每個固定 k 大於等於三,k-SAT 同樣需要指數時間。強指數時間假設給出更精確的預測,認為當 k 增大時,k-SAT 所需時間趨近 2 的 n 次方。
二十五年來,這兩個假設支撐了細粒度複雜度領域的大量推論。從編輯距離、最長公共子序列到正則表達式匹配,許多問題被認為已接近理論最優,理由正是它們能從 SAT 的指數下界歸約而來。
該演算法的執行時間與空間複雜度如何?
對每個固定 k 大於等於二,輸入含 n 個變數與 m 個子句時,演算法使用多項式空間,時間為多項式乘以 2 的 n 除以 log n 平方次方。
論文摘要給出的界線是:對任意 k-CNF,演算法在 poly_k(n,m) 空間內完成,時間為 (n+m) 的多項式乘以 2 的 n 除以 (log n) 的 1+o(1) 次方。由於指數部分的分母含有 log n,增長速度低於任何 2 的 εn 次方,屬於嚴格的次指數時間。
論文標示日期為 2026 年 10 月 17 日,10 月 25 日修訂,正文共六十四頁。目錄從引言、技術概覽,一路鋪陳到稀疏多項式方程組的公共零點計數,另有四個附錄處理分割、精確算術、額外推論與更緊的計數界。
技術路線上有什麼關鍵手法?
論文先在每變數最多出現三次的 3-CNF 上用插值還原精確解數,再以不相交稀疏化與變數複製推廣到任意 k-CNF,核心工具是共享線性摘要。
第一步處理受限情形:每個子句最多三個文字,每個變數最多出現在三個子句。此時子句多項式乘積的總次數不超過 3n,可利用 Hermite 插值從小子集的和還原完整計數。
第二步用不相交稀疏化與變數複製,把任意 k-CNF 轉為可處理的形式。論文以共享線性摘要與低次替換形式為核心工具,把計數問題化為稀疏多項式方程組的公共零點計數,並以條件期望法選取額外的奇偶校驗。
這項結果推翻了哪些複雜度假設?
論文宣稱同時推翻 ETH、SETH、Gap-ETH、NSETH 與計數版本的 ETH,並得出 ENP 不具有線性大小電路的推論,但未觸及 P 與 NP 問題。
論文明言主要定理推翻 ETH、SETH、Gap-ETH 與 NSETH。由於演算法同時提供精確計數,計數版本的假設亦隨之失效,過往依賴該假設排除次指數演算法的推論一併失去依據。
附錄借用 Williams 在 2013 年的結果,若 ETH 為假則 ENP 不具有線性大小電路,得出 ENP 不包含於 SIZE(O(n)) 的推論。論文亦保持克制,指出部分下界可由較弱的正交向量猜想繼續支撐,並不宣稱所有下界同時崩塌。
為何 OpenAI 選擇立即公開而非等待同儕評審?
由 Impagliazzo、Paturi 與 Williams 領導的獨立小組將檢視並解釋該證明,按該小組要求,材料即時公開供同步審查。
儲存庫的更新紀錄寫明,一個由電腦科學家組成的獨立工作組將審查並解釋這份證明,成員包括 Russell Impagliazzo、Ramamohan Paturi 與 Ryan Williams。三人長期深耕細粒度複雜度與 SAT 演算法,其中 Paturi 正是指數時間假設原始論文的作者之一。
這個安排把驗證責任明確外判,同時也承認單靠發布方無法自證。材料即時公開的理由寫得直接:按該小組要求,讓其他人可以一併檢視。
這份證明目前有哪些未驗證的風險?
儲存庫明言手稿屬原始研究數據而非成熟論文,並非全部附 Lean 形式化,且該庫曾因符號錯誤撤回三篇手稿,結論仍需獨立驗證。
README 直接說明,這些手稿應理解為原始研究數據,而非精雕細琢的學術論文,並把功勞、優先權與同期工作的判斷完全交給數學社群。這段自我定位,等於提醒讀者不要把手稿當成已通過審查的成果。
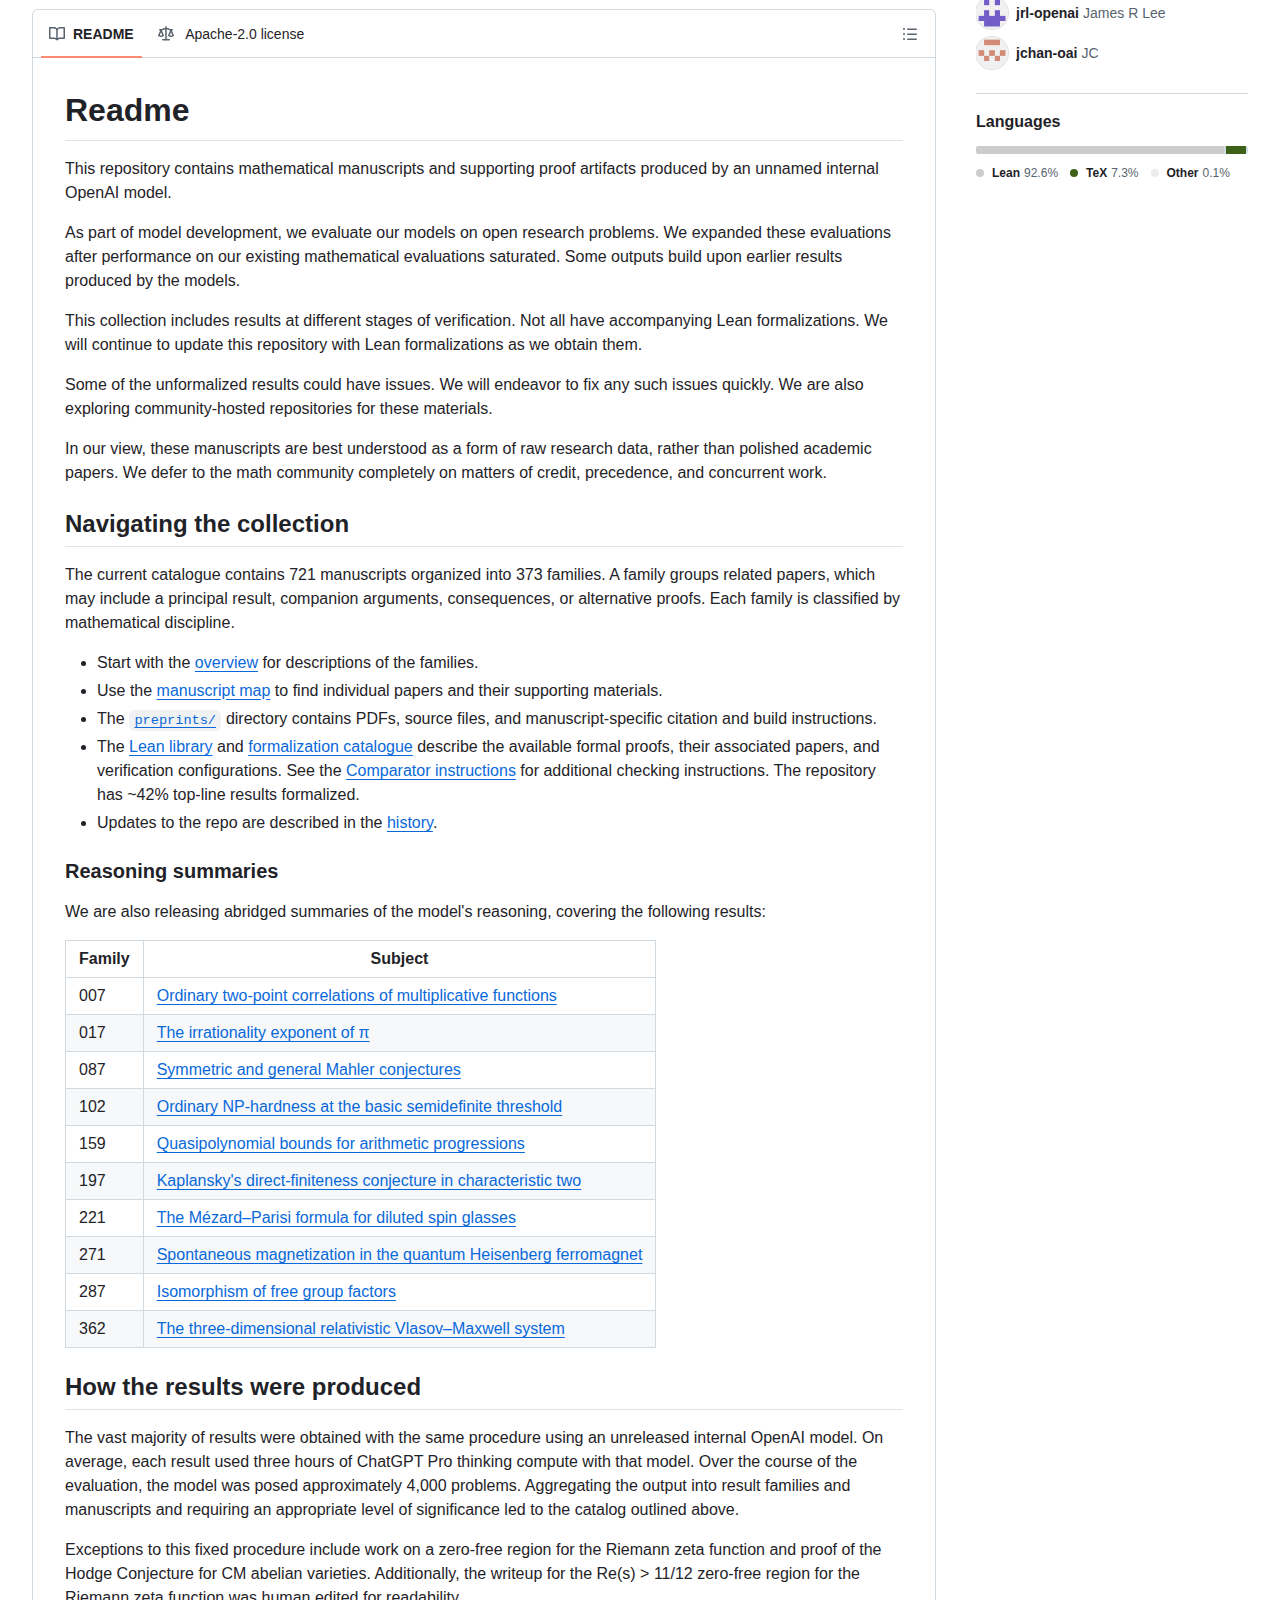
截至十月二十九日,主線結果的形式化比率為 719 項中的 300 項,約百分之四十二,其餘仍待補。十月七日該庫曾因一個符號錯誤作廢穩定跡消去論證,連帶撤回三篇手稿,顯示未形式化的部分確實存在實質風險。
儲存庫整體的驗證進度如何?
目前收錄 721 篇手稿、373 個成果家族,主線結果形式化約百分之四十二,修正與撤回全部以版本方式記錄,舊版仍可存取。
目錄現有七百二十一篇手稿,分屬三百七十三個成果家族,每個家族按數學學科分類。儲存庫表示會保留完整發布歷史,修正與修訂以新版本記錄,舊版本仍然公開可取。
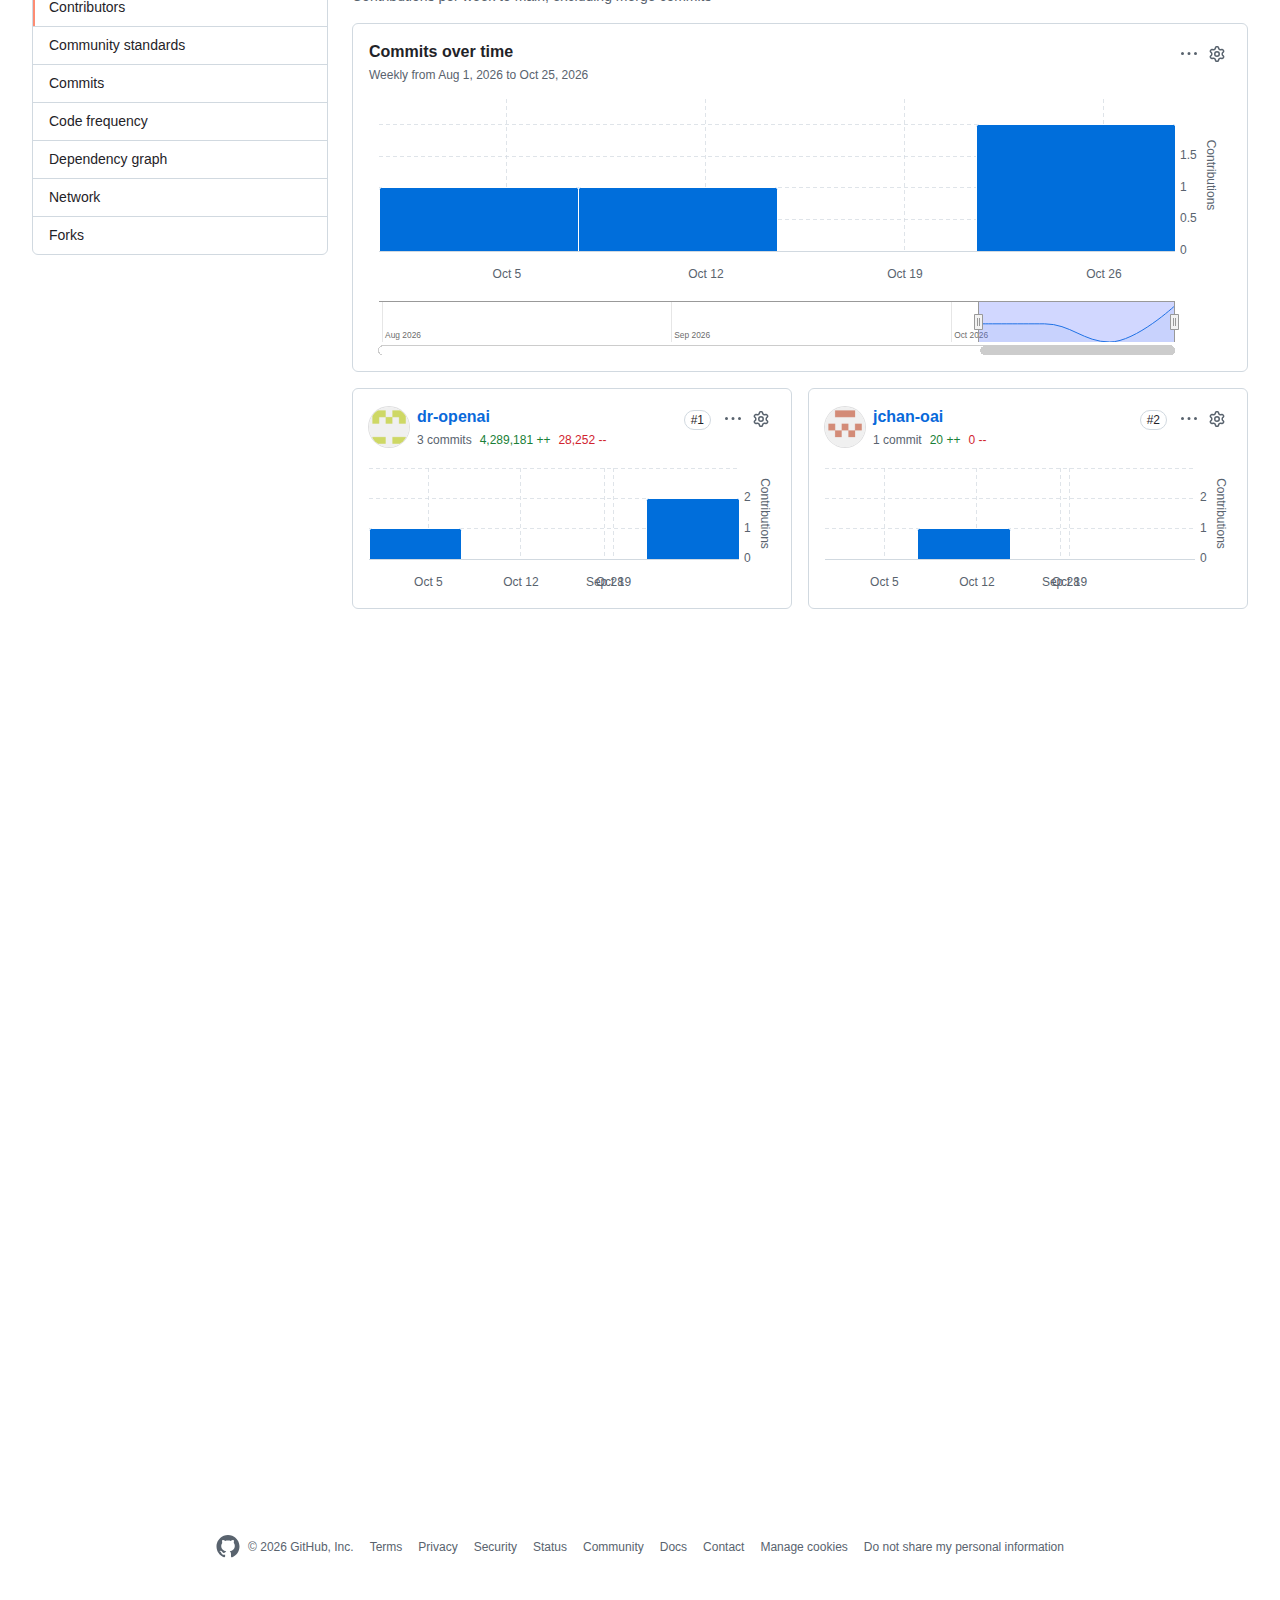
十月七日的一次修訂中,除撤回三篇外,另有十四篇手稿修補證明、更正命題陳述與假設條件,並因引用關係更新了十三篇。十月二十六日的更新亦修正部分形式化配置,並為 CM 阿貝爾簇的 Hodge 猜想補上 Lean 證明。
對開發者與研究者有什麼實際影響?
若證明成立,依賴 ETH 或 SETH 的細粒度下界將失去依據,演算法設計與複雜度教學的假設基礎需要重估,但短期工具鏈不受影響。
這些下界過去被用來解釋編輯距離、最長公共子序列、動態時間規整與正則表達式匹配等問題為何難以顯著加速。論文指出,其中部分結果可由正交向量猜想等較弱假設繼續推出,因此並非全部失效。
對實務開發者而言,短期內不會改變任何工具鏈或函式庫。中長期可能影響密碼參數的保守程度,以及演算法課程的內容取捨,特別是在講授「為何此問題只能做到這個複雜度」的時候。
如何取得與檢查這份手稿?
手稿位於 preprints 目錄下的專屬資料夾,附六十四頁 PDF 與 BibTeX,形式化在 lean 目錄,可用 Comparator 重跑驗證。
手稿存放於 preprints/The-Exponential-Time-Hypothesis-is-False-October-25-2026 目錄,內含 PDF、建置設定與引用用的 BibTeX 區塊。形式化部分位於 lean 目錄,清單在 lean/formalization.yaml,另有 Comparator 的檢查說明。
研究者若要自行驗證,可以 clone 儲存庫,按 Comparator 文件重跑對照。儲存庫亦提供總覽 PDF 與手稿地圖,方便先定位成果家族再深入單篇。
常見問題有哪些?
常見疑問集中在四點:是否等於 P 等於 NP、是否已過同儕評審、手稿為何被撤回,以及四成二形式化比率實際代表什麼。
這是否代表 P 等於 NP? 不是。次指數時間仍屬超多項式增長,只是指數部分被壓低,與多項式時間相距甚遠,P 與 NP 的問題不受影響。
這份論文經過同儕評審嗎? 沒有。目前由獨立學者小組檢視,尚未完成期刊評審流程,儲存庫本身亦以原始研究數據定位這批材料。
為何部分手稿被撤回? 十月七日其中一篇出現符號錯誤,導致穩定跡消去論證失效,連帶三篇依賴該結論的手稿一併撤回,撤回通告已附在目錄中。
形式化比率四成二代表什麼? 代表七百一十九項主線結果中約三百項已有 Lean 證明可供機器檢查,其餘仍只有文字論證,需要人工閱讀判斷。
這批手稿的作者是誰? 儲存庫署名為 OpenAI,全部內容由一個尚未發布的內部模型產生,平均每項結果消耗約三小時的推理算力。
總結:這批材料適合哪些讀者?
適合關注複雜度理論、SAT 演算法與人工智能數學能力的讀者,但應把結論視為待驗證的線索,而非既定事實。
這次更新的價值,在於把一個足以動搖理論計算機科學基礎的宣稱,連同原始論證一併放到公眾面前。讀者可以逐節檢查推導,也可以等待獨立小組的解釋。
在形式化比率仍為四成二、且該庫已有撤回前科的情況下,把結論當成待驗證的線索,比當成既定事實更為合適。真正的判準,將落在獨立小組的說明,以及後續能否補上完整形式化。
