微軟研究院於二零二六年五月開源 SkillOpt,把代理的技能文件視為可訓練狀態,用留出驗證集的分數把關每一次改動。專案於十一月四日累積一萬八千八百七十顆星標,六個基準、七個模型與三種執行環境共五十二個組合全部最佳或並列最佳。本文整理訓練迴圈、部署產物與實際限制。
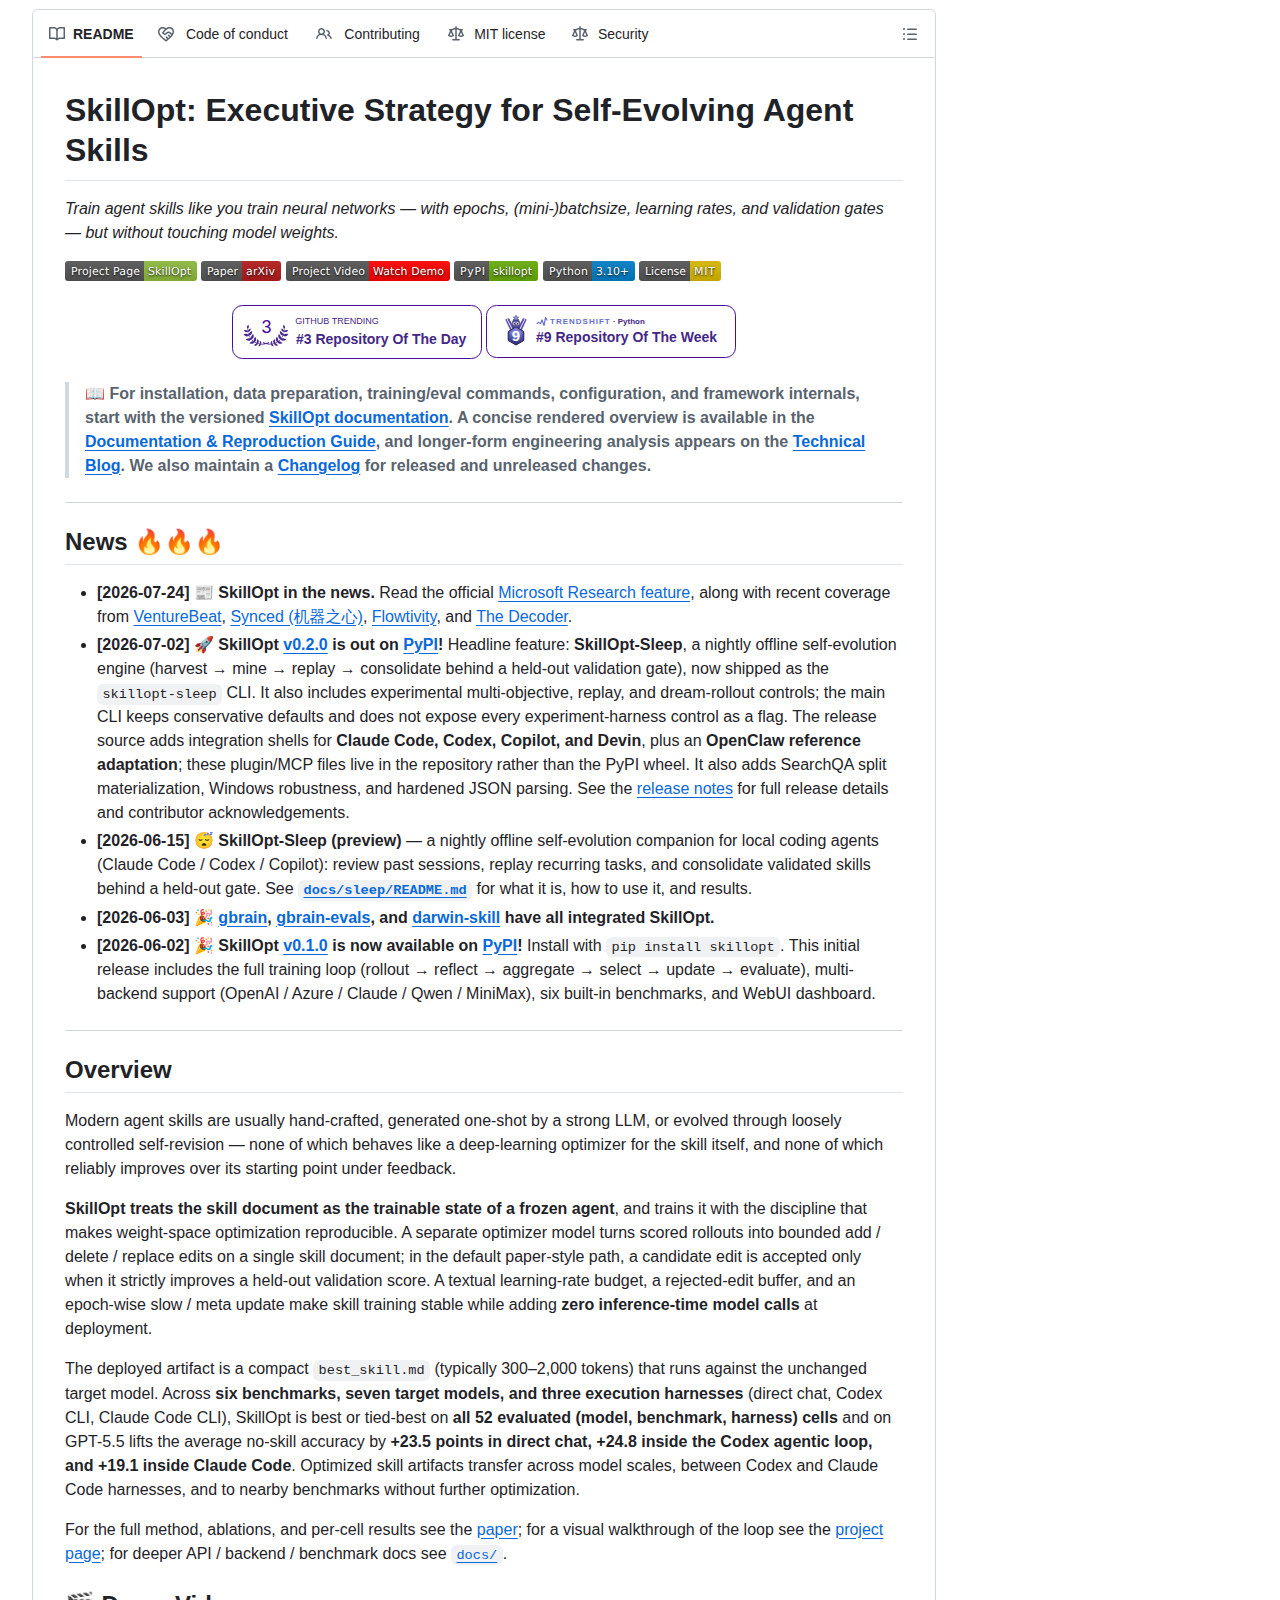
專案的定位相當明確。多數代理技能由人工撰寫、由強模型一次生成,或經過鬆散的自修訂,三種做法都沒有可重複的改進機制,遇上回饋時未必比初始版本更好。
SkillOpt 提出另一條路徑。它假設技能文件就是代理的可訓練狀態,模型權重完全凍結,改動只發生在文字檔案之中,並以與權重優化相同的紀律控制整個過程。
儲存庫以 Python 撰寫,採用 MIT 授權,目前有一千七百九十四次復刻與七十二個未關閉的議題。首個版本於六月二日發布,第二個版本於七月二日推出,加入名為 SkillOpt-Sleep 的夜間自我演化模組。
SkillOpt 是什麼?
SkillOpt 是微軟研究院開源的技能優化器,把代理的技能文件當成可訓練參數,以留出驗證集分數決定每次改動是否保留,部署時不需要額外的模型呼叫。
專案把訓練迴圈拆成五個步驟:執行軌跡、反省、聚合、選擇、更新。每一次循環都針對單一技能文件產生候選編輯,編輯形式限定為新增、刪除與替換三種。
整個流程的關鍵在於驗證。預設路徑下,候選編輯必須嚴格提升留出驗證集的分數才會被接受,否則進入被拒絕編輯的緩衝區,避免同一類錯誤改動反覆出現。
最終產物是一份名為 best_skill.md 的檔案,篇幅通常介于三百至二千個 token 之間。它在部署時與未經修改的目標模型一起使用,不會增加推論階段的模型呼叫次數。
技能文件為什麼可以訓練?
因為技能以文字形式存在,修改後的效果可以立即在驗證集上量度。這使技能能像權重一樣接受學習率預算、批次與早停控制,而目標模型本身保持凍結。
文字檔案具備一個容易被忽略的特性:任何改動都可以完整重現。模型權重的更新涉及隨機性與數值誤差,文字編輯則可以被記錄、比對與回滾。
第二個特性是可量度。技能改動之後,只需在固定的驗證集上重跑一次,就能取得分數差異,這個差異可以作為接受或拒絕的唯一依據。
第三個特性是通用性。論文指出,優化後的技能產物可以在不同規模的模型之間轉移,也可以在 Codex 與 Claude Code 兩種執行環境之間轉移,甚至轉移到鄰近的基準而不需要重新優化。
訓練迴圈如何運作?
每輪先以目標模型跑出帶分數的軌跡,再由另一個優化模型提出新增、刪除或替換,通過留出驗證集才寫入技能文件,落選的編輯進入緩衝區避免重複嘗試。
優化模型與目標模型是兩個獨立角色。目標模型只負責執行任務並產生可評分的結果,優化模型只讀取這些結果與分數,提出對技能文件的具體編輯。
為了避免改動過猛,系統引入文字形式的學習率預算。單輪可改動的幅度受限,配合被拒絕編輯的緩衝區,令技能在數輪之內逐步收斂而非劇烈跳動。
此外還有按輪次進行的慢更新與元更新。前者降低後期波動,後者調整優化方向本身,兩者共同構成穩定訓練的外層結構。
五十二個組合全勝代表什麼?
代表方法在多模型多環境下並非單點運氣。GPT-5.5 在直接對話提升 23.5 分,Codex 迴圈 24.8 分,Claude Code 19.1 分,三項皆高於無技能基線。
評測覆蓋六個基準、七個目標模型與三種執行環境,合計五十二個模型與基準與環境的組合。SkillOpt 在全部五十二個組合中取得最佳或並列最佳。
提升幅度以 GPT-5.5 最為明顯。直接對話場景平均準確率上升二十三點五分,放進 Codex 代理迴圈上升二十四點八分,放進 Claude Code 上升十九點一分。
值得注意的是轉移能力。未經重新優化的技能產物在跨模型規模、跨執行環境與鄰近基準上仍保有增益,顯示優化結果捕捉到的是任務方法而非特定模型的偏好。
部署成本與實際限制有哪些?
部署只多一份三百至二千 token 的技能文件,推論時零額外呼叫。限制在於訓練需要大量帶分數的軌跡與可靠的驗證集,驗證集品質直接決定技能是否真正進步。
部署端的成本極低。技能文件以純文字形式隨提示載入,不涉及額外的推論請求,對於已經在使用技能機制的代理而言幾乎沒有邊際成本。
訓練端的成本則不可忽略。每個候選編輯都需要在驗證集上完整執行一次,並取得可比的分數,這意味著需要穩定的評分方式與足夠規模的驗證樣本。
第三項限制是驗證集與實際使用情境的落差。若驗證集無法代表真實任務分佈,被接受的高分技能在生產環境中可能毫無幫助,這是所有以分數把關的方法共同面對的問題。
與手寫技能、一次性生成有何差別?
手寫技能依靠經驗,一次性生成依靠單次提示,兩者都沒有驗證把關。SkillOpt 以分數門檻過濾改動,並保存被拒絕的編輯紀錄,令每次修改可比較、可回溯。
手寫技能的問題在於無法比較。兩份由不同人撰寫的技能孰優孰劣,通常只能依靠個案觀察,缺乏可重複的量度方式。
一次性生成的問題在於沒有修正機會。強模型產出的技能看似完整,但遇上與訓練分佈不同的任務時,往往缺乏應對空間,也沒有機制把失敗經驗回流。
SkillOpt 的差別在於把兩者接上同一個閉環。技能由優化模型提出,由驗證集裁決,被拒絕的改動同樣被記錄,形成一份可審計的演化紀錄。
開發者可以如何使用?
可由 PyPI 安裝並指定後端,在內建基準或自有資料上訓練,輸出 best_skill.md 後放入 Claude Code 直接使用,不需要改動模型權重。
安裝步驟相當直接。套件名稱為 skillopt,透過 pip 安裝後即可使用命令列工具,後端涵蓋 OpenAI、Azure、Claude、Qwen、MiniMax 與相容介面,亦提供 Codex 與 Claude Code 的執行型後端。
自有任務的接入方式有兩種。第一種是沿用內建基準的格式,把資料整理成適配器可讀取的結構;第二種是自行新增基準套件,按文件說明的契約註冊。
若需要觀察訓練過程,可啟動內建的監控面板,預設只綁定本機位址並使用七千八百六十埠。專案亦提供夜間離線演化命令,把過去工作階段的軌跡回收、挖掘、重播與整合,整合前同樣需要通過留出驗證。
出處連結有哪些?
資訊來自專案儲存庫、arXiv 論文編號 2605.23904、專案頁與微軟研究院的技術文章,星標與復刻數字於十一月四日核對。
- 儲存庫:microsoft/SkillOpt
- 論文:arXiv:2605.23904
- 專案頁:microsoft.github.io/SkillOpt
- 技術文章:Microsoft Research
- 套件:PyPI skillopt
常見問題有哪些?
以下五個問題涵蓋與微調的分別、所需的資料規模、授權條款、跨語言適用性,以及對現有代理工作流程的實際影響與建議。
SkillOpt 與微調模型有什麼分別?
微調更新模型權重,需要大量運算資源與部署流程變更。SkillOpt 完全不改動權重,只輸出一份文字技能文件,部署時隨提示載入,可隨時替換或回滾。
需要準備多少資料?
需要的是帶分數的驗證集與可執行的任務軌跡,而非標注過的訓練語料。專案提供六個內建基準可直接使用,自有任務則需自建評分方式與驗證樣本。
授權條款是否允許商業使用?
儲存庫採用 MIT 授權,允許商業使用與修改。惟實際部署時所使用的目標模型與資料供應商,仍受各自的服務條款約束。
技能可以跨語言使用嗎?
論文驗證的是跨模型規模與跨執行環境的轉移,未針對自然語言差異做專門評測。實務上技能多以英文撰寫,非英語任務的成效需要自行驗證。
對現有代理工作流程有何實際影響?
影響集中在技能維護方式。原本依靠人工迭代的技能庫,可以改用分數門檻決定是否採納修改,並保留完整的編輯歷史,令團隊協作時的爭議有客觀依據。
總結:技能訓練會否成為標準流程?
當代理的能力愈來愈多由技能而非權重決定,技能就需要可比較的改進機制。SkillOpt 把驗證門檻與編輯紀錄帶進這個環節,令技能演化從手藝變成流程。
專案的價值不在於某個具體分數,而在於提出一個可檢驗的假設:技能文件是可以被優化的對象,而且優化過程可以像權重訓練一樣具備紀律。
這個假設目前已有初步證據。五十二個組合的最佳或並列最佳成績、跨模型與跨環境的轉移能力,以及大廠與第三方專案的整合,都指向同一方向。
仍未解決的是驗證集的代表性。當技能被高分驗證集訓練到極致,卻在真實任務上表現平平,問題會回到評分方式本身,而非優化方法。這一點值得後續觀察。
