亞馬遜內部票務系統原本以 Claude Sonnet 4.6 為二十類工單貼標籤,近日改用 Strands Decider 的 E4B 模型。官方公布每百萬張工單成本由約 22,200 美元降至約 500 美元,單次呼叫時間由 4,215 毫秒縮至 897 毫秒,輸出 token 由 170 個減至 1 個,全年可省數百萬美元。
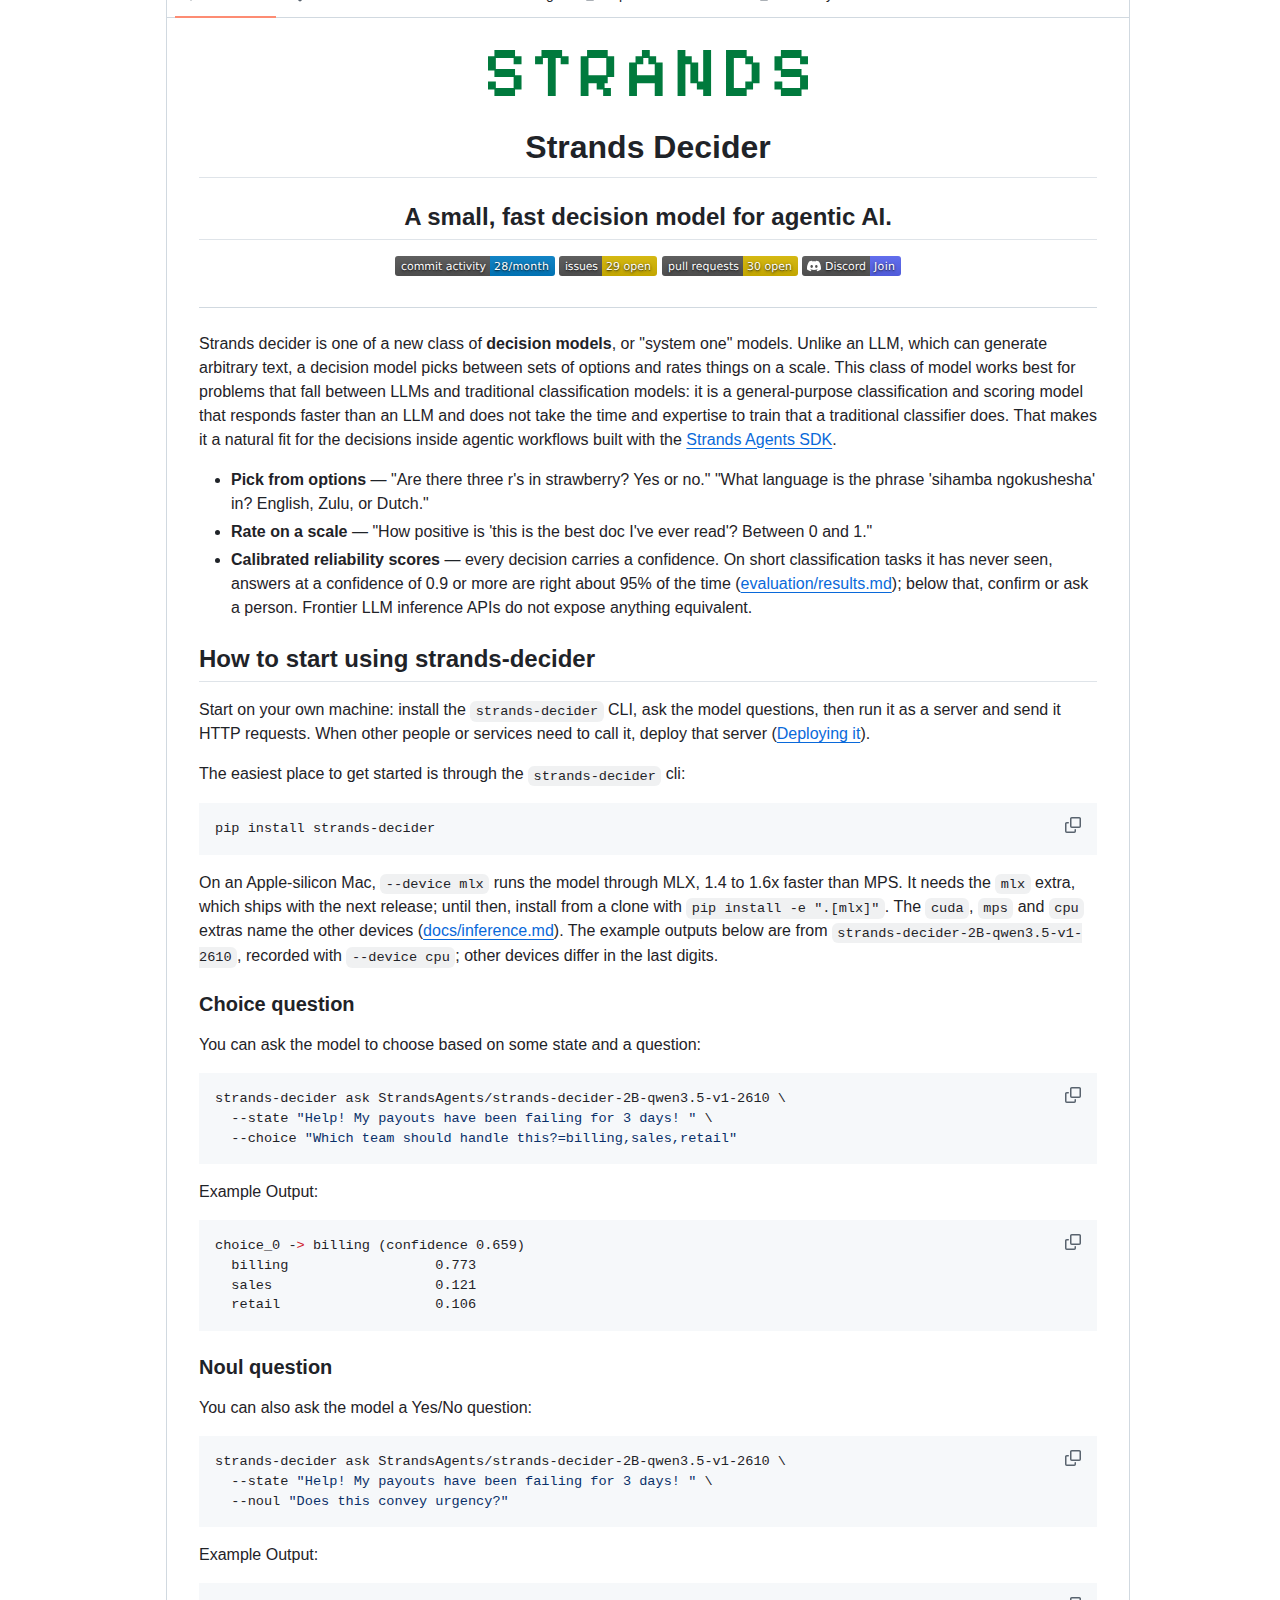
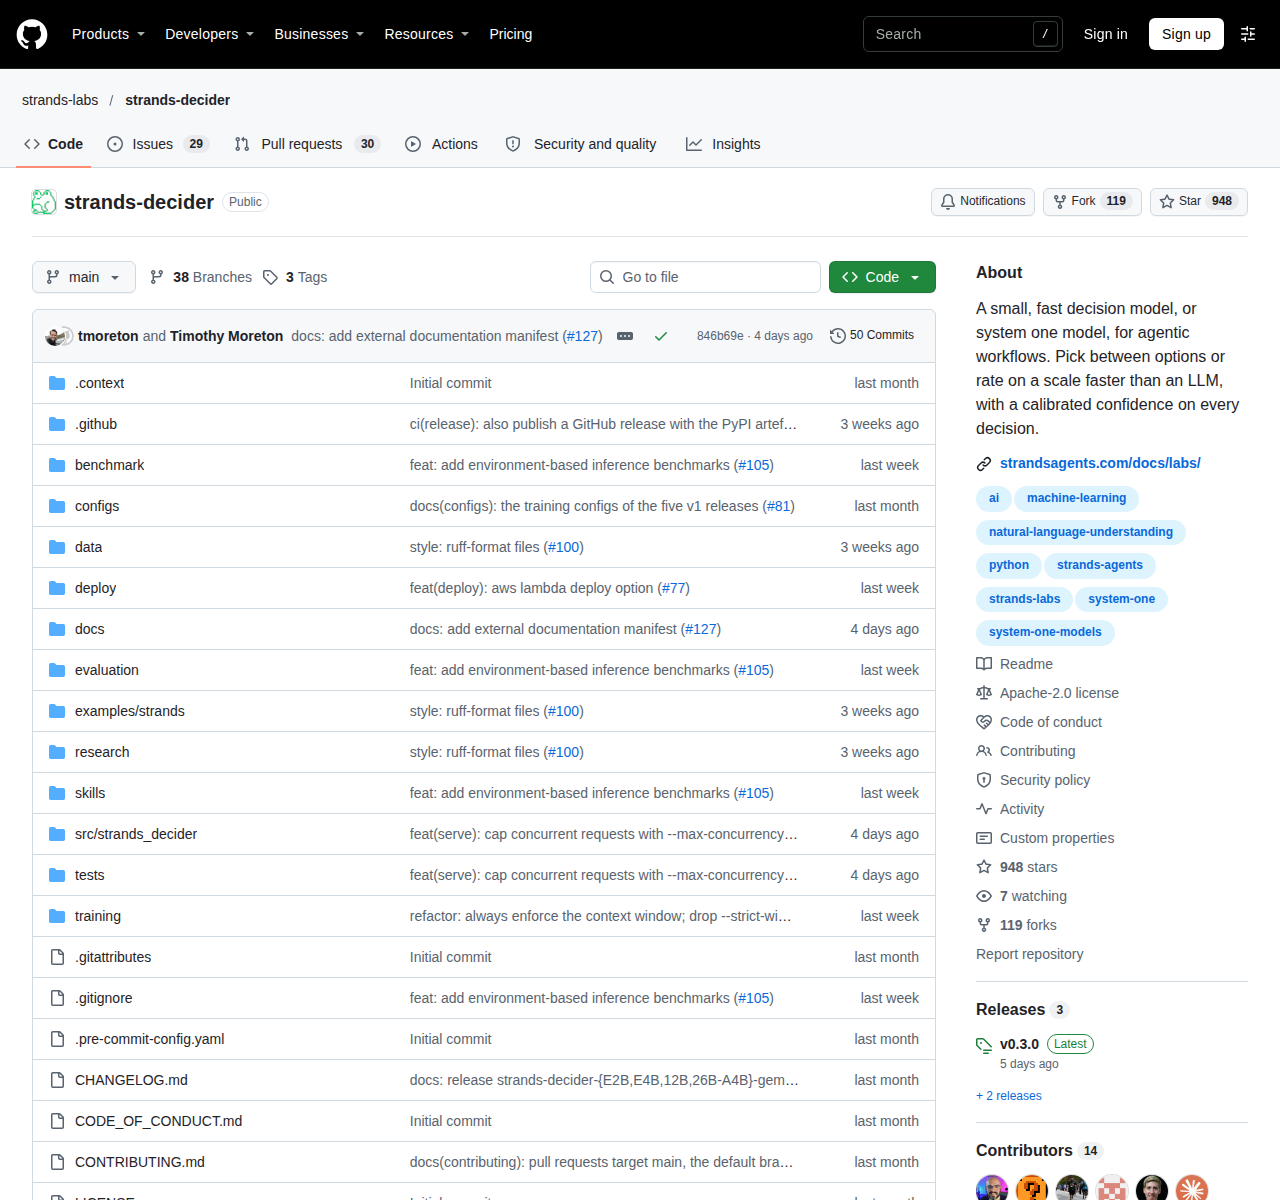
Strands Decider 由 strands-labs 於九月二十九日建立,以 Python 撰寫,Apache-2.0 授權,至十一月十日累積約 946 顆星標與 119 次複製。它不屬於通用語言模型,而是官方所稱的決策模型,也叫系統一模型。這類模型只做兩件事:在一組已知選項中挑一個,或按既定尺度給出分數。
亞馬遜的個案由兩名工程師 Carr 與 Mehul 撰寫,發表在 Strands 官方部落格。他們把一個每天處理大量客戶升級、容量申請、自動告警與安全告警的內部工單系統,從語言模型推理路徑換成一個 2B 參數的決策模型,並公開完整量測數據與切換方法。
Strands Decider 是什麼?
Strands Decider 是開源決策模型,只從已知選項挑選或按尺度評分,回傳各選項機率與信心值,不生成文字。基礎模型為 Qwen3.5 與 Gemma 4。
三種提問形式構成全部介面。選項選擇題把狀態與一組候選標籤送出,模型回傳各標籤的機率;是非題回傳一個貼近一的分數代表傾向成立;尺度評分則在有序等級之間給出落點,例如判斷一段文字的情緒位於平靜、不滿或低落之間。
每個答案都附帶信心值,這是它與傳統分類器最大的差異。官方評估顯示,在未曾見過的短分類任務上,信心值達 0.9 以上的答案約有 95% 正確;低於此門檻時,建議改為人工確認或向使用者追問。前沿語言模型的推理介面並不提供對等的可靠度訊號。
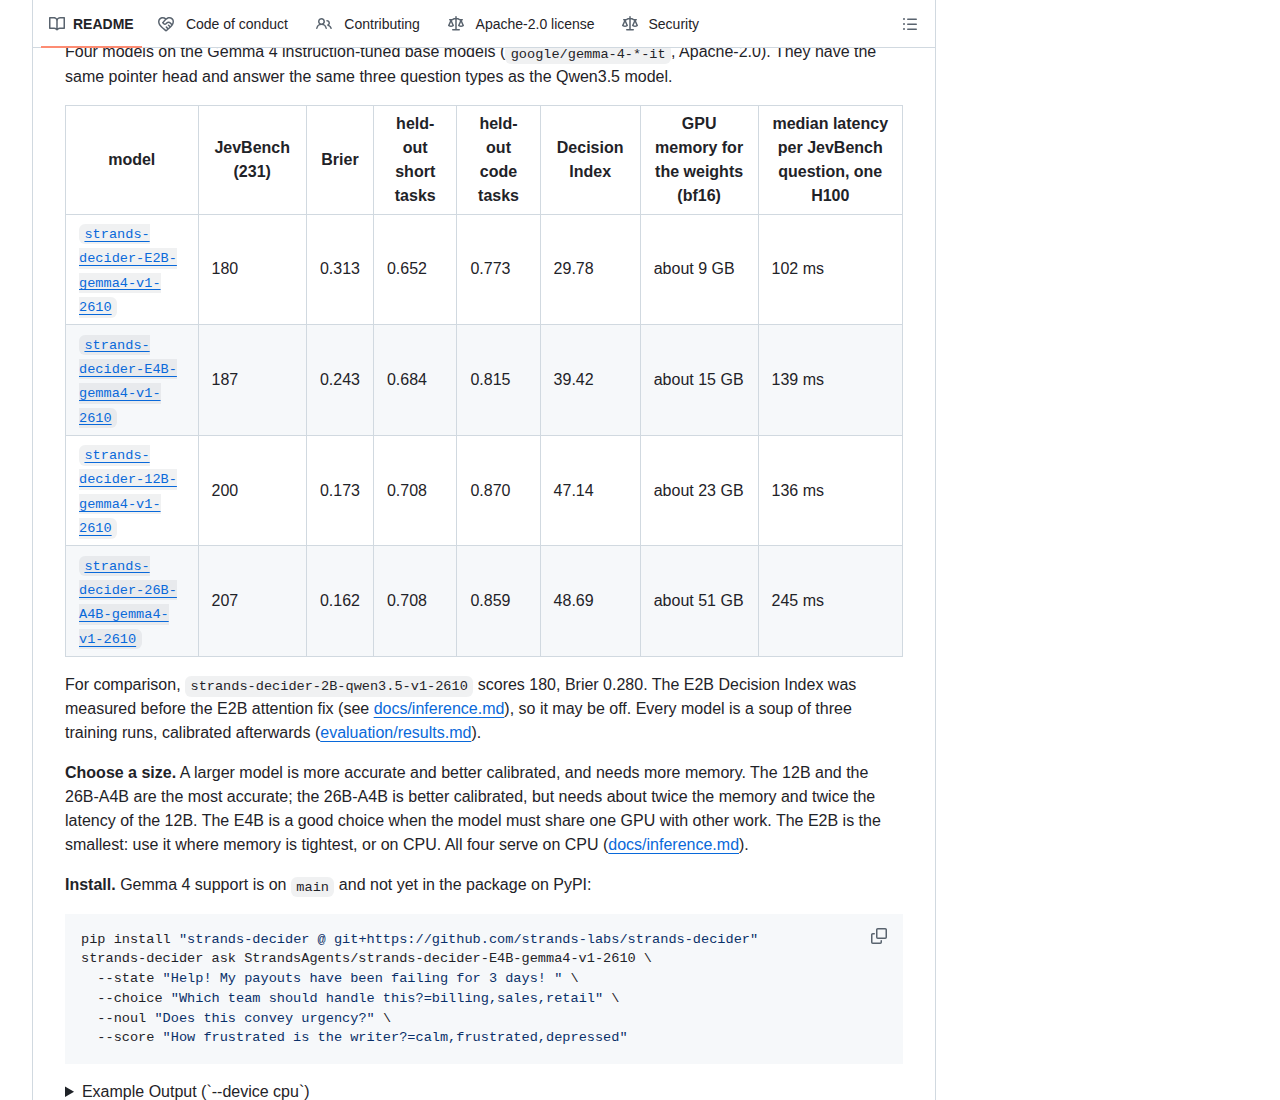
模型權重放在 Hugging Face 的 StrandsAgents 組織,五個 v1 版本同時鏡像到 amazon 組織。尺寸涵蓋 Qwen3.5-2B 與 Gemma 4 的 E2B、E4B、12B、26B-A4B 四級,全部共用同一個指標頭,回答相同的三種題型。
為什麼 2B 模型可以取代 Sonnet?
因為工單分類是從二十個已知標籤中單選,屬封閉選項任務。模型只輸出一個選擇,不必產生 JSON 與推理文字,提示詞可壓到四千 token 內。
亞馬遜的票務系統每天把客戶升級、容量請求、自動告警、安全發現等項目歸入二十類標籤之一。原本的做法是每次呼叫都帶一段長系統提示,要求模型產生 JSON 並附上推理過程,再從輸出中解析結果。
改用決策模型後,工程師把二十個標籤各改寫成一至兩句判準,加上一個「無適用」選項,整體包成一道單選題。工單內容作為狀態送出,模型只回傳一個選擇與對應機率。長工單超出四千零九十六 token 視窗時,最舊的留言會被丟棄。
提示詞縮短與輸出長度歸零,是 token 下降的兩個來源。原本每次呼叫平均消耗 6,554 個輸入 token 與 170 個輸出 token,改後為 2,009 個與 1 個。這裡的關鍵在於任務性質:分類不需要解釋,只需要判斷。對照前沿模型近期的定價方向,可參考 Claude Fable 5.2 的每任務成本說法。
三向切換開關如何降低上線風險?
標籤服務每處理一則訊息就讀取一次 AppConfig 的三向設定,可選舊模型、雙跑並比對、或全面改用決策模型。切回舊路徑只是一次設定變更,約四十五秒生效。
三種模式分別命名為 BEDROCK、DUAL 與 DECIDER。BEDROCK 模式下 Sonnet 標記每一張工單,決策模型不被呼叫;DUAL 模式同時呼叫兩者,Sonnet 的結果寫入工單,決策模型的判斷另存供逐筆比對;DECIDER 模式則完全由決策模型接手,不再呼叫 Bedrock。
這個設計把上線決策從事前評測搬到真實流量。工程師在雙跑期間檢視每一處分歧,判斷哪一方正確,再決定是否切換。相較於離線測試集,真實流量的分歧更能暴露邊界情況。
回滾成本同樣被壓到最低。團隊在文章中明言,回到舊路徑是一次四十五秒的設定變更,因此整個實驗沒有單向門的壓力。
成本差距有多大?
每百萬張工單由約 22,200 美元降至約 500 美元,差距約四十四倍。單次呼叫由 4,215 毫秒縮至 897 毫秒,總 token 減少七成。
官方以美東第一區的公開隨需價格計算,Sonnet 4.6 每百萬輸入 token 收 3 美元、每百萬輸出 token 收 15 美元,換算每張工單約 0.0222 美元。決策模型跑在 SageMaker 的 ml.g5.xlarge 執行個體,每小時 1.408 美元。
| 指標 | Claude Sonnet 4.6 | Strands Decider E4B | 變化 |
|---|---|---|---|
| 單次呼叫時間 | 4,215 毫秒 | 897 毫秒 | 縮短 78% |
| 每張工單輸入 token | 6,554 | 2,009 | — |
| 每張工單輸出 token | 170 | 1 | — |
| 每張工單總 token | 6,724 | 2,010 | 減少 70% |
| 每百萬張工單成本 | 約 22,200 美元 | 約 500 美元 | 降低 98% |
單一執行個體配一張 A10G 顯示卡與 24 GB 記憶體,模型佔用約 19 GiB。每次請求約 640 毫秒,換算每小時可處理約 5,600 張工單;理論滿載成本為每百萬張 250 美元,保留尖峰餘裕後實際約 500 美元。
值得注意的是,這個數字不含 Lambda 費用,但 Lambda 的執行時間同步下降 74%,因此整體帳單的減幅只會更大。團隊指出,改用決策模型後一年可節省數百萬美元的 token 支出。
哪些任務不適合用決策模型?
標籤需要附帶解釋文字、目錄每週變動、或有用上下文無法壓進數千 token 的任務都不適合。決策模型只回傳選項與分數,無法說明理由,也無法處理開放式生成。
官方把適用條件寫得很直白:任務必須是從已知目錄中做封閉選擇,呼叫量要夠大,且舊路徑的延遲確實造成困擾。三項之中缺任何一項,節省幅度就會被抵銷。
三種情境被明確列為不適合。第一是標籤本身需要解釋,例如法務或醫療場景要求模型說明歸類依據;第二是目錄頻繁變動,每週新增標籤會讓固定選項的前提失效;第三是判斷所需的上下文超過數千 token,壓縮後會丟失關鍵資訊。
對正在評估同類方案的團隊,這些邊界比節省數字更有參考價值。決策模型並非語言模型的廉價替代品,而是把一類特定任務從生成式推理中切出來處理。站內曾整理 llama.cpp v0.9.0 的量化路線,同樣屬於以較小運算量換取可接受準確度的思路。
自行部署需要注意什麼?
可先以命令列工具在本機提問,再以伺服器模式開出端點供其他服務呼叫。官方提醒 JSON 鍵順序會改變輸出機率,比較前必須固定排序。
命令列工具名為 strands-decider,安裝後可直接對模型提問。裝置參數支援 cuda、mps 與 cpu,蘋果晶片機器可改用 mlx 後端,官方量測比 MPS 快 1.4 至 1.6 倍。伺服器模式則以 /v1/systemone 端點接受狀態與題目組合。
一個容易忽略的細節出現在比對實驗中。相同內容若以不同順序排列 JSON 鍵,輸出機率最多偏移 0.19,足以改變最終標籤。團隊因此改為每次送出前排序鍵值,並建議任何把決策模型放在 API 後面的人都先檢查這一點。
視覺版本需要額外安裝,並要求 transformers 5.18 以上。開啟後請求可附帶 base64 影像,用於判斷表單欄位是否填妥一類的檢查。模型卡顯示,v1 在缺圖情況下的過度自信程度高於 v21,選擇版本時值得留意。
出處連結有哪些?
原始碼位於 strands-labs/strands-decider,權重放在 Hugging Face 的 StrandsAgents 組織,成本數據出自官方部落格。
儲存庫位於 github.com/strands-labs/strands-decider,內含評估結果、推論文件、部署指南與訓練設定。亞馬遜個案的完整量測與切換流程見 Strands 官方部落格。
模型權重可在 Hugging Face 的 StrandsAgents 組織 取得,五個 v1 版本同時鏡像於 amazon 組織。專案官網為 strandsagents.com,代理框架的文件亦在同站。
常見問題有哪些?
本文整理授權條款、硬體需求、與傳統分類器的差別、信心值解讀、視覺支援與企業採用六項疑問,並附上官方公布的適用邊界。
總結:決策模型適合哪些團隊?
適合已有封閉標籤目錄、呼叫量大且對延遲敏感的團隊。先以雙跑模式比對一週真實流量,確認分歧可控後再切換,是成本最低的導入路徑。生成式任務仍應留在語言模型。
亞馬遜個案的價值不在 98% 這個數字,而在於它把一類任務重新定義。工單分類長期被當成語言模型的工作,實際上只需要在二十個選項中挑一個,並附上一個可信度。把這部分切出來交給 2B 模型,語言模型仍可留在需要解釋與生成的環節。
三向切換開關是整個實驗中最可複製的部分。它讓上線風險從「猜對」變成「比對」,也讓回滾成本低到可以忽略。任何要替換生產環境推理路徑的團隊,都可以照搬這個結構。
邊界條件同樣值得記住。標籤需要解釋、目錄頻繁變動、上下文過長,這三種情境會讓節省幅度消失。評估時應先確認任務落在封閉選項這一側,再談成本。
