Unsloth 於 2026 年 11 月 11 日發佈桌面版 v0.1.917-beta,把 Qwen3.8-27B 的 GGUF 量化檔升級至 Dynamic V3.1。官方基準指同一檔案大小下平均準確度提升 5% 至 10%,4-bit 版本只需 16GB 至 19GB 記憶體。
Dynamic V3.1 是 Unsloth 的量化演算法預覽版,2026 年 11 月 11 日隨桌面版推出,首批套用於 Qwen3.8-27B 的 2-bit 至 6-bit 檔案。
Unsloth Dynamic V3.1 是什麼?
Dynamic V3.1 按權重層的敏感度分配位元數,而非全模型採同一精度。項目以 Python 撰寫,採 Apache 2.0 授權,GitHub 累積 79,380 顆星標。
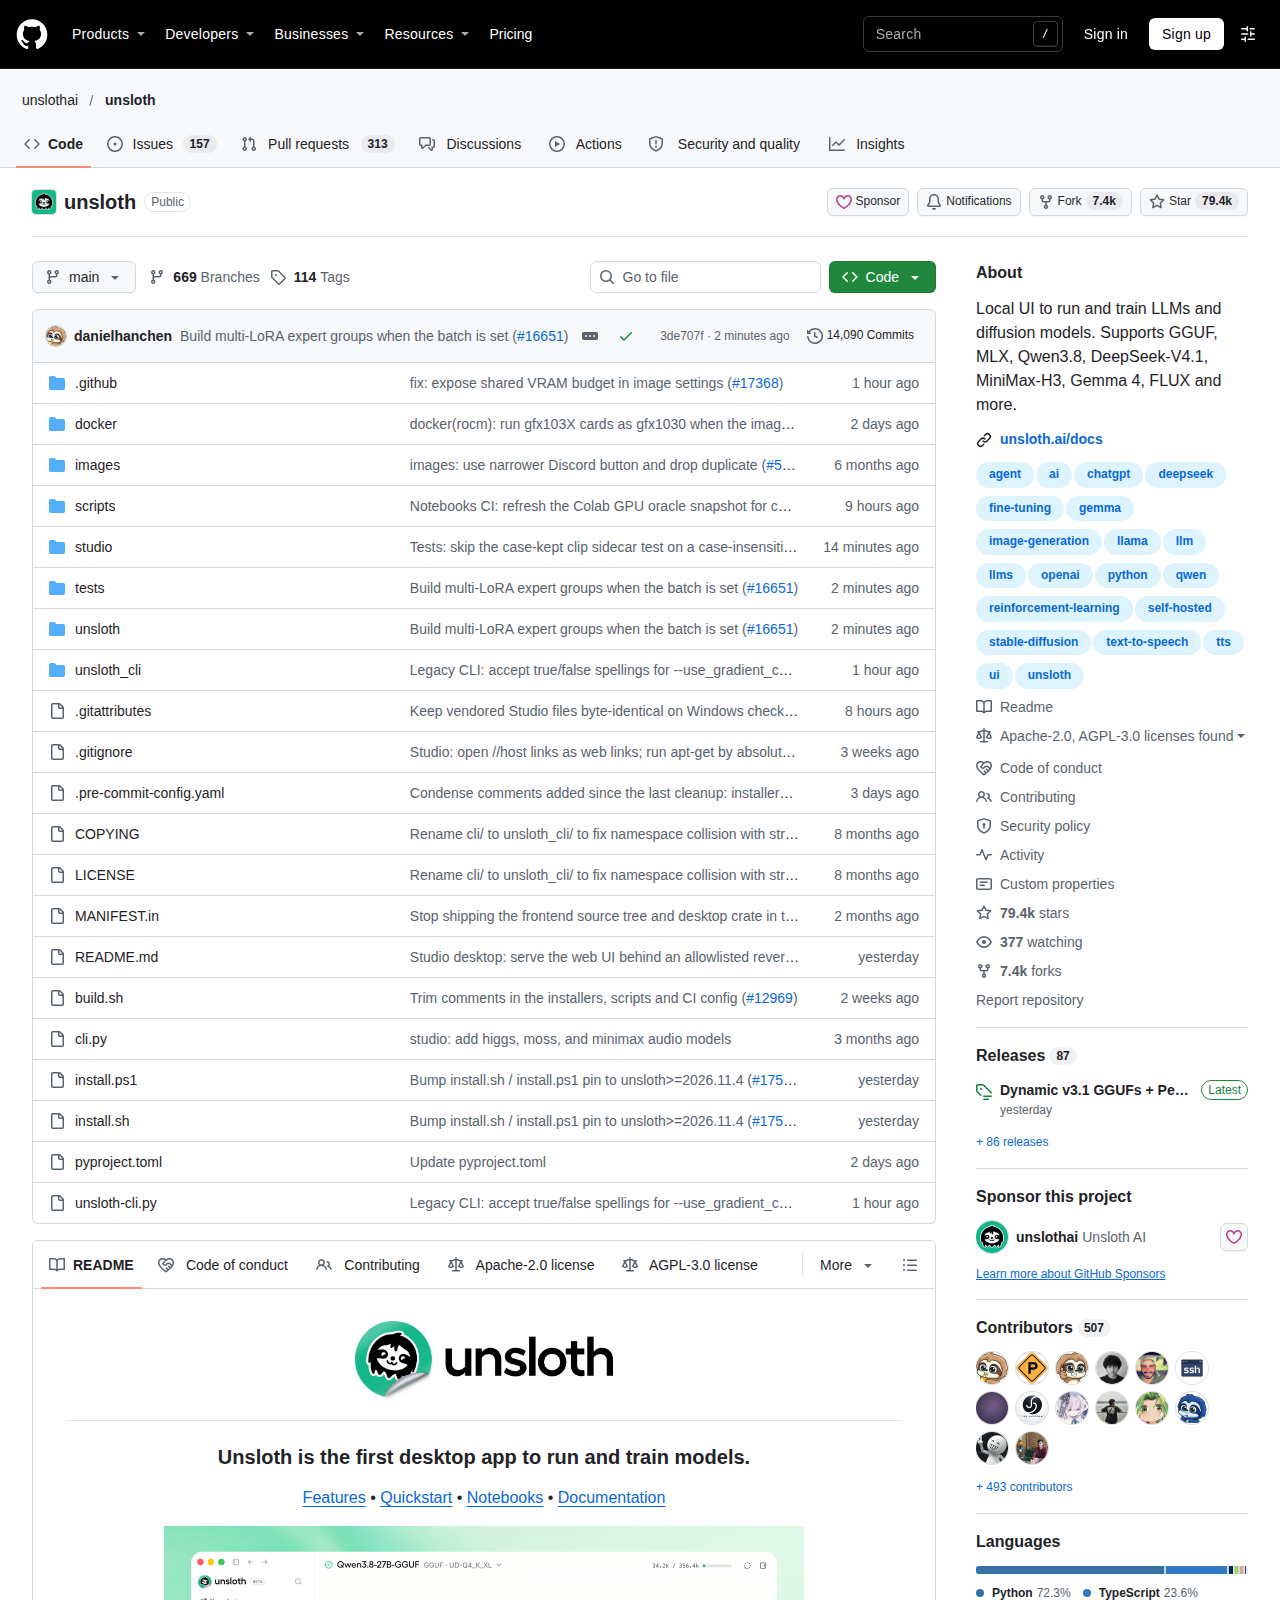
Unsloth 是一個以降低微調與推論成本為目標的開源專案,2023 年 11 月 29 日建立,目前累積 79,380 顆星標與 7,396 個分叉。它以 Python 撰寫,採 Apache 2.0 授權,提供命令列套件、網頁介面 Unsloth Studio 與桌面應用三種形態。
Dynamic 系列是該項目的量化方案。名稱中的「動態」指位元分配並非整齊劃一,而是按層的重要性浮動。V3.0 演算法此前已用於 DeepSeek-V4.1-Flash 與 Qwen3.8-Flash-Next,V3.1 屬預覽版本,先在 Qwen3.8-27B 上落地。
更新範圍有明確邊界。官方指出 2-bit 至 6-bit 的檔案大多已重新產生,但 3-bit 的 UD3 量化與 UD3.1 表現相當,因此維持原樣。團隊同時表示,更進一步的演算法版本將留待 Qwen4 及後續模型使用。
Qwen3.8-27B 的量化精度提升了多少?
官方稱同一檔案大小下平均準確度提升 5% 至 10%。代理測試採 Terminal Bench 2.1 與 DeepSWE v1.1,一般能力涵蓋 LiveCodeBench v6。
27B 是 Qwen3.8 系列中的緊湊稠密模型,具備視覺與推理能力,原生上下文長度為 256K。官方文件指出,該模型可在 17GB 記憶體或顯示記憶體的環境下運行,定位是讓中階硬件也能承擔多步代理任務。
基準測試分為兩類。代理類工作使用 Terminal Bench 2.1 與 DeepSWE v1.1,兩者皆以 256K 上下文執行;一般能力測試則包含 LiveCodeBench v6、GPQA Diamond、MMLU-Pro、AIME25 與其他通用題庫,上下文中設為 128K。
推理參數在文件中完整公開。測試採 temperature 1.0、top_p 0.95、top_k 20、min_p 0,關閉 presence 與 repetition 懲罰,並開啟 preserve_thinking 與 xhigh 推理層級。
方法論段落還交代一個細節。官方表示無法透過 temperature 為 0 的貪婪解碼重現百分之百的準確度恢復,原因是圖形處理器本身的運算並非完全確定性。文件因此建議基準測試應重複多次執行,單次結果不足以定論。
27B 模型需要多少記憶體才能運行?
官方硬體表列總記憶體需求:1-bit 需 7 至 8GB,3-bit 需 12 至 14GB,4-bit 需 16 至 19GB,6-bit 需 23 至 26GB,8-bit 需 31GB。
4-bit 是實務上最常被考慮的檔位。官方指出該級別可在 16GB 至 19GB 顯示記憶體的裝置上運行,例如 RTX 5080、RTX 4090,或配備 24GB 統一記憶體的 Mac。若計劃啟用 MTP 加速,需額外預留 1GB 至 2GB 空間。
記憶體不足時仍可執行,代價是速度。官方給出的經驗法則相當直接:隨機存取記憶體與顯示記憶體之和應接近量化檔大小,否則權重會被分頁到磁碟,生成速度明顯下降。Unsloth 會自動把部分層卸載到隨機存取記憶體,並偵測多張顯示卡的組合。
同系列的超大模型提供另一個參照。Qwen3.8-2.4T-A95B 的 BF16 版本需 4.9TB 儲存空間,經 Dynamic 1-bit 量化後降至 397GB,約減少 91%。這個級別需要至少 450GB 記憶體,已超出消費級裝置範圍。
動態量化與傳統量化有何差別?
傳統量化對所有層採同一精度,動態量化按層的敏感度分配位元數,把容量留給影響輸出最大的層。兩者檔案大小相近,動態方案的準確度通常較高。
量化本質上是一場取捨。位元數下降可換來更小的檔案與更快的載入,但誤差會累積,尤其在長鏈推理與工具呼叫時容易被放大。固定精度方案的好處是流程簡單、工具鏈成熟,弱點是對所有層一視同仁。
動態方案改變了分配邏輯。敏感層保留較多精度,冗餘層則壓得更緊,總檔案大小維持在目標範圍。這種做法需要逐層評估,量化流程因此較長,但換來的準確度可直接反映在基準分數上。
比較時有一個技術細節值得注意。官方說明,為與 Exllama-v3 對照,主要圖表的橫軸剔除了 token embedding 層,原因是 Exllama-v3 在該層使用 BF16。若按完整下載大小與實際隨機存取記憶體佔用計算,曲線會有所變化。
除 GGUF 之外,項目另推 NVFP4 路線。官方稱該格式在 24GB 顯示記憶體上比 BF16 快約 1.5 倍,並加入 FP8 KV 快取校準,令可用上下文長度延長約一倍。限制是 NVFP4 需 NVIDIA Blackwell 架構的顯示卡,例如 RTX 50 系列與 DGX Spark,目前僅在 vLLM 中支援。
Unsloth Start 如何接上編碼代理?
在終端執行 unsloth start 加代理名稱,即可把本地模型接入該代理。官方列出 Claude Code、Codex、OpenCode、Pi 等九種客戶端。
本地模型的價值取決於能否進入既有工作流。Unsloth Start 的作用正是補上這一段,把模型服務與代理客戶端之間的設定壓縮成一行指令。
unsloth start claude --model unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_XL
上例把 4-bit 動態量化的 Qwen3.8-27B 接到 Claude Code。同一模式可套用於 Codex 與其他客戶端,只需替換代理名稱。桌面版亦內建 MCP 預設,讓編碼代理直接取用本機工具。
Mac 用戶另有選擇。v0.1.917-beta 把 MLX 模型接入 Claude Code 與 Codex 的路徑整併進同一指令,並修正 MLX 模型在提示超出服務上下文時的處理方式,改為回傳明確的長度錯誤,不再給出空白回應。
桌面版 v0.1.917 還帶來哪些改動?
同版本改善長對話的串流與選單效能,FLUX.2 與 FLUX.3 影像解碼減少 36% 至 43% 顯示記憶體,並新增 HTML 與 PDF 匯出及影像生成排隊功能。
效能修正集中在長對話場景。官方稱串流輸出不再隨對話變長而劣化,背景圖與 Glass 主題同時開啟時的捲動亦更順暢,選單與對話框的開啟延遲一併降低。
影像生成方面,FLUX.2 與 FLUX.3 在解碼階段的顯示記憶體佔用減少 36% 至 43%,速度維持不變。INT8 與 FP8 影像模型現在可在較舊的 NVIDIA 顯示卡上載入,包括 T4;LTX-2.5 的 FP8 版本可在 24GB 顯示記憶體上運行。
訓練路徑亦有改善。FastModel 系列的 model.generate() 在 T4 顯示卡上預設快 2 至 8 倍,Ulysses 上下文並行擴展至 Kimi-Linear、DeepSeek、MiniMax 與 Gemma 4 等文字模型。這些改動對以舊卡執行微調的團隊較有實際意義。
項目規模與維護節奏如何?
倉庫累積 79,380 星標與 7,396 個分叉,主要語言 Python,採 Apache 2.0 授權。兩個 beta 版本相隔五日推出,節奏密集。
維護節奏偏向高頻小幅更新。兩個版本相隔五日,前者主打長對話效能與雙顯示卡影像生成,後者集中在量化演算法與界面細節。發佈檔一律標記為 beta,說明桌面應用仍在快速迭代階段。
未解議題的數量值得留意。倉庫現有 470 個未關閉議題,對於一個安裝門檻涉及顯示卡驅動與記憶體配置的專案而言,這個數字反映使用者環境的複雜度,也提示新手在首次部署時需預留排錯時間。
如何開始使用?
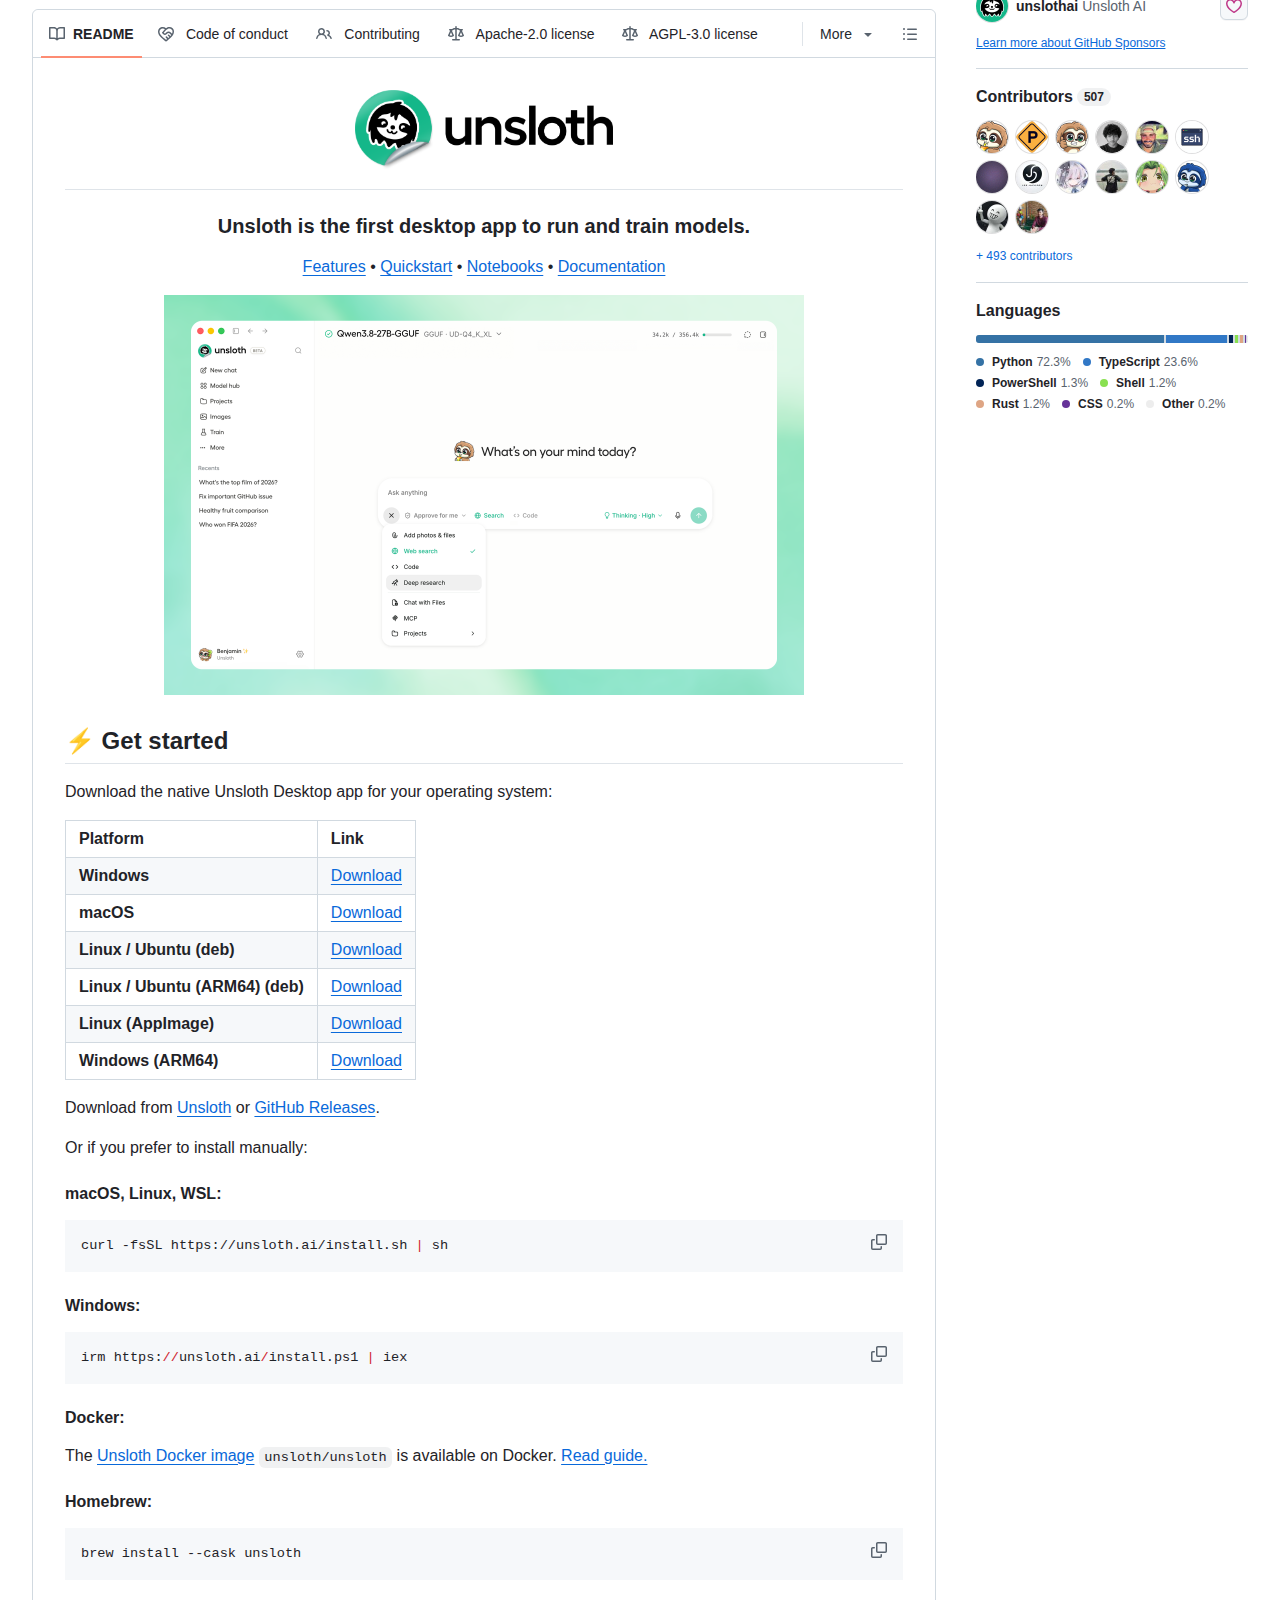
Mac、Linux 與 WSL 可執行 curl 安裝腳本,Windows 用 PowerShell,亦提供 Homebrew 與 Docker 映像。
curl -fsSL https://unsloth.ai/install.sh | sh
unsloth studio
Windows 環境改用 irm https://unsloth.ai/install.ps1 | iex。若偏好套件管理器,macOS 可用 brew install --cask unsloth,Windows 可用 winget install --id UnslothAI.Unsloth -e。
桌面應用提供 Windows、macOS、Ubuntu 與 ARM64 版本,並可透過環境變數 UNSLOTH_DESKTOP_PORT 指定本機連接埠,預設為 8888。若該埠被佔用,程式會自動往後嘗試二十個埠。
Docker 路線適合伺服器部署。官方映像為 unsloth/unsloth,AMD 顯示卡另有 unsloth/unsloth-rocm。需要對外提供服務時可加上 –secure 參數,透過 Cloudflare 取得 HTTPS 連結。官方同時提醒,伺服器端工具預設開啟,對外暴露時應設定密碼或加上 –disable-tools。
常見問題有哪些?
常見疑問集中在量化等級選擇、舊顯示卡支援、與 Ollama 共存、授權範圍、視覺能力與更新方式,以下逐項以問答形式回答,並附上官方文件對應的限制說明。
4-bit 與 8-bit 應如何取捨?
4-bit 需 16GB 至 19GB 記憶體,8-bit 需 31GB。記憶體充裕時 8-bit 的準確度較高;若要在單張消費級顯示卡上運行長上下文代理任務,4-bit 是較現實的選擇。
舊款 NVIDIA 顯示卡仍然可用嗎?
可以。官方明言 NVFP4 需要 Blackwell 架構,但 GGUF 路線對較舊的顯示卡支援較廣,T4 亦在改善名單之內。
Dynamic V3.1 是否取代 V3.0?
V3.1 屬預覽版本,先在 Qwen3.8-27B 上套用。官方表示後續更完整的演算法版本會用於 Qwen4 及之後的模型。
3-bit 為何沒有更新?
官方測試發現 UD3 與 UD3.1 的表現相當,因此維持原有檔案,避免使用者重複下載。
可以與 Ollama 共存嗎?
可以。v0.1.917-beta 加入讓 unsloth start 連接已載入的 Ollama 模型的能力。
授權是否允許商業使用?
專案採 Apache 2.0 授權,允許商業使用與修改,需保留版權聲明。個別模型權重另有授權條款,使用前應查閱對應的模型卡。
視覺能力是否需要額外設定?
Qwen3.8-27B 原生支援圖像與影片理解。桌面版提供思考模式切換,推理深度可透過 reasoning_effort 調整。
如何更新到最新量化檔?
重新下載對應的 GGUF 檔案即可。安裝腳本已固定最低套件版本,重新執行安裝指令會一併更新依賴。
這次更新適合哪些使用者?
適合以單張消費級顯示卡運行 27B 模型、又需要代理與工具呼叫能力的開發者。若硬件低於 16GB 記憶體,或只需短對話用途,改用量化程度更高的檔案或較小模型更合適。
這次更新的核心是一條算術題。硬件不變,檔案大小不變,準確度上升 5% 至 10%,對已經在 16GB 級別顯示卡上跑本地模型的團隊而言,這是可直接感受到的改善。
限制同樣明確。5% 至 10% 是官方自測的平均值,個別任務的差距可能更小或更大;代理類測試使用 256K 上下文,實際使用若縮短上下文,分數未必完全對應。
部署決策仍取決於工作型態。需要頻繁工具呼叫與長鏈推理的流程,值得投入時間調整量化等級與上下文設定;純文字問答或短篇摘要,較小的模型配合一般量化已能滿足需求。同類的本地推理與代理接入選項,可對照 llama.cpp v0.9.0 的本地推論路線 與 Qwen Code 1.0 預覽版的終端代理安排。
原始碼與文件在何處查閱?
原始碼在 GitHub 的 unslothai/unsloth,文件在 unsloth.ai/docs,量化檔案發佈於 Hugging Face 的 unsloth 組織頁面。
倉庫網址為 https://github.com/unslothai/unsloth ,內含各平台安裝方式、Unsloth Start 對照表與功能說明。量化細節與基準方法論載於 https://unsloth.ai/docs/models/qwen3.8 ,該頁提供 Markdown 版本,便於比對數據。
模型檔案位於 https://huggingface.co/unsloth/Qwen3.8-27B-GGUF ,模型卡列出量化等級、硬體需求與更新日期。桌面應用的發佈檔則集中在 https://github.com/unslothai/unsloth/releases 。
