
Unsloth 是專注於大型語言模型微調與本地執行的開源專案,在 GitHub 累積 77,513 顆星標與 7,148 次 fork,以 Apache-2.0 授權發布、主要語言為 Python,自 2023 年 11 月建立以來持續更新。該專案在 2026 年推出原生桌面應用程式,把原本偏向指令列的微調流程搬進圖形介面,讓不具備深度學習工程背景的使用者也能在自己的電腦上執行與訓練模型。
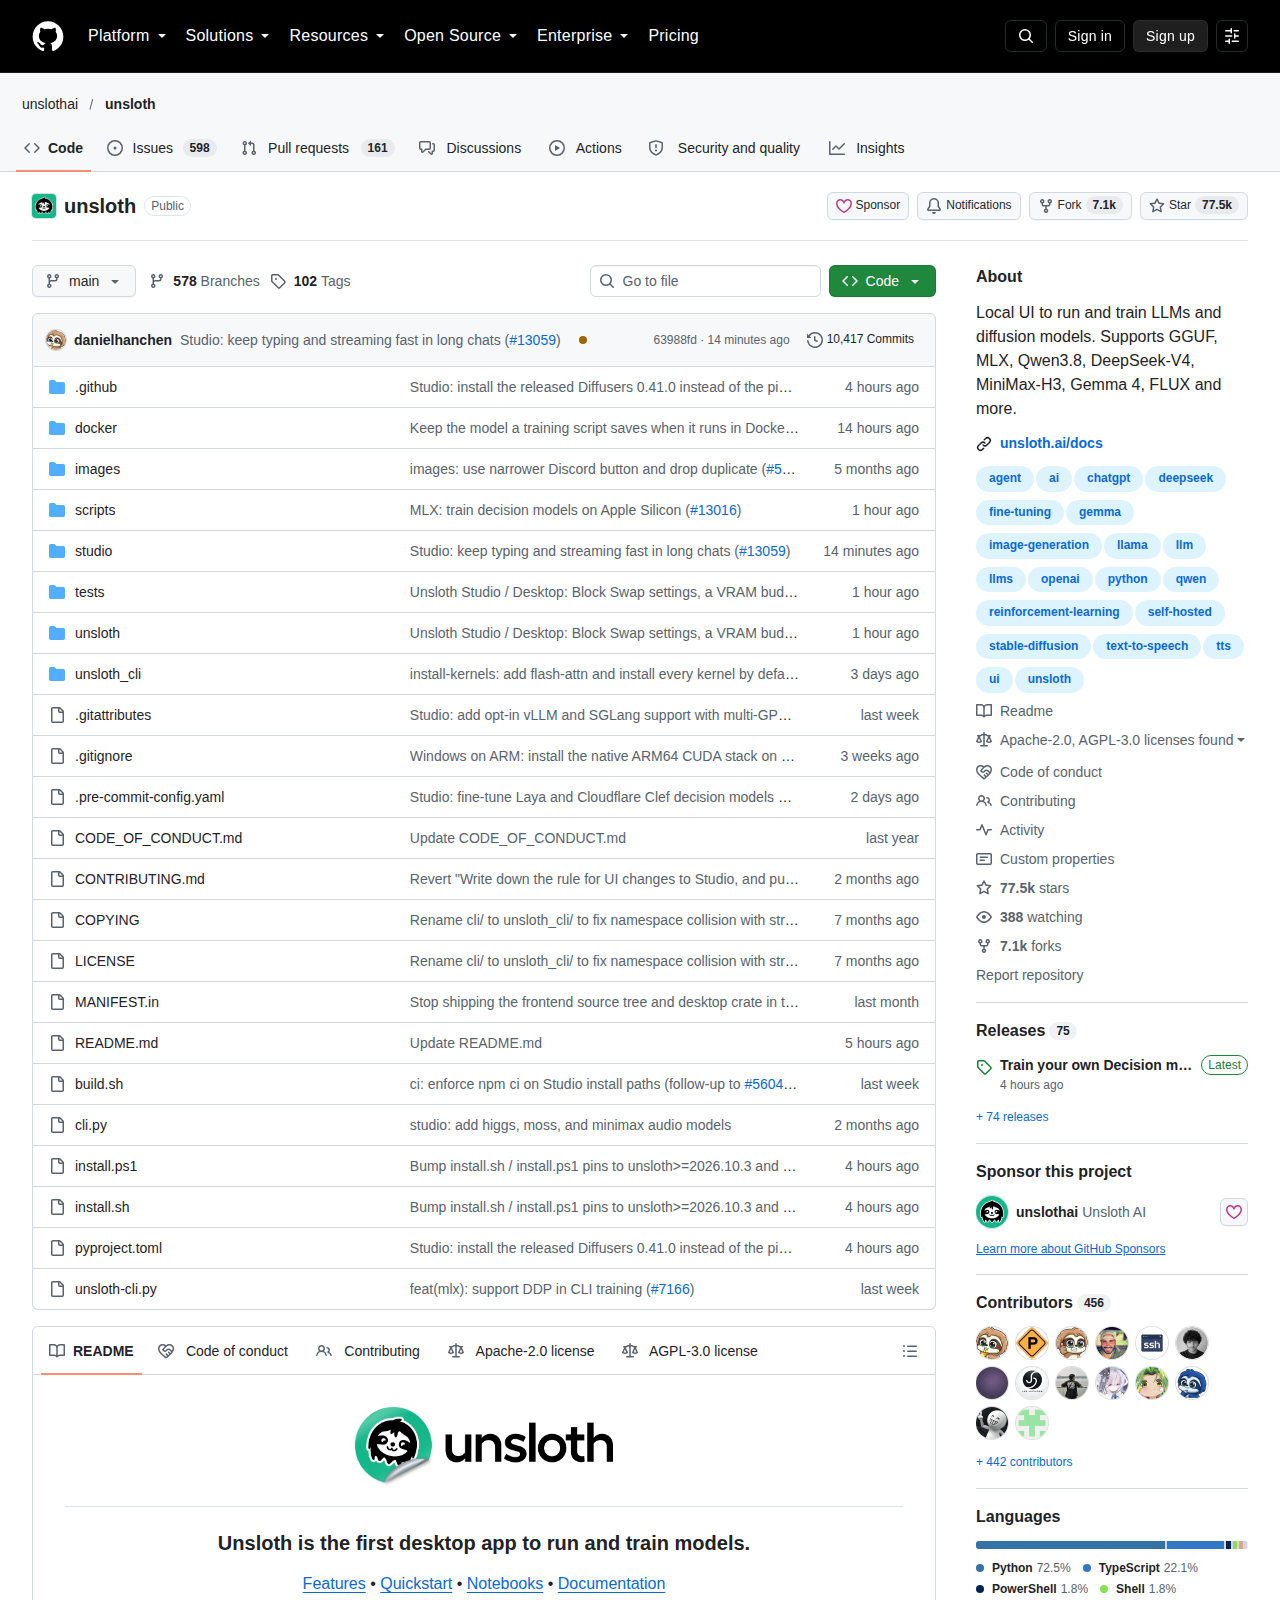
Unsloth 是一套開源的大型語言模型微調與本地執行程式,以 Apache-2.0 授權發布,在 GitHub 累積 77,513 顆星。
Unsloth 是什麼?
Unsloth 是專為大型語言模型設計的微調與推論框架,可在個人電腦、工作站與多 GPU 環境運行,並支援 Windows、Linux 與 macOS 平台。
Unsloth 的定位是一套兼具訓練與執行能力的開源工具鏈。它的核心目標是降低大型語言模型微調的硬體門檻,讓使用者在消費級顯卡甚至中央處理器上,也能完成過去需要專業算力叢集才能進行的參數調整工作。專案同時提供本地執行環境,使用者可載入量化後的模型並以對話、工具呼叫與檢索增強等方式實際運用。
在功能覆蓋上,Unsloth 已從早期的微調加速庫,擴展為包含桌面應用、網頁介面與程式化核心的完整產品線。官方說明將它分為桌面版、網頁版與程式版三種使用形態,並提供 Docker 映像、Homebrew 套件與一鍵安裝腳本。這種多形態策略讓研究者、工程師與一般使用者都能找到對應的入口。
Unsloth 有哪些核心技術亮點?
Unsloth 以優化後的訓練核心實現約 2 倍速度提升與 70% 記憶體節省,並支援 LoRA、QLoRA、全參數微調、強化學習與多種量化匯出格式。
Unsloth 最具代表性的能力是效率上的改善。官方說明指出,其訓練核心相較標準實作可達到約 2 倍速度與 70% 更低的記憶體佔用,同時維持不損失精度的承諾。這項特性對硬體資源有限的團隊格外關鍵,因為它直接決定了原本無法負擔的模型規模是否有機會在現有設備上完成訓練。
在方法支援上,Unsloth 涵蓋低秩適配、量化低秩適配、全參數微調、預訓練與強化學習等路徑,並支援群組相對策略優化與直接偏好優化等對齊技術。訓練完成後,模型可匯出為 GGUF、NVFP4 與 FP8 等格式,直接對接常見的本地推論引擎與部署流程。它同時支援 NVIDIA、AMD、Intel 顯示晶片、中央處理器與 Vulkan 後端,硬體選擇具有相當彈性。
Unsloth 桌面版帶來什麼新進展?
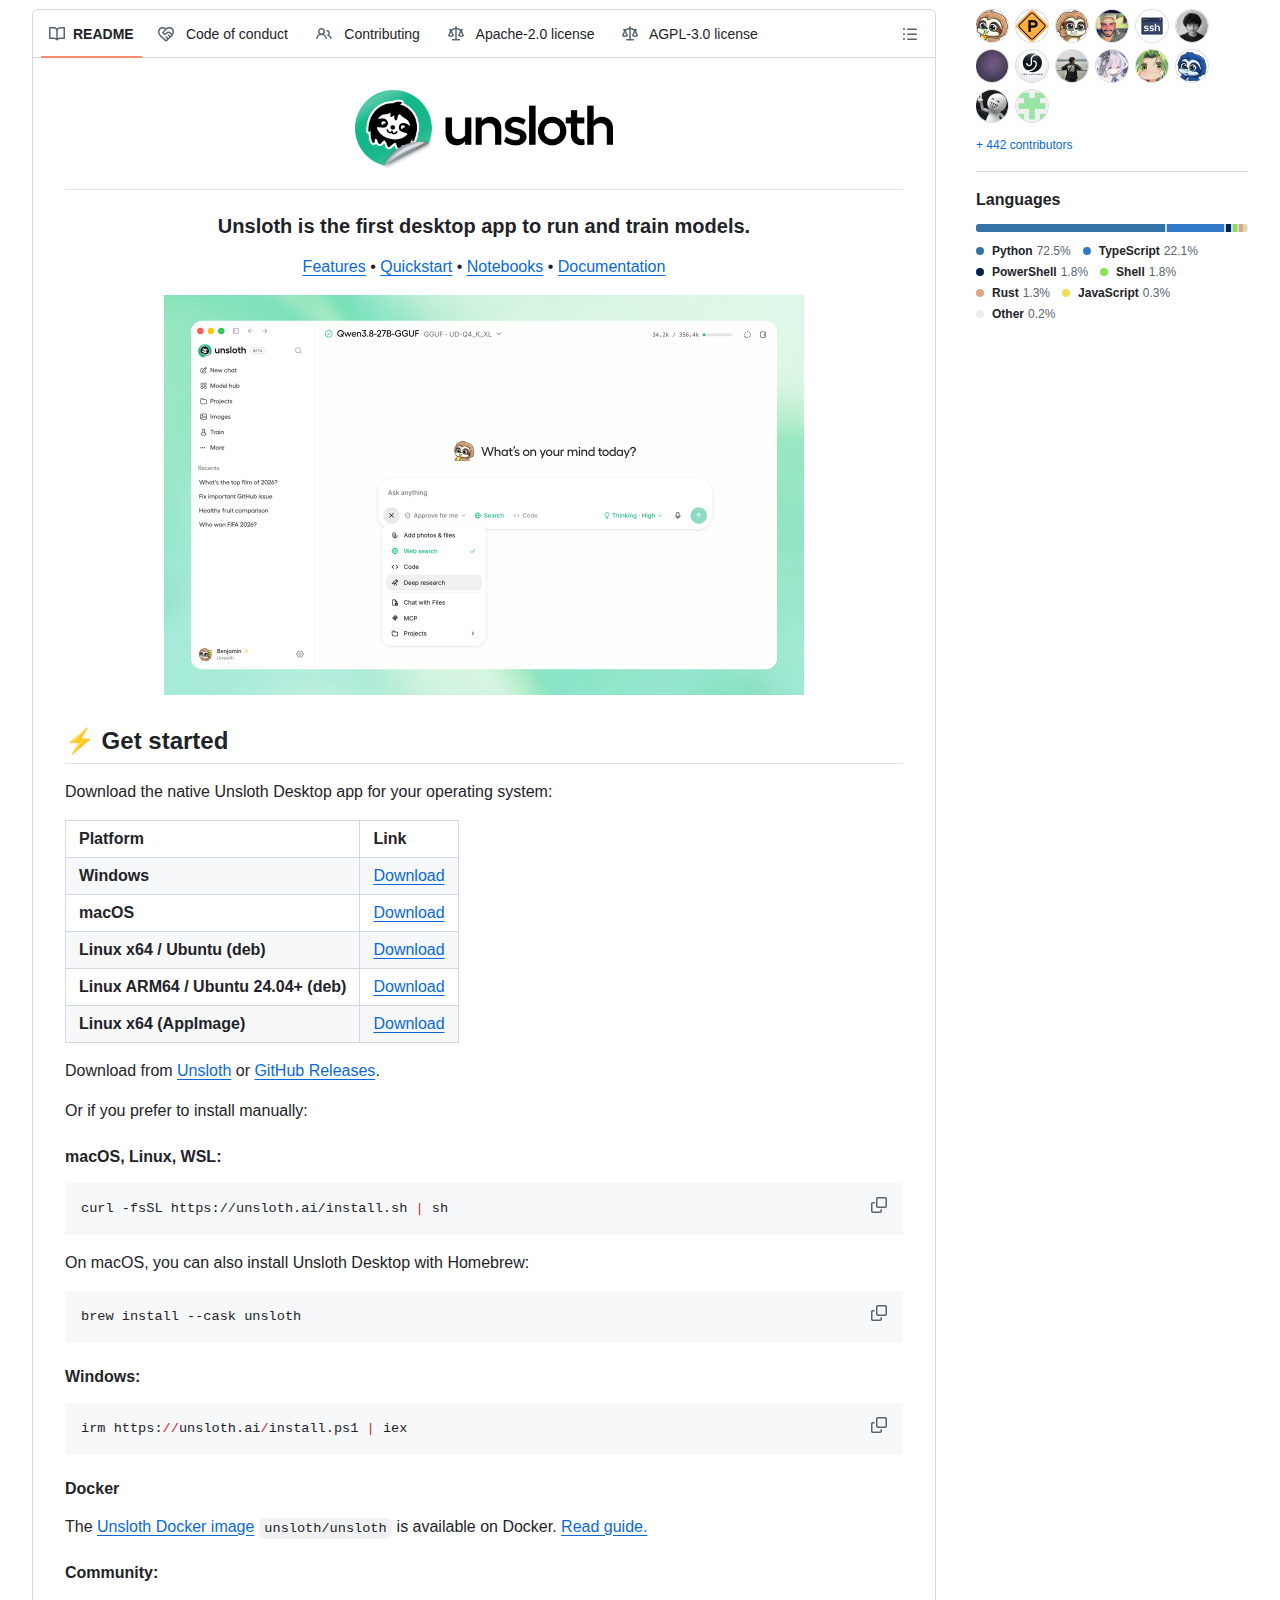
Unsloth 桌面版把模型執行與訓練整合進圖形介面,支援 Windows、macOS 與 Linux,並可一鍵連接 Claude Code 等代理工具使用本地模型。
桌面版的推出是該專案在 2026 年最重要的轉變。它把模型下載、資料集準備、訓練參數設定與匯出部署等步驟,整合進同一個應用程式中,並針對 Windows、macOS、Linux 與 ARM 架構裝置提供原生安裝檔。對於不熟悉命令列的使用者而言,這相當於把過去需要閱讀大量文件才能完成的操作,壓縮成可視化流程。
與代理工具的整合則是另一個重點。專案提供 Unsloth Start 指令,可將 Claude Code、OpenAI Codex 與其他代理程式連接至本地模型,並支援工具呼叫與程式碼執行。這意味著使用者在保留本地模型隱私與成本優勢的同時,仍可沿用主流代理生態的工作流程。最新版本亦將決策模型與語音複製等功能納入支援範圍。
Unsloth 與其他微調方案相比如何?
Unsloth 以單一高效核心同時覆蓋訓練與執行,並提供桌面、網頁與程式三種入口,在易用性與硬體相容性上具備明顯差異化。
市面上多數微調框架側重單一環節:有些專注於訓練加速,有些專攻推論部署,使用者往往需要在多套工具間轉換格式與環境。Unsloth 的差異在於把訓練與執行整合於同一專案,並以一致的模型格式與介面串接流程,減少工具鏈轉換帶來的摩擦。其跨硬體支援也讓同一套方案能覆蓋不同規格的裝置。
在易用性層面,桌面版與網頁版的加入,使它不再只是寫給工程師的函式庫。社群可透過現成筆記本在雲端環境免費試用,再決定是否轉向本地部署,這種由試用導向落地的路徑,降低了評估成本。需要注意的是,專案仍處於快速迭代階段,各項功能的成熟度與穩定性可能因版本而異。
Unsloth 支援哪些模型與應用場景?
Unsloth 支援語言、視覺、語音、嵌入與影像生成等模型類型,常見場景包括私有化部署、領域微調、代理工具本地化與資料集建構。
在模型覆蓋方面,官方文件列出對多個主流開源模型的支援,涵蓋語言、視覺、多模態、語音合成與影像生成等類別,並持續跟進社群新發布的權重。使用者可依裝置記憶體容量選擇對應的量化等級,在品質與資源之間取得平衡。這種廣泛支援讓它成為本地模型社群的常用入口之一。
實際應用場景則涵蓋企業內部知識問答、特定領域文字生成、代理程式本地化與資料集建構等。企業若對資料外流有顧慮,可將模型與訓練流程完全留在自有設備;個人開發者則可利用它把通用模型調整為符合自身需求的版本。專案亦提供從文件與試算表建構資料集的工具,讓資料準備階段的門檻進一步降低。
Unsloth 的統計數據與授權條件為何?
Unsloth 在 GitHub 累積 77,513 顆星標與 7,148 次 fork,以 Python 撰寫、採 Apache-2.0 授權,於 2023 年 11 月建立。
授權條件是評估商業採用時的重要前提。Unsloth 採用 Apache-2.0 授權,屬於寬鬆型條款,允許修改、散布與商業使用,且不要求衍生作品開源,因此對企業內部部署與商業產品整合相對友善。這與部分採用強copyleft條款的同類專案形成對比,也降低了法務審查的複雜度。
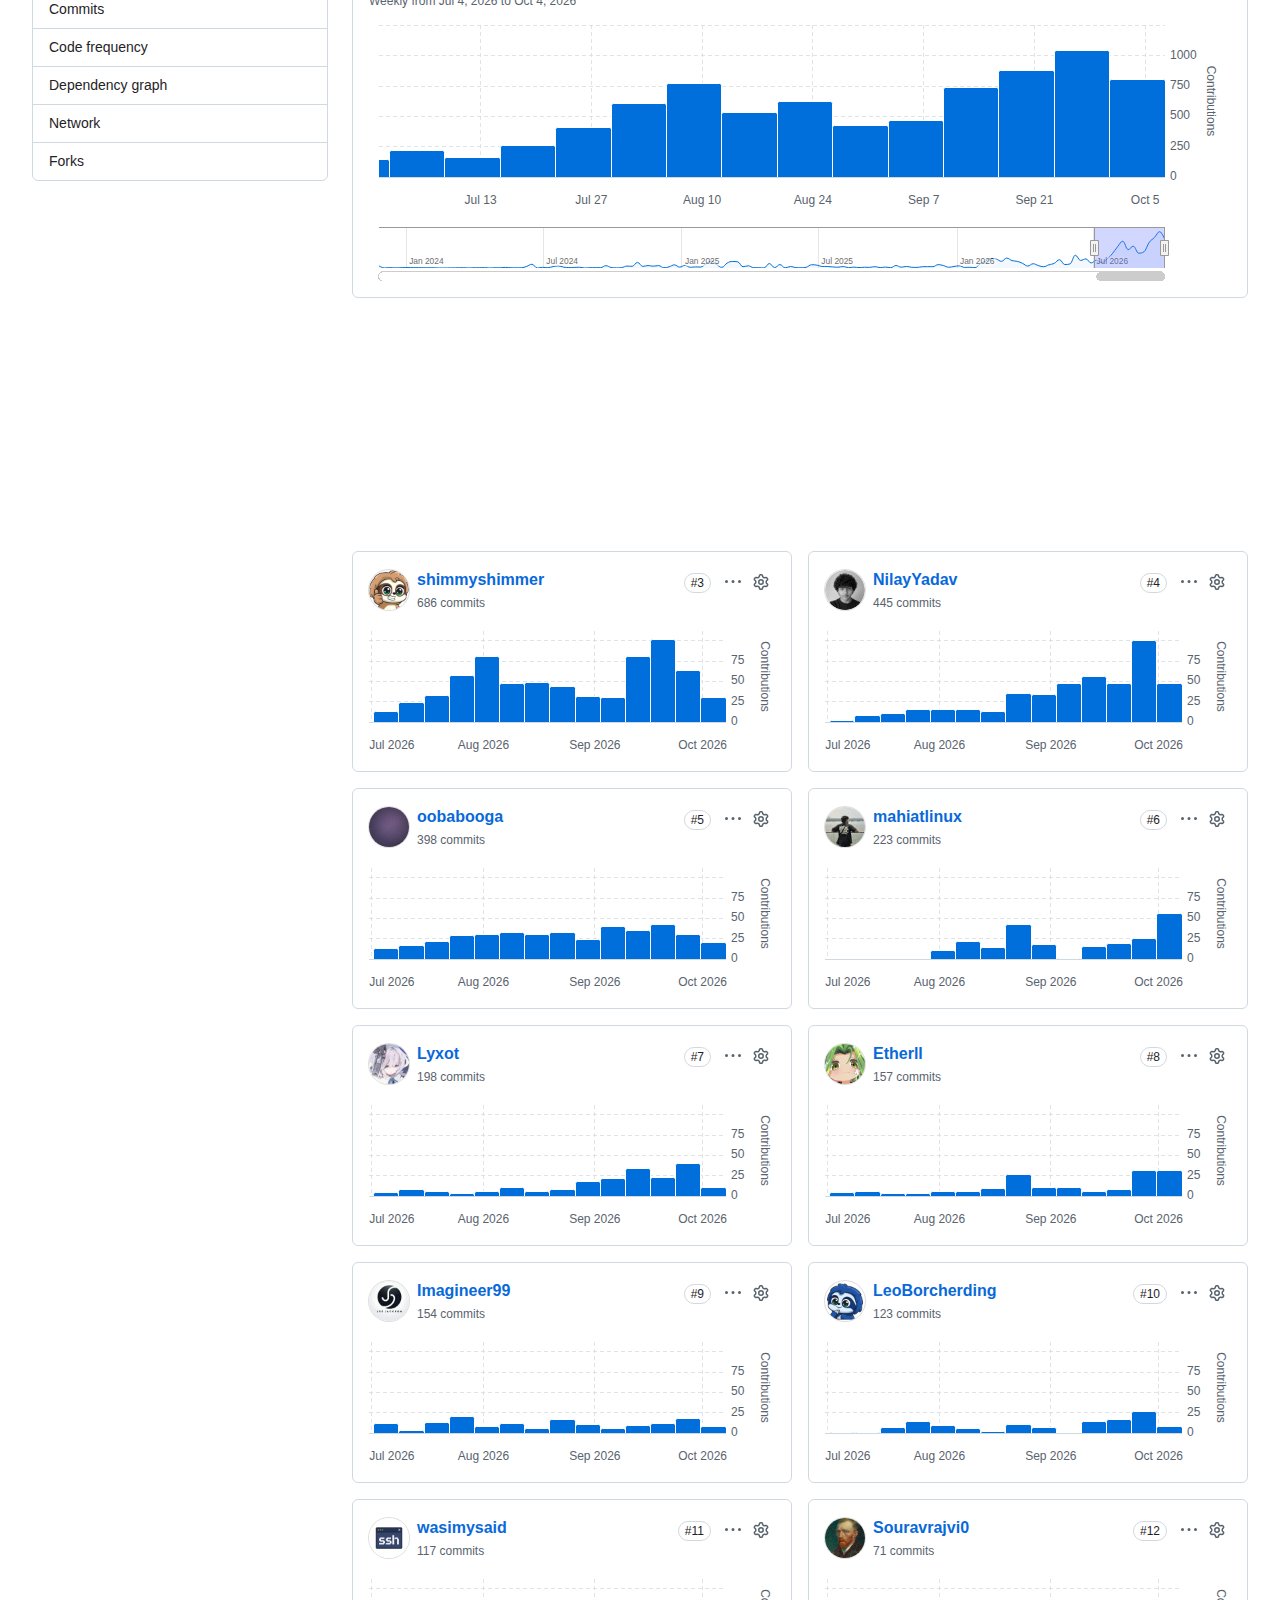
從維護節奏觀察,儲存庫在 2026 年 10 月仍持續推送更新,並保持約數日一次的版本發布頻率,顯示專案處於活躍開發階段。這種節奏對於依賴單一專案的生產環境而言,既代表功能迭代快速,也意味著版本相容性需要納入維運規劃。
出處連結有哪些?
本文資訊整理自 unslothai/unsloth 的 GitHub 儲存庫與官方文件,涵蓋專案定位、技術特性、桌面版功能與授權條款。
- GitHub 儲存庫:https://github.com/unslothai/unsloth
- 官方文件:https://unsloth.ai/docs
- 桌面版下載:https://unsloth.ai/download
- Apache-2.0 授權條款:https://github.com/unslothai/unsloth/blob/main/LICENSE
總結:Unsloth 適合什麼團隊?
Unsloth 適合希望以有限硬體完成模型微調、重視本地部署與寬鬆授權的團隊;需要長期穩定支援者,則應評估版本管理與維運成本。
Unsloth 的價值在於把大型語言模型的訓練與執行,從需要專業算力叢集的場景,壓縮到個人電腦與小型工作站可負擔的範圍。對硬體資源有限、重視資料不外流,且能接受快速迭代節奏的團隊而言,它在效率、易用性與授權條件上都提供了具吸引力的組合,桌面版的出現更讓非技術背景的使用者得以參與。
採用前仍有幾項現實考量。專案更新頻繁,生產環境需要建立版本鎖定與回滾機制;不同模型與硬體的實際表現可能與文件所述有落差,建議先以小型資料集驗證。這次桌面版的推進也反映一個趨勢,也就是本地模型工具正在從工程師導向的函式庫,轉向面向一般使用者的完整產品,而這種轉變將持續重塑開源人工智慧生態的入口競爭。