
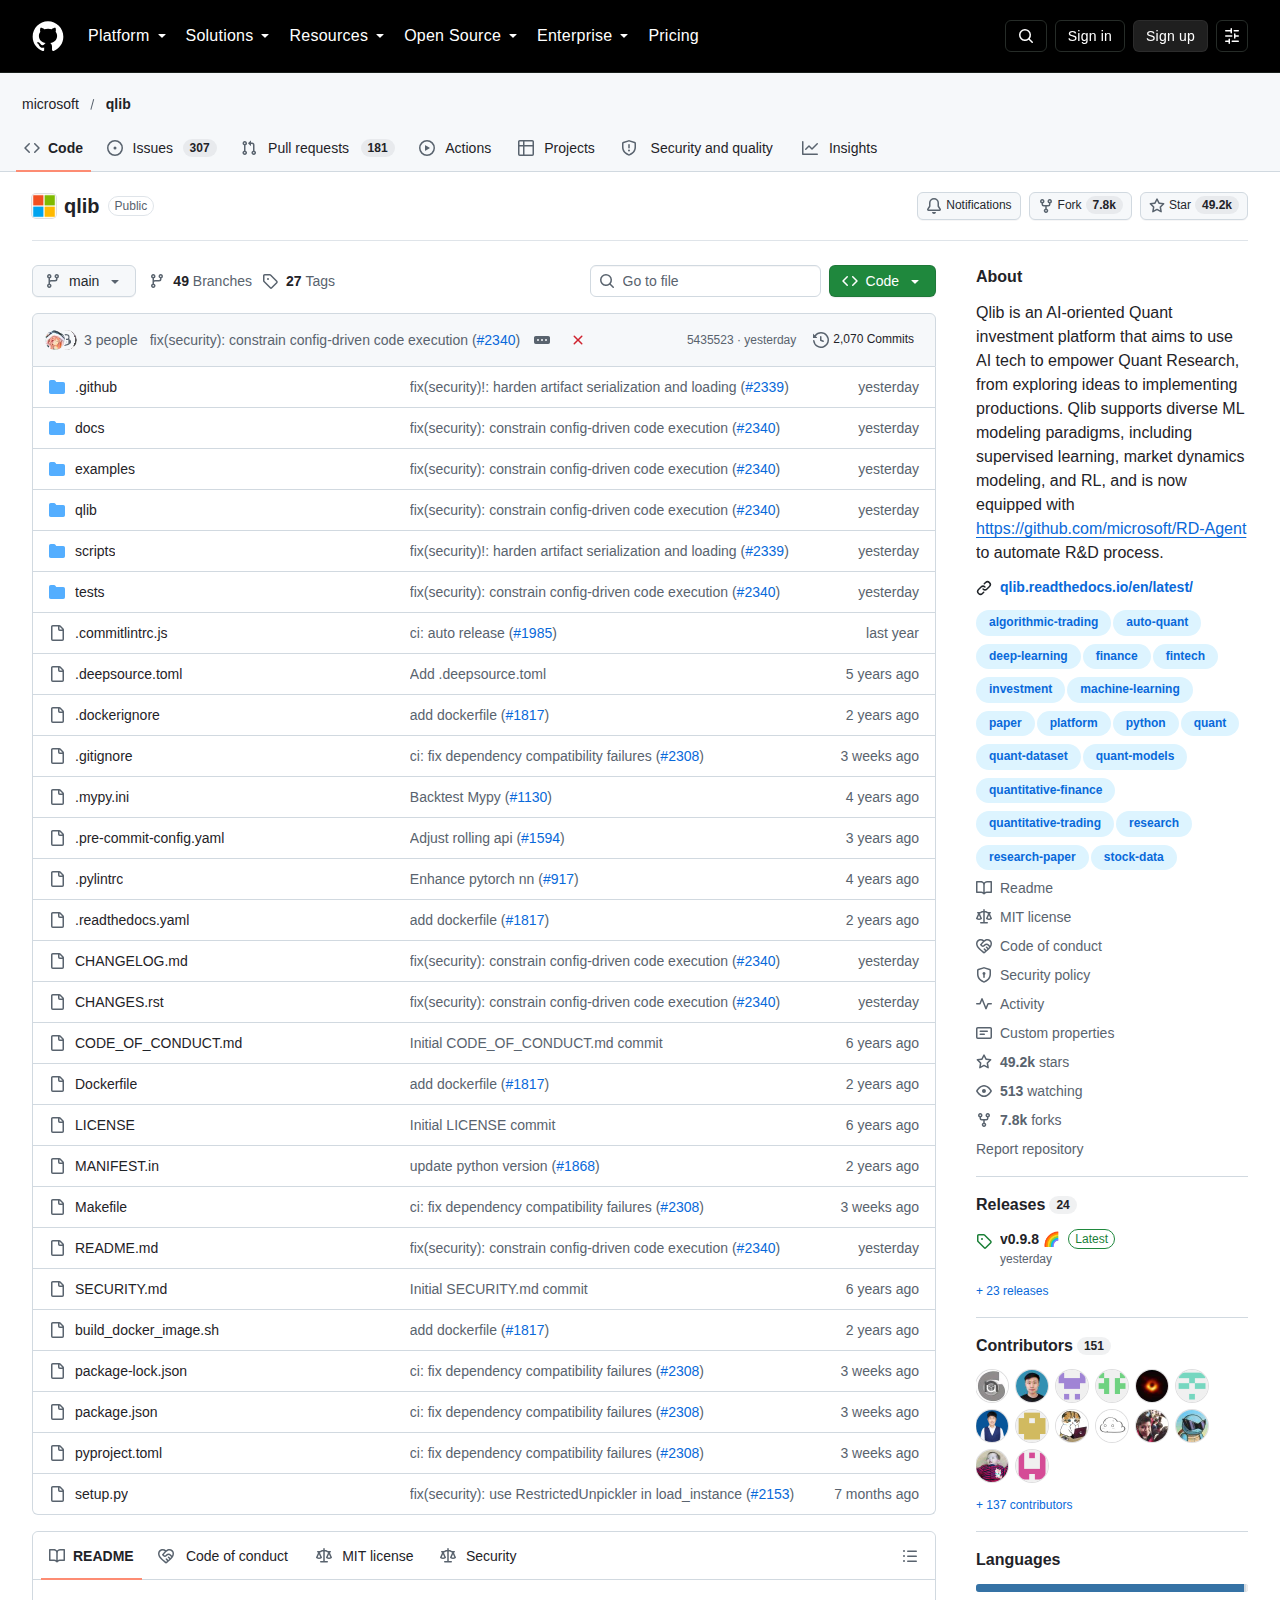
微軟開源的 Qlib 是專為 AI 量化投資設計的開源平台,在 GitHub 累積 49,237 顆星標與 7,768 次複製,以 Python 撰寫並採用 MIT 授權。此平台把資料處理、模型訓練、策略回測與線上服務整合為一條完整流水線,2026 年 10 月 8 日發布的 v0.9.8 進一步收緊了模型載入與設定檔的安全預設,反映官方在功能擴張之外,開始強化生產環境的可靠性。
微軟 Qlib 是開源的 AI 量化投資平台,累積 49,237 顆星標,整合資料處理、模型訓練、回測與線上服務,以 Python 撰寫並採 MIT 授權。
Qlib 是什麼?
Qlib 是微軟亞洲研究院主導的開源量化投資平台,成立於 2020 年,目標是把人工智慧技術導入量化研究的完整流程,從想法驗證一路支援到生產部署。
依照官方定義,Qlib 是一個以人工智慧為導向的量化投資平台,旨在運用人工智慧技術實現潛力、賦能研究並創造價值,涵蓋從探索想法到落地生產的整個流程。它支援多種機器學習建模範式,包括監督式學習、市場動態建模與強化學習,並針對量化投資特有的挑戰提供對應解法。
專案由微軟主導開發,儲存庫建立於 2020 年 8 月,主要語言為 Python,採用寬鬆的 MIT 授權,目前仍有 488 個待處理議題,程式碼在 2026 年 10 月仍維持高頻更新。它的目標受眾是量化研究員、資料科學家,以及希望以機器學習方式驗證選股與交易想法的開發團隊。
Qlib 的核心架構與模組有哪些?
Qlib 採鬆耦合模組設計,核心包含資料層、學習框架、工作流程、策略與執行、報表分析與線上服務,每個元件都能獨立使用,也可串接成自動化流程。
Qlib 的架構以鬆耦合模組為原則,各元件可以獨立使用。資料層負責金融資料的儲存、查詢與時間點對齊,解決量化研究中資料格式繁雜、時序容易錯位的問題。學習框架則同時支援監督式學習與強化學習,前者用於預測股價趨勢、挖掘有價值的訊號,後者用於為連續性的投資決策建模。
工作流程層負責把資料、模型、策略與執行串成可重複執行的流程。使用者可以用名為 qrun 的命令列工具,以一組設定檔自動完成資料集建構、模型訓練、回測與評估;也可以改用程式介面自行組裝模組,適合需要高度客製化的研究場景。策略與執行層支援多層級、多顆粒度的嵌套決策,例如把組合管理策略與下單執行策略同時優化並一起執行。最後由報表分析層輸出報酬、資訊係數與回撤等指標,並可透過線上服務模組以較低成本部署模型。
Qlib v0.9.8 更新了哪些安全性設計?
v0.9.8 依微軟要求進行安全強化,模型與資料集的載入改為受限,需明確標記為受信任才能讀取既有成品,特徵運算式改用受限解析器,設定檔載入本機程式碼亦需明確授權。
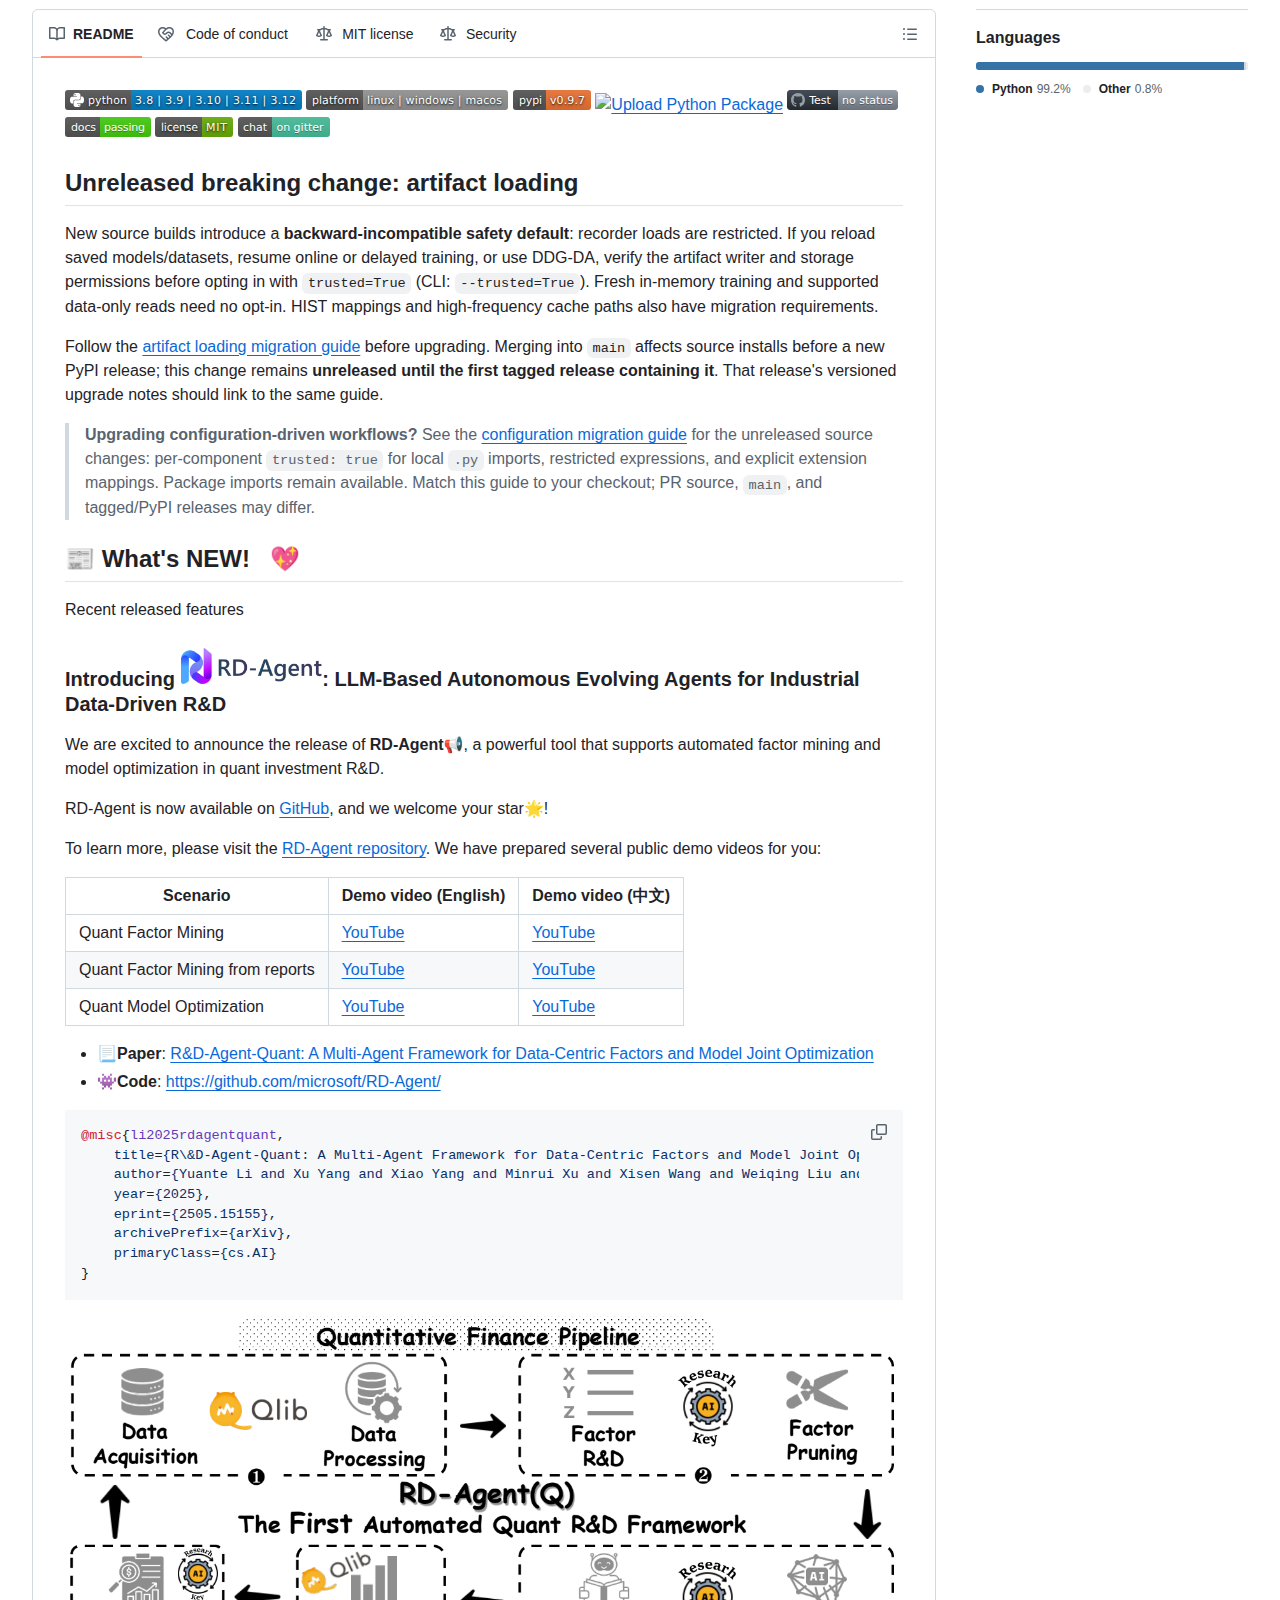
2026 年 10 月 8 日發布的 v0.9.8 是一次以安全為核心的更新。官方說明指出,此版本納入微軟要求的安全強化,包含限制可執行成品(artifact)的載入行為,純資料讀取與新的記憶體訓練不受影響,但從既有儲存位置載入模型或資料集時,現在必須明確指定為受信任來源。對於需要重新載入已儲存模型、恢復線上或延遲訓練,以及使用 DDG-DA 的使用者,升級前必須先確認寫入者與儲存權限。
其他變更同樣針對攻擊面。特徵運算式的求值改為使用受限解析器,內建的時間路由適配器骨幹與模型效能圖表名稱改用明確對應表,高頻快取路徑也被限制在設定的成品根目錄之內。此外,由設定檔驅動的本機 Python 匯入同樣需要明確的受信任標記,套件匯入與類別物件則不受影響。官方同時提供成品載入與設定的遷移指引,建議使用者在升級前先閱讀。
Qlib 支援哪些模型與資料集?
Qlib 內建二十多種論文級模型,涵蓋梯度提升樹、循環神經網路、注意力模型與集成方法,並提供 Alpha158 與 Alpha360 資料集,支援中國與美國市場。
Qlib 的模型庫以論文實作為主,收錄的基準模型超過二十種,包括以 XGBoost、LightGBM 與 CatBoost 為基礎的梯度提升方法,以 PyTorch 實作的 MLP、LSTM、GRU、ALSTM 等神經網路,以及 GATs、SFM、TFT、TabNet、Transformer、Localformer、TCN、ADARNN 等結構。集成與進階方法則包含 DoubleEnsemble、TCTS、ADD、IGMTF、HIST、KRNN 與 Sandwich,官方歡迎社群提交新模型。
在資料層面,Qlib 提供 Alpha158 與 Alpha360 兩組特徵資料集,兩者都同時支援中國與美國市場,並附有完整教學說明如何自行建構資料集。官方在基準測試頁面公布了各模型在滬深 300 成分股上的表現。以 Alpha158 資料集為例,DoubleEnsemble 的年化報酬約為百分之十一點六、資訊比率約一點三四;LightGBM 的年化報酬約百分之九、資訊比率約一點零二。官方同時提醒,這些數字僅反映完整工作流程的效能,部分模型仍有未被充分挖掘的潛力。
Qlib 與 RD-Agent 如何結合運作?
RD-Agent 是微軟以大型語言模型驅動的自動化研發代理,能與 Qlib 串接,自動挖掘量化因子並優化模型。
RD-Agent 是微軟推出的自主演化代理工具,定位為工業級資料驅動研發的自動化方案,支援量化投資研發中的因子挖掘與模型優化。它與 Qlib 的關係是上下游整合:Qlib 提供資料、模型、回測與評估的基礎設施,RD-Agent 則負責在這些基礎設施之上自動提出假設、生成因子、執行實驗並依結果迭代。
官方在其論文《R&D-Agent-Quant》中描述了這套多代理框架,如何針對以資料為中心的因子與模型進行聯合優化,並公開了因子挖掘與模型優化兩個場景的示範影片。對量化團隊而言,這種組合把研究流程中最耗時的重複性實驗環節自動化,人力可集中在假設設計與風險控管上。
Qlib 在量化投資領域的定位與影響為何?
Qlib 把量化研究常見的資料、模型與回測流程標準化並開源,降低了個人研究者與小型團隊的入門成本,但其資料多來自公開來源,仍需自行驗證品質。
在量化投資領域,長期以來的門檻並不在於單一模型的強弱,而在於能否建立一套可重複驗證的研究流水線。Qlib 的價值在於把這套流水線標準化並以開源方式釋出,讓個人研究者與小型團隊不必從零打造資料層與回測框架,即可把心力放在因子與策略設計上。
相較於以單一策略為主的開源專案,Qlib 的定位更接近研究基礎設施。它同時納入監督式學習、市場動態建模與強化學習三種範式,並支援嵌套決策框架,能描述組合管理與下單執行之間的層級關係。官方亦提醒,內建資料集部分來自公開網路來源,品質未必完美,官方建議對資料品質有要求的團隊自行準備資料,這一點是採用前必須先評估的現實限制。
使用者如何開始使用 Qlib?
使用者可用 pip 安裝 pyqlib,或從原始碼建置;完成資料準備後,以 qrun 搭配設定檔即可執行完整研究流程,也可改用程式介面自行組裝。
安裝方式分為兩種。最簡單的做法是透過 pip 安裝 pyqlib,取得最新的穩定版本;若需要測試主分支的新功能,則可從原始碼建置,建議在 conda 環境中操作並先安裝相依套件。官方表示支援 Python 3.8 至 3.12,並提供 Windows、Linux 與 macOS 的安裝說明。官方亦提供現成的容器映像,方便在隔離環境中快速試用。
資料準備是使用的關鍵前提。官方說明指出,由於資料安全政策收緊,官方資料集暫時停用,使用者可改用社群維護的資料來源下載。取得資料後,透過命令列工具指定目標目錄與市場區域即可完成初始化;若只想在歷史資料上測試模型,則不需要設定每日自動更新。完成準備後,以 qrun 搭配官方提供的 LightGBM 設定檔即可執行第一個完整工作流程,官方示範的結果顯示,未計成本的年化報酬約百分之十七點八、資訊比率約二點零,最大回撤約百分之八點二。
Qlib 有哪些限制與注意事項?
Qlib 的官方資料集暫時停用,內建資料來自公開來源且品質不一;v0.9.8 起載入既有模型需明確授權,升級前須依遷移指引調整設定。
首先是資料來源的限制。官方資料集目前暫時停用,使用者需依賴社群維護的資料。官方也提醒,這些資料蒐集自公開的財經網站,未必完整或準確,若研究結論對資料品質敏感,應自行準備資料並以官方提供的工具轉換格式。
其次是升級的相容性。v0.9.8 把成品載入、特徵運算式求值與設定檔載入本機程式碼等行為改為預設受限,屬於向後不相容的變更。仍在重新載入既有模型、恢復延遲訓練或使用特定模型的團隊,在升級前必須先閱讀官方遷移指引並調整設定,否則可能在流程中途失敗。
最後是回測結果的判讀。官方明確指出,基準測試表中的數字反映的是整套工作流程的表現,而非單一模型的極限,且部分模型由於官方資源有限而未經充分調校。任何以此為起點的策略,都應在自有資料與風控框架下重新驗證。
出處連結有哪些?
本文資訊來源為微軟 Qlib 的 GitHub 儲存庫、官方 README 與 v0.9.8 版本說明,內容涵蓋架構、模型清單、資料集與安全性更新。
- 49,237GitHub 星標
- 7,768複製次數
- 513關注人數
- Python主要語言
- MIT授權條款
- v0.9.8最新版本
- GitHub 儲存庫:https://github.com/microsoft/qlib
- 官方文件:https://qlib.readthedocs.io/en/latest/
- 基準測試結果:https://github.com/microsoft/qlib/tree/main/examples/benchmarks
- RD-Agent 專案:https://github.com/microsoft/RD-Agent
常見問題有哪些?
常見疑問集中在授權與費用、資料來源、是否需要圖形處理器,以及能否直接用於實盤交易;Qlib 為開源研究平台,實務應用仍需自行驗證與風控。
Qlib 需要付費嗎?
不需要。專案以 MIT 授權釋出,程式碼與文件皆可自由使用,也可用於商業專案,只需保留授權聲明。
沒有量化背景可以上手嗎?
可以入門,但需具備基本的 Python 與機器學習概念。官方提供教學筆記本與基準範例,適合依範例逐步熟悉流程。
官方資料集為何下載不到?
官方說明指出,因資料安全政策收緊,官方資料集暫時停用,使用者可改用社群維護的資料來源,官方表示未來會恢復提供。
需要圖形處理器才能執行嗎?
不一定。LightGBM、XGBoost 等樹狀模型可在中央處理器上執行,深度學習模型則建議搭配圖形處理器以縮短訓練時間。
Qlib 可以直接用來實盤交易嗎?
不建議直接使用。它定位為研究與回測平台,實盤仍需自行處理下單介接、風控與資金管理,並以自有資料重新驗證策略。
升級到 v0.9.8 會不會破壞原有流程?
可能會有影響。載入既有模型與設定檔驅動的本機程式碼匯入改為預設受限,需依官方遷移指引明確授權後才能運作。
Qlib 支援哪些市場的資料?
官方資料集涵蓋中國 A 股與美國市場,基準測試以滬深 300 成分股為主。其他市場需自行準備資料並以官方工具轉換格式。
可以只用其中一部分模組嗎?
可以。Qlib 的元件採鬆耦合設計,資料層、學習框架與回測模組皆可獨立使用,不強制採用整套流程。
總結:Qlib 適合什麼樣的團隊?
Qlib 適合想以機器學習驗證量化想法、又不想自行搭建全套基礎設施的研究者與小型團隊;若需生產級實盤系統,仍要補上資料治理與風控。
Qlib 的價值在於把量化研究中反覆出現的資料處理、模型訓練、回測與評估流程,收斂成一套可重複執行的開源基礎設施,並附上二十多種論文級模型與兩套特徵資料集。四萬九千顆星標與七千多次複製,反映它在研究社群中已具備一定的信任度。v0.9.8 以安全強化為主的更新,也顯示專案開始正視生產環境的風險。
對個人研究者與小型團隊而言,Qlib 最大的意義是省下打造研究流水線的時間,並能以官方基準作為比對起點。需要留意的是,官方資料集暫時停用、內建資料品質不一,且新版本帶來向後不相容的變更。將它視為研究與實驗的平台,而非現成的實盤系統,會是比較務實的期待。