vLLM 於 2026 年 11 月 2 日發布 0.33.0,這個累積 96,935 顆星標的推理引擎在單一版本內收進 927 個提交與 389 位貢獻者,並把推測解碼的草稿槽位限制取消,DeepSeek-V4.1-Flash 搭配 DSpark 在 GB300 上由每秒 1373 個輸出 token 升至 3390 個。
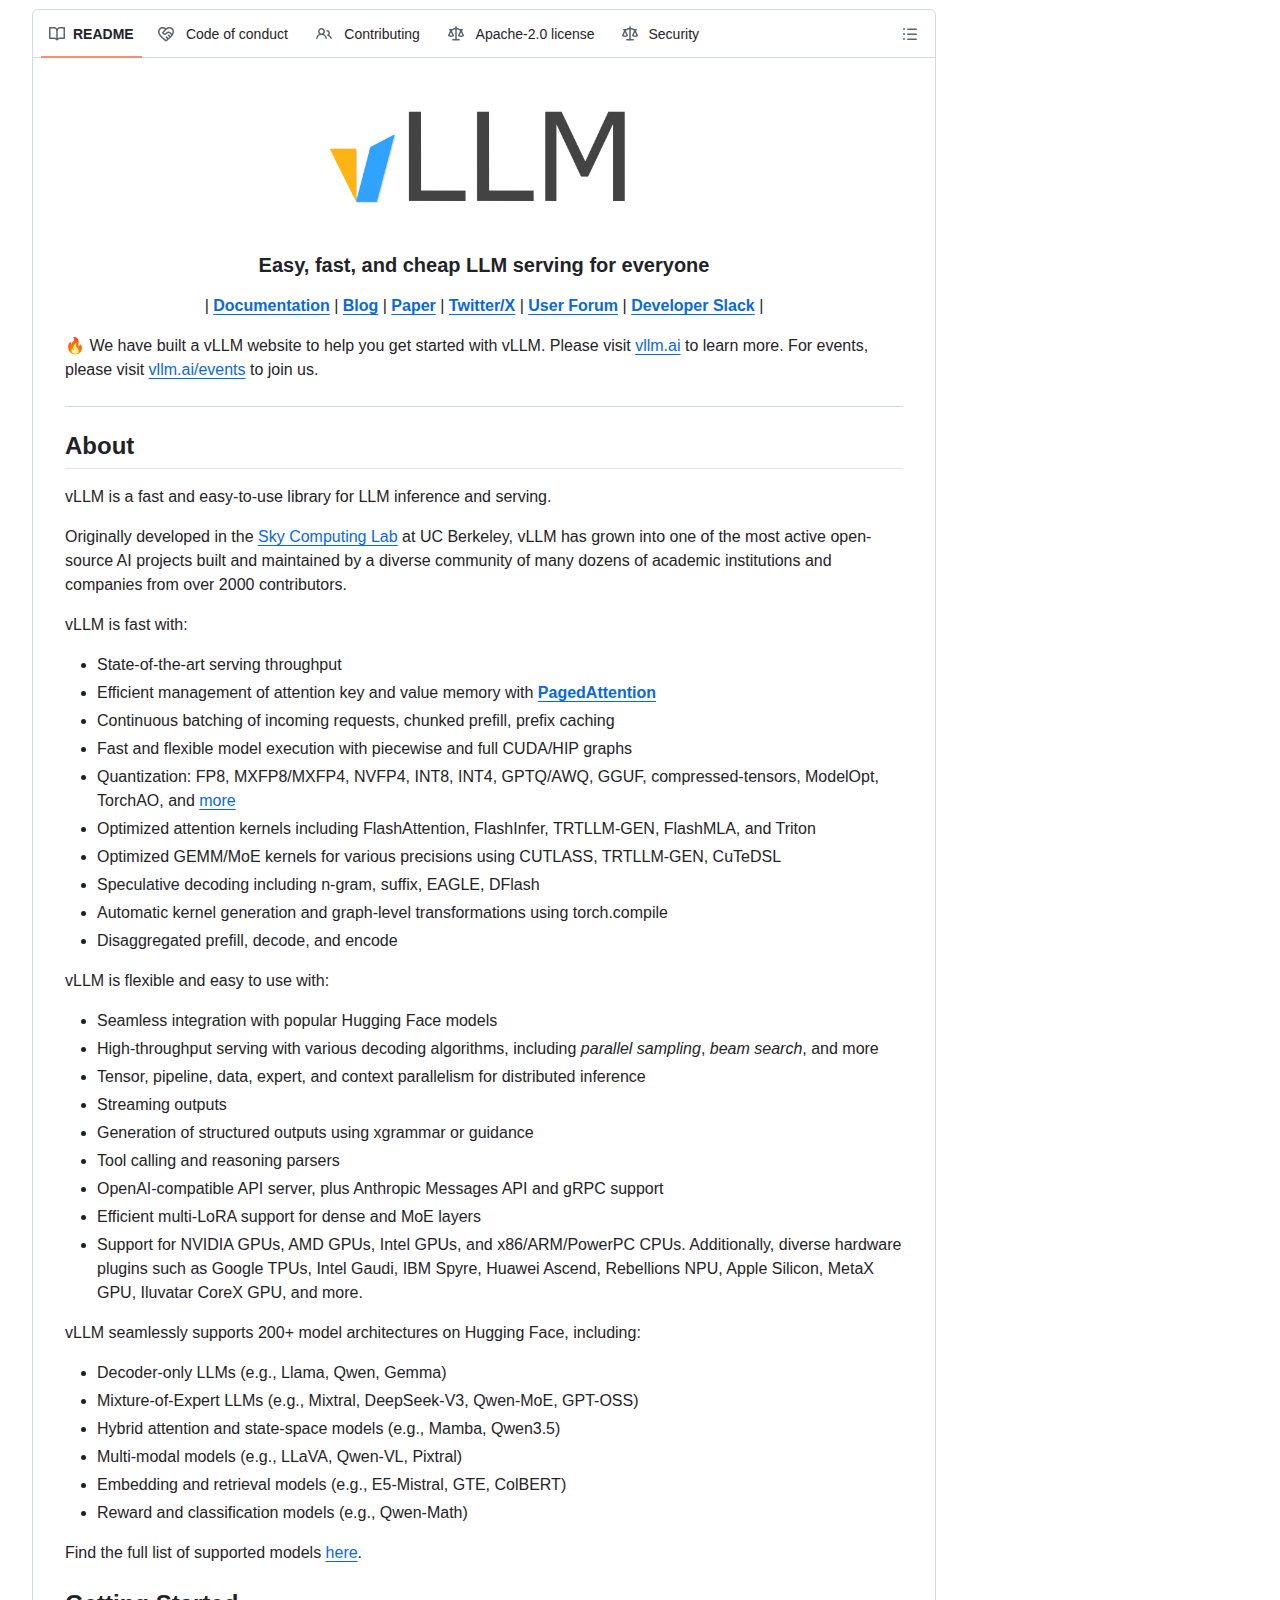
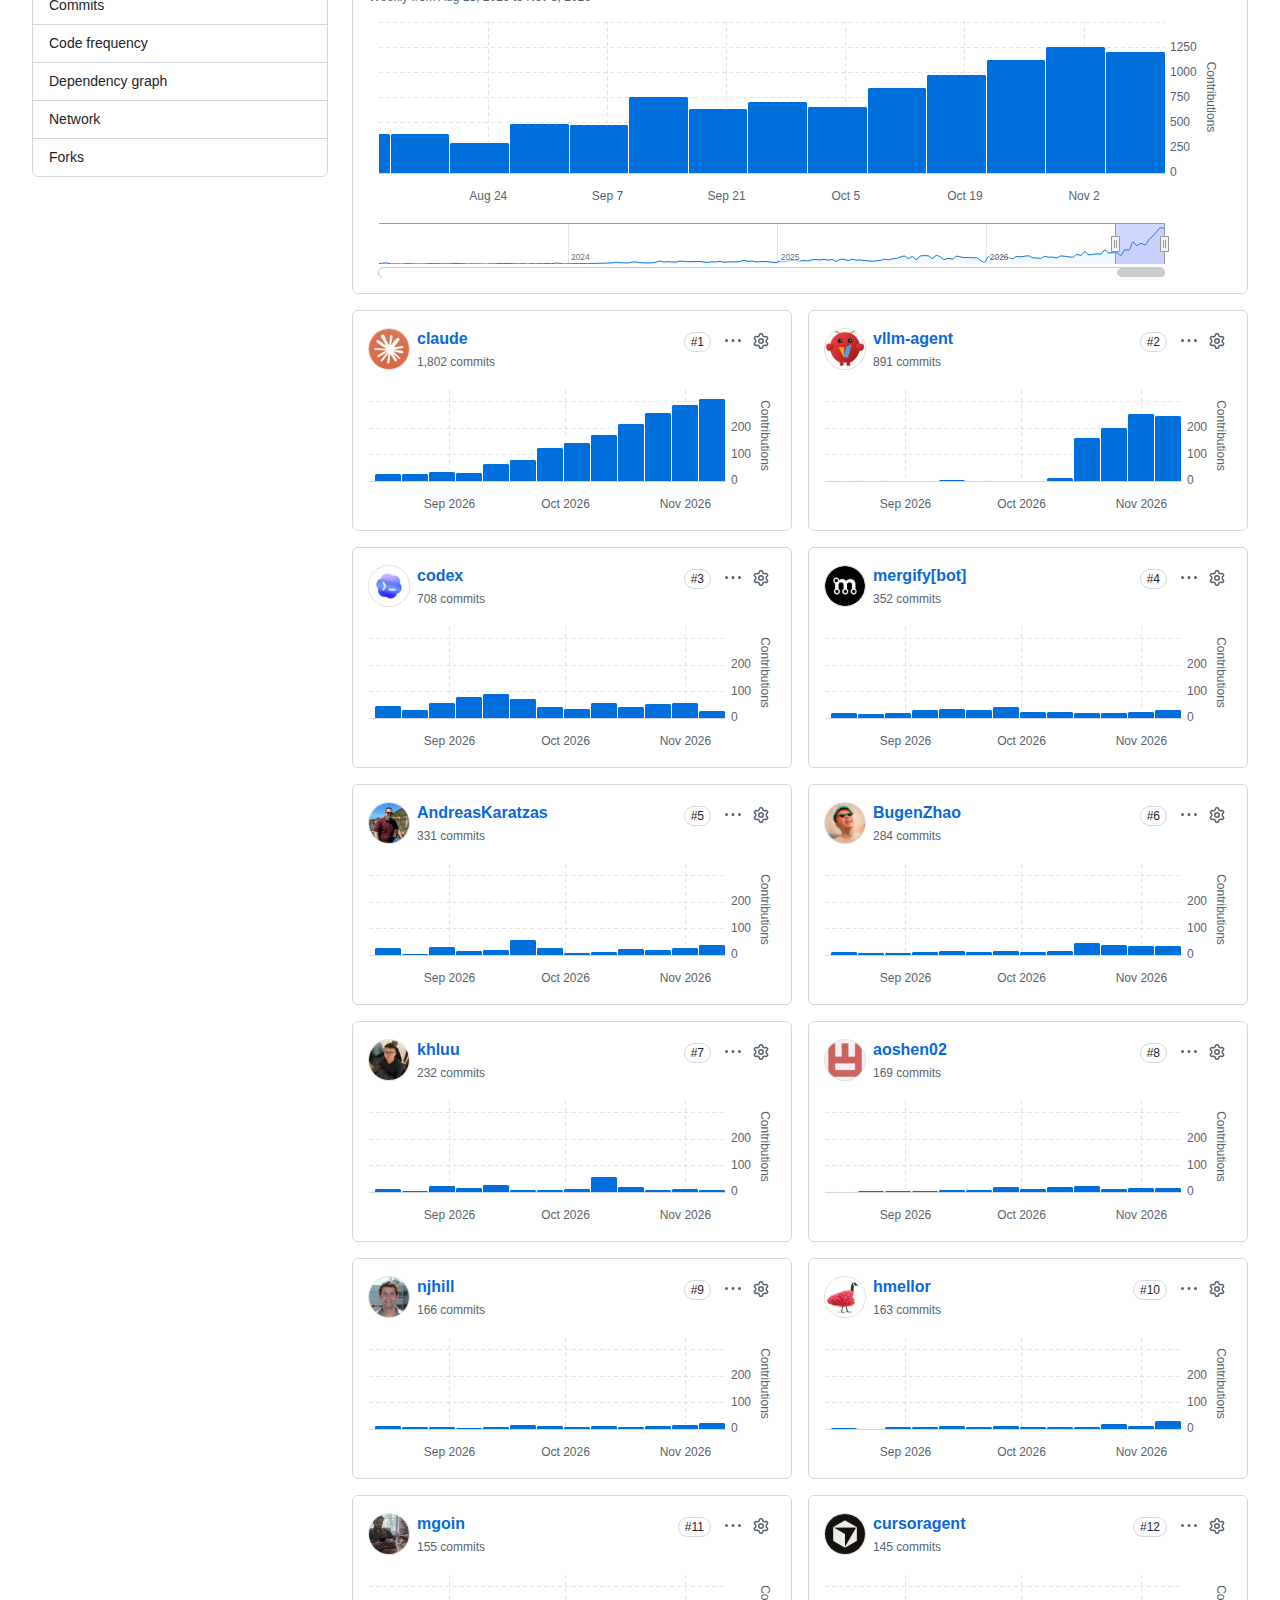
這個專案自 2023 年 2 月建立以來,已成為開源推理領域的基礎設施之一,目前支援超過 200 種模型架構。版本節奏維持在約兩周一次,由 8 月 26 日的 0.28 到 11 月 2 日的 0.33,五個版本之間相隔不足七十日。
vLLM 0.33 是什麼?
vLLM 0.33.0 於 2026 年 11 月 2 日發布,是 Apache 2.0 授權的開源推理與服務引擎,本版包含 927 個提交,重點在推測解碼、ROCm 支援與基礎環境升級。
專案最初由加州大學柏克萊分校的 Sky Computing Lab 發起,現由超過 2000 位貢獻者與數十間機構共同維護。它的核心價值在於把注意力鍵值記憶體切成固定大小的區塊管理,令批次內請求可以非同步加入與結束。
0.33.0 的變更橫跨四個層面。模型層新增十餘款架構,引擎層重寫推測解碼的驗證流程,硬件層把 AMD 的預設映像推上 ROCm 10.0,發行層則把 CUDA 12.9 版本全面下架。這種同時改動多層的節奏,令升級評估無法只看單一功能的效能數字。
v0.33 新增了哪些模型支援?
本版新增 Reflection Beam、Recursive Flint、Muse Spark、Step-5 Preview 與 MiniCPM-OCR 等十餘款模型。
最受注目的是 Reflection Beam-1.0,這是一款 5010 億參數的混合專家模型,每次推論只啟用 230 億參數,並附帶名為 DFlash2 的草稿模型。vLLM 對它做到當日支援,同時提供融合的 Blackwell 核心與對應的推理、工具解析器。
另一款值得留意的是 Yandex 的 AliceAI-Foundation-80B-A3B,它結合線性注意力與 512 個專家的混合架構,上下文長度達 26.2 萬個 token。小模型方面則有 Nemotron-Labs 的 Dory1.0-4B 與 MiniCPM-OCR 1.0,後者針對文件辨識場景設計。
推測解碼在今次版本有什麼突破?
推測解碼取消草稿槽位預留,DeepSeek-V4.1-Flash 搭配 DSpark 於 GB300 由每秒 1373 升至 3390 個輸出 token。
推測解碼的運作方式是先由小模型草擬數個候選 token,再交由主模型批次驗證。舊實作會在 token 預算內為草稿保留固定槽位,當草稿命中率不穩定時,這部分預算就被浪費。
推論引擎的競爭同時發生在本地與伺服器兩端。llama.cpp 1.0 把介面凍結、專攻單機效率,而 vLLM 這類專案則以並發吞吐為主要指標,兩者的優化目標並不相同。
0.33 取消這項預留,改為按實際需要分配,官方在 GB300 上量到 DeepSeek-V4.1-Flash 搭配 DSpark 的輸出吞吐由每秒 1373 個 token 升到 3390 個。同一版本還加入 XPress 修正器處理區塊擴散式草稿模型,並提供可選的 FLy 有損驗證策略,在 MI355X 與 B300 上錄得 1.04 至 1.31 倍的解碼加速。
草稿模型的輸出層亦可量化,官方稱在併發度為 1 時帶來 18% 的解碼提升。EAGLE 與多 token 預測的窺視區塊雜湊改為預設開啟,令前綴快取命中時可保留最後一個區塊。
硬件支援有什麼變化?
AMD 預設映像升至 ROCm 10.0,MonoKernel 解碼在 MI300X 錄得 2.32 倍互動性;NVIDIA 新增 GB300 延遲特化解碼。
AMD 路線的變化最徹底。預設映像改為 ROCm 10.0,7.2 版仍以 -rocm72 標籤保留,MonoKernel 解碼透過 --monokernel 開啟,在 MI300X 與 MI325X 上對 DeepSeek-V4.1-Flash 量到 2.32 倍的 P50 互動性提升。
記憶體方面新增 ROCM_OCTAVE 的三至四位元鍵值快取,官方在 RX 7900 XTX 上量到相當於 fp16 的 4.6 倍快取 token 容量。NVIDIA 路線則為 Kimi-K3 與 DeepSeek-V4.1-Flash 加入 GB300 延遲特化解碼,在 TP8 與 TP16 組合下錄得 1.5 至 2 倍加速。
英特爾與 CPU 路線亦有更新,SYCL 後端把 GDN 預填與前綴快取納入支援,CPU 映像則換上 zentorch 2.14,並在啟動時完成 Triton 預熱,省去首次請求的編譯等待。
升級到 v0.33 有哪些破壞性變更?
Medusa 與 MLP 推測器被移除,舊版 Ray 執行器下架,CUDA 12.9 發行檔停發,多項參數進入棄用期。
推測解碼的舊路線影響最大。Medusa 與 MLP 推測器已被刪除,仍在設定檔引用相關參數的部署會直接啟動失敗。Ray 路線亦只剩 RayExecutorV2,環境變數 VLLM_USE_RAY_V2_EXECUTOR_BACKEND 不再有效。
基礎環境的門檻同步提高。發行輪子與映像只提供 CUDA 13.0,-cu129 系列標籤停止發布,NIXL 連接器要求 1.5 或以上版本。結構化輸出方面,LM Format Enforcer 後端會在 0.34 轉為需明確開啟、0.35 移除,--ir-op-priority 亦預告於 0.34 刪除。
行為層亦有幾處細節改動。生成暫停期間送出的請求改為回傳 HTTP 503,而非排隊等待;beam search 的分數改以生成長度正規化;LoRA 套用在未支援的模型上會在驗證階段直接報錯。
實際部署時應注意什麼?
升級前應先檢查是否引用 Medusa、MLP 推測器或舊 Ray 執行器,並確認驅動與 CUDA 版本符合 13.0;NIXL 與自訂核心需同步升級,否則啟動階段就會失敗。
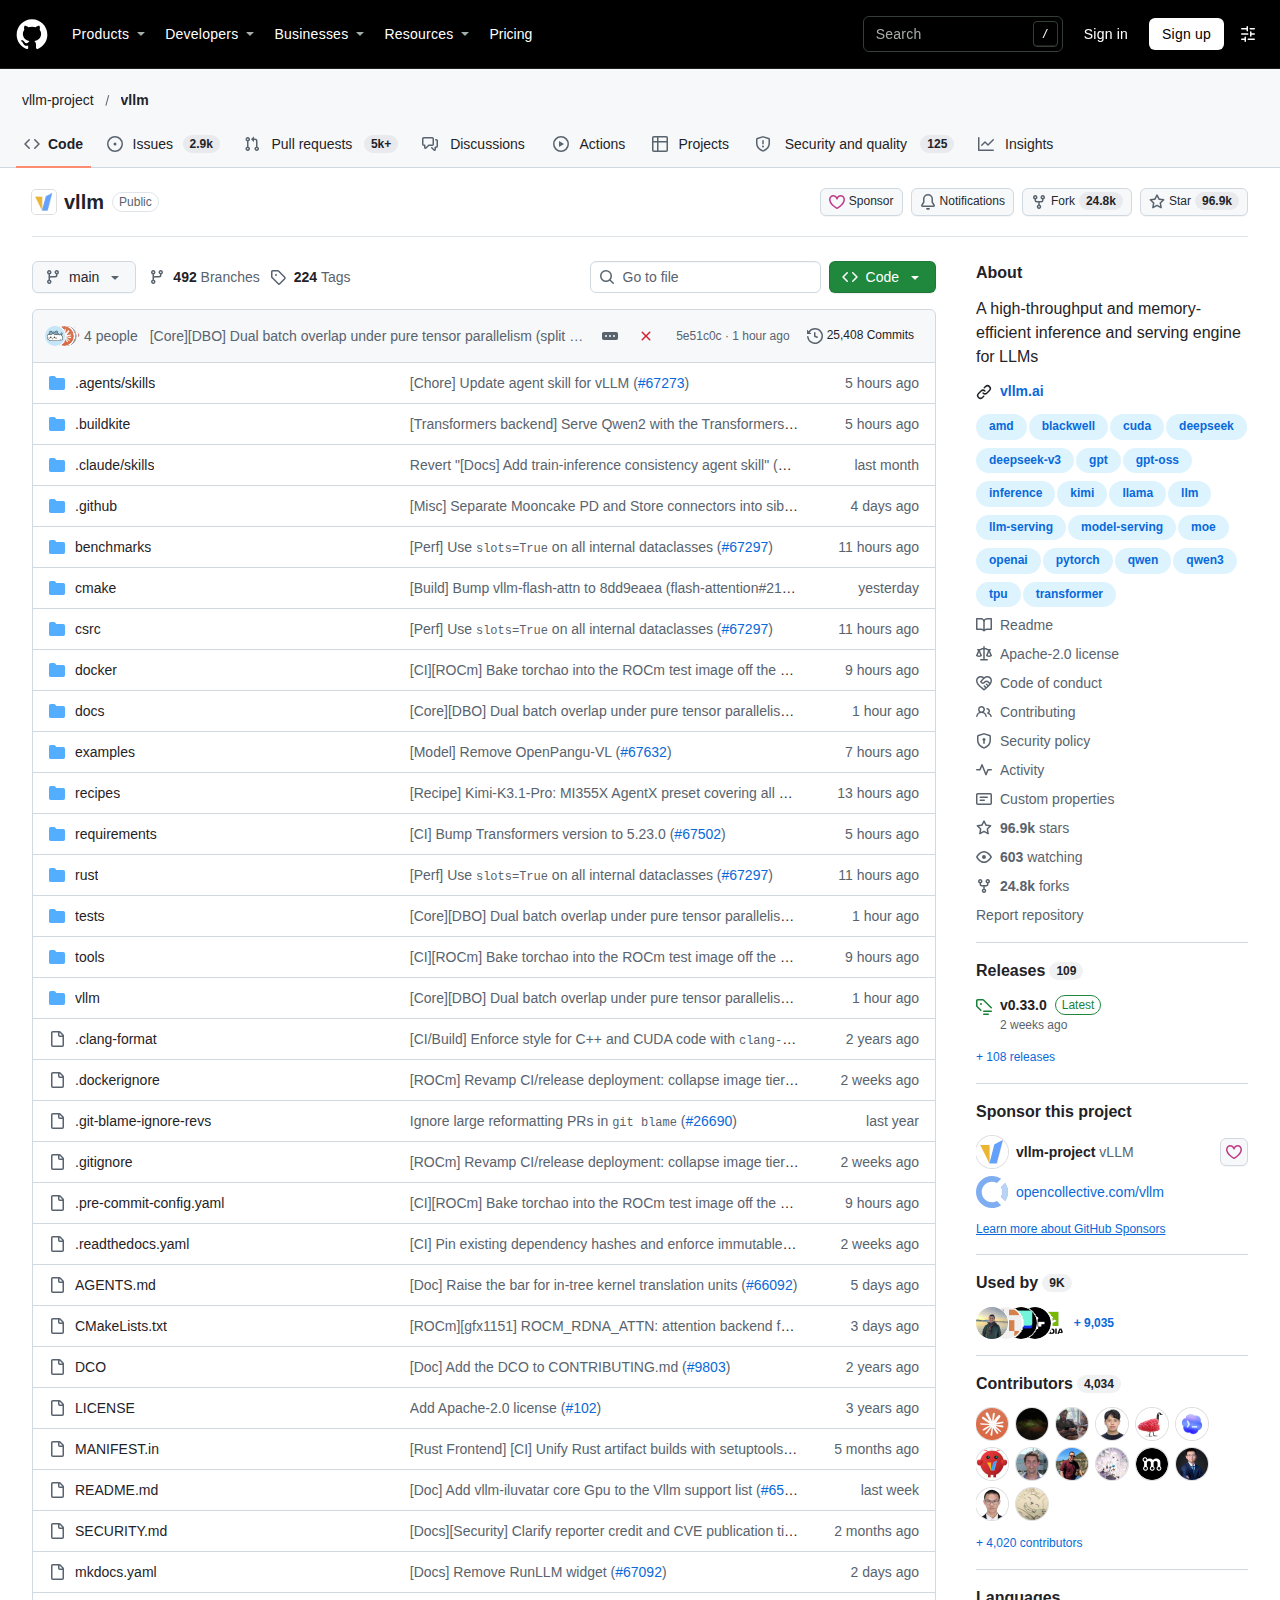
倉庫目前有 10,362 個未結議題,這個數字反映專案規模,同時意味著升級時遇到的行為差異未必即時有官方答覆。企業部署宜先在影子環境跑一輪真實流量,再對比輸出品質與延遲分佈。
若部署依賴自建編譯的核心,PyTorch 2.14 與 Triton 3.8 的組合會令舊核心需要重新編譯。官方今次提供與 libtorch 介面穩定的 CUDA 輪子,可減少每次升級重編的成本,亦是較值得優先採用的安裝方式。
模型路由與推理服務的分層也可以一併考慮。LangChain 1.5 把模型選擇交給分類器,上層決定用哪個模型,下層才由 vLLM 這類引擎負責如何跑得快。
啟動可靠度方面,本版加入引擎與工作進程的看門狗,卡住時會輸出堆疊追蹤。多卡部署的本地工作進程改為並行啟動,官方在 TP8 組合下量到約 50 秒的啟動時間節省。
vLLM 的主要數據有哪些?
vLLM 累積 96,935 顆星標與 24,826 個分支,Apache 2.0 授權,主要語言 Python,最新版本 0.33.0。
出處連結有哪些?
本文資訊整理自 vLLM 官方儲存庫的 README 與 0.33.0 版本說明,原始碼、發行檔與完整變更清單可在其 GitHub 頁面查閱。
出處為 GitHub 上的 vllm-project/vllm 儲存庫,版本說明同時列出各項效能的量測硬件組合,讀者可依自身配置對照:
- 儲存庫:https://github.com/vllm-project/vllm
- 版本說明:https://github.com/vllm-project/vllm/releases
- 官方文件:https://docs.vllm.ai
總結:vLLM 0.33 適合什麼團隊?
已在 CUDA 13 環境、或正評估 AMD 推理平台的團隊最適合升級;仍依賴 Medusa 推測解碼與 CUDA 12.9 映像的部署則應先完成遷移規劃。
0.33.0 的價值集中在兩點。推測解碼的槽位限制取消,令高併發場景的輸出吞吐有機會倍增;ROCm 10.0 與 MonoKernel 的組合,則令 AMD 平台首次具備與 NVIDIA 相近的部署選項。
代價是升級路徑變窄。CUDA 12.9 下架與兩項推測器移除,令部分既有部署無法直接替換映像。對於版本落後超過兩個版本的服務,較穩妥的做法是先升到 0.32 驗證相容性,再跨到 0.33 並逐項核對棄用清單。
專案的迭代速度仍然維持在兩周一次,這種節奏意味着任何一次升級都需要可重複的回滾方案。把版本固定與自動化測試納入流程的團隊,才能真正吸收每次版本帶來的吞吐紅利。
