llama.cpp 於二零二六年十一月十三日發布 v1.0.0,這是專案自二零二三年三月建立以來首次啟用主版本號,同時把底層張量庫 ggml 推進至 v1.0.0。此版移除三十五個棄用函數,把 NextN 投機解碼介面升上公開標頭,並加入 OCP FP8 KV 快取。
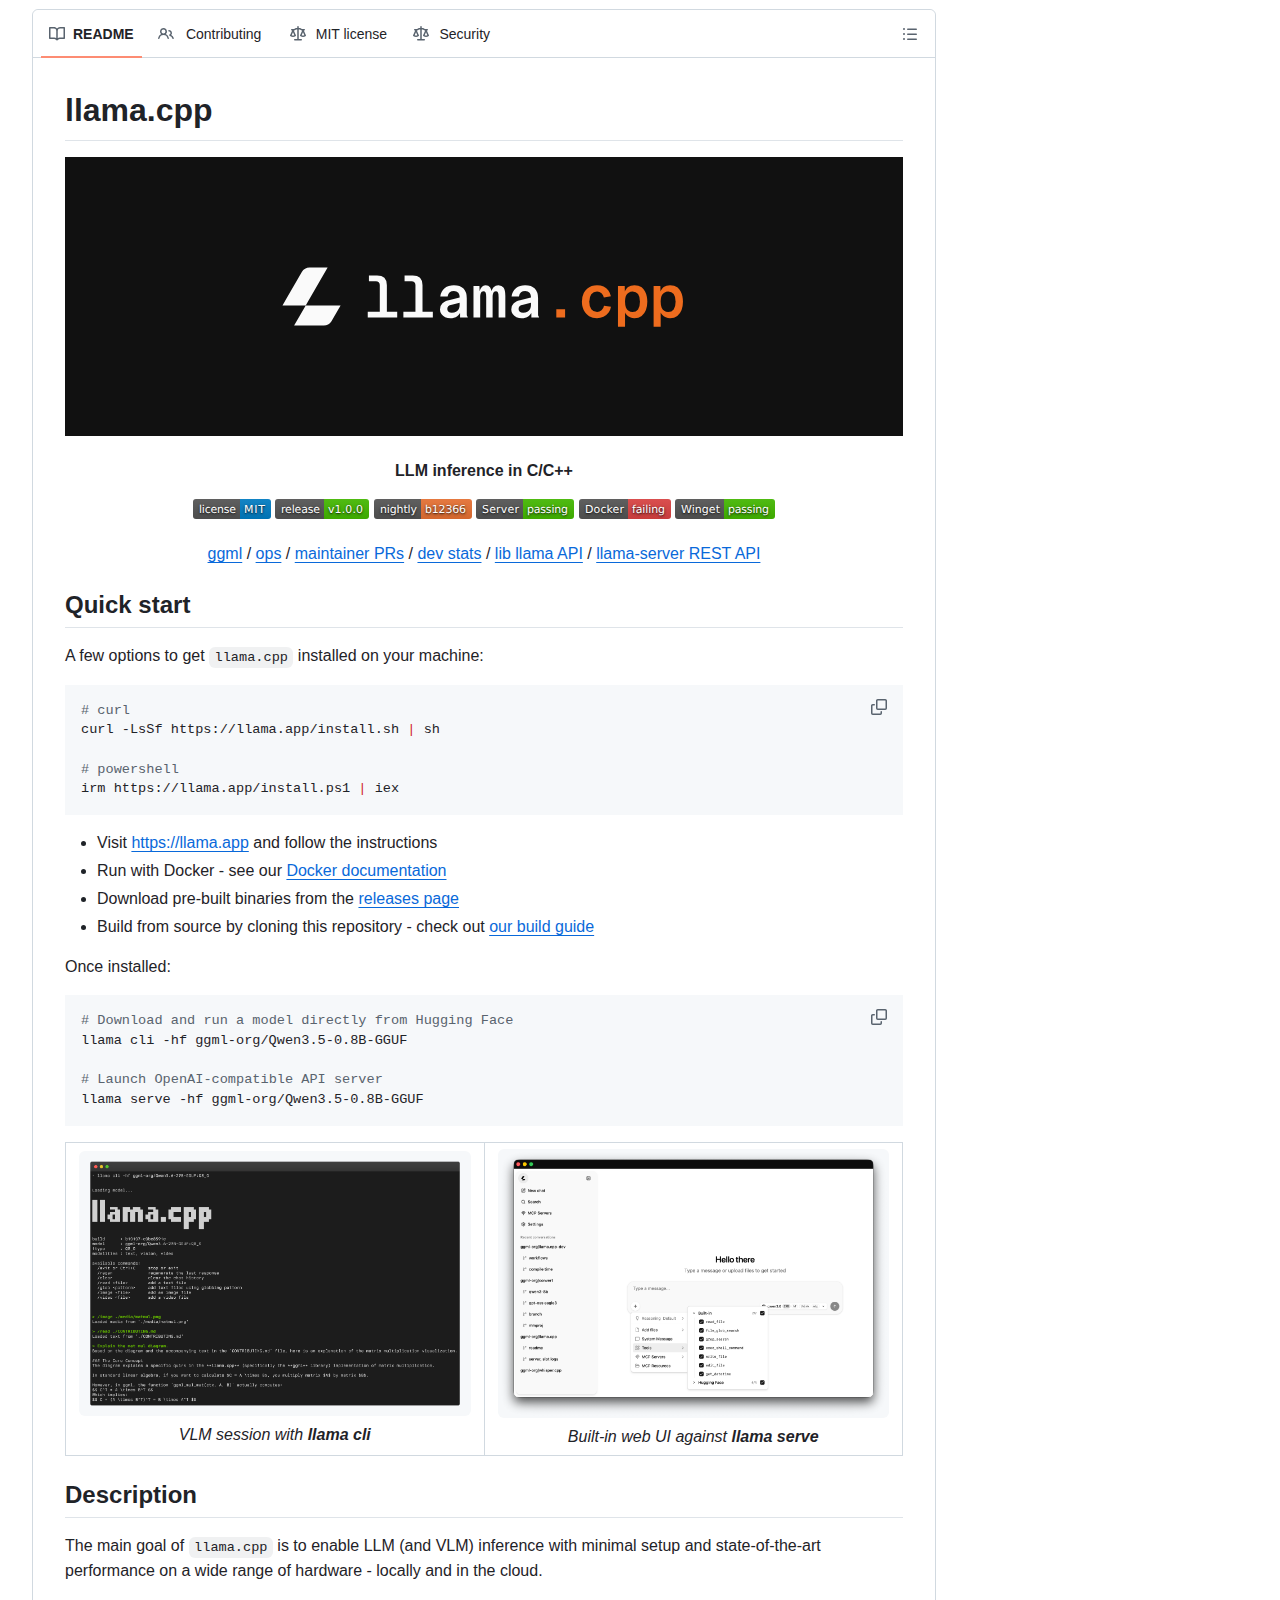
專案定位自建立以來保持一致。它要在最少設定的前提下,於各類硬件執行大型語言模型與視覺語言模型的推理,既可在本地執行,也能部署到雲端。
這項定位使專案成為本地推理的主要基礎。多數桌面端模型應用、量化工具與圖形介面,都以它的 GGUF 格式與後端作為執行層。
llama.cpp v1.0.0 是什麼?
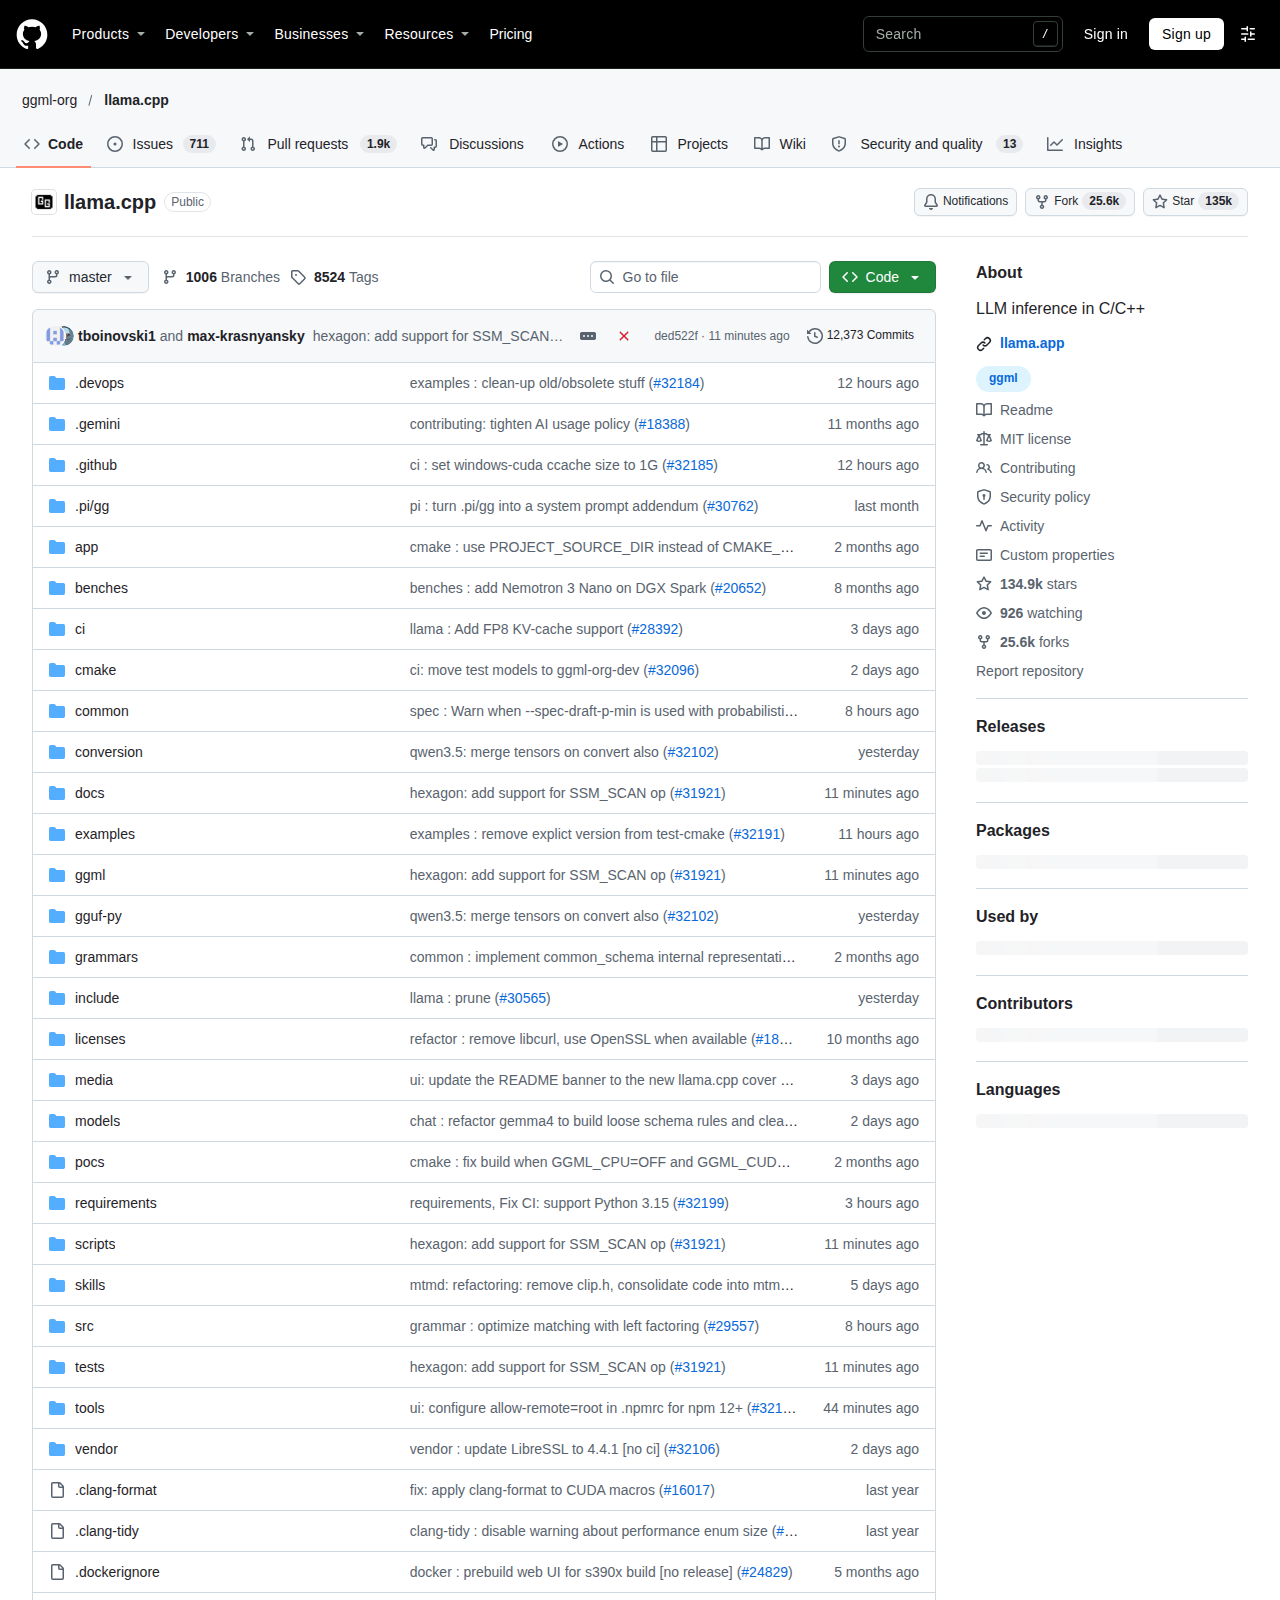
llama.cpp v1.0.0 於 2026 年 11 月 13 日發布,以 C/C++ 提供大型語言模型推理,採 MIT 授權,星標約 13.5 萬。
專案以 libllama 對外提供推理介面,底層張量運算交由 libggml 處理,兩者各自有獨立的公開標頭與版本號。此次發布把兩個庫一併標記為 v1.0.0,版本說明引用七十八個合併請求,並列出二百四十九筆提交紀錄。
| 項目 | 數據 |
|---|---|
| GitHub 星標 | 134,862 |
| 分支數 | 25,566 |
| 主要語言 | C/C++ |
| 授權 | MIT |
| 建立日期 | 2023 年 3 月 10 日 |
| v1.0.0 發布 | 2026 年 11 月 13 日 |
為什麼要推出 1.0 這個版本?
專案成立三年半後,下游應用已大量依賴其介面,維護團隊需要一個明確的穩定承諾。主版本號用來標示介面邊界,而非功能成熟度。
官方部落格把這次發布描述為責任的宣告。當愈來愈多產品把 llama.cpp 當作執行層,介面的每一次變動都會傳導到下游,因此需要一套可預期的版本規則。
規模是另一項理由。目前專案支援超過一百五十種模型架構,以及主流的多種投機解碼方法,並在 Linux、macOS、Windows、Android 與 iOS 上提供預先建置產物。
維護團隊亦在發布文中說明持續投入的基礎設施。在 NVIDIA、AMD、Qualcomm、Arm、IBM 與 Intel 的硬件支援下,自架執行器覆蓋主要運算平台,用以驗證每一次合併。
語意化版本規則如何影響下游開發者?
主版本對應 include 目錄內公開 C API 的破壞性變更,次版本對應向後兼容的功能與後端更新,修訂號對應無介面變更的修錯。
規則寫得相當具體。凡是 include 內的公開 C 介面出現不相容變更,就升主版本號;新增功能、後端更新或模型支援,升次版本號;純修錯而介面不變,只升修訂號。
這套規則同時適用於 ggml 專案群。官方表明往後會更嚴格地把介面邊界顯性化,讓下游在建置與升級時能預先判斷風險。
對使用命令列工具的讀者,版本號的意義較小。但若專案把 libllama 嵌入自家應用,主版本號的變動就是必須重新編譯與回歸測試的訊號。
v1.0.0 的公開介面有哪些破壞性變更?
移除 llama_set_warmup 與三十五個棄用函數,刪除 defrag_thold 及旗標,NextN 介面升上 llama.h。
三處改動最有機會令既有程式編譯失敗。第一項是預熱功能退場,原本呼叫 llama_set_warmup 的初始化流程需要改寫。第二項是命令列旗標 --defrag-thold 消失,依賴它調整 KV 快取碎片整理的啟動腳本會失去效果。
第三項關係到投機解碼。NextN 介面原本放在擴充標頭 llama-ext.h,現已提升為正式介面並移入 llama.h,同時把 llama_set_embd_state_src 更名為 llama_set_ctx_state_src。
升級時建議先做一次完整編譯,再以自建腳本跑一輪推理,確認沒有殘留舊介面的呼叫。專案維持每夜建置,若需要時間遷移,可暫時停留在對應的每夜版本。
記憶體管理新增了哪些能力?
新增 OCP FP8 KV 快取,可用 -ctk/-ctv 設為 f8_e4m3。MoE 專家快取加入 CPU 佔比參數,外部 PLE 分片可獨立載入。
FP8 KV 快取是這次最直接影響佔用的改動。把鍵值快取由十六位元降到八位元,可延長可用上下文長度,代價是需要確認縮放設定與模型相容性。上一版把 FP8 量化與多節點並行放在一起,v0.9.0 的實測數字可作對照基線。
MoE 專家快取的調整針對混合專家模型。新增的 CPU 佔比參數讓未命中的專家在系統記憶體中處理,並改用 LRFU 與 ClassLRU 之類的替換策略,命中時不再等待 CPU 端。同類設計在顯示記憶體不足時以系統記憶體承接參數的做法中亦可見,方向都是把權重搬運成本換成可預測的延遲。
其餘兩項偏工程層面。外部 PLE 分片允許把詞彙相關權重放在獨立 GGUF 檔案,按需載入;Windows 端補上與 Linux DirectIO 對應的無緩衝載入路徑。
新增支援哪些模型與模態?
文字架構加入 Kimi-K3.1-Pro、Ripple-65B 與 xing4_0,語音加入 drama-3,視覺加入 MageVL-Cowork 與 Kimi-K3.1。
Kimi-K3.1-Pro 的改動幅度較大。它把原本的全注意力 MLA 層換成 DSA,屬架構層調整而非單純權重相容。Ripple-65B-Preview 則是新的稠密六十五億級設計,官方強調沒有引入新算子。
語音端補上 drama-3 合成,並新增 OpenAI 相容的 /v1/audio/speech 端點,/tts 亦加上溫度參數。視覺與音訊的子上下文改為共用計算緩衝,降低同時載入多模態模型時的記憶體需求。
架構層同時做了收斂。舊有的 clip.h 被移除,模型與子上下文的基礎設施整合進 mtmd,log-mel 頻譜改在計算圖內完成,不再為每個請求開執行緒。
llama-server 在安全性上做了哪些收緊?
未認證工具與私有網址改為須明確開啟,同版修正 CORS 驗證、DNS 重綁定與代理 SSRF,HF_TOKEN 限制在 huggingface.co。
四項修正都被列入版本說明的安全段落。CORS 來源檢查原本可被繞過,代理路徑存在 SSRF 風險,子實例的存取控制亦有缺口。
令牌處理同樣收窄。HF_TOKEN 只會送往 huggingface.co 主機,避免在下載模型時把憑證交給其他網域。
工具調用補上取消機制。客戶端斷線或超時時,伺服器會中止對應的 MCP 工具調用並通知對方,不再讓請求在背景持續佔用資源。
對外暴露服務的讀者值得留意預設值的變化。以往可直接使用的未認證工具與私有網址抓取,現在要自行加上旗標才會啟用。
如何安裝或升級到 v1.0.0?
最簡方式是執行官方安裝腳本,Linux 與 macOS 用 curl,Windows 用 powershell,亦可經 Homebrew、Winget 或 Docker 安裝。
官方 README 把安裝壓成一行指令。腳本會抓取對應平台的預先建置版本,完成後即可下載模型並啟動相容 OpenAI 介面的伺服器。
curl -LsSf https://llama.app/install.sh | sh
llama run <model>
llama serve
Windows 環境改用 irm https://llama.app/install.ps1 | iex。若團隊已有套件管理流程,可走 Homebrew、Winget、conda-forge 或 MacPorts,容器化部署則有官方 Docker 映像。
自行編譯的讀者要留意後端選項。CUDA 十二與十三、ROCm、Vulkan、SYCL、OpenVINO 與行動平台的 Snapdragon 後端各有獨立產物,升級時需同步更新對應的執行期函式庫。
有哪些已知限制與升級風險?
介面移除會令舊呼叫編譯失敗,defrag 旗標失效後碎片整理改由其他機制處理。商店條目的未簽章提示與各後端產物版本不同步,亦是常見的升級障礙。
風險集中在三個層面。原始碼層面的舊函數呼叫必須改寫,這一點在編譯階段就會暴露,處理成本最低。
執行層面的變化較隱蔽。KV 快取改為 FP8 後,長上下文的數值穩定性需要實測;MoE 專家快取的 CPU 佔比若設得過高,吞吐會明顯下降。
發行渠道的同步亦需留意。各平台商店與容器映像的收錄時間不同,版本說明中的功能未必在當日就能透過套件管理器取得。倉庫目前仍有約二千六百個未結問題,遇到異常時值得先搜尋既有回報。
出處連結有哪些?
版本內容見 GitHub 的 v1.0.0 Release,設計說明與版本規則見 Hugging Face 部落格,程式碼在 ggml-org/llama.cpp。
發布說明位於 llama.cpp v1.0.0 Release,逐項列出介面變更、新模型與後端修正。官方設計文章為 llama.cpp v1.0.0: A stronger foundation for the local AI ecosystem。
程式碼、建置說明與各平台發行產物集中在 github.com/ggml-org/llama.cpp,張量庫 ggml 亦同步發布 v1.0.0。
總結:llama.cpp v1.0.0 適合什麼團隊?
把推理層嵌入自家產品的團隊最值得升級,因為介面邊界自此有明確規則。純用命令列工具的讀者收益集中在模型支援與伺服器安全修正。
這次發布的意義主要在契約層面。三年半累積的功能已足夠,專案選擇在此刻把介面鎖定,讓下游能按版本號判斷升級成本。
實際收益分散在幾個方向。FP8 KV 快取與 MoE 專家快取降低記憶體門檻,新架構擴大可用模型範圍,伺服器安全修正則降低自架服務的暴露面。
限制同樣存在。捨棄舊介面的代價由下游承擔,自行編譯者要重新驗證後端組合。對只在桌面使用圖形介面的讀者,升不升級的差別,多半要等應用程式跟著更新才感受得到。
