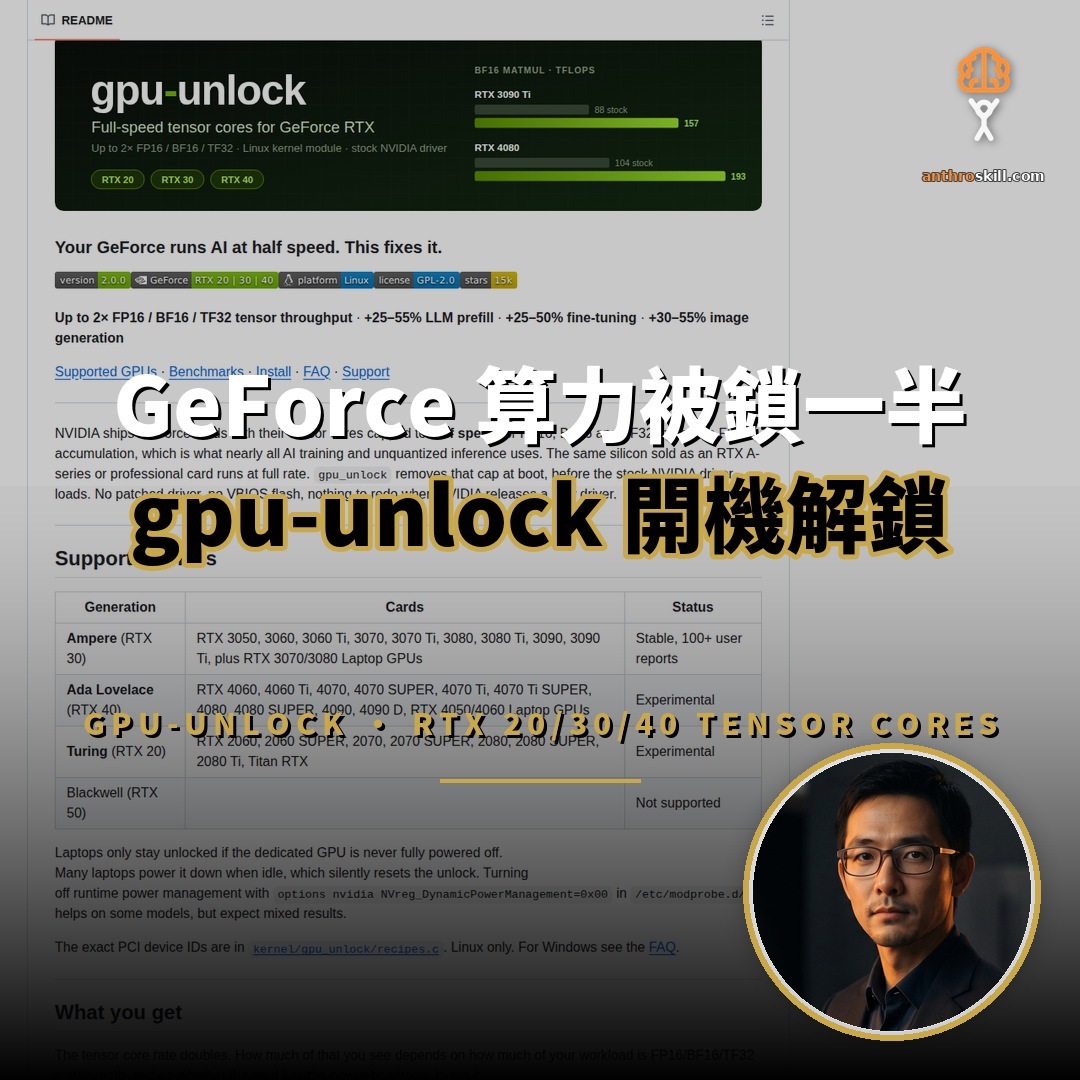
Zagitta 的 gpu-unlock 於二零二六年十月十八日建立,兩星期內累積超過一萬五千顆星標。它是一個 Linux 核心模組,在 NVIDIA 驅動綁定顯卡前,把 GeForce 被鎖住的張量核心速率解開。RTX 4090 的 BF16 矩陣運算由 165 TFLOPS 升至 329 TFLOPS。
gpu-unlock 到底解除什麼限制?
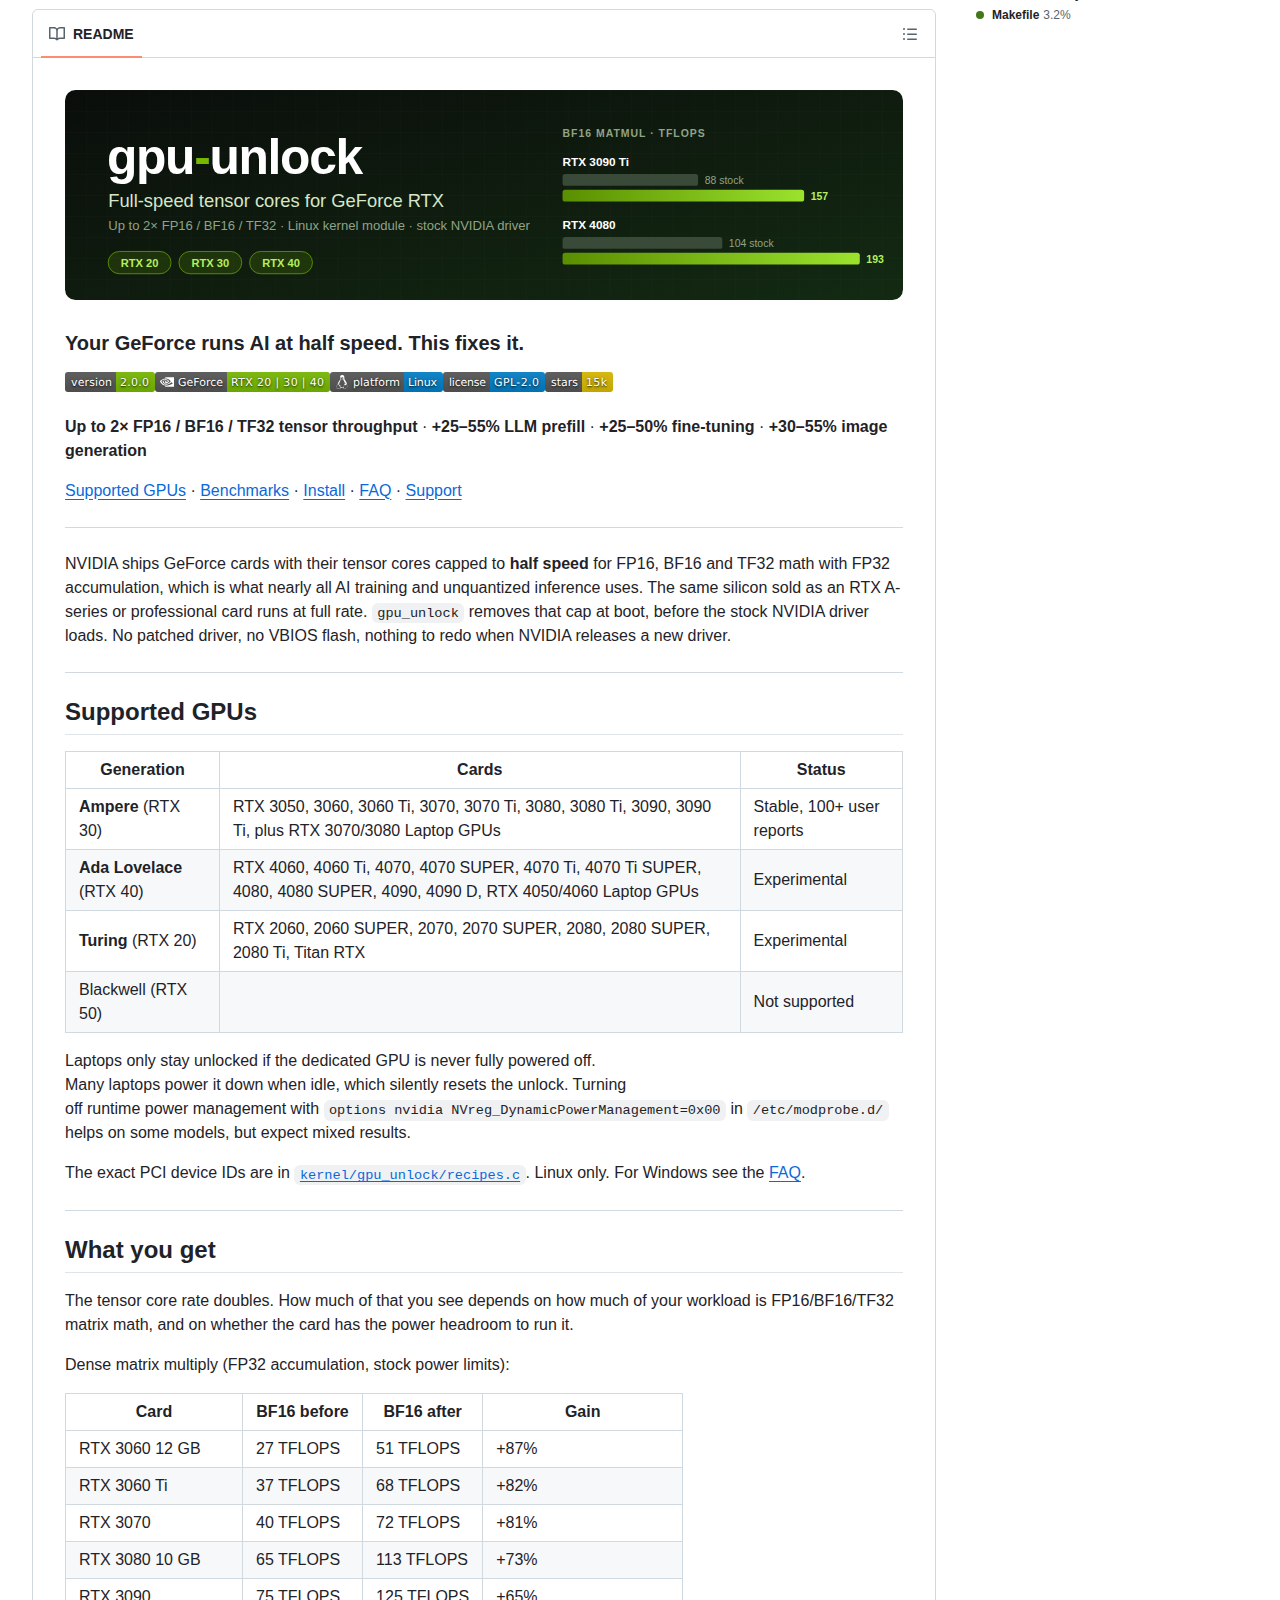
NVIDIA 在 GeForce 上把 FP16、BF16、TF32 配合 FP32 累加的張量核心速率鎖在一半,專業卡則跑全速。模組在開機時寫入速度選擇器解除限制。
這個限制影響的範圍比想像中闊。幾乎所有 AI 訓練與未量化的推論,用的正是 FP16、BF16 或 TF32 配合 FP32 累加的矩陣運算。同一片矽晶以 RTX A 系列或專業卡名義出售時,跑的就是全速。
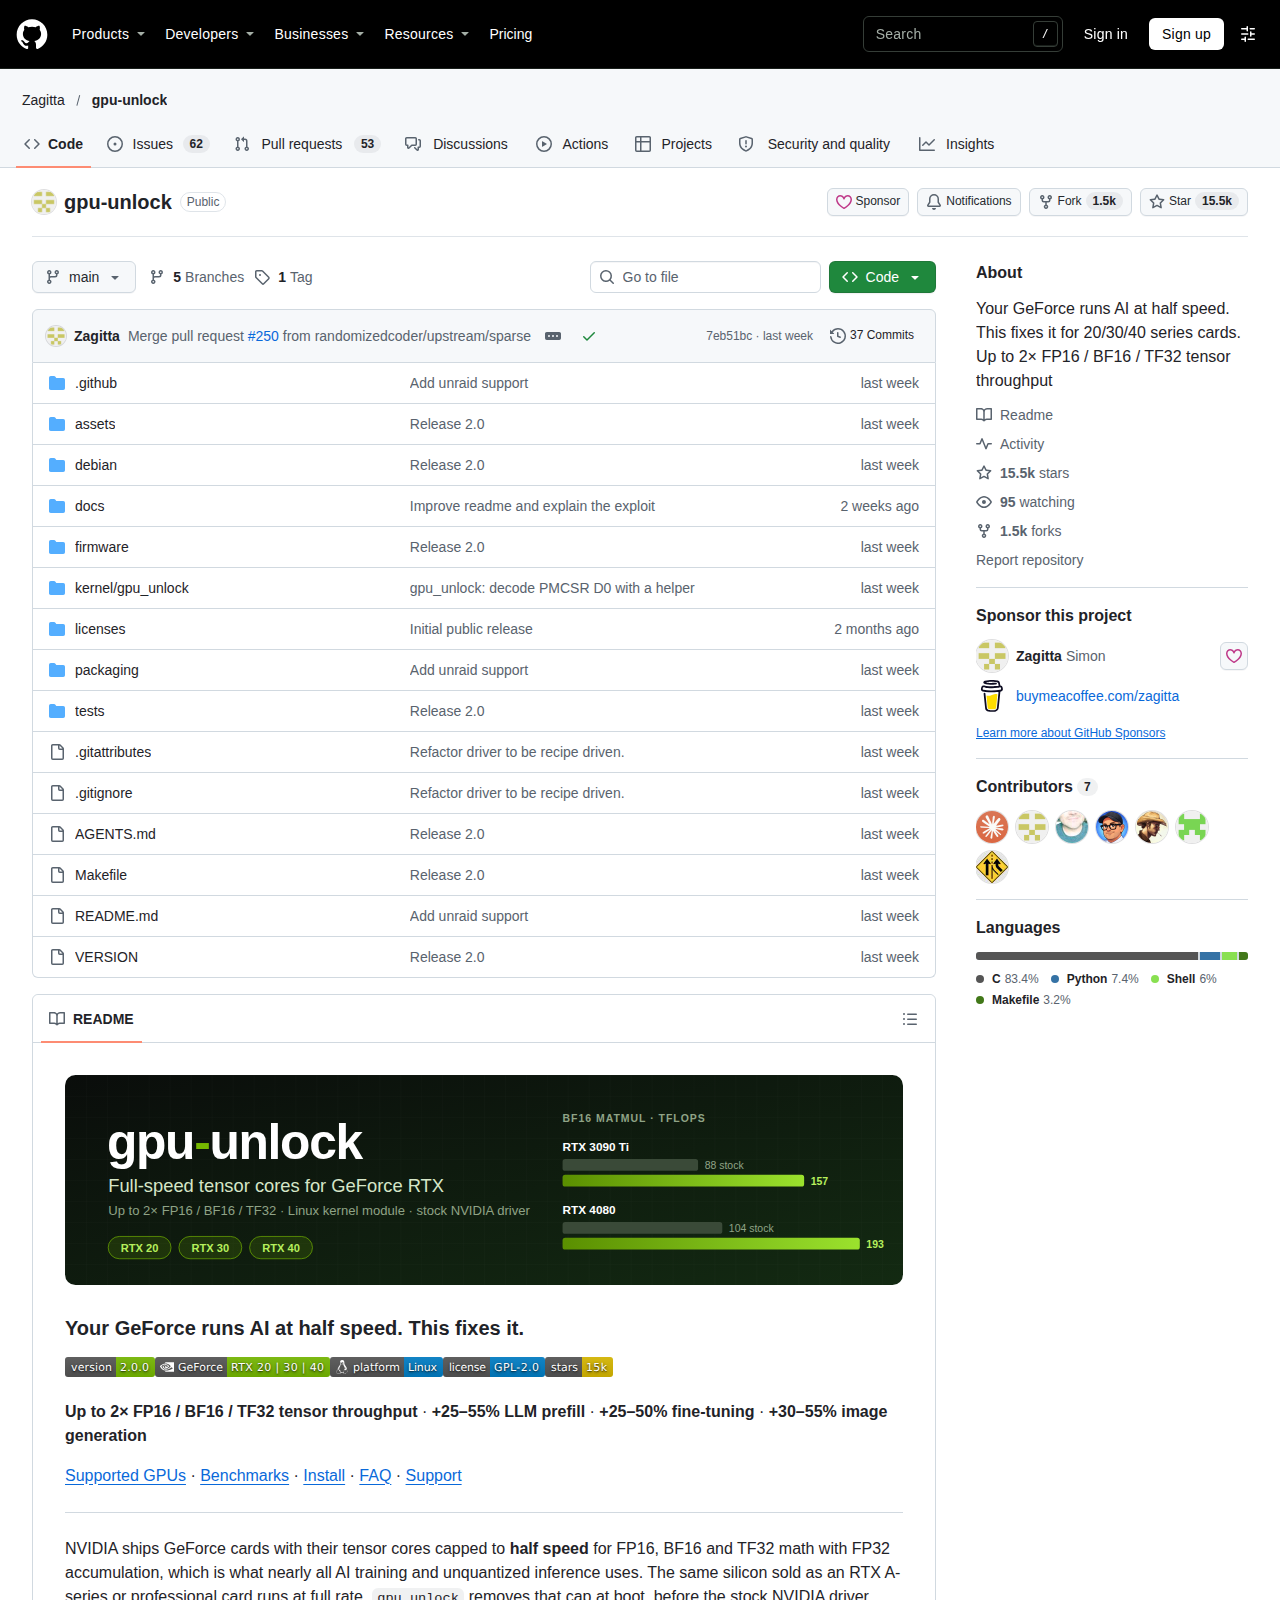
作者在倉庫的問答段落給出直接解釋,指這是市場區隔的手段,NVIDIA 要企業購買價格高出數倍的專業卡才能取得完整算力。倉庫目前為 2.0.0 版,以 C 語言撰寫核心模組,累積一萬五千四百九十九顆星標與一千五百二十一次復刻。
解鎖後實際快多少?
作者公布九款顯卡的 BF16 前後對比,全部在預設功耗上限下量度。RTX 4090 由 165 升至 329 TFLOPS,RTX 3060 12GB 由 27 升至 51。
數據按顯示卡世代排列,Ampere 架構的 RTX 30 系列全部落在六成半至八成七的增幅區間。Ada 架構的 RTX 40 系列增幅相近,但功耗牆更早觸頂。
| 顯示卡 | 解鎖前 BF16 | 解鎖後 BF16 | 增幅 |
|---|---|---|---|
| RTX 3060 12GB | 27 TFLOPS | 51 TFLOPS | +87% |
| RTX 3060 Ti | 37 TFLOPS | 68 TFLOPS | +82% |
| RTX 3070 | 40 TFLOPS | 72 TFLOPS | +81% |
| RTX 3080 10GB | 65 TFLOPS | 113 TFLOPS | +73% |
| RTX 3090 | 75 TFLOPS | 125 TFLOPS | +65% |
| RTX 3090 Ti 450W | 88 TFLOPS | 157 TFLOPS | +80% |
| RTX 4070 Ti | 81 TFLOPS | 150 TFLOPS | +84% |
| RTX 4080 | 104 TFLOPS | 193 TFLOPS | +87% |
| RTX 4090 | 165 TFLOPS | 329 TFLOPS | +100% |
RTX 4090 的數字需要額外說明。它的功耗預算在張量核心用到一半之前就已經耗盡,因此大型矩陣乘法的實際增益遠低於峰值比率所示的一倍。表格中的 329 TFLOPS 屬於峰值 MMA 速率,不是可持續輸出的成績。
真實工作負載的加速幅度有多大?
LLM 預填提升兩成半至五成半,首次出字時間縮短兩成半至三成,LoRA 微調提升兩成半至五成,影像生成提升三成至五成半。解碼階段與量化模型沒有變化。
工作負載的差距比規格數字更能說明適用範圍。加速集中在矩陣乘法密集的階段,瓶頸一旦轉移到記憶體頻寬就完全消失。
| 工作負載 | 典型加速 |
|---|---|
| LLM 預填與提示處理,FP16/BF16 或 AWQ/GPTQ | +25% 至 +55% |
| 首次出字時間 | 縮短 25% 至 30% |
| BF16 LoRA 與全參數微調 | +25% 至 +50% |
| 影像生成,SDXL、SD 1.5、Krea、ComfyUI 的 DiT 模型 | +30% 至 +55% |
| FlashAttention 與 SDPA 核心 | +50% 至 +60% |
| Wan 2.2 影片生成 | +15% 至 +20% |
| llama.cpp 與 Ollama 的量化 GGUF | 0% 至 +15% |
| LLM 解碼與逐字生成 | 無變化 |
| INT8、FP8、INT4 模型 | 無變化 |
| 遊戲與 FP32 CUDA | 無變化 |
輸出數值前後完全一致,只有速度改變。這一點相當關鍵,它意味著解鎖不會影響實驗可重現性,也不會令既有基準分數失去可比性。作者強調這些數字來自使用者自行提交的相容性報告,完整基準細節可在倉庫的議題區查閱。
為什麼消費卡會被限制一半算力?
作者認為這是市場區隔策略,NVIDIA 要企業購買價格高出數倍的專業卡。同一晶片在專業卡上跑全速,消費卡則被人為寫入較低的速率設定。
這個解釋與 NVIDIA 多年的產品線安排一致。專業卡與消費卡在記憶體容量、錯誤校正與驅動認證上有真實差異,張量核心速率則屬於可以軟性設定的部分。
倉庫的問答段落亦回應安全性疑問。作者指出解鎖只是移除一道為區分產品線而設的人為限制,標準的溫度與功耗調節機制完全保留,顯卡在更高負載下會自行降頻。
開機解鎖的技術原理是什麼?
核心模組結合 cmpunlocker 的 V67/PLM 手法與 UEFI 方案的載入時機,在驅動綁定前寫入速度選擇器並執行功能層重置,並非修改驅動或刷寫 VBIOS。
具體做法是在開機階段寫入兩組速度選擇器。SS0 寫入 0x88888888 選取完整 BF16 速率,四位元的 SS1 寫入 0x8 啟用 IMLA4 指令。寫入完成後執行一次功能層重置,再由未經修改的 NVIDIA 驅動照常綁定顯卡。
套件會把模組與其固件放進 initramfs,確保載入時機早於驅動。三種主流 initramfs 工具各有對應設定檔,mkinitcpio 會把模組插在 nvidia 之前,令顯示卡黑屏時間盡量縮短。
值得注意的是它沒有使用 softdep 依賴規則。作者解釋 kmod 只會採用讀到的第一條 softdep nvidia 規則,其他套件的規則會互相覆蓋,因此改以 initramfs 排序處理順序問題。這種設計亦令 NVIDIA 日後更新驅動時無需重新套用任何補丁。
安裝與日常使用門檻有多高?
三步完成:複製倉庫、執行 make install、在核心命令列加入 gpu_unlock.targets=all。模組未見授權參數時不做任何事,設計可逆。
make install 會讀取系統資訊判斷發行版,再選用對應的封裝方式,支援 Arch、Debian/Ubuntu 與 Fedora 系列。它會要求 sudo 密碼以安裝建置依賴與套件。
核心命令列參數除了 all 之外,亦可指定個別顯卡的 PCI 位址,格式與 lspci -D 的輸出相同,與 GPU 編號及顯示角色無關。所有支援的顯卡會並行解鎖,不論數量多寡都在約一秒內完成。
驗證方式有兩條指令,journalctl -k -b | grep gpu_unlock 檢查開機日誌,lspci -nnk -s 確認綁定狀態。若要停用,移除命令列參數即可,單次開機亦可在開機選單臨時刪除。
休眠與待機的處理值得留意。進入記憶體待機會令顯卡斷電,速度選擇器隨之重置,模組的電源管理通知會在驅動恢復前重新解鎖,代價是恢復時間增加約一秒。硬碟休眠則不在覆蓋範圍。
哪些情況完全沒有加速?
解碼階段受記憶體頻寬限制,量化模型、INT8、FP8、INT4 與遊戲全部無變化。Blackwell 架構的 RTX 50 系列不支援,短期內亦無計劃支援。
量化模型的結果需要特別澄清。llama.cpp 與 Ollama 使用量化 GGUF 時只有零至一成半的增益,主要集中在長上下文場景。若日常用途是跑量化模型做推論,實際感受會相當有限。
平台限制同樣明確。專案只支援 Linux,作者表明不打算維護 Windows 版本,社群雖有非官方移植,但作者提醒使用者對來路不明的安裝程式保持警覺。
筆記型電腦的情況更複雜。獨立顯卡必須全程保持供電,解鎖狀態才得以維持。多數筆電在閒置時會關閉獨顯,令解鎖靜默失效。在核心模組設定關閉執行時電源管理有幫助,但作者坦言效果因機型而異。
風險與穩定性要怎麼評估?
Ampere 世代累積超過一百份使用者報告,狀態標為穩定。Ada 與 Turing 仍屬實驗階段。授權為 GPL-2.0,固件衍生自 CMP 參考實作,法律定位需自行判斷。
穩定性分級在支援清單中寫得相當清楚。RTX 30 全系列標為穩定並有超過一百份使用者回報,RTX 40 與 RTX 20 則標為實驗階段,意味著有機會遇到未預期的行為。
授權安排存在需要留意的細節。核心模組與封裝腳本採用 GPL-2.0-only,產生的緩衝區衍生自已固定的 CMP 參考實作,NVIDIA 固件本身仍受其原有條款約束。倉庫另附 NOTICE 與授權目錄說明署名要求。
作者亦主動劃清界線,聲明沒有官方網站、代幣或安裝程式,任何以專案名義出現的類似產物都與其無關。這類聲明在顯卡解鎖類專案中並不罕見,以往曾有冒充版本夾帶惡意程式。
曾經出現的極端情況亦有記錄。若顯卡上的固件始終無法停止,模組會寫入日誌並保留固件可能仍在使用的 DMA 緩衝區,直到下一次斷電。作者建議在這種情況下先完全關機再重試。
出處連結有哪些?
專案原始碼放在 GitHub 的 Zagitta/gpu-unlock,授權與固件聲明見倉庫目錄。使用者提交的相容性報告與基準細節集中在議題區。
- 專案倉庫:https://github.com/Zagitta/gpu-unlock
- 議題區與相容性報告:https://github.com/Zagitta/gpu-unlock/issues
- 非官方 Windows 移植:https://github.com/impacifist/Windows-GPU-UNLOCK
常見問題有哪些?
以下五條問題涵蓋適用顯卡、與超頻的分別、量化模型的實際效果、筆電可行性與保固風險,每題均按倉庫文件與實測數據回答。哪些顯卡可以用?
RTX 30 全系列標為穩定,包括 3050 至 3090 Ti 與筆電版本。RTX 40 與 RTX 20 標為實驗階段。Blackwell 架構的 RTX 50 系列不支援,作者認為短期內亦不會支援。
這與超頻有什麼分別?
超頻提高時脈頻率,解鎖改變的是張量核心的速率設定。前者會令功耗與溫度同步上升,後者只是移除人為限制,標準的功耗與溫度調節機制完全保留,顯卡仍會自行降頻。
跑量化模型值得安裝嗎?
視用途而定。llama.cpp 與 Ollama 的量化 GGUF 只有零至一成半增益,主要集中在長上下文。若主要用途是 vLLM、PyTorch 或 Transformers 的 FP16/BF16 推論與微調,增益可達兩成半至五成半。
筆記型電腦可以使用嗎?
條件較嚴苛。獨顯必須全程保持供電,解鎖狀態才會維持。多數筆電在閒置時會關閉獨顯,令解鎖失效。關閉執行時電源管理對部分機型有幫助,但作者表明效果因機型而異。
會不會損壞顯卡或影響保固?
作者認為損壞風險很低,理由是只移除為區分產品線而設的限制,溫度與功耗保護並未改動,運算量增加只會令溫度略升。保固責任與合規風險則需使用者自行判斷。
總結:這類工具適合哪些使用者?
適合在 Linux 上以 FP16/BF16 做推論或微調、擁有 RTX 30 系列並願意自行處理開機設定的開發者。依賴量化模型、用筆電或需要 Windows 者收益有限。
這個專案的價值在於把一個長期被視為硬體差異的規格,還原成軟體設定問題。它證明消費卡與專業卡在張量核心速率上的差距,並非矽晶層面的物理限制。
適用判斷可以簡化成一條線。工作負載是否集中在 FP16、BF16 或 TF32 的矩陣運算,決定了解鎖能否帶來實際改變。落在記憶體頻寬或量化路徑上的工作,安裝之後大概不會察覺分別。
風險層面則需要獨立看待。實驗階段的世代、筆電的供電行為、授權與固件的法律定位,都屬於使用者要自行承擔的部分。倉庫文件把這些界線寫得相當坦白,這一點本身值得肯定。
