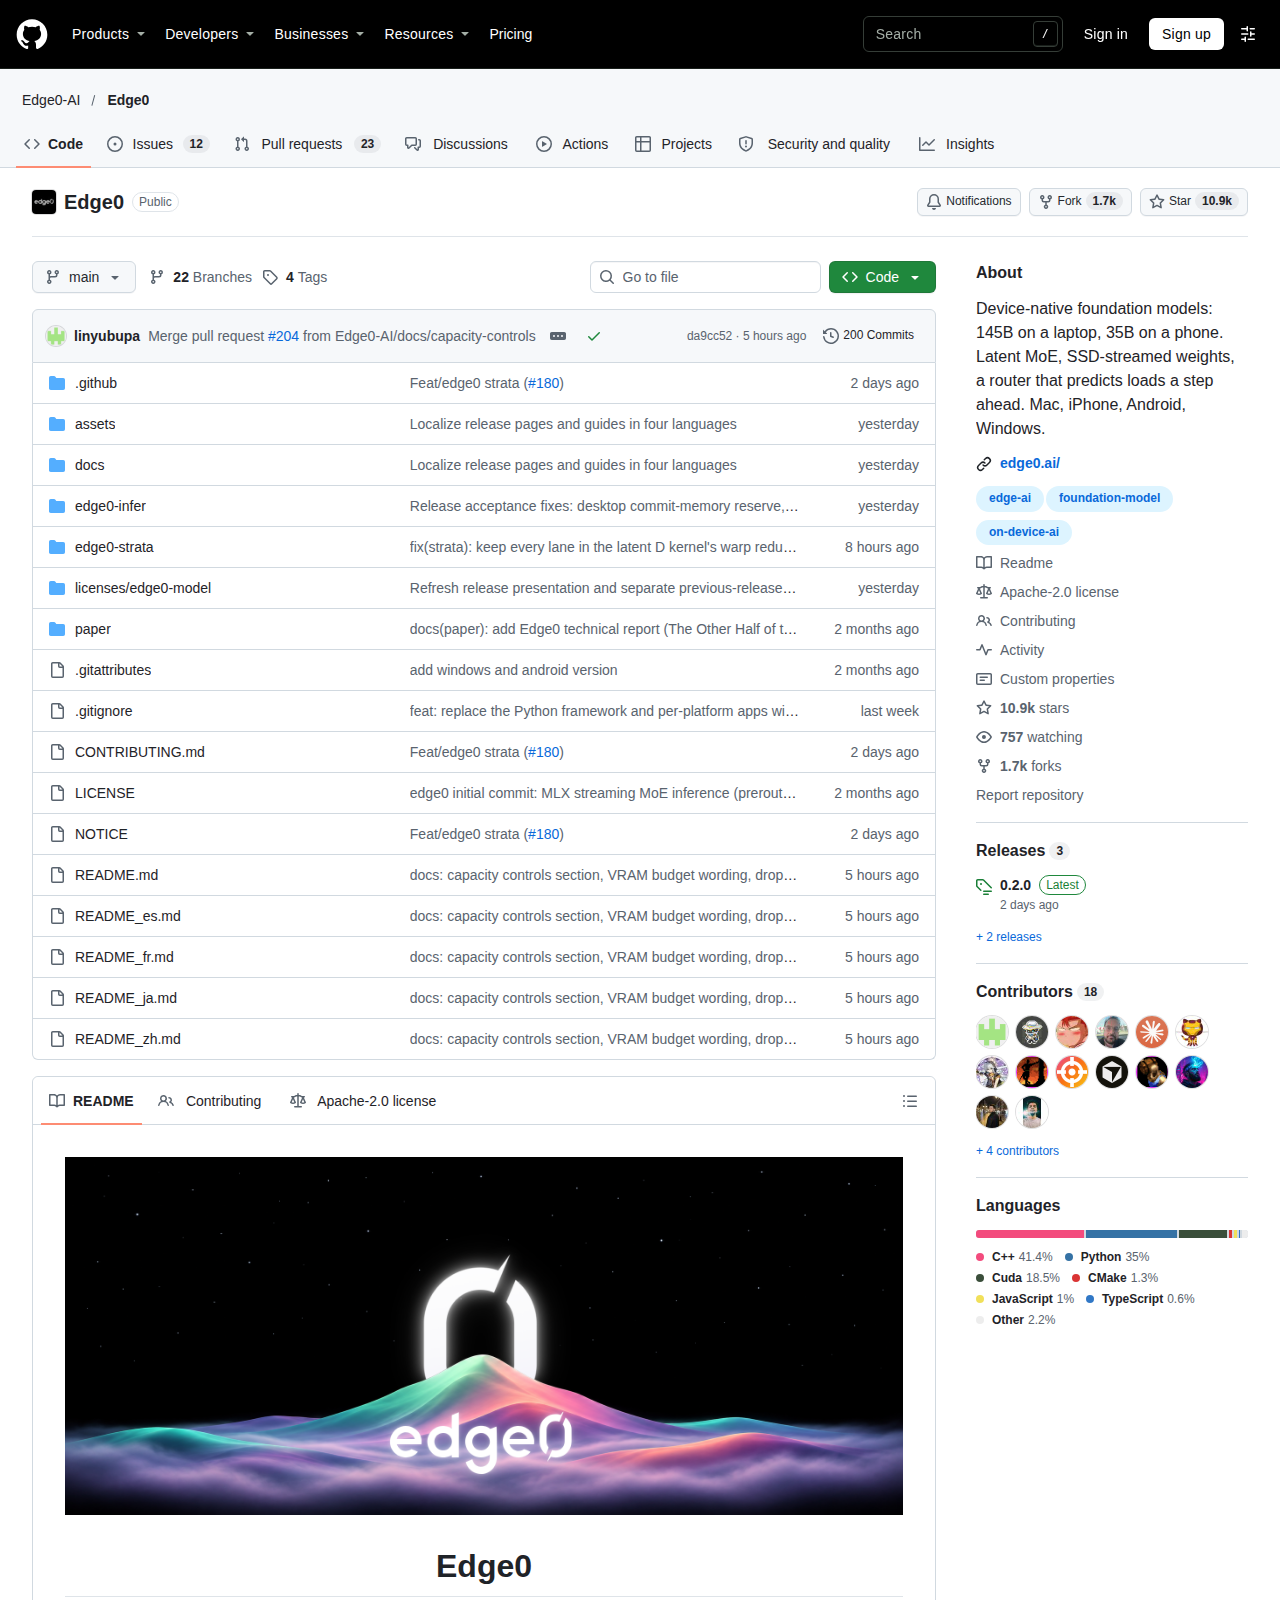
Edge0 於 2026 年 11 月 13 日開源 145B 的 Edge0-145B 與 120B 版本,配合 edge0-infer 推理引擎,可在單張 24GB 顯示卡上執行編程與代理任務。倉庫採 Apache-2.0 授權,以 C++ 撰寫,累積 10,862 顆星標,官方錄得 121.2 tok/s 代理解碼速度。
Edge0-145B 是什麼?
Edge0-145B 是 1450 億參數的潛在混合專家模型,原生以 4 位元訓練,採 Apache-2.0 授權,定位為本機執行代理工作的開源方案。
模型派生自 Qwen3.8-Flash-Next,架構為 48 層、512 個專家、每次推理啟動 K=10。145B 版本設有 1792 個潛在專家,120B 版本為 1280 個,兩者總參數不同但層數與專家數一致。權重同時上架 Hugging Face 與 ModelScope,技術報告以 The Other Half of the Memory Wall 為題放在 arXiv,處理 35B 混合專家模型從 SSD 供應的問題。
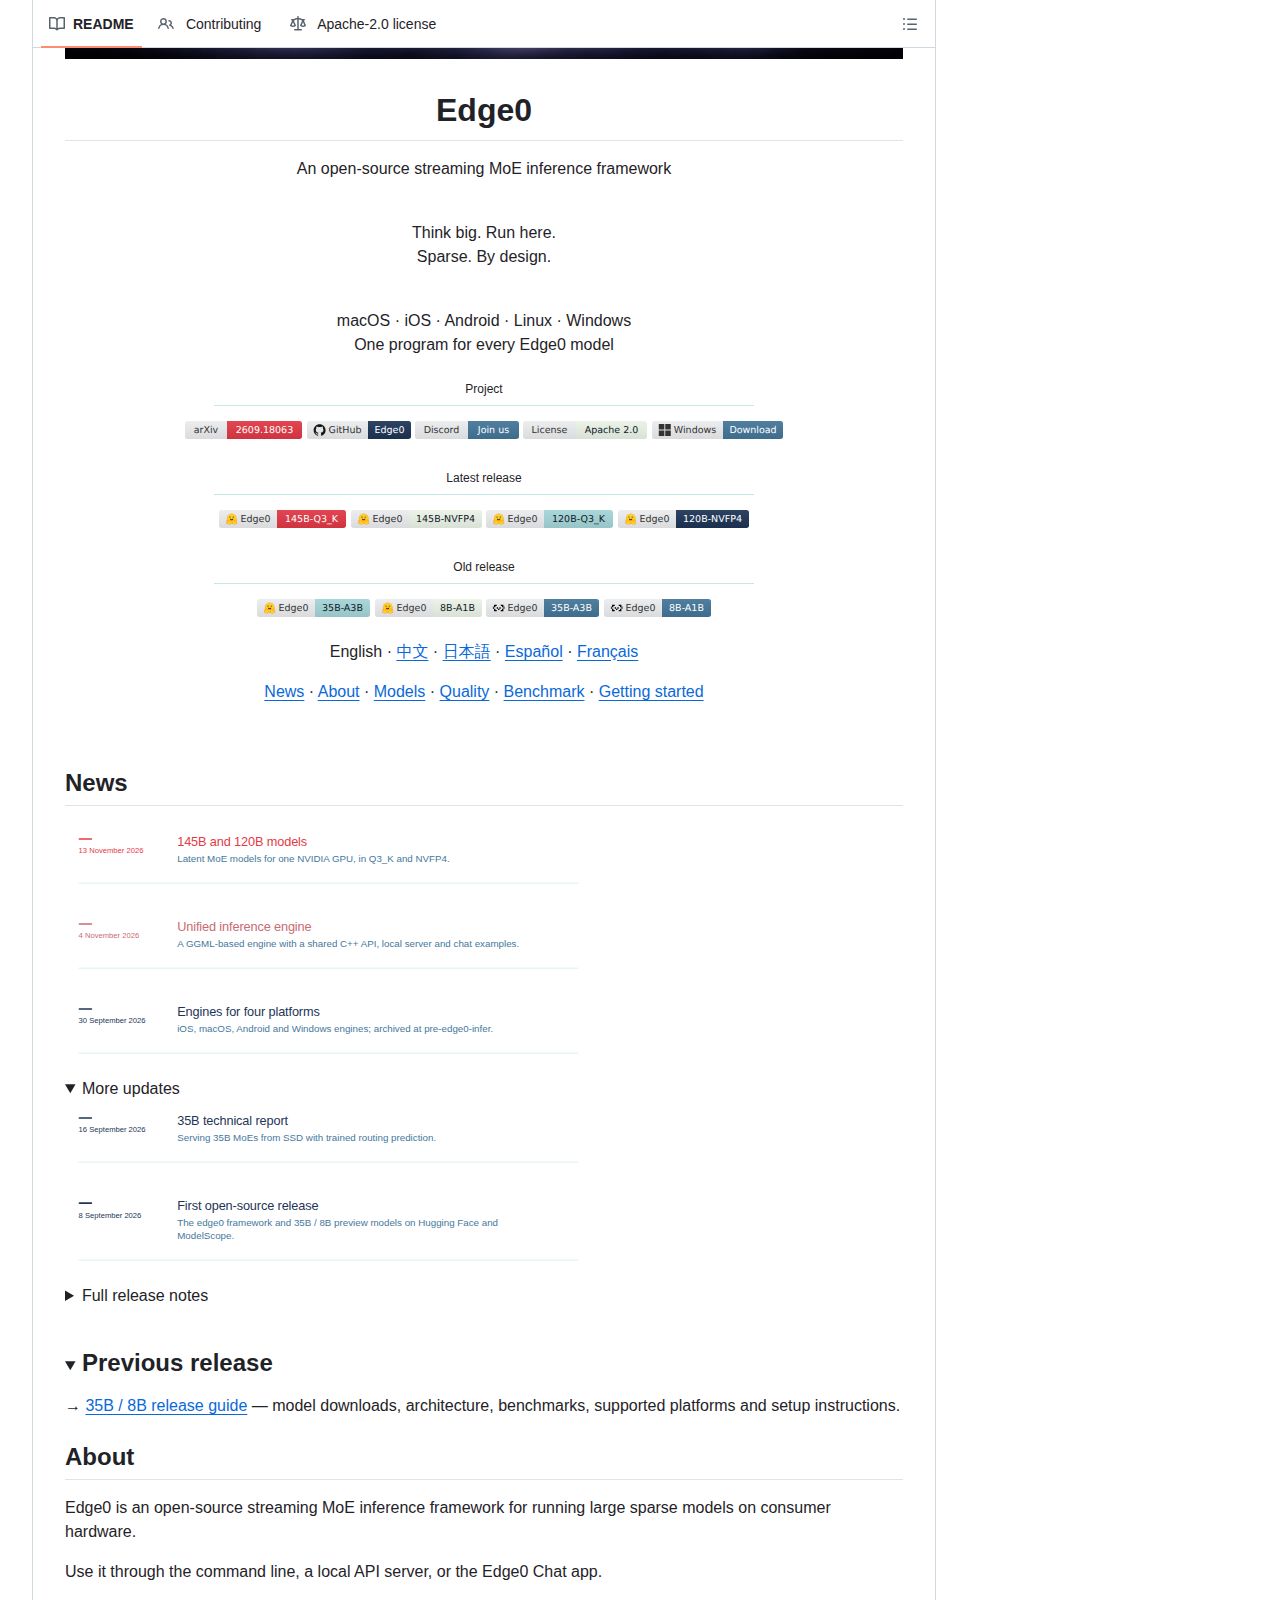
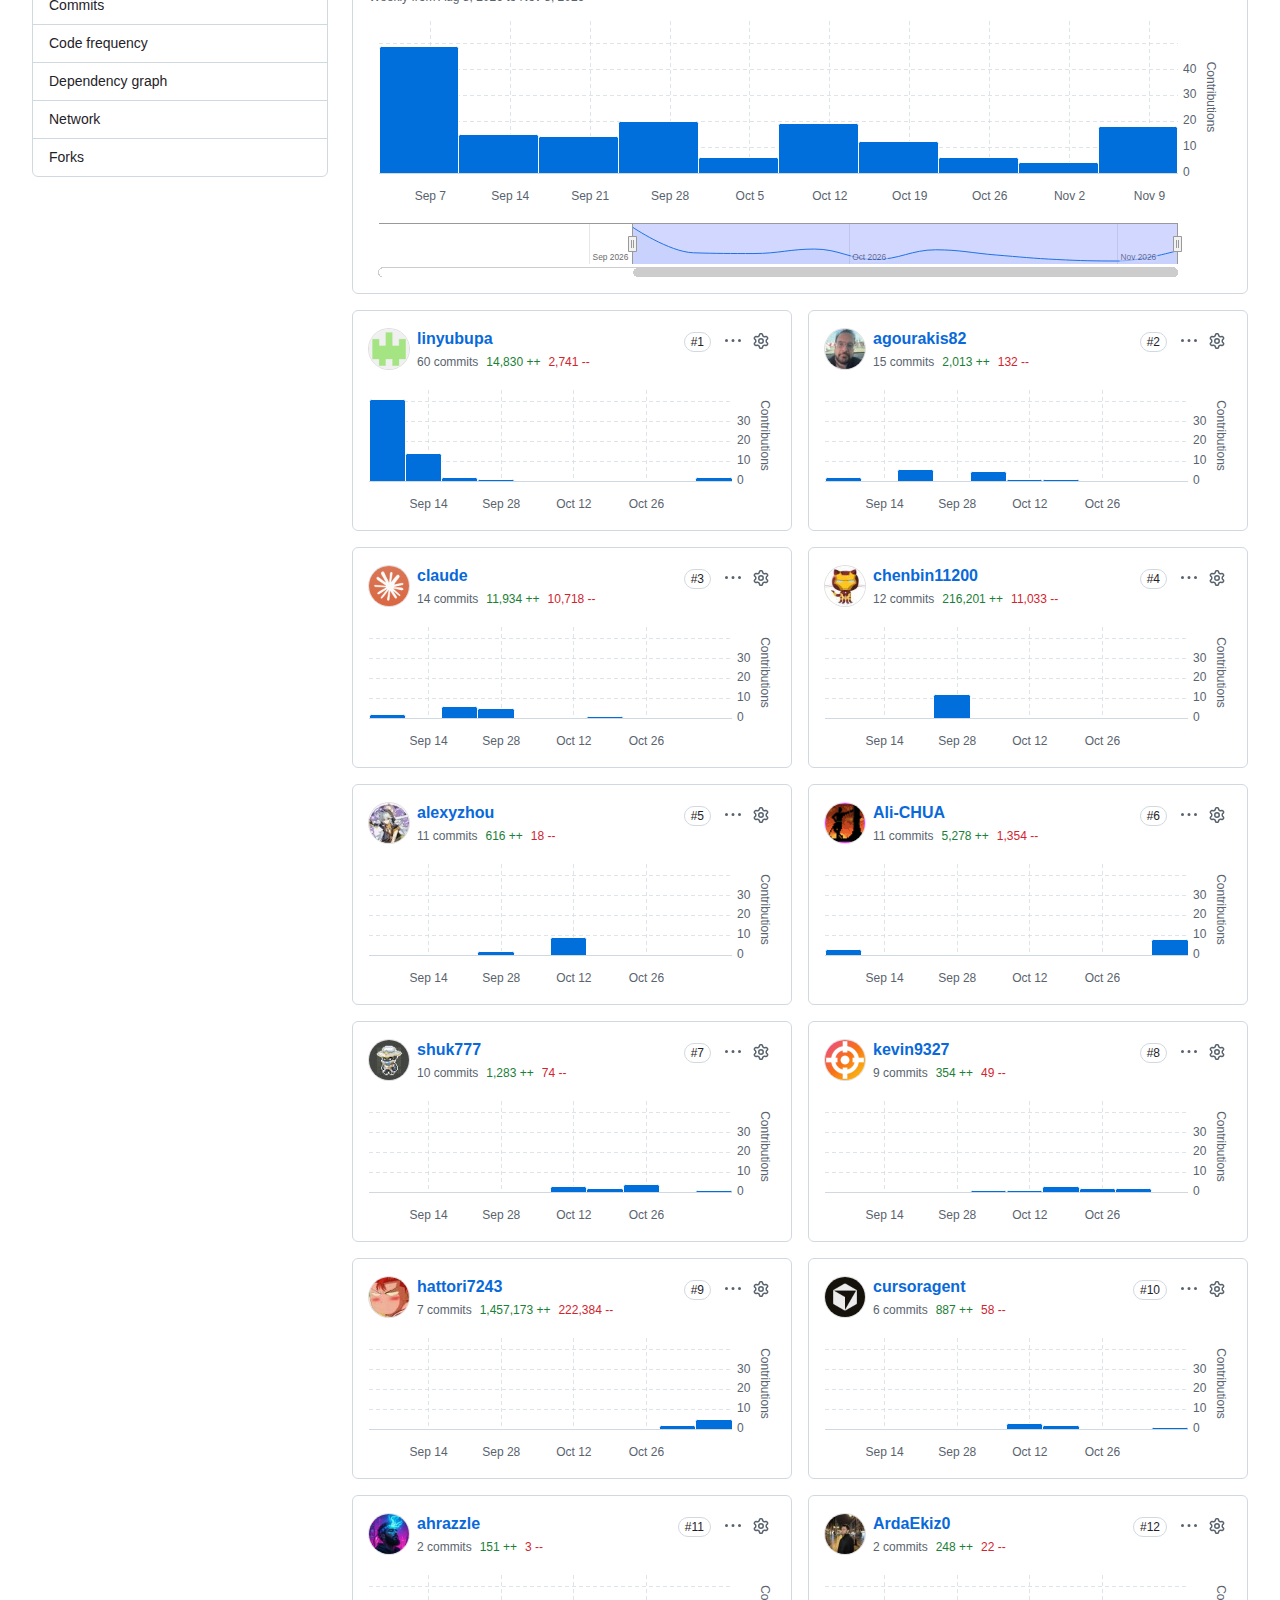
倉庫由 Edge0-AI 維護,內容包含推理引擎、模型文件與桌面應用程式三個部分。11 月 4 日釋出的 edge0-infer 以 GGML 為基礎,把命令列、OpenAI 相容的本機伺服器與聊天範例統一成一套 C++ 介面,取代原本的 Python 框架與逐平台引擎。
145B 模型如何在單張 24GB 顯示卡上運行?
關鍵在三層權重放置與專家共用矩陣。常駐專家留在顯示記憶體,專家庫放系統記憶體,詞彙資料留在 SSD 按需讀取,配合 CPU 與 GPU 分工壓低搬運量。
官方把設計拆成四個層次。架構層讓每組 64 個專家共用兩組大型矩陣,每個專家只保留少量差異參數,因此 145B 的總參數中每次推理約 10B 參與計算。訓練層直接以裝置架構為前提,避免先訓練雲端模型再壓縮的做法。
載入層把顯示記憶體、系統記憶體與 SSD 串成管線。常用專家留在 GPU,約 40GB 的專家庫放在系統記憶體,約 48GB 的詞彙資料留在 SSD 按需讀取。排程層由 GPU 處理已快取的專家、CPU 並行處理其餘工作,並以投機解碼一次驗證多個候選 token,把讀取權重的成本攤到更多輸出上。
權重體積仍是硬指標。Q3_K 版本佔 40.81 GiB,NVFP4 佔 47.79 GiB。在 16 GiB 顯示記憶體加 20 GiB 系統記憶體的測試條件下,同一張 RTX 5090 D 把 Q3_K 拆成 23.14 GiB 顯示記憶體與 31.28 GiB 系統記憶體,兩組專家集合互不重疊。
官方公布的效能數據如何?
RTX 5090 D 配 Q3_K 版錄得代理解碼 121.2 tok/s、16K 前置填充 3554.9 tok/s。RTX 4090 為 91.7,記憶體受限時降至 44.9。
所有吞吐數字以 tok/s 計,官方頭條採用 145B 的 Q3_K 版本。前置填充指處理輸入提示的速度,代理解碼指多回合工具調用時的生成速度,兩者在長流程下的差距會直接影響等待時間。
| 機器 | 版本 | 4K 前置 | 16K 前置 | 對話解碼 | 代理解碼 |
|---|---|---|---|---|---|
| RTX 5090 D 24GB | Q3_K | 2169.9 | 3554.9 | 99.7 | 121.2 |
| RTX 5090 D 24GB | NVFP4 | 1839.6 | 3165.7 | 79.6 | 98.3 |
| RTX 4090 24GB | Q3_K | 2042.0 | 3179.4 | 69.9 | 91.7 |
| RTX Spark N1X 60GiB | Q3_K | 674.0 | 770.3 | 37.7 | 36.7 |
| 16GiB VRAM + 20GiB RAM | Q3_K | 249 | 335 | 36.8 | 44.9 |
同一張 5090 D 在 NVFP4 版本反而較慢,官方數據顯示代理解碼由 121.2 降至 98.3。原因在於兩種量化格式的解碼路徑不同,較低的位元寬不等於較快的速度,選版本時要看實際工作負載而非只看壓縮率。
基準測試與雲端模型相差多少?
六項基準平均 72.8 分,高於 Qwen3.8-Flash-Next 的 71.7。DeepSWE 1.1 得 64.6,HLE 僅 35.4,通用推理仍落後於 Claude。
DeepSWE 1.1 得 64.6、Terminal-Bench 2.1 得 86.5,均高於同場雲端模型。GPQA-Diamond 90.4,HLE 僅 35.4 落後。
| 模型 | DeepSWE 1.1 | Terminal-Bench 2.1 | GPQA-Diamond | IFBench | HLE |
|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 90.4 | 80.6 | 35.4 |
| Edge0-120B | 51.3 | 75.3 | 87.4 | 79.3 | 31.0 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 91.7 | 81.3 | 35.9 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 90.8 | 79.2 | 33.8 |
| Claude-Opus-4.6 (Max) | 無公開分數 | 78.2 | 91.3 | 62.5 | 40.0 |
值得留意的是分數來源。Edge0、Qwen、DeepSeek 與 Claude 四組數字由 Edge0 自行評測,其中 Claude 沒有公開的 DeepSWE 1.1 成績,因此該列留空而非記零。Flint、Muse Glimmer 與 Gemma 4 的數據分別取自 Recursive Flint 評測與 Artificial Analysis,換算方式並不完全一致。
推論成本要一併看。官方把 145B 的 29GB 實測峰值與 Qwen3.8-Flash-Next 約 70GB 的 4 位元部署估算並列,得出約四成的記憶體佔用。這個比較對本地部署有意義,但估算值尚未實測,官方文件亦以星號標示。
如何在 Linux 或 Windows 上安裝並啟動?
先複製倉庫,再分別建置 edge0-strata 引擎與 edge0-infer。啟動時指向單一模型資料夾,載入後印出本機 8000 埠位址,並提供 OpenAI 相容端點。
建置分成兩步,兩個部分都要編譯。Linux 環境需要 CUDA 13,Windows 支援 x64 與 ARM64。
git clone https://github.com/Edge0-AI/Edge0.git edge0
build/cpu/bin/edge0-infer serve --model /path/to/Edge0-145B-q3k
載入完成後終端會印出 Listening 一行,其中模型名稱顯示為 edge0_145b。既有客戶端只要把 base URL 指向本機 8000 埠並改用該模型名稱,就能沿用原本的 OpenAI 介面。
curl localhost:8000/v1/chat/completions \
  -H 'content-type: application/json' \
  -d '{"model":"edge0_145b","messages":[{"role":"user","content":"hi"}],"max_tokens":64}'
若不想自行編譯,Windows 另有 Edge0 Chat 桌面應用程式,從 Releases 下載後直接選擇模型資料夾即可執行,離線狀態下核心功能仍可用。命令列模式則提供 chat 子命令開啟互動工作階段,適合在終端內連續測試提示詞。
這類本機服務的用法與其他執行期相近。llama.cpp 的伺服器同樣提供相容 OpenAI 的端點,客戶端只需改 base URL 與模型名稱。若要進一步壓縮記憶體佔用,Ollama 在近期版本改以 MLX 處理蘋果平台推理,顯示各執行期都在同一個方向上調整。
記憶體不足時有哪些調整參數?
五個旗標控制容量。vram-reserve-mib 保留顯示記憶體給桌面,expert-cache 決定常駐專家數,mmap-experts 改為全部按需讀取。
這些旗標寫在模型包的 model.json 內,分為 args 與 env 兩組,改一次就套用到每次啟動,不必每次在命令列重複。–vram-reserve-mib 預設 700,用於保留驅動與其他程式所需的顯示記憶體,引擎再從剩餘空間規劃快取。
–expert-cache 設為 auto 時,會依扣除固定開銷後的空閒顯示記憶體推算專家槽位。–kv-resident 控制每層留在顯示記憶體的 KV 單元數,其餘從鎖定的系統記憶體串流,這個設定換取的是專家可用的顯示記憶體。–spec 調整投機解碼的驗證視窗,預設 4,視窗越大需要越大的驗證緩衝區。
系統記憶體吃緊時,–mmap-experts 讓專家直接從包檔讀取,不在記憶體常駐,代價是速度下降。–resident-budget-gib 則限制系統記憶體專家快取的上限,並會依可用記憶體再收窄,使用時必須搭配靜態的專家設定檔。
與 9 月的手機版 Edge0-35B 有什麼差別?
35B 走原生引擎,支援 macOS、iOS 與 Android;145B 與 120B 走 edge0-strata,只支援 Linux 或 Windows 配 NVIDIA 顯示卡。
9 月 8 日首發的 35B 版本在 iPhone 18 Pro Max 上以約 2.5GB 記憶體達到 37 tok/s,把討論從數十億參數推向 350 億級別。11 月 4 日的 edge0-infer 進一步把命令列、本機伺服器與聊天範例收攏到同一套 C++ 介面,取代原本的 Python 框架。
145B 系列沒有跟上這份平台清單。倉庫的平台表把 145B 與 120B 標為 Linux 或 Windows 配 CUDA 13,35B 才涵蓋 macOS 的 Metal 與 CPU、iOS 的 Metal 及 Android 的 CPU。蘋果 M2 Ultra 的 57 tok/s 屬於量測數據,文件明確說明不構成 macOS 發佈承諾。
官方說法與倉庫文件有何不一致?
部落格以筆記本與 29GB 峰值描述,倉庫平台表只列 Linux 或 Windows 配 NVIDIA 顯示卡。採購前應以倉庫文件為準。
這是本地部署最常踩的一環。部落格示範提到 MacBook Pro 與 128K 至 256K 上下文,倉庫的建置說明則要求 CUDA 13 環境。兩種說法並非互相矛盾,而是描述不同層面:前者談模型能力上限,後者談目前的發佈狀態。
29GB 峰值與 40.81 GiB 權重兩個數字並列時亦容易誤讀。前者是特定硬體設定的實測峰值,後者是權重檔案本身的大小,測量對象不同。若團隊以蘋果筆記本為主要設備,現階段可行的組合是 35B 系列,145B 需要另備 NVIDIA 機器。
哪些團隊適合本地部署?
需要把程式碼與設計檔留在本機、且已有 24GB 顯示卡的團隊最適合。純雲端使用者若沒有資料外流顧慮,改用 API 的維護負擔與總成本通常更低。
本地推理省下的是 token 費用與網路往返,硬體與電力仍要計入。官方示範涵蓋 Blender 場景建構、遊戲關卡設計、無人機控制程式與電路板佈局,共同點是回合數多、需要視覺檢查。這類長流程按次計費時成本容易放大,改在本機執行則只受硬體限制。
反過來說,跨裝置長期記憶與需要即時資訊的查詢仍依賴雲端。官方文件把分工描述成三個階段:雲端優先、日常本機、複雜工作本機,並未主張全面取代。用耳機廠商的混合方案為例,92% 的 AI 用量在本機完成,其餘 8% 才送到雲端。
出處連結有哪些?
權重放在 Hugging Face 的 Edge0 組織,推理框架在 GitHub 的 Edge0-AI/Edge0 倉庫,官方部落格另有完整基準表。
權重分為 Edge0-145B-q3k 與 Edge0-145B-NVFP4 兩個版本,120B 同樣提供兩種量化格式。推理框架與建置說明位於 github.com/Edge0-AI/Edge0,模型細節見倉庫內的 145B 模型頁。
官方部落格文章 Introducing Edge0-145B 提供完整的硬體說明與示範案例。技術報告 The Other Half of the Memory Wall 說明了從 SSD 供應專家權重的路由預測方法。
總結:Edge0-145B 適合什麼情況?
在單張消費級顯示卡上執行 145B 級代理模型的門檻被拉低,編程與終端任務的分數已接近雲端中階模型。平台限制與自行評測兩點,是現階段評估時的主要變數。
真正的進展在資料搬運的處理方式,而非單純的參數堆疊。把專家拆到顯示記憶體、系統記憶體與 SSD 三層,再以投機解碼攤薄讀取成本,讓 24GB 的消費級顯示卡得以承載 145B 規模的模型,這條路徑對後續的本地部署方案有參考價值。
限制同樣清楚。平台仍鎖在 NVIDIA 與 CUDA 13,蘋果設備只能靠 35B 系列,而六項基準的分數由廠商自行評測。實際採用前值得先用自身工作流程跑一輪,特別是長上下文的代理任務,再判斷省下的費用是否足以抵銷硬體與調校成本。
