Ollama(ollama/ollama)是 Go 語言撰寫的開源本地模型執行環境,於 2026 年 9 月 25 日發布 v0.40.0,其後在三星期的時間內連續推出六個補丁版本至 v0.40.6,並在 10 月 18 日釋出 v0.40.7 的候選版。專案目前在 GitHub 累積 183,872 顆星標與 18,416 次複製,採 MIT 授權,自 2023 年 6 月建立以來已有約 627 位貢獻者。新聞價值在於這一輪改動的共同方向:過去的版本更新多數圍繞模型支援清單,0.40 系列則把資源投放到執行期本身,包括推論後端選擇、模型格式遷移、終端機互動模式與雲端額度管理。
Ollama 是什麼?
Ollama 是以 Go 撰寫、採 MIT 授權的開源本地模型執行環境,提供單一指令下載與執行模型、本機 REST API 與官方函式庫,並可把本地模型接入編程代理。
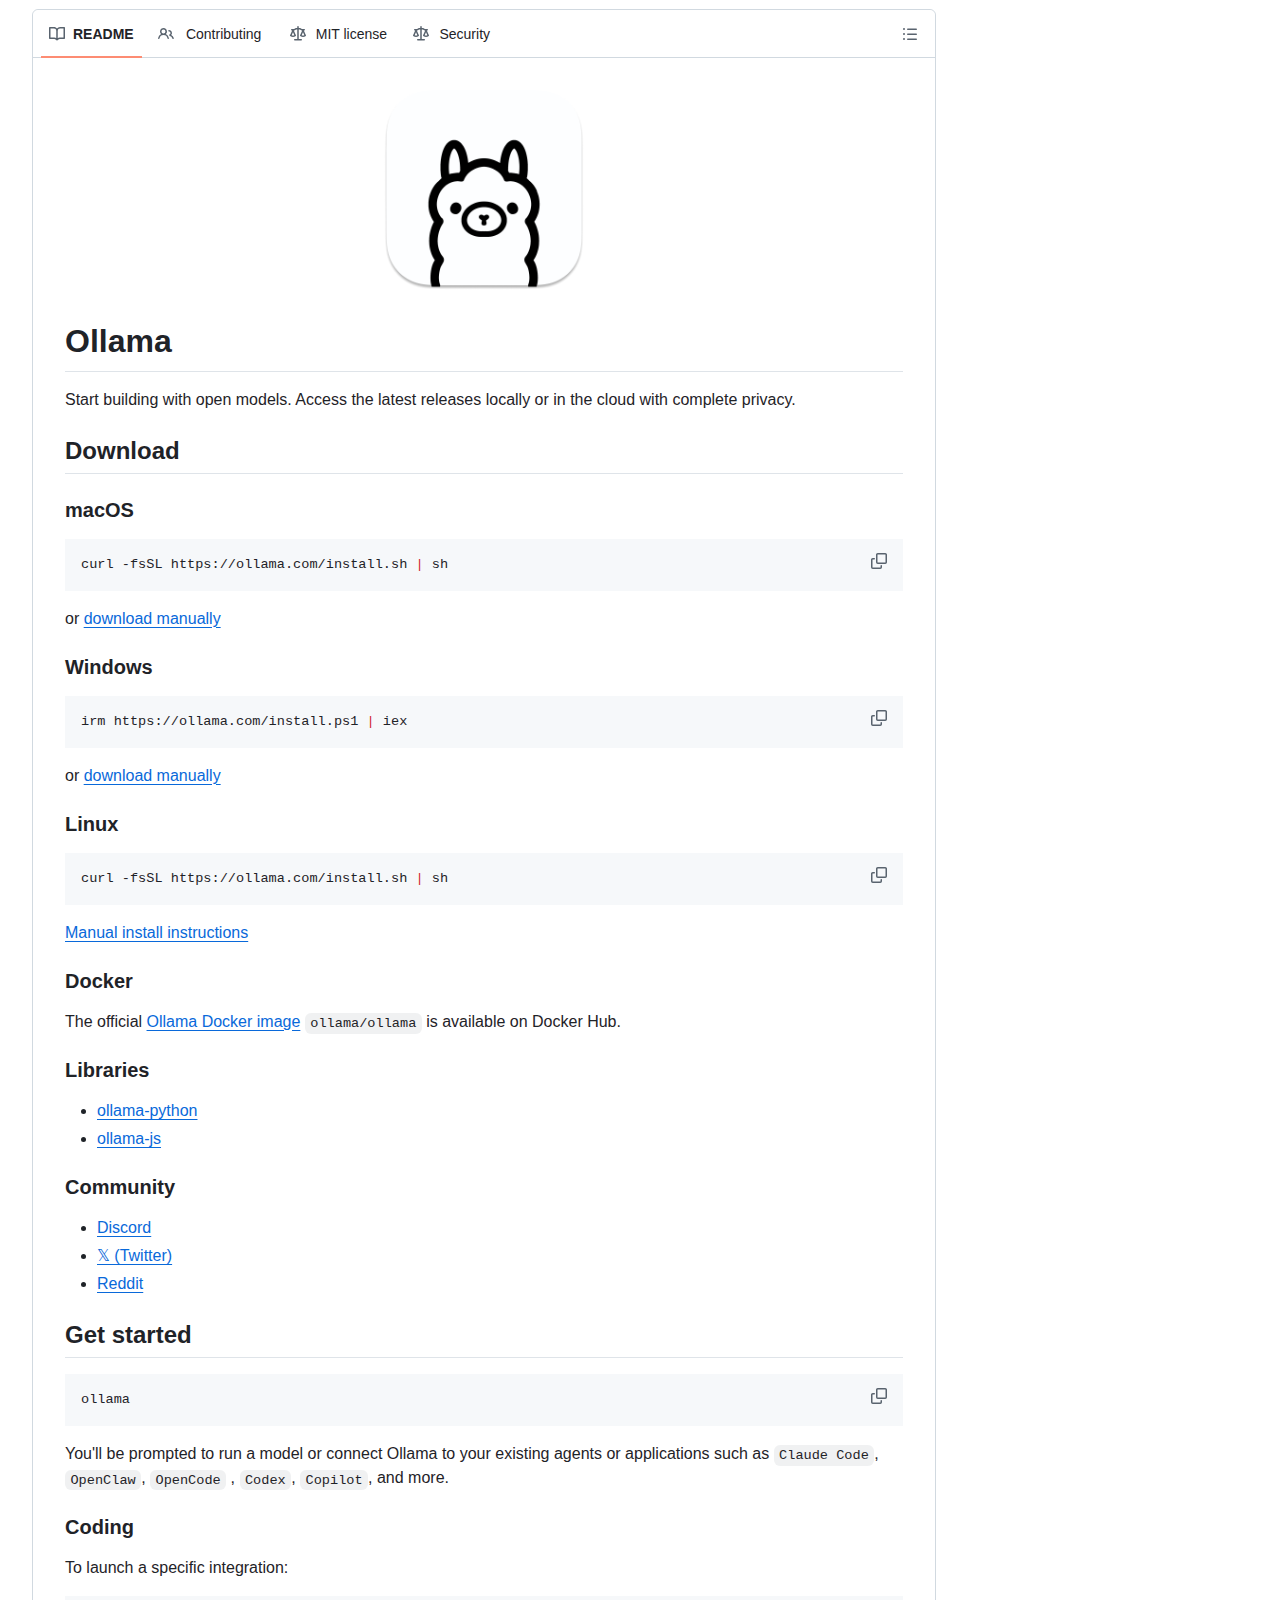
專案的 README 開宗明義寫著「在本機或雲端取用最新開源模型,並保有完整隱私」。安裝方式維持一貫的單行指令:macOS 與 Linux 使用 curl -fsSL https://ollama.com/install.sh | sh,Windows 使用 PowerShell 的 irm https://ollama.com/install.ps1 | iex,另提供 ollama/ollama 的 Docker 映像。啟動後服務監聽 11434 連接埠,以 /api/chat 等端點對外提供服務,請求格式與串流行為沿用既有設計,既有客戶端不需要改寫。
模型庫的描述已從早期的 Llama、Mistral 擴展到 Kimi、GLM、MiniMax、DeepSeek、gpt-oss、Qwen 與 Gemma 等亞洲與美系廠商的作品。這個清單的變化反映社群的實際流向:本地部署的需求已不再由單一開源模型驅動,而是隨著各家模型釋出節奏移動,執行環境能否在模型發布當日提供支援,成為使用者留存的關鍵。
編程代理的整合是近一年增長最快的部分。README 列出 ollama launch 可啟動的對象,包括 Claude Code、Codex、Copilot CLI、DeepSeek Harness、Droid 與 OpenCode,另有 ollama launch openclaw 用於把本地模型接上訊息平台形式的個人助理。這些整合的角色是把本地模型包裝成代理可呼叫的推論端點,讓原本綁定雲端 API 的工具改為指向本機。
生態方面,README 的社群整合清單已達數十項,涵蓋 Open WebUI、Onyx、LibreChat、Lobe Chat、NextChat、Perplexica、Dify.AI、AnythingLLM 等介面與平台。這份清單的長度構成實質的網路效應:使用者選擇執行環境時,往往先看自己慣用的前端是否支援。
v0.40 系列最重要的改動是什麼?
0.40 系列在 Apple Silicon 預設改用 MLX,導入背景升級與降級備份,終端加入決策模型,並支援 Nemotron 3.5 Super。
六個版本的時間軸密集得異常。v0.40.0 於 9 月 25 日發布,v0.40.1 在 10 月 7 日跟進,v0.40.2 在 10 月 8 日,v0.40.3 在 10 月 11 日,v0.40.4 在 10 月 12 日,v0.40.5 在 10 月 14 日,v0.40.6 在 10 月 16 日,v0.40.7 的候選版則在 10 月 18 日。這種節奏說明團隊在處理一項跨版本的重構:把模型執行從單一後端擴展為多後端,並讓舊模型資產平順遷移。
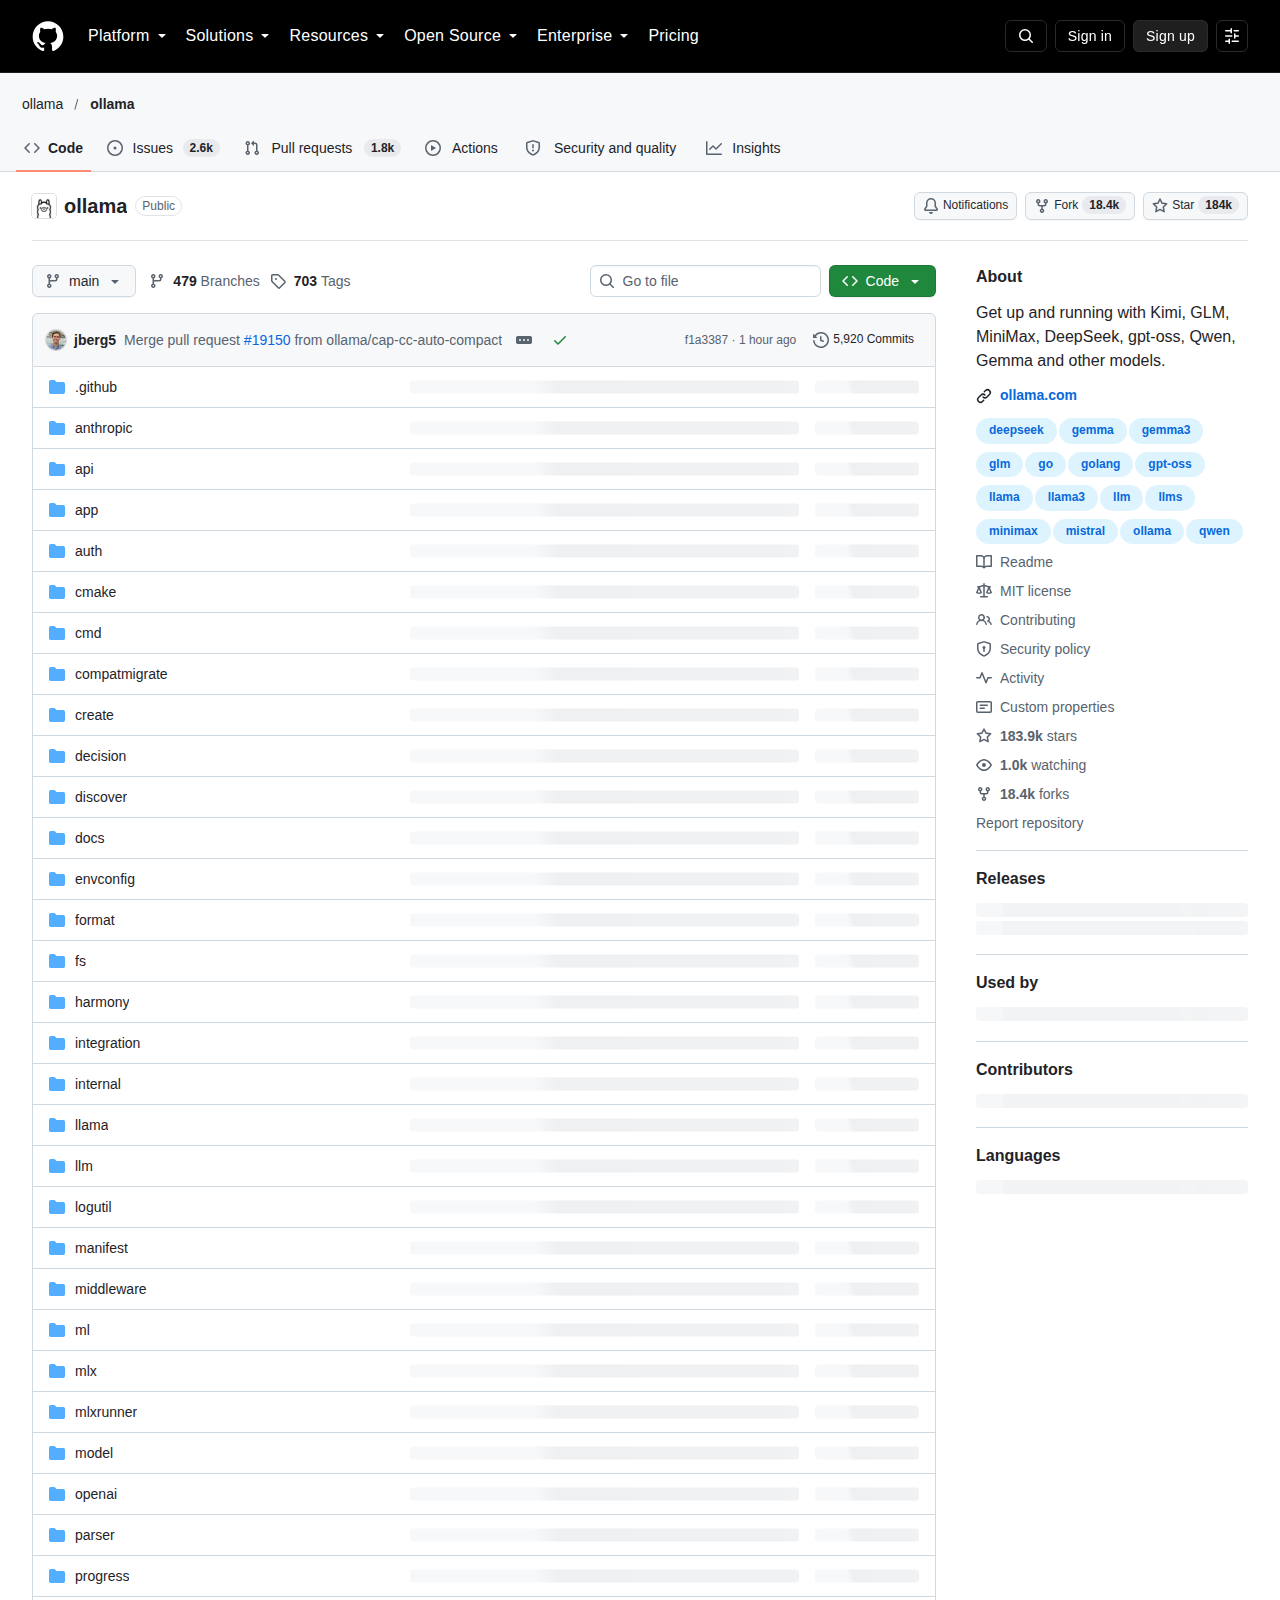
從改動的性質分類,0.40 系列可以拆成四條線。第一條是推論後端,Apple Silicon 的預設從自帶的 ggml 路徑轉向 MLX。第二條是資產治理,舊版下載的模型在首次執行時背景升級,並保留原始副本。第三條是互動模式,終端機新增以 --ask 提問的決策模型用法。第四條是雲端與本地的界線,雲端額度、餘額與錯誤訊息都納入同一套介面。
為什麼 Apple Silicon 預設改用 MLX?
MLX 由 Apple 針對自家晶片設計,在統一記憶體架構上頻寬利用較佳;0.40.0 起,受支援的模型架構在 Apple Silicon 自動改用 MLX,無需手動切換。
v0.40.0 的發布說明寫得直接:在 Apple Silicon 裝置上,MLX 執行環境支援的模型架構會自動以 MLX 執行。支援的模型包括 gemma4、qwen3.6 與 qwen3.5,決策模型 nimble、tev1、clef 與 clef-flash 亦已可用,嵌入模型 embeddinggemma-2 同樣納入支援範圍。官方表示會持續測試並啟用更多模型。
後續版本補完了這條路線的細節。v0.40.1 移除了原本自行攜帶的 Metal residency 修補,理由是相關改動已進入上游;這一步通常意味著該路徑的穩定性已達可依賴的程度。v0.40.4 改善 MLX 執行環境的推測解碼可靠性,包括回滾後的遞迴狀態處理,並把先前會直接拒絕的超長狀態改為截斷處理,減少長上下文下的中斷。同一個版本也改善了 NVIDIA GPU 上 Gemma 4 的預填充效能。
對使用者的實際影響是安裝後的預設行為改變。過去在 Mac 上需要透過環境變數或設定檔切換後端,現在由執行環境自行判斷模型架構是否受支援。好處是省去調校步驟,代價是同一台機器上不同模型可能走不同後端,除錯時需要先確認模型實際使用的執行環境,而非假設全部一致。
背景模型升級機制如何運作?
自 v0.40.2 起,舊版下載的模型在首次執行時會於背景升級至新格式,以取得較佳效能與相容性;原始副本保留為備份,佔用的磁碟空間需手動清除。
這項設計處理的是一個長期存在的斷層。模型檔案格式隨執行環境演進,舊格式在 llama.cpp 上仍可載入,但效能與相容性落後;若強制使用者重新下載,動輒數十 GB 的傳輸成本會讓人卻步。Ollama 的折衷方案是在首次執行時就地升級,並把原檔留作降級備份。
備份不會自動消失。發布說明明言未來版本才會自動清除,目前需要手動處理。官方提供一段以 jq 為前提的指令,透過本機 API 列出模型清單,篩選出同時存在新舊執行環境清單的項目,再取出舊格式的摘要值去重後刪除:
curl -s localhost:11434/api/tags | jq -r '.models[].name' | while read -r m; do
  curl -s localhost:11434/api/show -d "{\"model\":\"$m\"}" | jq -r \
    'select(any(.manifests[]?; .runner == "llamacpp")) | .manifests[] | select(.runner == "ggml") | .digest'
done | sort -u | xargs -n1 ollama rm
指令只刪除備份,不動現行版本。風險在於降級路徑:若日後回到 0.40 之前的版本,被清除的舊模型需要重新下載。對於在邊緣裝置或頻寬受限環境部署的團隊,這個取捨需要事先盤算,而不是等到磁碟告急才處理。
v0.40.3 另外暫停了針對嵌入模型與其他請求效能的背景升級。這道修正顯示背景升級並非無痛:升級動作會佔用 I/O 與記憶體,在低規格機器上可能與正在進行的推論互相干擾。暫停的範圍限於特定類型,說明團隊把它視為需要按情境控管的機制。
Decision models 是什麼?
決策模型是針對是與否判斷、文字分類與評分管設計的小型模型;自 v0.40.4 起可用 ollama run 配合 --ask 於終端提問,並可從標準輸入讀取內容。
發布說明給出的範例把用途講得清楚:把客服信件導向判斷是否為退款請求。指令形式為 ollama run nimble --ask "Is a refund being requested?" < ticket.txt,模型輸出極短的回覆,不需要生成段落。這種模式適合放在自動化流程的前段,用最低成本完成分流,再決定是否升級給大型模型處理。
v0.40.6 為 --ask 模式的問題鍵改用具識別性的名稱,讓多題組合的輸出可以被穩定解析。這項調整看似細微,實際上決定它能否作為程式介面使用:若輸出鍵依位置而定,流程重排就會壞掉。
雲端版本在 v0.40.5 上線,clef:cloud 與 clef-flash:cloud 可在不下載模型的情況下透過 ollama.com 執行。本地與雲端並存的設計,讓同一組指令在筆記型電腦與伺服器上行為一致,部署時只需切換模型名稱。
Nemotron 3.5 Super 帶來什麼能力?
Nemotron 3.5 Super 是 120B 參數的專家混合模型,每 token 啟用 12B,支援工具呼叫與百萬 token 上下文。
NVIDIA 這款模型在 v0.40.5 加入模型庫,定位涵蓋編程、推理、工具使用與文件理解。混合架構的意義在於長序列的記憶體佔用:Mamba-2 的狀態空間層讓上下文拉長時的成長曲線較平緩,這是它能宣告百萬 token 上限的基礎。視覺編碼器採用 C-RADIO,代表它同時接受圖像輸入。
同系列另有 Nemotron 3.5 Bolt,把 Super 蒸餾至 74B 參數、每 token 啟用 9B,官方明確標示調校目標是塞進 24 GB 顯示記憶體,並附帶草稿模型以支援推測解碼。這個規格對消費級顯示卡使用者更具現實意義,也解釋了為何 v0.40.4 要優先改善推測解碼在 MLX 上的可靠性。
v0.40.6 在 GGUF 格式加入 q2_0 張量與檔案類型。二位元量化通常用於極端壓縮場景,精度損失明顯,但對於把大型模型放進有限記憶體的需求仍然有效。這項改動屬底層支援,短期不會出現在使用者的操作介面,卻決定了後續模型能否以更低門檻在本地執行。
本地與雲端如何分工?
0.40 系列把雲端模型、用量與餘額 API 納入同一套介面,本地與雲端可用同一組指令切換;ollama launch 在未升級付費方案時亦可用既有額度運作。
v0.40.1 在伺服器端代理雲端用量與餘額查詢,讓用戶端不必各自實作計費邏輯。v0.40.4 允許 ollama launch 在使用額度而非付費方案的情況下運作,降低了把本地模型接上編程代理的門檻。v0.40.5 改善雲端存取失敗時的訊息,把登入問題、桌面應用的付款問題與 ChatGPT 閘道的上游錯誤分開說明。
這些改動共同指向一個混合模型:常駐、敏感的推論留在本機,突發或需要大模型能力的請求走雲端,兩者由同一個命令列工具調度。README 的措辭亦隨之調整,把隱私與雲端服務的界線寫得更明確,避免使用者誤以為所有請求都留在本機。
值得留意的是 ollama launch codex 在 v0.40.4 起會把本機已安裝的模型納入模型選擇器,並可用 /model 在 Codex CLI 內切換。這代表本地與雲端的界線在代理層被進一步模糊:同一個對話可以在不同執行環境之間轉移,而使用者只需要選擇模型名稱。
專案目前的規模數據如何?
儲存庫累積 183,872 顆星標、18,416 次複製與約 627 位貢獻者,主要語言為 Go,採 MIT 授權,待處理議題 4,363 個。
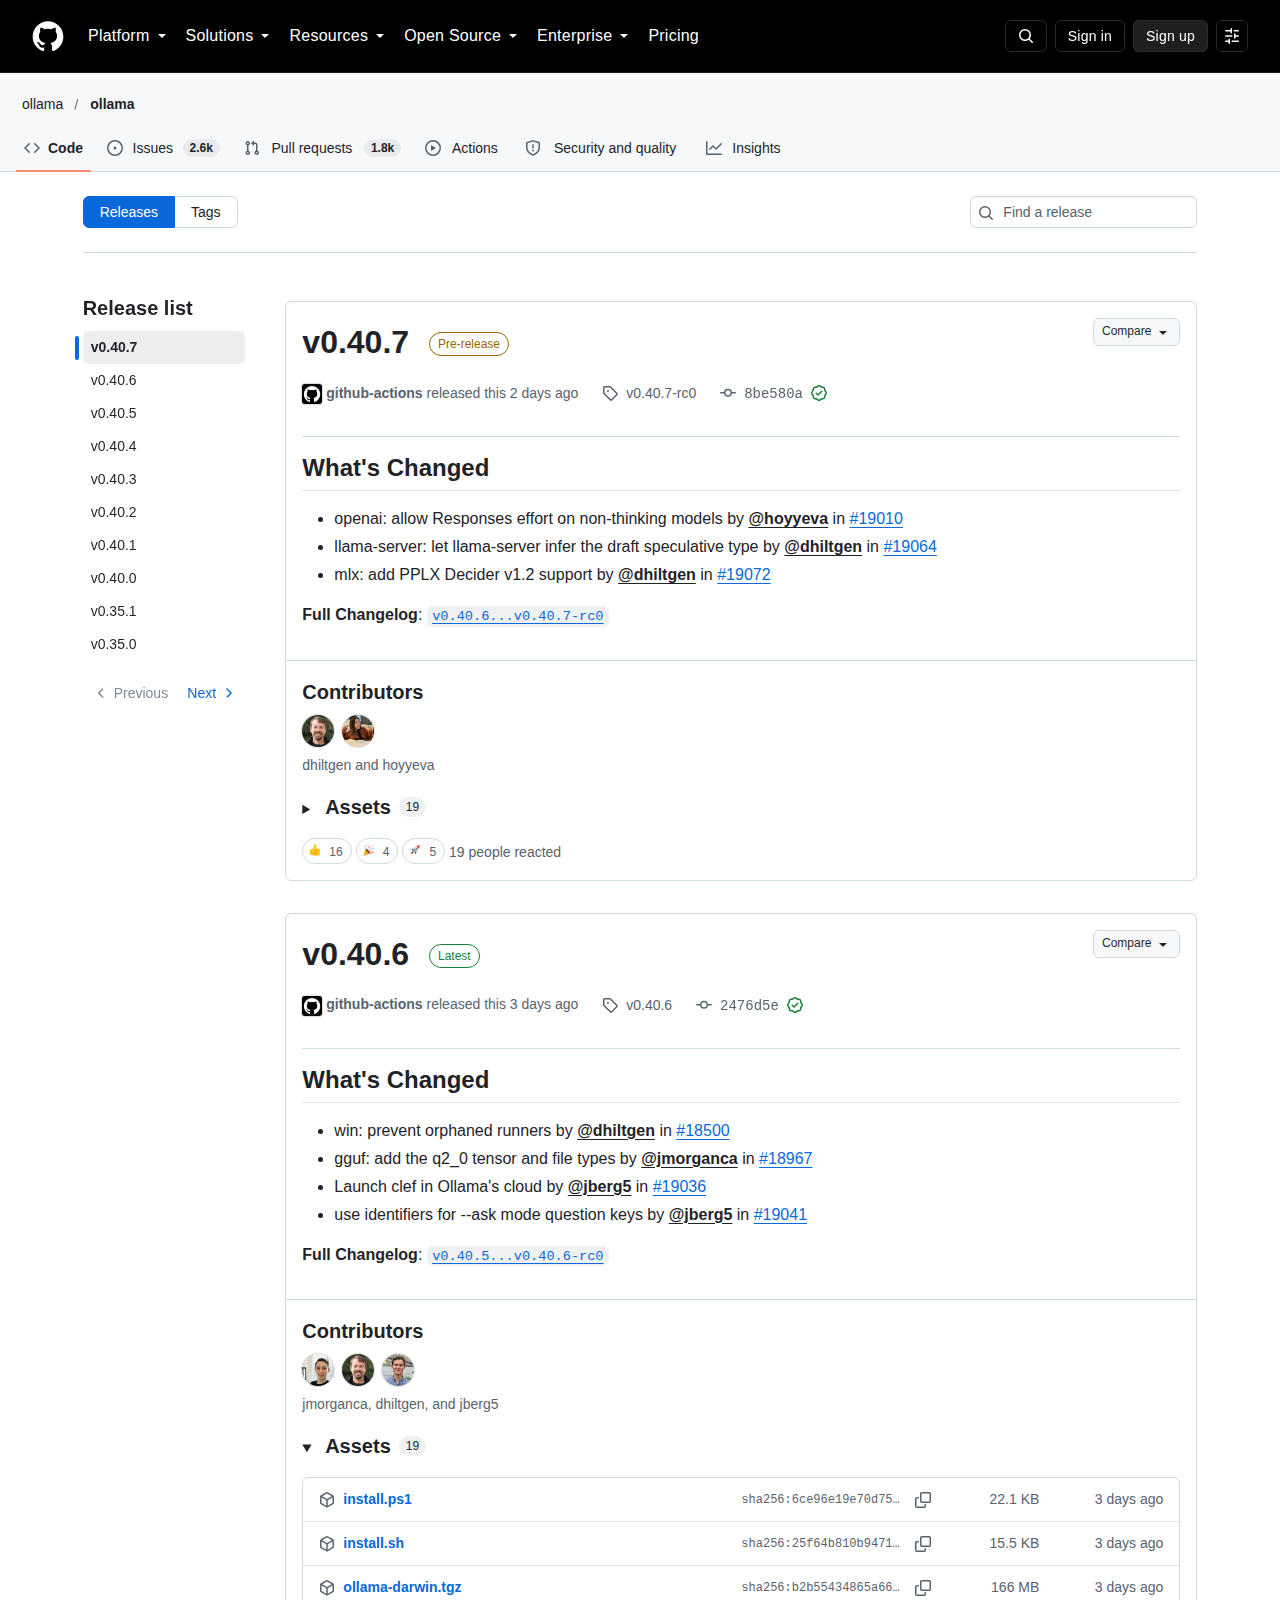
星標與複製的比例約為十比一,在開發工具類專案中屬於偏低的比例,通常反映使用者以「安裝使用」為主,較少直接分叉修改原始碼。相對於代理框架常見的四比一或五比一,這個差距說明 Ollama 的定位更接近基礎設施:使用者把它當成執行環境,而不是二次開發的起點。
待處理議題 4,363 個對照十八萬顆星標並不算高。以每日多次推送、跨平台建置的專案而言,這個數字顯示維護團隊的清理節奏跟得上議題流入速度。貢獻者約 627 位,其中相當比例集中在小幅度的文件修正與社群整合清單補充,從 v0.40.1 至 v0.40.6 的發布說明可見多位首次貢獻者,多數對應單一文件或平台修正。
升級前應注意什麼?
先確認磁碟餘裕、備份清除後降級需重新下載、Windows 的符號連結與行程管理已有修正、候選版不宜用於生產,並留意舊顯示卡在新後端下的表現。
磁碟是首要變數。背景升級會在新格式之外保留原檔,若模型庫累積多個大型模型,可用空間可能在同一日內顯著下降。建議在升級前執行一次容量檢查,並把備份清除指令納入維護腳本,而不是等到系統提示空間不足。
降級條件需要事先確認。一旦清除備份,回到 0.40 之前版本時相關模型必須重新下載;若團隊有版本回退的流程要求,應保留備份至確認新版穩定之後。這與一般軟體回退的直覺不同,值得寫進內部文件。
平台細節同樣值得留意。v0.40.1 修正 Windows 上清單檔的符號連結問題,v0.40.6 防止 Windows 產生孤兒 runner 行程,兩項都指向同一類故障:行程或檔案在異常結束後殘留,導致後續啟動失敗。若曾在 Windows 上遇過模型載入卡住,升級後值得重新測試。
後端切換的驗證方式亦需調整。由於 Apple Silicon 現在會依模型架構自動選擇 MLX,遇到效能不如預期時,第一步應確認模型實際使用的執行環境,其次才是調整參數量或上下文長度。把這個檢查寫進排查清單,可以省下不少誤判。
最後是版本選擇。v0.40.7 目前僅有候選版,發布說明對應的穩定版尚未推出。生產環境宜停留在 v0.40.6,候選版留給需要提前驗證相容性的場景。
出處連結有哪些?
主要出處為 GitHub 儲存庫 ollama/ollama,含 v0.40.0 至 v0.40.6 的發布說明、README 的整合清單與官方文件站的 API 與命令列參考。
本文數據取自專案公開資料,包括儲存庫統計、各版本發布說明與 README 的技術描述。讀者如需核對個別細節,可依下列連結前往原始來源。
- 儲存庫:https://github.com/ollama/ollama
- v0.40.0 發布說明:https://github.com/ollama/ollama/releases/tag/v0.40.0
- v0.40.2 發布說明:https://github.com/ollama/ollama/releases/tag/v0.40.2
- v0.40.4 發布說明:https://github.com/ollama/ollama/releases/tag/v0.40.4
- v0.40.5 發布說明:https://github.com/ollama/ollama/releases/tag/v0.40.5
- v0.40.6 發布說明:https://github.com/ollama/ollama/releases/tag/v0.40.6
- 命令列參考:https://docs.ollama.com/cli
- API 參考:https://docs.ollama.com/api
總結:哪些使用者適合升級到 0.40?
在 Apple Silicon 上執行本地模型、需把決策模型放進自動化流程、或計劃測試百萬 token 上下文的團隊最適合;磁碟緊張者宜先評估。
0.40 系列的意義不在單一功能,而在它把本地推論工具從「下載並執行」推進到「管理執行期」。後端選擇自動化、模型資產可遷移並可回退、終端機支援輕量判斷任務、雲端與本地共用同一套介面,這四項合起來構成一個較完整的運行環境,而不只是模型啟動器。
代價是複雜度轉移到使用者身上。背景升級佔用磁碟、備份需要手動清理、自動選擇後端讓除錯多一層、候選版與穩定版需要分辨,這些都是為了換取跨平台一致性所付的學費。對於把本地模型當成長期基礎設施的團隊,這些維護動作可以腳本化,成本可控;對於偶爾試用單一模型的使用者,先停留在目前可運作的版本,等 0.41 或穩定版沈澱後再升級,同樣是合理選擇。
