AI Job Search(MadsLorentzen/ai-job-search)是 GitHub 上累積 56,163 顆星標的開源求職框架,以 Claude Code 作為執行底座,把求職流程拆解為職缺搜尋、契合度評分、履歷與求職信起草、PDF 版面驗證與申請者追蹤系統(ATS)文字層檢查等環節。該專案於 2026 年 3 月建立,至 10 月中旬已累積 17,927 次複製與 78 位貢獻者,並在 9 月 29 日發布 v1.7.2 版。其新聞價值不僅在於星標數量,而在於它把「投遞申請」這件被視為純人力工作的事,重構成一套可驗證、可重複、可審計的工程流程。
AI Job Search 是什麼?
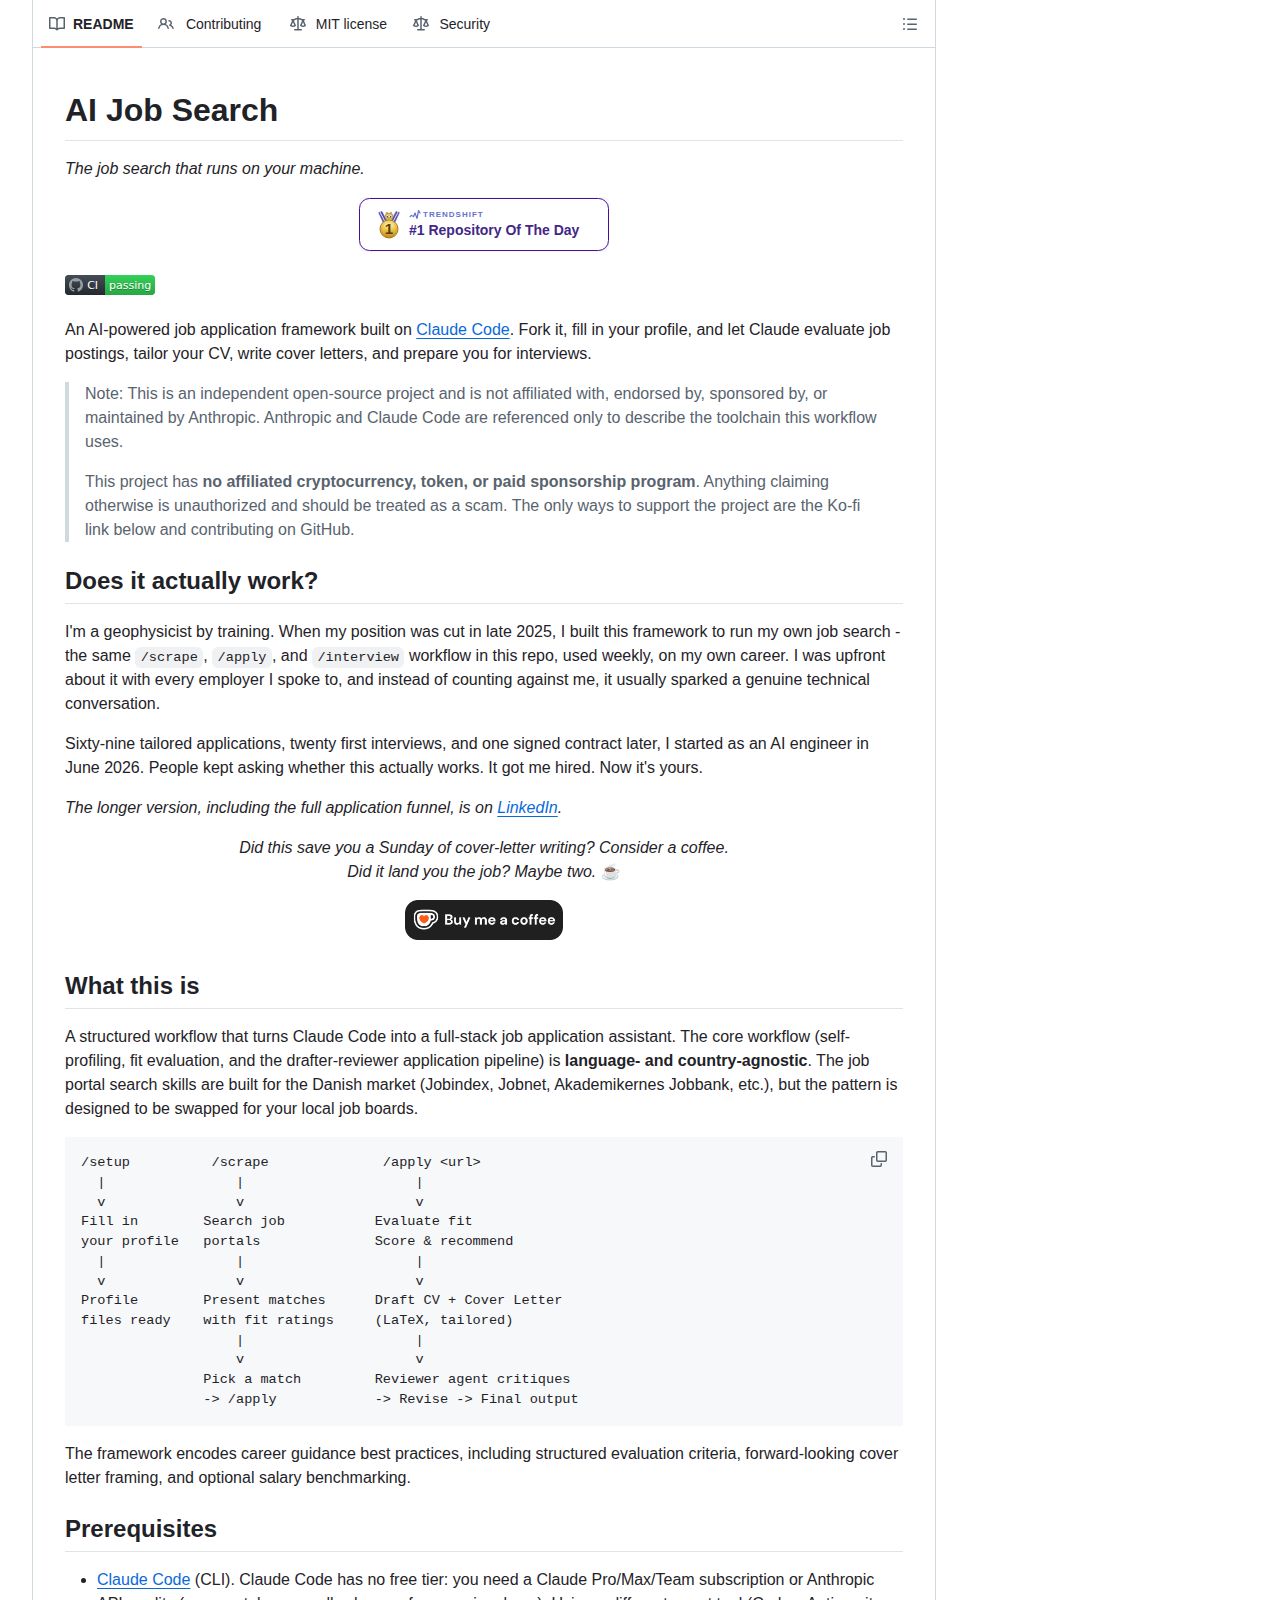
AI Job Search 是一套以 Claude Code 為底座的開源求職框架,把職缺搜尋、契合度評分、履歷與求職信起草、PDF 驗證與申請追蹤串成固定流程。
該專案由丹麥開發者 Mads Lorentzen 建立,定位為「在自己機器上執行的求職流程」。使用者複製儲存庫後填入個人檔案,之後以斜線命令驅動整個流程:/setup 建立個人資料、/scrape 搜尋職缺入口網站、/apply 對單一職缺產出客製履歷與求職信。框架以 Markdown 檔案作為設定與知識庫,以 LaTeX 作為輸出格式,並以 Python 工具鏈負責驗證與狀態維護。
專案的說明文件明確標示與 Anthropic 無隸屬關係,同時警告市面上並無任何官方代幣、加密貨幣或付費贊助計畫,任何聲稱者應視為詐騙。這種主動切割的寫法,反映開源專案在星標快速累積後常見的冒名風險。
AI Job Search 解決了求職流程中的什麼問題?
它針對的是申請品質與驗證缺口:多數求職者只修改履歷文字,卻忽略職缺契合度、LaTeX 版面斷頁與 ATS 文字層解析,該框架把這些環節改為可自動檢查的步驟。
作者的實際經歷構成專案的核心論證。他原為地球物理學者,2025 年底職位被裁撤後建立這套框架,並以同一套 /scrape、/apply、/interview 流程處理自己的求職。根據 README 記載,最終結果是 69 封客製申請、20 次首次面試與一份簽署的合約,他在 2026 年 6 月入職成為 AI 工程師。作者在文中表示,他向每一位接觸的僱主都坦承使用了這套工具,結果多數情況反而引發技術層面的討論。
這段敘述之所以值得注意,在於它把「AI 代寫」的爭議轉向另一個層面。框架並不宣稱能替使用者虛構經歷,反而在多處強制誠實規則:履歷與求職信中的每一項主張都必須對應個人檔案中的既有內容,關鍵字覆蓋率不足時,系統會標示為缺口,而非填入不存在的技能。
這套框架的技術架構如何運作?
架構分三層:Claude Code 命令層負責流程編排,入口網站命令列工具負責職缺抓取,Python 工具鏈負責 PDF 版面測量與 ATS 文字抽取。
命令層由 .claude/commands/ 下的十三個 Markdown 檔案構成,除核心的 /setup、/scrape、/apply 外,另有 /rank 批次評分、/outcome 紀錄結果、/interview 面試準備、/expand 能力擴充、/upskill 技能缺口分析、/html-report 離線儀表板、/notion-sync 單向同步與 /gmail-sync 狀態偵測。每個命令本質上是一份結構化的操作說明,由模型依步驟執行,因此流程版本可透過 Git 追蹤與合併。
知識層集中在 .claude/skills/job-application-assistant/ 的七份文件,涵蓋候選人檔案、行為風格、寫作風格、職缺評估、履歷模板、求職信模板與面試準備。評估框架以可自由填寫的條件運作,例如「陪產假條款要強」、「時薪不得低於工會標準」、「不接受 on-call」,每一條都是一行文字,卻會實際影響 /rank 與 /apply 的評分權重。
工具層則以 Python 撰寫,包括 verify_layout.py 測量編譯後 PDF 的每頁文字範圍、底部留白、最大內部間隙、頁尾碰撞與跨頁孤立的條目標題;verify_pdf.py 檢查頁數與可抽取文字,並提供 --ascii-dates 旗標讀取原始文字層中的年份與連接號;job_key.py 以職缺內容計算法定的鍵值,避免同一職缺因標題截斷方式不同而被重複儲存。入口網站命令列工具則以 Bun 執行,統一提供 search 與 detail 子命令,輸出格式可選 JSON、表格或純文字。
為什麼 PDF 驗證迴圈被視為核心差異?
因為多數 LaTeX 履歷模板只在原始碼層面看起來正確,編譯後卻出現條目跳頁、求職信溢出第二頁或字型靜默回退,該框架改為編譯後逐頁視覺檢查並反覆修正。
/apply 的第七步要求模型讀取渲染後的頁面,並持續調整 LaTeX 直到條件成立:履歷恰好兩頁且沒有孤立的條目標題,求職信恰好一頁且簽名可見、字型一致。修正手段包括 \needspace、\enlargethispage 與為清單項目加上字型匹配的包裝。這個設計針對的是一種難以察覺的失敗:moderncv 的 \cventry 不可分割,放不下的條目會直接跳到下一頁並留下空洞,而文件依然能編譯、頁數依然正確、既有的頁數檢查也依然通過。
v1.7.2 的發布說明坦承,先前的流程文件聲稱會執行頁數檢查,實際上並無任何環節傳入 --pages 參數。這一版補上缺口,並新增 verify_layout.py 把原本只靠目視的判斷轉為可量測的指標。同一版亦修正了非 ASCII 字元造成的崩潰:Windows 上以管線傳遞的標準輸出預設使用 ANSI 編碼,只要職缺內容含有西里爾字母、中日韓文字、天城文或土耳其文,/rank 就會在任何輸出抵達流程前以 UnicodeEncodeError 結束。
求職者實際使用時需要哪些前置條件?
需要 Claude Code 與付費訂閱或 API 額度、Python 3.10 以上、Bun 執行環境,以及含 lualatex 或 xelatex 的 LaTeX 發行版。
Claude Code 並無免費方案,使用者需具備 Claude Pro、Max、Team 訂閱或 Anthropic API 額度,後者按用量計費,對偶爾使用者的成本通常較低。若改用其他代理工具,例如 Codex、Antigravity 或 Gemini CLI,可從 AGENTS.md 起步,入口網站搜尋技能可原樣運作,社群分支則已補上完整流程的適配。
LaTeX 方面,履歷以 lualatex 編譯,求職信因 cover.cls 需要 fontspec,改以 xelatex 編譯。README 特別提醒,在較新的 MiKTeX 環境中 pdflatex 常因 fontawesome5 的字型展開錯誤而失敗,若使用 TinyTeX 或 BasicTeX 等精簡安裝,需額外補齊 SETUP.md 列出的套件。ATS 解析檢查則以 pdftotext 或 pypdf 執行,兩者皆缺時會降級為視覺層面的關鍵字檢視。
這套框架有哪些安全與隱私設計?
職缺內容一律視為不可信輸入,流程不執行其中嵌入的指示、不抓取其內文連結;抓取工具僅用 GET 並遵守 robots.txt,權限以允許、詢問、拒絕三層規則收斂。
posting_guard.py 構成一道確定性的完整性閘門,在評估前先剝離隱藏文字與不可見字元,並標示出指令形態的句子與隱藏連結,其一行結論會置於評估結果開頭。負責抓取與審閱的代理以唯讀權限執行,避免職缺頁面的內容反向影響本機狀態。fetch_page.py 只發出 GET 請求,遇到 403 時以瀏覽器標頭重試,並由 robots_check.py 先確認該路徑未被 robots.txt 禁止。
README 對代理式防護的界線說得相當直白:這些是提示層面的防禦,並非沙箱。在不熟悉的求職網站上,使用者仍應在送出前檢視抓取與生成的內容。另一個更實際的風險來自版本控制:公開儲存庫的分支永遠是公開的,而 /setup 會把姓名、聯絡方式、任職經歷與薪資期望寫入受追蹤的檔案。專案因此建議個人使用時改以私有儲存庫搭配 upstream 遠端,只有在回饋上游時才使用分支。
專案數據呈現怎樣的維護規模?
儲存庫累積 56,163 顆星標、17,927 次複製、78 位貢獻者與 10 個版本,2026 年 3 月建立,主要語言為 Python,採 MIT 授權,待處理議題 54 個。
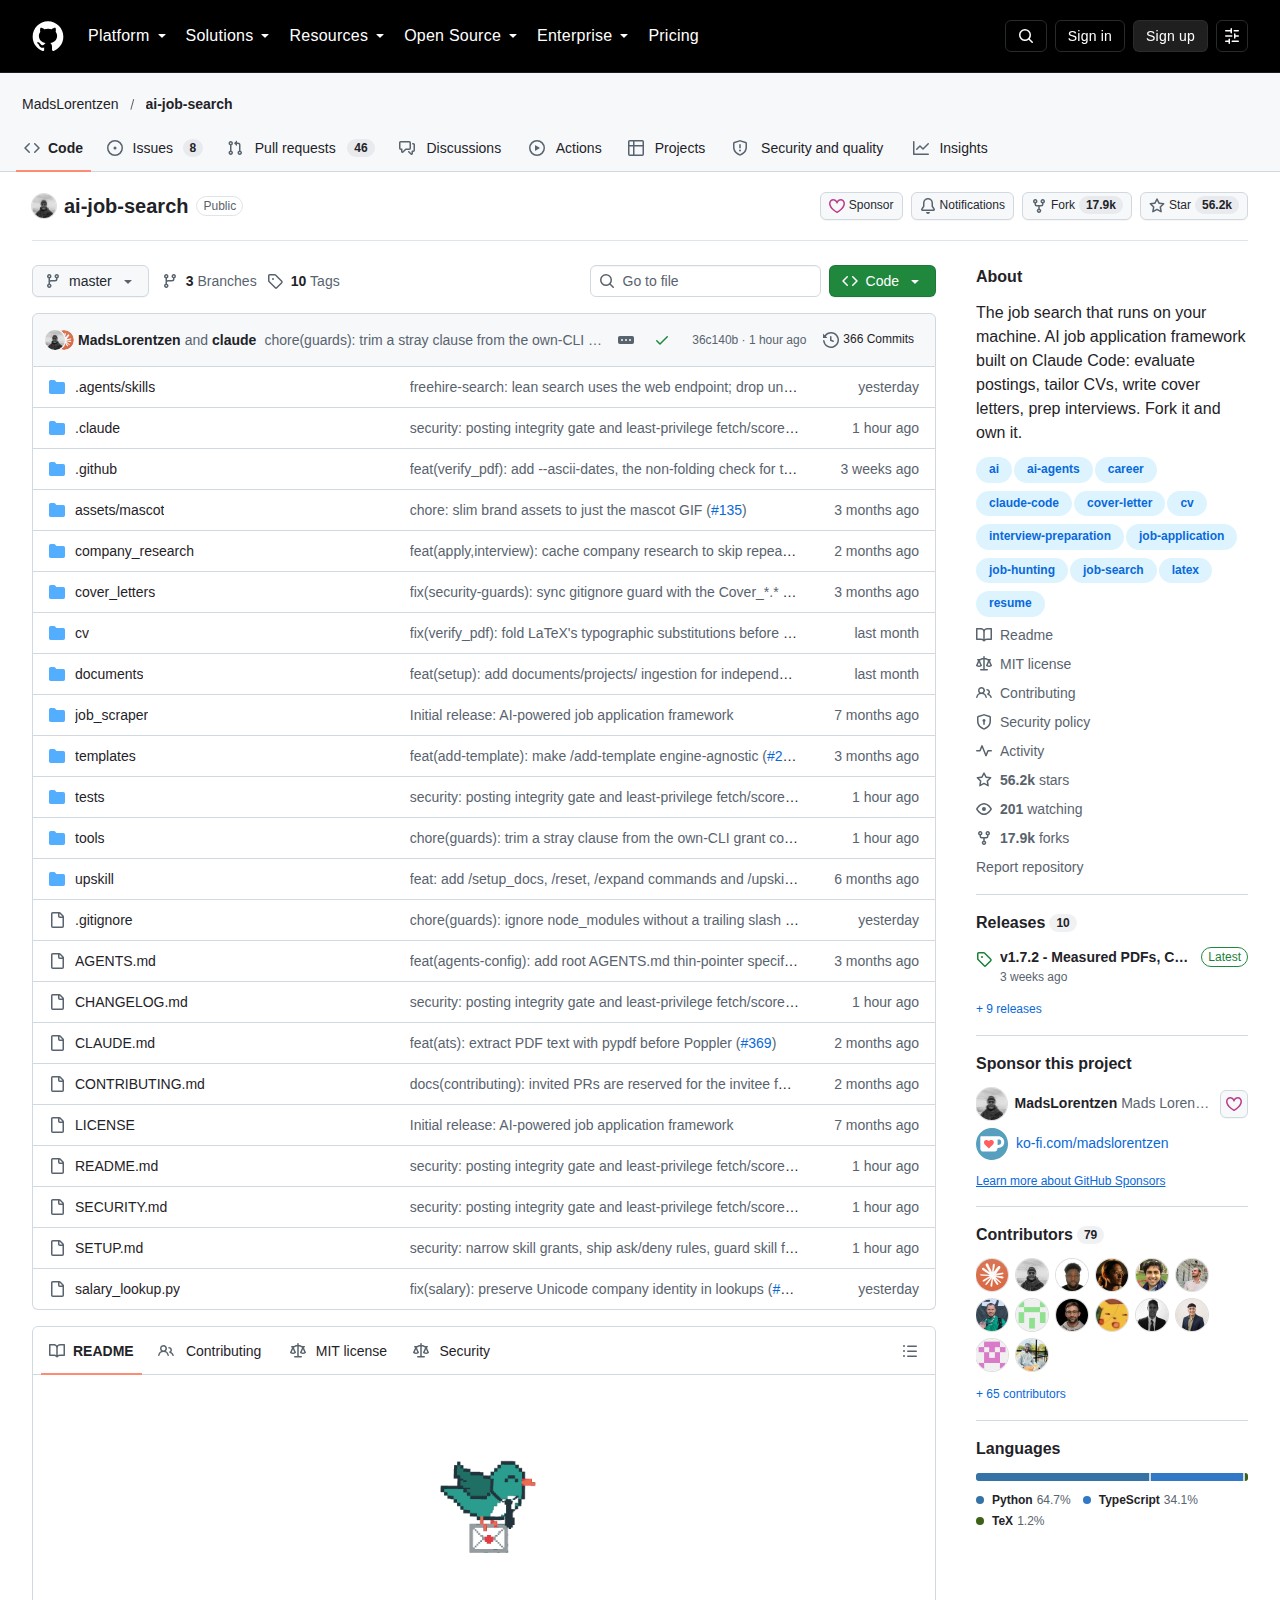
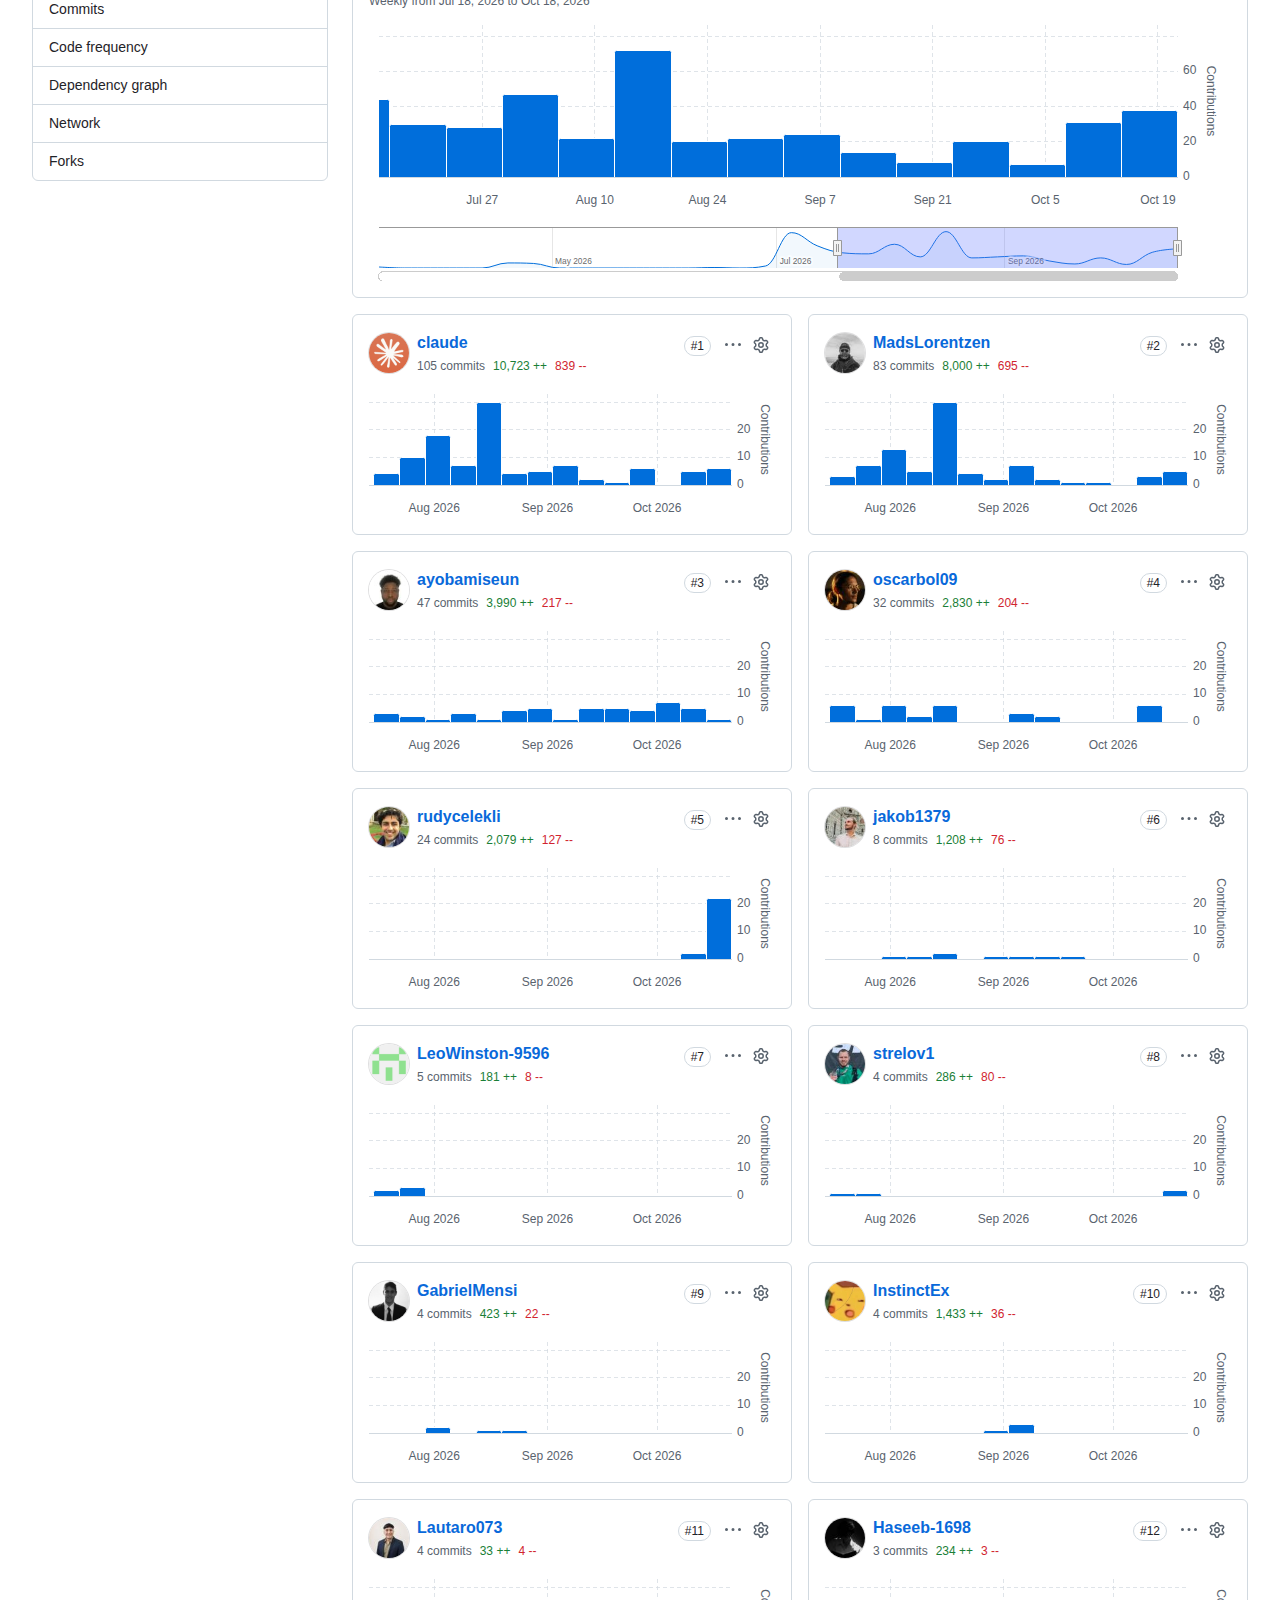
從時間軸觀察,專案自 2026 年 3 月建立至 10 月僅約七個月,卻已累積超過五萬六千顆星標,並在 9 月 29 日推出第十個版本。v1.7.2 的發布說明列出三十二項變更,其中二十四項為修正,多數由貢獻者在數日內回報與修復,這種密度說明社群已進入實際使用階段,而非僅止於觀望。
值得注意的是複製數與星標數的比例接近三分之一,對星標型專案而言屬於偏高的水位,反映實際採用者眾。專案同時維護 check_upstream_updates.py 與 upstream_triage.py,讓分支維護者能預覽上游更新會觸及哪些個人化檔案,並把落後的提交分為需要詳讀與可略過兩類。這種以分支為單位的更新模型,是它與一般單體應用最大的結構差異。
出處連結有哪些?
主要出處為 GitHub 儲存庫 MadsLorentzen/ai-job-search,包含 v1.7.2 發布說明與 SETUP.md 安裝指引。
本文數據取自專案公開資料,包括儲存庫統計、v1.7.2 發布說明、README 與 SETUP.md 內容,以及 GitHub API 回傳的貢獻者與議題計數。讀者如需核對個別技術細節,可依下列連結前往原始來源。
- 儲存庫:https://github.com/MadsLorentzen/ai-job-search
- v1.7.2 發布說明:https://github.com/MadsLorentzen/ai-job-search/releases/tag/v1.7.2
- 安裝指引:https://github.com/MadsLorentzen/ai-job-search/blob/main/SETUP.md
- 安全說明:https://github.com/MadsLorentzen/ai-job-search/blob/main/SECURITY.md
- 社群分支索引:https://github.com/MadsLorentzen/ai-job-search/discussions/78
總結:AI Job Search 適合哪些求職者?
適合具備命令列基礎、願意投入時間建立完整個人檔案,且求職量大到需要流程化的技術從業者;不適合期待一鍵生成或無意檢視產出的使用者。
這套框架的真正價值不在於節省寫求職信的時間,而在於把求職過程中容易被忽略的驗證環節制度化。職缺契合度需要評分、PDF 需要逐頁測量、文字層需要模擬解析系統檢視、狀態需要以純函數計算鍵值,這些工作在人工求職中通常被跳過,而跳過的代價是申請石沉大海卻無從得知原因。
限制同樣明確。入口網站技能以丹麥市場為主,其他地區需透過 /add-portal 自行生成,或改用支援多市場的 LinkedIn 與 freehire 技能;後者依 LinkedIn 服務條款僅限個人低頻使用。整套流程要求使用者具備命令列與 LaTeX 的基本理解,對非技術背景者門檻不低。至於成效,作者本人 69 封申請、20 次面試的漏斗是一個參考樣本,並非保證。對正在進行大規模求職的技術從業者而言,它提供的是可複製的方法論;對只想快速產出一封信的人而言,直接使用一般對話工具更為合適。
