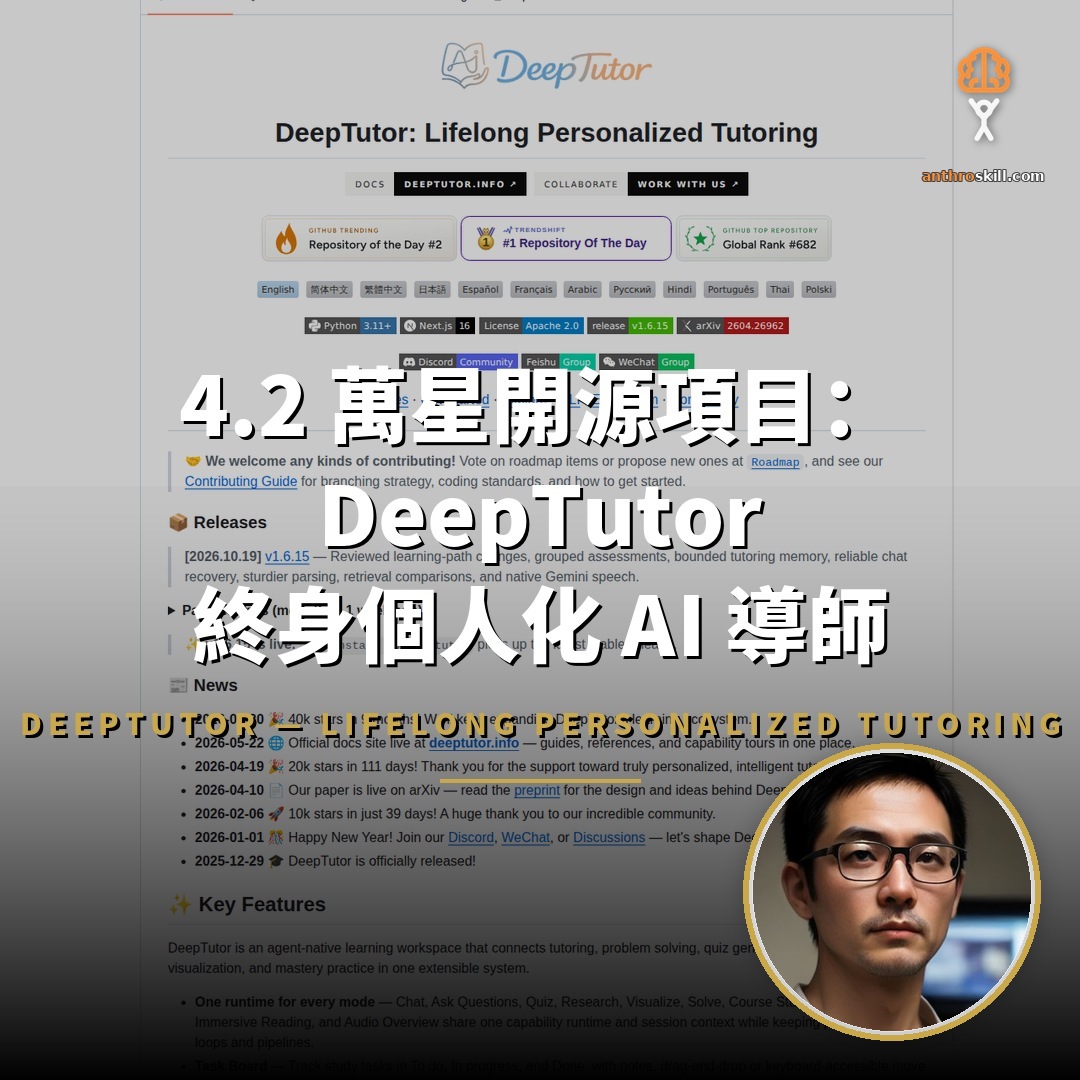
DeepTutor 是香港大學數據智能實驗室(HKUDS)開源的個人化 AI 導師系統,GitHub 累積 42,664 顆星標與 215 位貢獻者,採 Apache-2.0 授權。它把對話答疑、測驗生成、深度研究與掌握度練習整合在同一個代理執行環境,並以知識庫、記憶與技能支撐跨學期學習。
DeepTutor 是什麼?
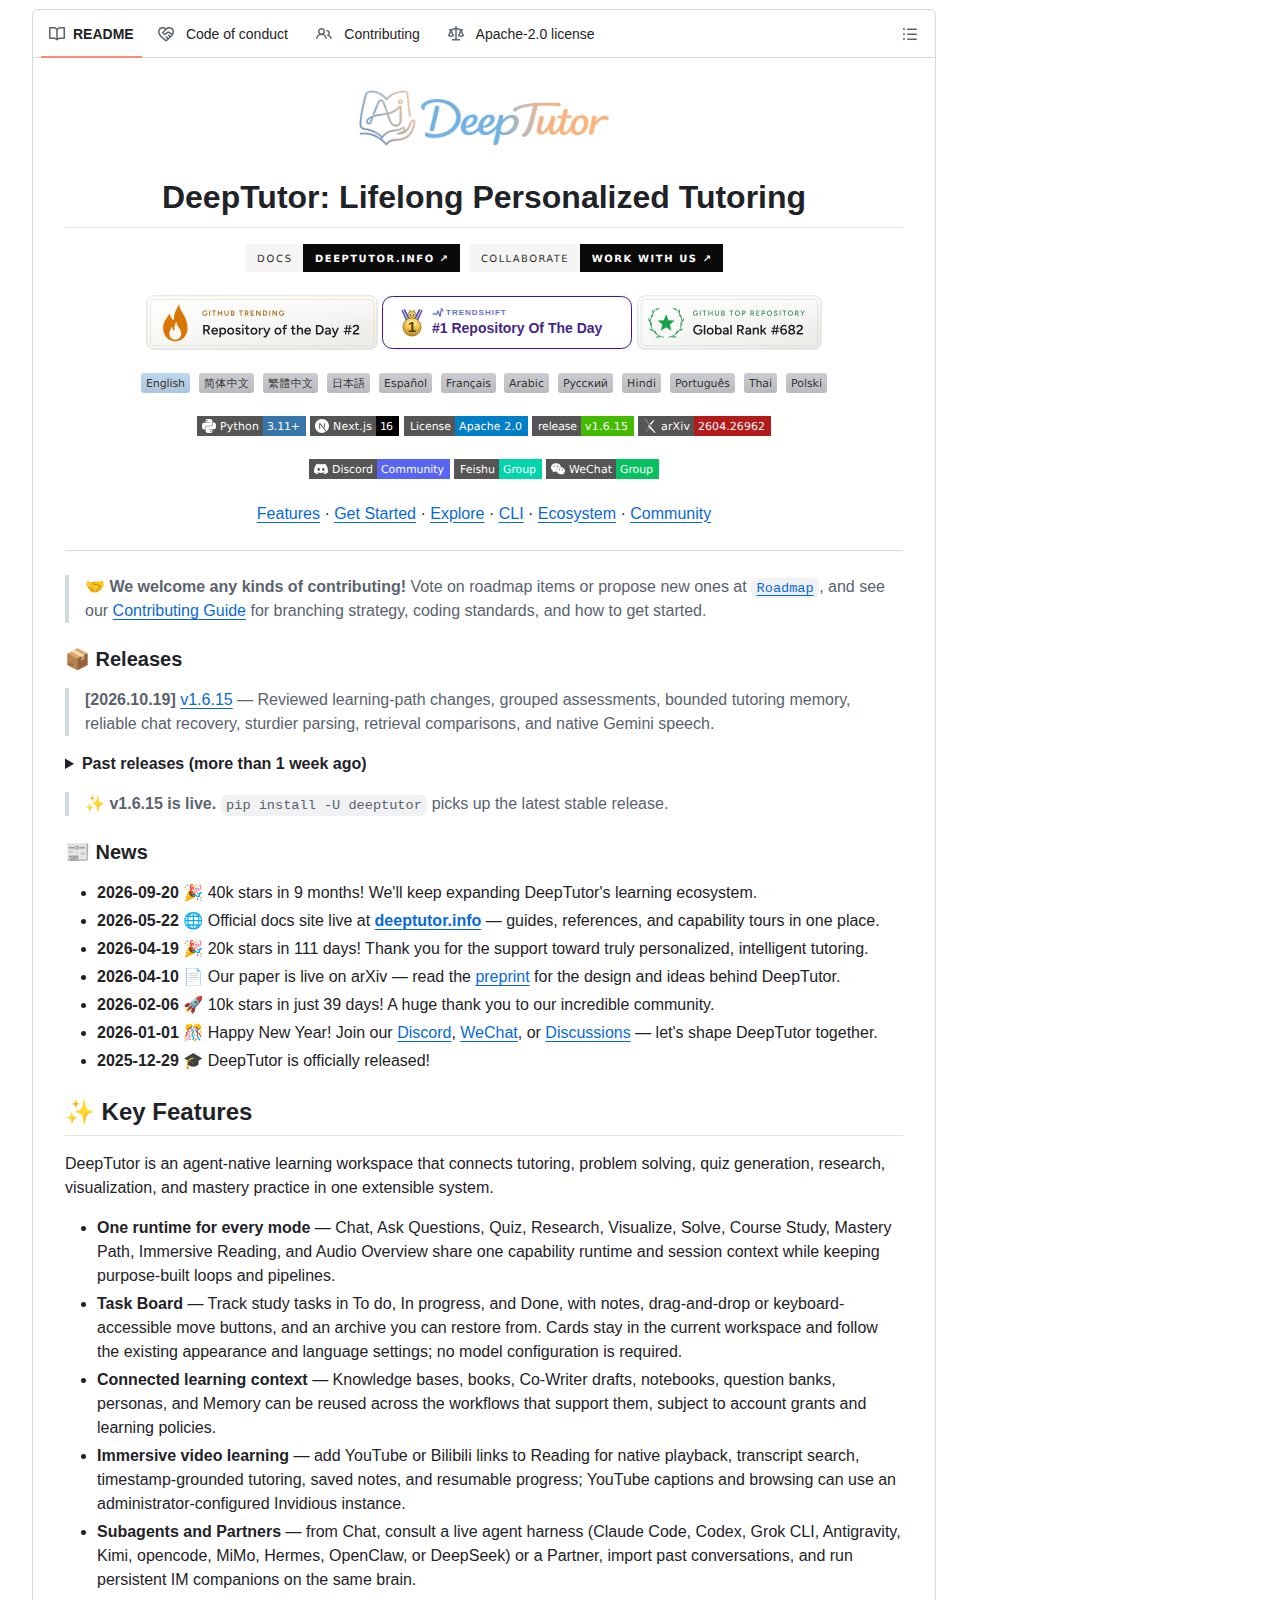
DeepTutor 是開源的個人化 AI 導師系統,以單一代理執行環境整合答疑、測驗、研究與掌握度練習,並用知識庫、三層記憶與可安裝技能支撐跨學期的持續學習。
名稱中的 Tutor 說明定位:它不處理單次提問,而是記錄學習者長期走過的路徑。README 對功能的描述集中在兩處,一是把十種學習模式放進同一個執行環境,二是讓知識庫、書籍、筆記、題庫與記憶在不同模式之間互相重用。
專案由香港大學數據智能實驗室主導,2025 年 12 月 29 日正式發布,並在 2026 年 4 月於 arXiv 發表論文,編號 2604.26962,交代設計取捨。README 的里程碑記錄顯示,它在 39 日內達到一萬星標,111 日內達到兩萬,九個月內達到四萬,屬於 2026 年增長最快的教育類開源專案之一。
這條增長曲線對應一個具體缺口。通用對話模型能解釋概念,卻不掌握學習者過去錯在哪裡;傳統學習管理系統掌握進度,卻無法即時生成練習。DeepTutor 試圖把兩端接在同一份資料上,這也是它與一般 AI 聊天介面的根本差別。
DeepTutor 的核心架構如何運作?
系統以 ChatOrchestrator 為單一入口,將每個請求轉成代理回合:模型分輪思考、呼叫工具、觀察結果再收尾,各學習模式共用工具與工作區。
README 把設計原則寫得相當直白:一個執行環境服務所有模式。對話、提問、測驗、研究、視覺化、解題、課程研習、掌握度路徑、沉浸閱讀與語音摘要共用同一份工作階段上下文,各自保留專屬流程與管線。
單一回合的循環只有四步。模型先思考,判斷是否需要工具;需要時發出工具呼叫,取得結果後再回到思考;最後以一個不含工具呼叫的訊息結束。其中一個工具值得單獨說明:ask_user。當指令含糊,代理可以暫停回合,提出結構化問題,收到答覆後從原處續跑,而不是憑猜測補上缺失條件。
工具分為兩類。使用者可自行開關的有 brainstorming、web_search、paper_search、zotero_search、reason 與 geogebra_analysis,配置生成模型後另有 imagegen 與 videogen。另一類由上下文自動掛載,包括 rag、kb_files、read_source、read_memory、write_memory、read_skill、exec、web_fetch、question_bank、github、consult_subagent 與工作區相關的讀寫工具,只有回合條件吻合時才出現。
這種分層解決了工具過載。一次把所有工具塞進提示詞,模型的選擇準確度會下降,成本也會上升。按上下文掛載等於讓可用工具清單隨任務變化,對本地部署的模型尤其重要,因為小模型的判斷餘裕本來就有限。
DeepTutor 提供哪些學習模式?
十種模式涵蓋對話答疑、提問訓練、測驗生成、引用式研究報告、圖表視覺化、逐步解題、課程研習、掌握度路徑、沉浸閱讀與語音摘要,共用同一份學習上下文。
首頁把 Chat、Ask Questions、Quiz 與 Visualize 放在一鍵可及的位置,Research 與 Solve 收在更多能力之下。個人化學習區則聚集 Book、Mastery Path、Immersive Reading 與 Practice 四項,指向需要跨回合累積的功能。
沉浸閱讀的範圍超出純文字。學習者可以加入 YouTube 或 Bilibili 連結,在閱讀介面直接播放,同時搜尋逐字稿、按時間戳提問、儲存筆記,並在下次開啟時回到上次位置。系統亦支援以管理員配置的 Invidious 實例取得字幕,避免依賴單一來源。
掌握度路徑是設計上較少見的一環。它把一個主題拆成有先後次序的節點,每個節點設有通過條件,未達標就不能前進。這種硬性門檻與多數 AI 學習工具的自由探索路線相反,適合有明確考試或技能目標的場景,代價是靈活性下降。
任務看板則補上行政層面。學習任務分為待辦、進行中與完成三欄,支援備註、拖曳或鍵盤移動,並保留可還原的封存區。這項功能不需要模型參與,也不消耗推論額度,反映專案把學習管理視為獨立於生成能力之外的必需品。
DeepTutor 的知識庫支援哪些引擎?
支援 LlamaIndex、PageIndex、GraphRAG、LightRAG 與遠端伺服器,另接 WeKnora、IMA 與 Obsidian,索引可重建。
檢索層採多引擎並存,而非綁定單一方案。LlamaIndex 走傳統向量檢索路線,適合大量短文件;PageIndex 以頁面為單位建立推理式檢索,貼近長篇教材的閱讀習慣;GraphRAG 抽取實體與關聯,用於需要跨章節推理的題材;LightRAG 則在圖譜建構成本與檢索品質之間取平衡。
外部來源同樣納入。WeKnora 可自架,騰訊 IMA 與 MarginNote 4 圖書館可直接連結,Kiwix 的 ZIM 離線檔案適合沒有穩定網路的環境。Obsidian 儲存庫的支援意味著既有筆記不必搬遷,直接在原目錄上建立索引。
版本記錄是這層設計的關鍵細節。README 說明知識庫索引具版本編號,重建時會比對建索引所用的設定,需要確認才執行。文件解析引擎亦可替換,涵蓋 MinerU、PyMuPDF4LLM、Apache Tika 與 LiteParse。對照實際使用情境,教材格式混亂是常態,能否換解析器往往決定檢索成敗。
DeepTutor 的記憶機制有什麼特別?
記憶分三層:L1 保留原始互動痕跡,L2 生成介面摘要,L3 綜合長期結論,並以記憶圖譜把結論連回證據,學習者可逐層檢視與手動修改。
多數 AI 工具的記憶是不透明的摘要,使用者只能接受或清除。DeepTutor 把三層攤開:L1 是原始對話與操作痕跡,L2 是各使用介面的摘要,L3 是跨介面的長期綜合。記憶圖譜把 L2 的事實連到 L1 的證據,也把 L3 的結論連到貢獻它的介面。
這種設計的直接好處是可稽核。若導師給出與教材相反的建議,學習者可以沿圖譜回查是哪一層的記憶出了偏差,而不必整份清除重來。README 亦提供推理安全檢查清單,要求回報問題前先收集診斷資訊,說明團隊把記憶錯誤視為需要定位的技術問題。
代價是複雜度。三層記憶需要額外的儲存、摘要與檢索成本,模型每次回答前要先判斷該讀哪一層。對於只用來查名詞解釋的使用者,這套機制屬於過度設計;對於準備考試或長期進修的人,累積下來的個人化差異才是價值所在。
DeepTutor 如何安裝與部署?
提供四條路徑:Docker 單一容器、PyPI 安裝、原始碼開發與代理代為設定。Docker 只需發佈 3782 埠,資料存於具名磁碟區,重啟後保留設定與知識庫。
最短的一條是容器。執行一行 docker run 指令,把容器內 3782 埠對應到本機,掛上具名磁碟區保存資料,開啟瀏覽器即可在設定頁填入模型供應商與金鑰。README 特別註明只需發佈前端埠,因為容器內的 Next.js 中介層會把 API 與 WebSocket 請求轉給後端。
第二條走 PyPI,需要 Python 3.11 至 3.14 與 Node.js 20 以上的執行環境。安裝後依次執行 deeptutor init 與 deeptutor start,初始化精靈會詢問連接埠、模型供應商、金鑰與模型名稱,以及可選的嵌入與搜尋供應商。第三條針對開發者,從儲存庫取得原始碼後以可編輯模式安裝,前端可用熱更新模式啟動。
第四條路徑在開源專案中並不常見:讓另一個代理代為安裝。README 提供一段可直接貼進具備終端能力的代理的提示詞,要求它先讀 SKILL.md 與代理設定指南,再依序準備環境、設定供應商、驗證並啟動,過程中不得輸出金鑰。專案同時提供 deeptutor doctor 指令,用於檢查執行環境是否具備開回合條件,加上線上參數可一併探測模型供應商。
DeepTutor 的 CLI 與技能生態如何運作?
CLI 有互動式 REPL 與 JSON 兩種介面,run 可輸出逐行 NDJSON 供代理驅動;技能採開放格式,內建 EduHub 並相容 ClawHub,匯入前過安全檢查。
deeptutor 這一個執行檔提供兩種用法。deeptutor chat 開啟互動式環境,以參數指定能力、知識庫、工具與工作區;deeptutor run 接收單一能力與訊息,跑完一回合即結束,加上格式參數後改為逐行輸出 NDJSON,每行帶工作階段編號與事件類型。
這種輸出格式的意義在於可被另一個代理驅動。上層代理可以擷取工作階段編號,把後續提問接在同一份狀態上,形成有記憶的長流程。README 亦提示可把 run 指令包成 LangChain 或 AutoGen 的工具。無終端環境下的行為也考慮過:遇 ask_user 暫停時自動以空回覆結束,不會卡住整個流程。
技能層採開放的 Agent-Skills 格式,一個資料夾內放 SKILL.md 與可選參考檔,並非 DeepTutor 專屬規格。專案內建教育導向的 EduHub 目錄,提供蘇格拉底式提問、閃卡製作、論文批改與命題藍圖等技能,同時相容 ClawHub,可用前綴指定來源與版本。
匯入流程設有統一的安全檢查。系統先讀取目錄方提供的安全評級,被標記的套件除非明確放行否則拒絕;壓縮檔解開時檢查路徑穿越、項目數、體積、壓縮比、副檔名與符號連結,並移除執行權限;前置資料會被正規化,其中 always 欄位一律剝除,避免下載的技能強制進入每一段系統提示;來源、版本、評級與安裝時間寫入鎖檔以備稽核。
DeepTutor 有哪些限制與風險?
未結問題 199 項,儲存庫達 276.7 MB,十個月內發布 87 個版本,介面與設定可能頻繁變動;系統本身不含模型,推論成本與資料合規須由部署方自行承擔。
版本節奏是最需要留意的項目。專案在十個月內累積 87 個版本標籤,README 的更新記錄顯示幾乎每週都有功能調整或架構重構,其中一次前端與後端的分層重寫被標示為破壞性變更。對要長期維護的教學機構,這代表升級前必須預留測試時間。
儲存庫體積達 276.7 MB,主要來自示範圖片與文件,加上 Node.js 與 Python 雙邊依賴,首次建置的等待時間不短。未結問題 199 項,開發者需自行判斷哪些會影響自身使用路徑。
系統本身不附模型能力。所有生成、嵌入與語音功能都要接上外部供應商,或改接本地模型,成本與延遲取決於這個選擇。教材若含學生個人資料,部署方還須自行處理傳送至第三方供應商的合規問題,專案並未提供資料落地保證。
DeepTutor 的專案數據反映什麼?
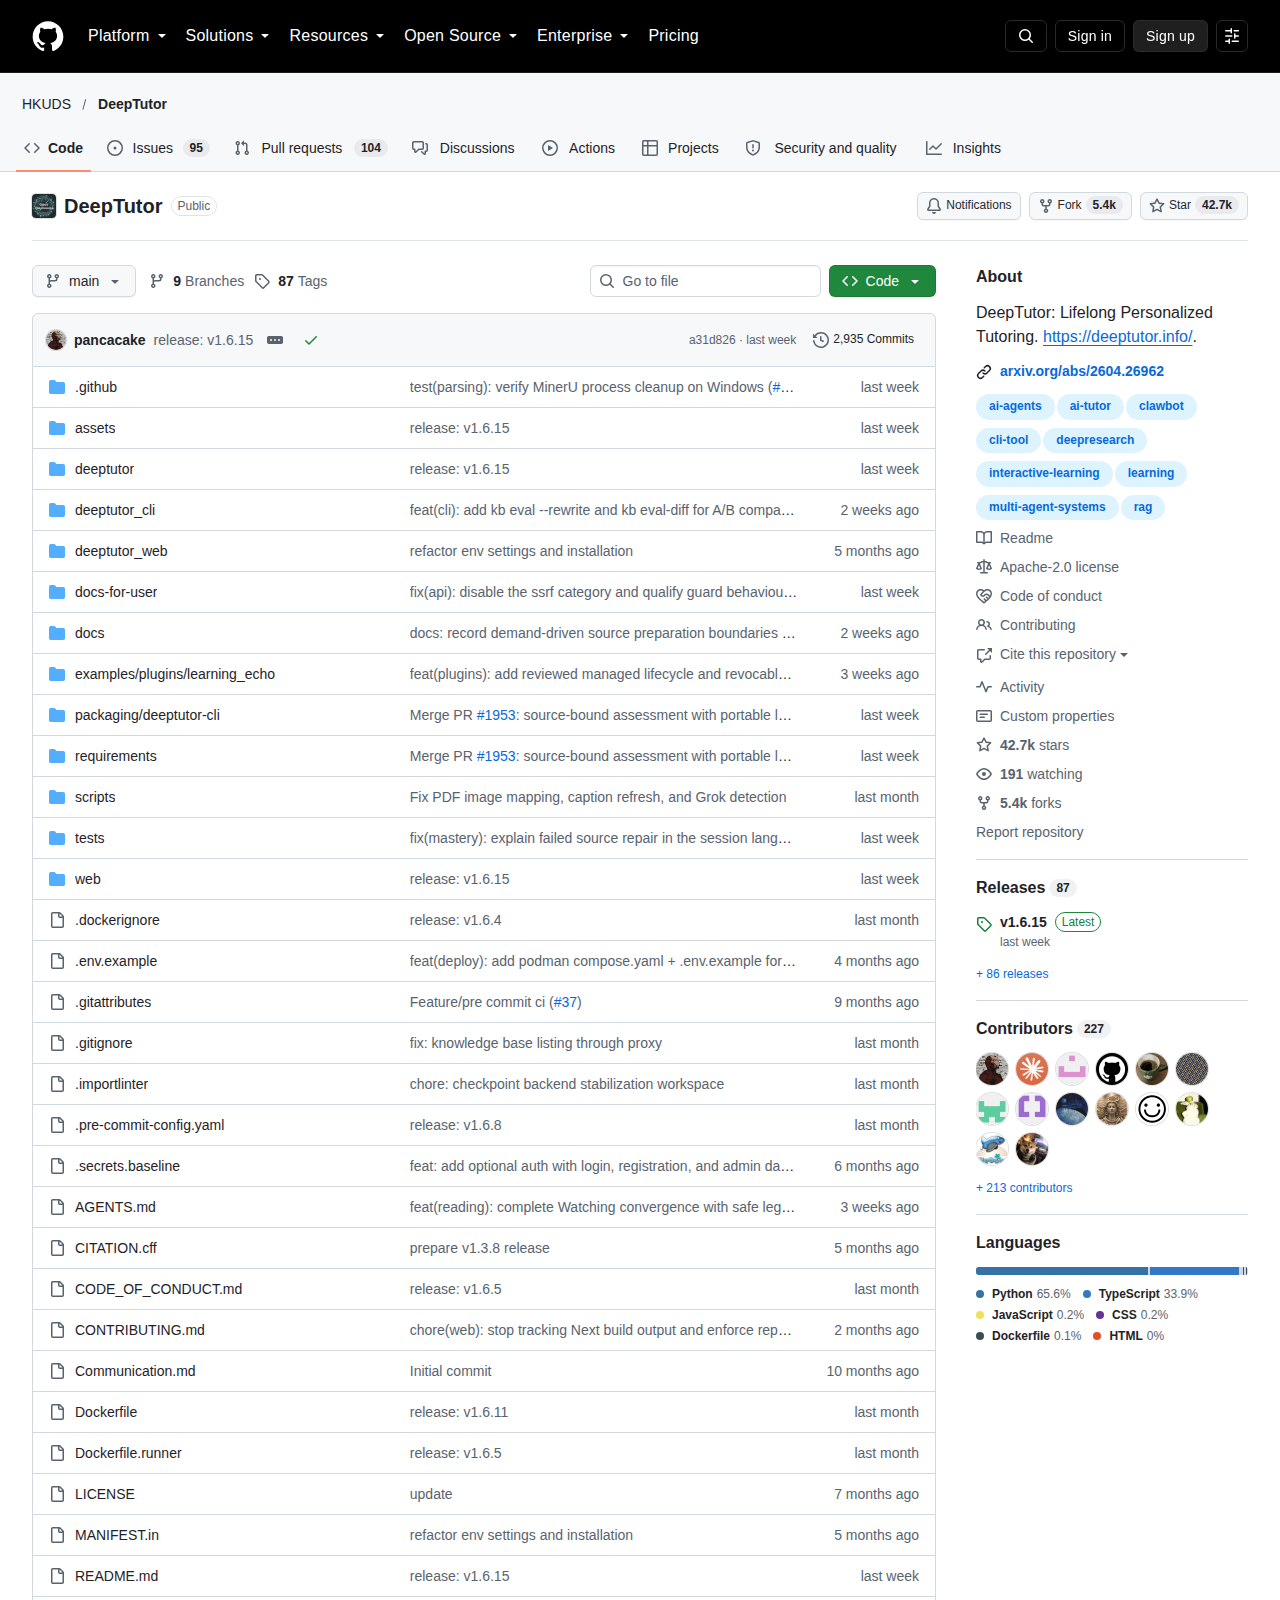
42,664 顆星標對 5,413 個分支,比例約 8 比 1;215 位貢獻者、199 項未結問題、近 30 日 661 次提交,顯示核心團隊主導且開發密度高的特徵。
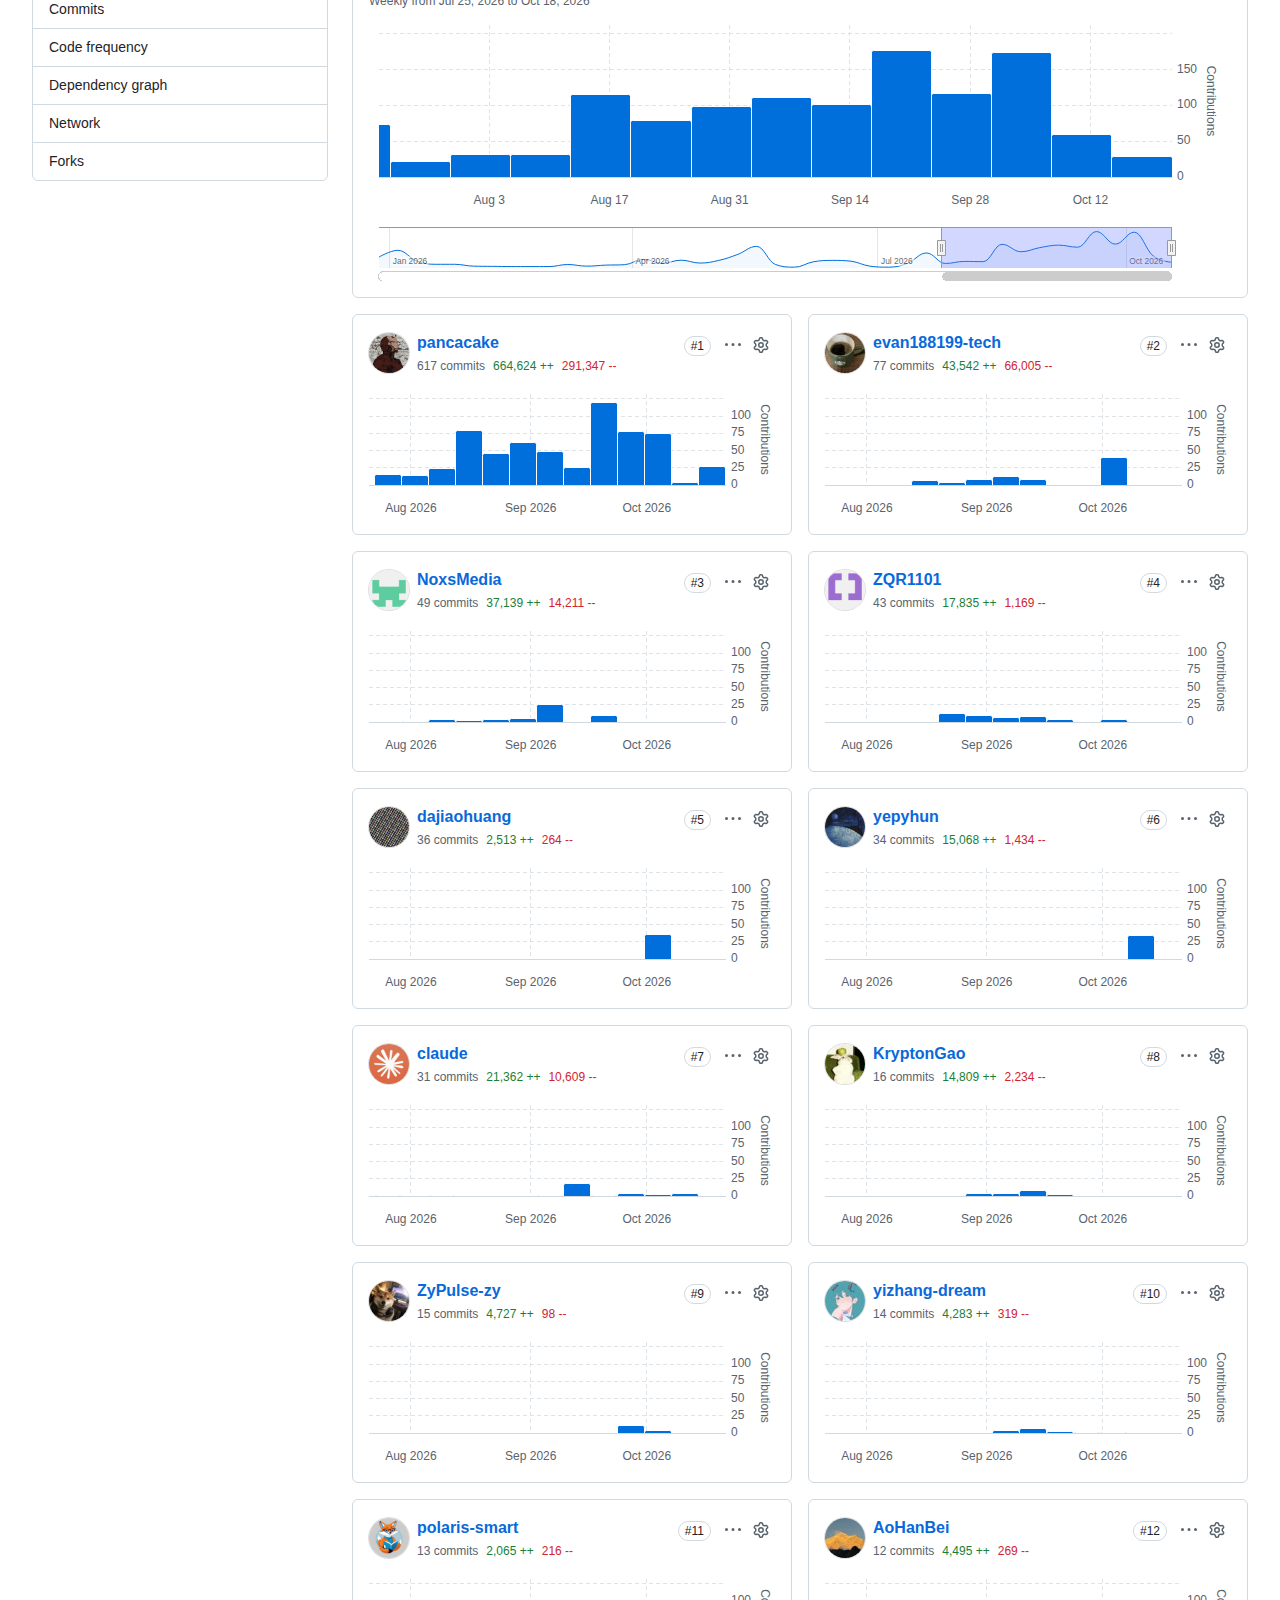
近 30 日 661 次提交,平均每日超過 20 次,屬於高強度維護的節奏。配合十個月內 87 個版本標籤,可以看出團隊採用小步快跑的方式推進,而非累積大批變更後一次發布。
貢獻者 215 位對 42,664 顆星標,密度低於同星級的工具型專案。這個組合通常代表核心團隊掌握主要程式碼,外部貢獻集中在文件、翻譯與邊緣修正。README 提供十三種語言的說明文件,亦印證國際社群參與集中在此層。
Apache-2.0 授權對商業採用相對友善,無須開源衍生作品。對於想把導師功能嵌入自家學習平台的機構,這一點比功能清單更具決定性。
出處連結有哪些?
原始碼在 GitHub 的 HKUDS/DeepTutor,文件站為 deeptutor.info,論文見 arXiv 2604.26962。
主要入口是 GitHub 儲存庫 https://github.com/HKUDS/DeepTutor,README 提供英文、簡體中文、繁體中文、日文、韓文、法文、德文等十三種語言版本。
官方文件站 deeptutor.info 收錄安裝指引、能力導覽與代理接手流程;arXiv 論文 2604.26962 交代系統設計與記憶架構的取捨;EduHub 目錄位於 eduhub.deeptutor.info,可瀏覽與發佈教學技能。容器映像則發佈在 GitHub Container Registry,路徑為 ghcr.io/hkuds/deeptutor。
總結:DeepTutor 適合哪些人?
適合需要跨學期累積個人化教材、且有能力自行部署模型與知識庫的教師、進修者與教學機構;若只需即時答疑,輕量聊天工具更省成本。
DeepTutor 的價值落在一個具體條件上:學習互動要延續數週以上。只有長期互動,三層記憶與掌握度路徑才會產生差異;若使用場景是一次性的名詞查詢,整套架構帶來的設定成本遠超回報。
採用前應確認四件事。模型來源是否已備妥,這決定推論成本與資料流向;教材格式是否雜亂到需要更換解析引擎;團隊能否承受每週級別的版本更新節奏;以及是否需要在多使用者環境下隔離各自的知識庫與記憶。四項都有答案時,這個四萬星專案可作為自建教學平台的起點。
專案仍在高速演進,功能清單與設定介面每隔數週就會變動。把它當成長期投資而非即裝即用的成品,判斷會更貼近實際。
