
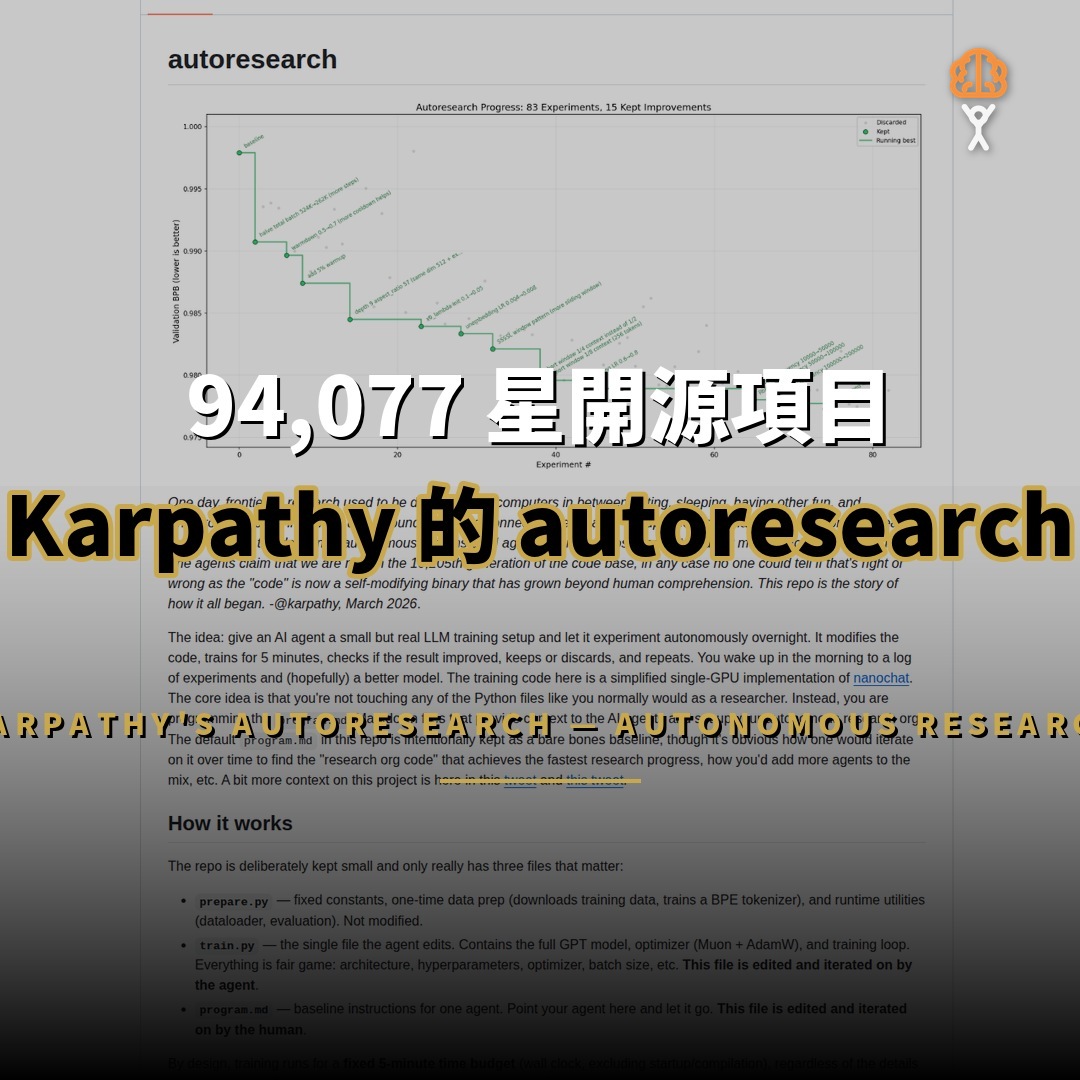
autoresearch 是 GitHub 星標超過 94,077 顆的開源實驗項目,由 AI 領域指標性人物 Andrej Karpathy 於 2026 年 3 月發布,核心概念是讓 AI Agent 在單張 GPU 上、以固定 5 分鐘的時間預算,反覆修改訓練程式碼、執行訓練並依據結果自主迭代,最終在無人為干涉的情況下自動完成實驗與模型改進;項目採 MIT 開源授權、以 Python 撰寫,工程上是其先前 nanochat 項目簡化後的單 GPU 實現。
autoresearch 是 Karpathy 於 2026 年 3 月發布的開源項目,讓 AI Agent 在單張 GPU 上以固定 5 分鐘預算反覆修改並訓練模型、依結果自主迭代,MIT 授權、Python 撰寫,GitHub 星標逾 9.4 萬。
autoresearch 是什麼?
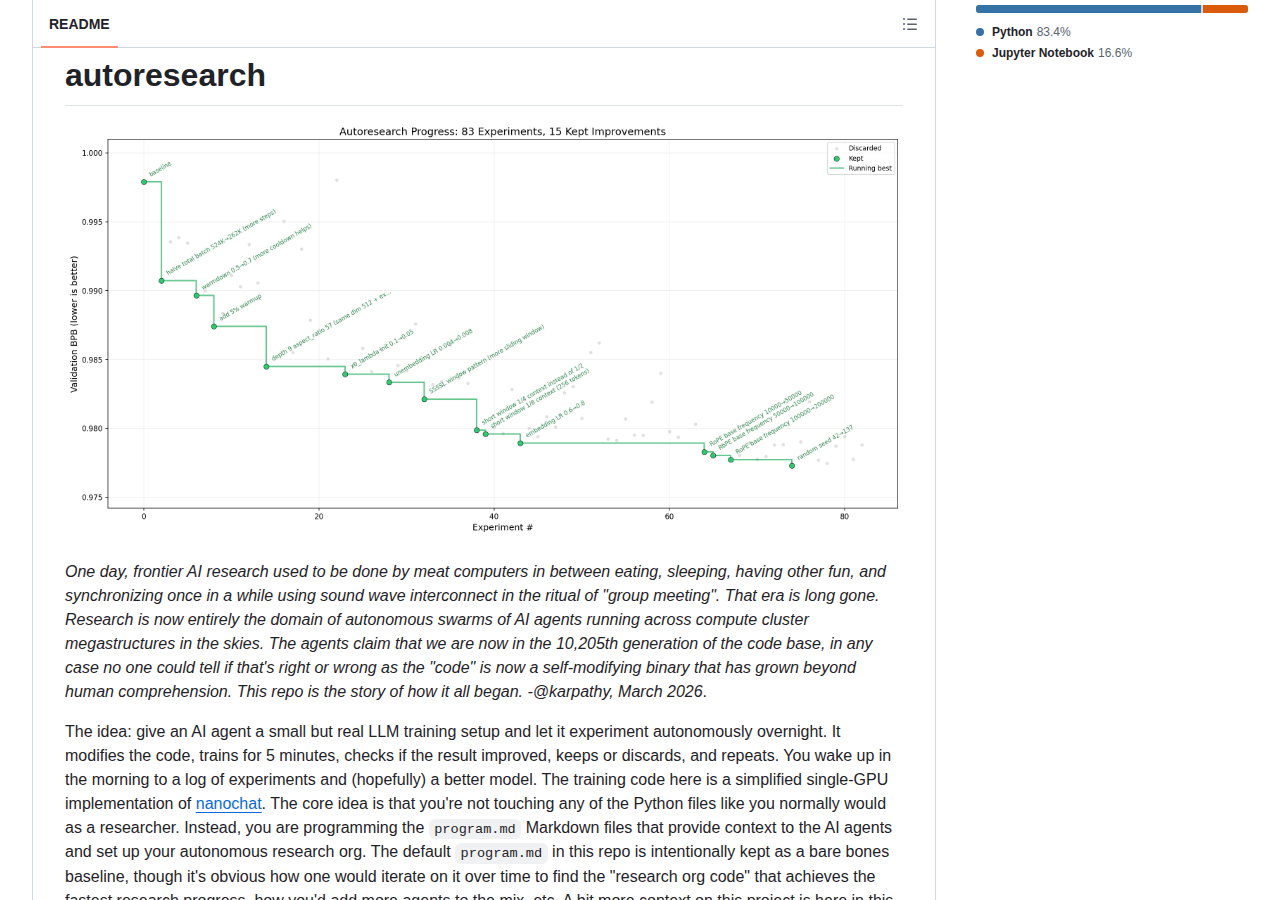
autoresearch 是 Andrej Karpathy 在 2026 年 3 月發布的開源實驗項目,將「自主研究」具體化為一套可以實際運行的最小可行框架。其公開的目標是讓 AI Agent 頭戴一個小型的真實 LLM 訓練環境,在夜間自動執行實驗:Agent 修改訓練程式碼、訓練 5 分鐘、檢查結果是否改進、決定保留或捨棄,然後重複循環,直到清晨留下完整實驗紀錄與一個「更好」的模型。
autoresearch 是讓 AI Agent 自主做研究的開源框架:Agent 反覆修改訓練程式碼並執行 5 分鐘訓練,依據結果決定保留或捨棄,整晚循環後自動產出更好模型與完整實驗紀錄。
這個項目的特殊性在於它刻意設計得「極度簡潔」,整個 repo 只有三個關鍵檔案:prepare.py(固定常數與資料前處理,不可修改)、train.py(Agent 唯一可以動手的模型與訓練迴圈檔案)、以及 program.md(人類提供給 Agent 的實驗指令)。這套極簡設計讓「自主研究」不再只是概念,而是一個可重現、可比較、可自行迭代的真實實驗場域。
autoresearch 如何運作?
autoresearch 的運作機制圍繞「固定時間預算」這個核心設計展開。每次訓練嚴格限制在 5 分鐘(以牆鐘時間計算,不含啟動與編譯),無論硬體平台如何,實驗時間都維持一致,因此可以直接比較 Agent 對架構、超參數、最佳化器或批次大小所作的各種修改所帶來的效果;評價指標採用 val_bpb(每字節驗證位元數),數值越低越好,且因與詞彙表大小無關,架構性變動也能公平比較。
運作核心是固定 5 分鐘訓練預算,讓硬體差異不影響比較;以 val_bpb(越低越好、與詞彙表無關)作為評價指標,因此 Agent 對架構與超參數的修改都能被公平比較與迭代。
在實務上,使用者只要在這個 repo 中啟動 Claude、Codex 等任何編程 Agent(並關閉其權限),然後下達「看一下 program.md,來啟動一個新實驗」的指令,Agent 就會開始自主循環。由於每次約 5 分鐘,理論上每小時可執行約 12 次實驗,整夜約可完成上百次自動迭代;這種「固定時間、單一檔案、單一指標」的自我約束,正是 autoresearch 能穩定運行的關鍵。
autoresearch 有哪些核心技術亮點?
autoresearch 的第一個技術亮點是「單一檔案修改」的設計哲學。Agent 只被允許編輯 train.py,這個檔案同時涵蓋完整的 GPT 模型、最佳化器(Muon 與 AdamW)與訓練迴圈,無論是架構、超參數還是批次大小都在其可動範圍內;這種刻意收斂的修改範圍,讓每一次實驗的 diff 都清晰可審查,也避免 Agent 的自主行為失控造成不可預期的系統變動。
技術亮點之一是「單一檔案修改」:Agent 僅能編輯 train.py,涵蓋模型、最佳化器與訓練迴圈,讓每次實驗的變更清楚可審查,也防範自主行為失控。
第二個亮點是「時間預算」與「單指標評價」的結合,構成一個乾淨的最佳化迴路。固定 5 分鐘的容量讓比較聚焦在 Agent 的「程式修改智慧」,而非硬體差異;而 val_bpb 這個與詞彙表大小無關的指標,則讓架構等級的變動也能被公平量測,從而使 Agent 能夠真正透過「實驗→評估→保留或回滾」的循環進行自我改進。
第二個亮點是時間預算與單指標結合,構成乾淨的最佳化迴路:固定 5 分鐘聚焦於改碼智慧,vocab 無關的 val_bpb 讓架構變動可公平量測,驅動實驗、評估、保留回滾的循環。
第三個亮點是「人性化程式介面」的創新:人類不再直接改 Python,而是透過編輯 program.md 這個 Markdown 檔案來「編寫研究組織的程式碼」,設定 Agent 的行為與實驗方向。Karpathy 將這個檔案形容為「超輕量的 skill」,讓研究者可以像寫提示詞一樣調整自主研究的策略,這在 AI 自動化研究中屬於相當新穎的互動模式。
autoresearch 與 nanochat 有何關聯?
autoresearch 的訓練程式碼是 Karpathy 先前 nanochat 項目的簡化單 GPU 實現。nanochat 是 Karpathy 推出的開源迷你聊天模型專案,可視為 nanoGPT 精神的延續;autoresearch 從中抽出核心的 GPT 模型與訓練迴圈,去除分散式訓練與複雜設定,聚焦於單一 GPU、單一檔案、單一指標的精簡實驗場景。
autoresearch 的訓練程式碼取自 Karpathy 的 nanochat 項目,做單 GPU 簡化實現,去除分散式與複雜設定,聚焦單一檔案、單一指標的最小自主研究場景。
這樣的設計讓兩者形成互補關係:nanochat 提供功能更完整、平台支援更廣的參考實作,而 autoresearch 則以極度精簡的規模,展示「AI 自主研究」這個概念可被如何落地。對於希望在其他平台(如 MacBook、AMD、Windows RTX)運行 autoresearch 的使用者,社群已發展出多個知名 fork,例如 miolini 的 macOS 版、trevin-creator 的 MLX 版與 jsegov 的 Windows RTX 版,形成一個活躍的二次開發生態。
autoresearch 為何引發開源社區關注?
autoresearch 之所以短時間內累積超過 9.4 萬顆星標,主要在於其「由 AI 教父級人物示範自主研究」的象徵意義。Karpathy 是 AI 領域最具影響力的開發者之一,其親自設計「讓 AI 自己訓練 AI」的框架,被視為自動化機器學習(AutoML)與自主智能體研究走向實用化的重要訊號,也為整個開源社區提供了一個可親手複製、驗證與改造的實驗範本。
項目短時間累積逾 9.4 萬星標,象徵 AI 指標人物親自示範「AI 自主訓練 AI」;它把 AutoML 與自主智能體研究推向實用,並提供可親手複製驗證的開源實驗範本。
從生態層面觀察,autoresearch 引發最多的討論集中在「AI 是否可以取代部分人類研究流程」這個命題。支持者認為,將重複性的超參數調校與架構探索交給自主 Agent,能大幅釋放研究者的時間;另一方面,固定時間預算與單一指標的侷限,也引導社區反思自主研究的邊界。整體而言,autoresearch 讓原本相對遙遠的「自主科研」願景,變成一個任何人都能在單張 GPU 上親自體驗的起點。
autoresearch 的數據表現如何?
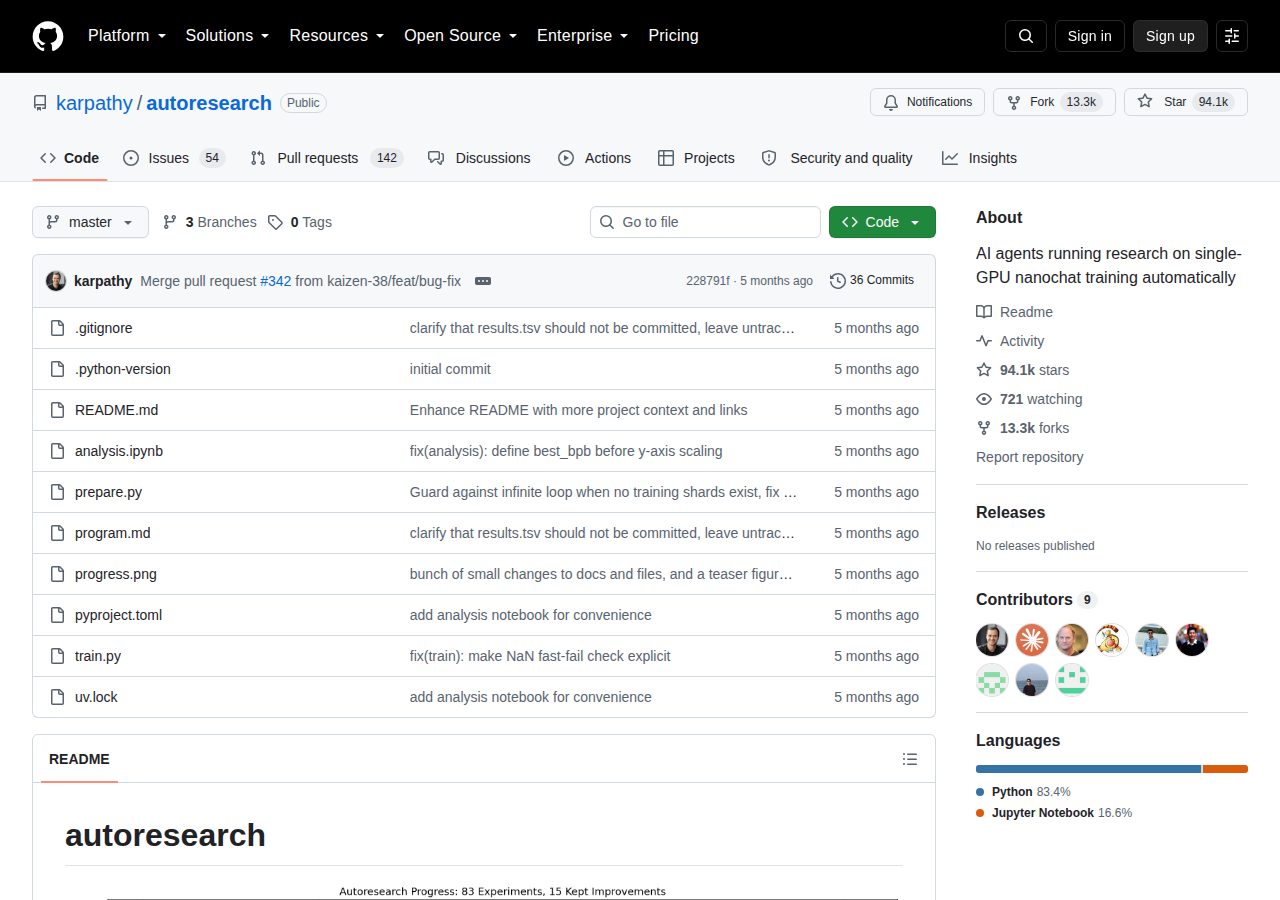
從數據面觀察,autoresearch 以 94,077 顆星標與 13,323 次復刻,在短時間內躋身 AI 開源項目的一線陣營,其 1.4 倍的復刻比值更反映出大量使用者不只是「收藏」,而是實際複製、修改與運行。項目於 2026 年 8 月中旬仍維持活躍提交,顯示作者仍在持續維護與迭代,對於一個以「實驗」為核心的項目而言,持續的更新代表其設計正隨社群回饋而進化。
autoresearch 以 94,077 星標與 13,323 復刻短時間躋身一線,1.4 倍復刻比反映大量實用;2026 年 8 月仍活躍更新,設計隨社群回饋持續進化。
如何快速開始使用 autoresearch?
要快速開始使用 autoresearch,前提是擁有一張 NVIDIA GPU(官方以 H100 實測)、Python 3.10 以上與 uv 套件管理器。
要快速開始使用 autoresearch,前提是擁有一張 NVIDIA GPU(官方以 H100 實測)、Python 3.10 以上與 uv 套件管理器。步驟相當直接:先安裝 uv,執行 uv sync 安裝依賴,再執行 uv run prepare.py 完成一次性資料下載與 BPE tokenizer 訓練(約 2 分鐘),最後以 uv run train.py 手動運行一次約 5 分鐘的訓練以確認環境就緒。
快速開始需 NVIDIA GPU、Python 3.10+ 與 uv:uv sync 安裝、uv run prepare.py 做一次性資料前處理,最後 uv run train.py 手動跑一次 5 分鐘訓練確認環境就緒。
環境確認後即可進入自主研究模式:在 repo 中啟動 Claude、Codex 等編程 Agent 並關閉其權限,然後指示它閱讀 program.md 並啟動新實驗。對於沒有 H100 的使用者,社群 fork 提供了 macOS(MLX)、Windows RTX 與 AMD 等平台支援,Karpathy 並建議在較小算力上改用熵值較低的 TinyStories 資料集、縮小詞彙表與序列長度,以在有限資源下獲得合理結果。
出處連結有哪些?
本篇文章的資訊來源為 autoresearch 的 GitHub 官方儲存庫,包含 README 說明文件、原始程式碼與 Karpathy 在社群發布的相關公開說明。有興趣的讀者可以前往 GitHub 查看原始碼、平台支援討論以及社群開發的各式 fork。
本篇文章資訊來自 autoresearch 官方 GitHub 儲存庫,包括 README、原始碼與作者公開說明;讀者可前往查看原始碼、平台支援與社群 fork。
出處:karpathy/autoresearch — GitHub
常見問題有哪些?
官方要求一張 NVIDIA GPU(以 H100 實測)、Python 3.10 以上與 uv;社群 fork 提供 macOS(MLX)、
總結:autoresearch 的未來前景如何?
autoresearch 以 94,077 顆星標與 13,323 次復刻,展示了「AI 自主研究」由概念走向可運行的具體樣貌。
autoresearch 以 94,077 顆星標與 13,323 次復刻,展示了「AI 自主研究」由概念走向可運行的具體樣貌。它以「單一檔案修改、固定時間預算、單一指標評價」的極簡設計,讓一個 AI Agent 能在單張 GPU 上整夜自主地改碼、訓練與迭代,並透過 program.md 讓研究者在高層次主導實驗方向。對於關注自動化機器學習、自主智能體與 Karpathy 後續動向的開發者,autoresearch 提供了一個既能親手驗證、又能參與改造的開源入口,其後續迭代與社群衍生的生態,值得持續觀察。
autoresearch 以 9.4 萬星標展示 AI 自主研究由概念走向可行運行,極簡設計讓 Agent 在單 GPU 整夜自主迭代;對 AutoML 與自主智能體關注者而言,是一個可親手驗證並參與改造的開源入口。