
codebase-memory-mcp 是 DeusData 維護的開源程式碼智能引擎,在 GitHub 累積 45,834 顆星標與 3,771 次複製。它以純 C 撰寫,透過 Model Context Protocol(MCP)為 AI 編碼代理建立持久化的知識圖譜,官方實測為 Linux 核心(2,800 萬行程式碼、7.5 萬個檔案)建立完整索引僅需 3 分鐘,並宣稱能把 5 次結構查詢的 token 消耗由約 41.2 萬降至約 3,400。專案自 2026 年 2 月公開,最新版本為 2026 年 9 月 15 日發布的 v0.11.0。
codebase-memory-mcp 是純 C 實作的開源程式碼智能引擎,為 AI 編碼代理建立知識圖譜。Linux 核心索引約 3 分鐘,結構查詢省約 99.2% token。
codebase-memory-mcp 是什麼?
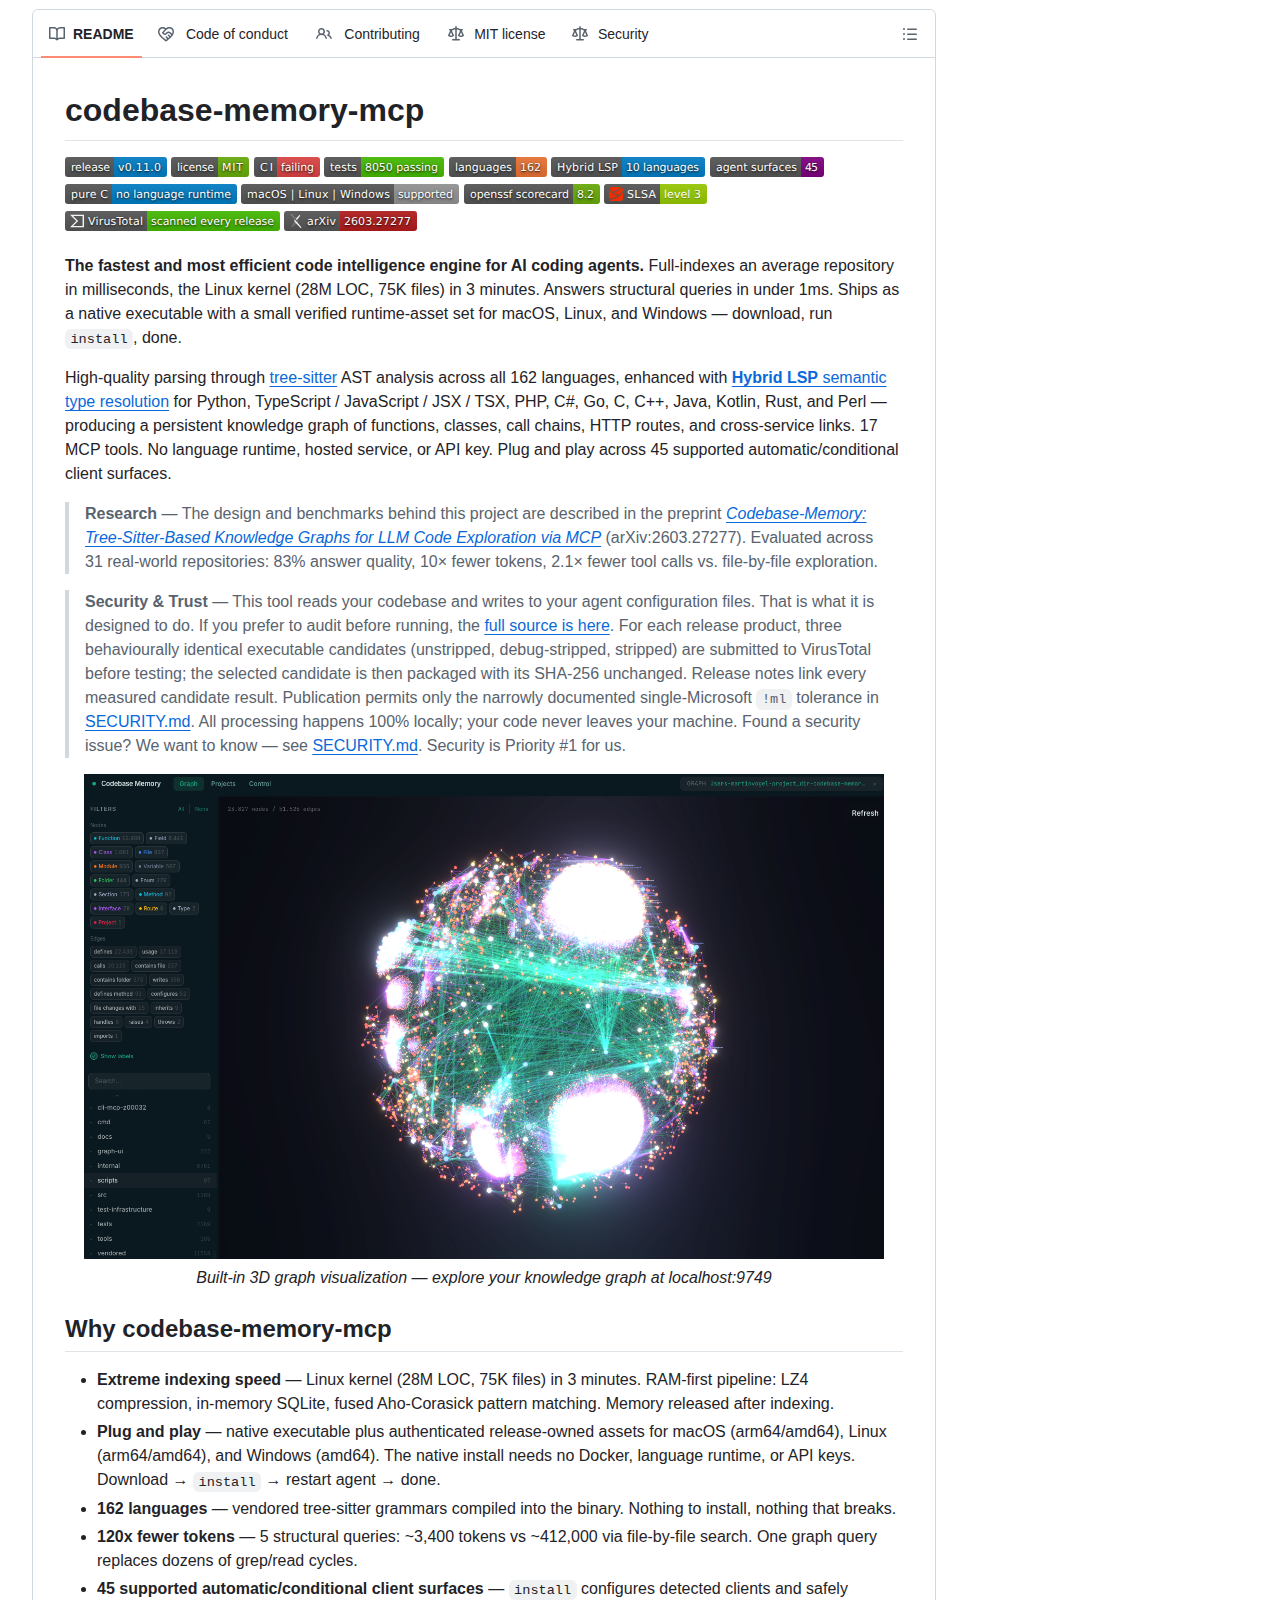
codebase-memory-mcp 是不內建語言模型的結構分析後端,負責建立並查詢程式碼知識圖譜;問題翻譯交給既有 MCP 客戶端,因此不需要額外 API 金鑰。
依照官方說明,這個專案是一套針對 AI 編碼代理設計的程式碼智能引擎,也是目前同類工具中索引速度與 token 效率較突出的實作。它把來源程式碼解析為函式、類別、呼叫鏈、HTTP 路由與跨服務關聯等節點與邊,集中存放在本機的 SQLite 資料庫,讓代理以圖查詢取代逐一讀檔。
專案的關鍵設計取向,是把「理解問題」與「查詢圖譜」拆開。多數程式碼圖工具會在工具內部嵌入語言模型,將自然語言翻譯成圖查詢,代價是額外的 API 金鑰、額外費用與另一個需要設定的模型。codebase-memory-mcp 選擇不做這件事,因為在 MCP 架構下,正在對話的那個代理本身就是查詢翻譯器。
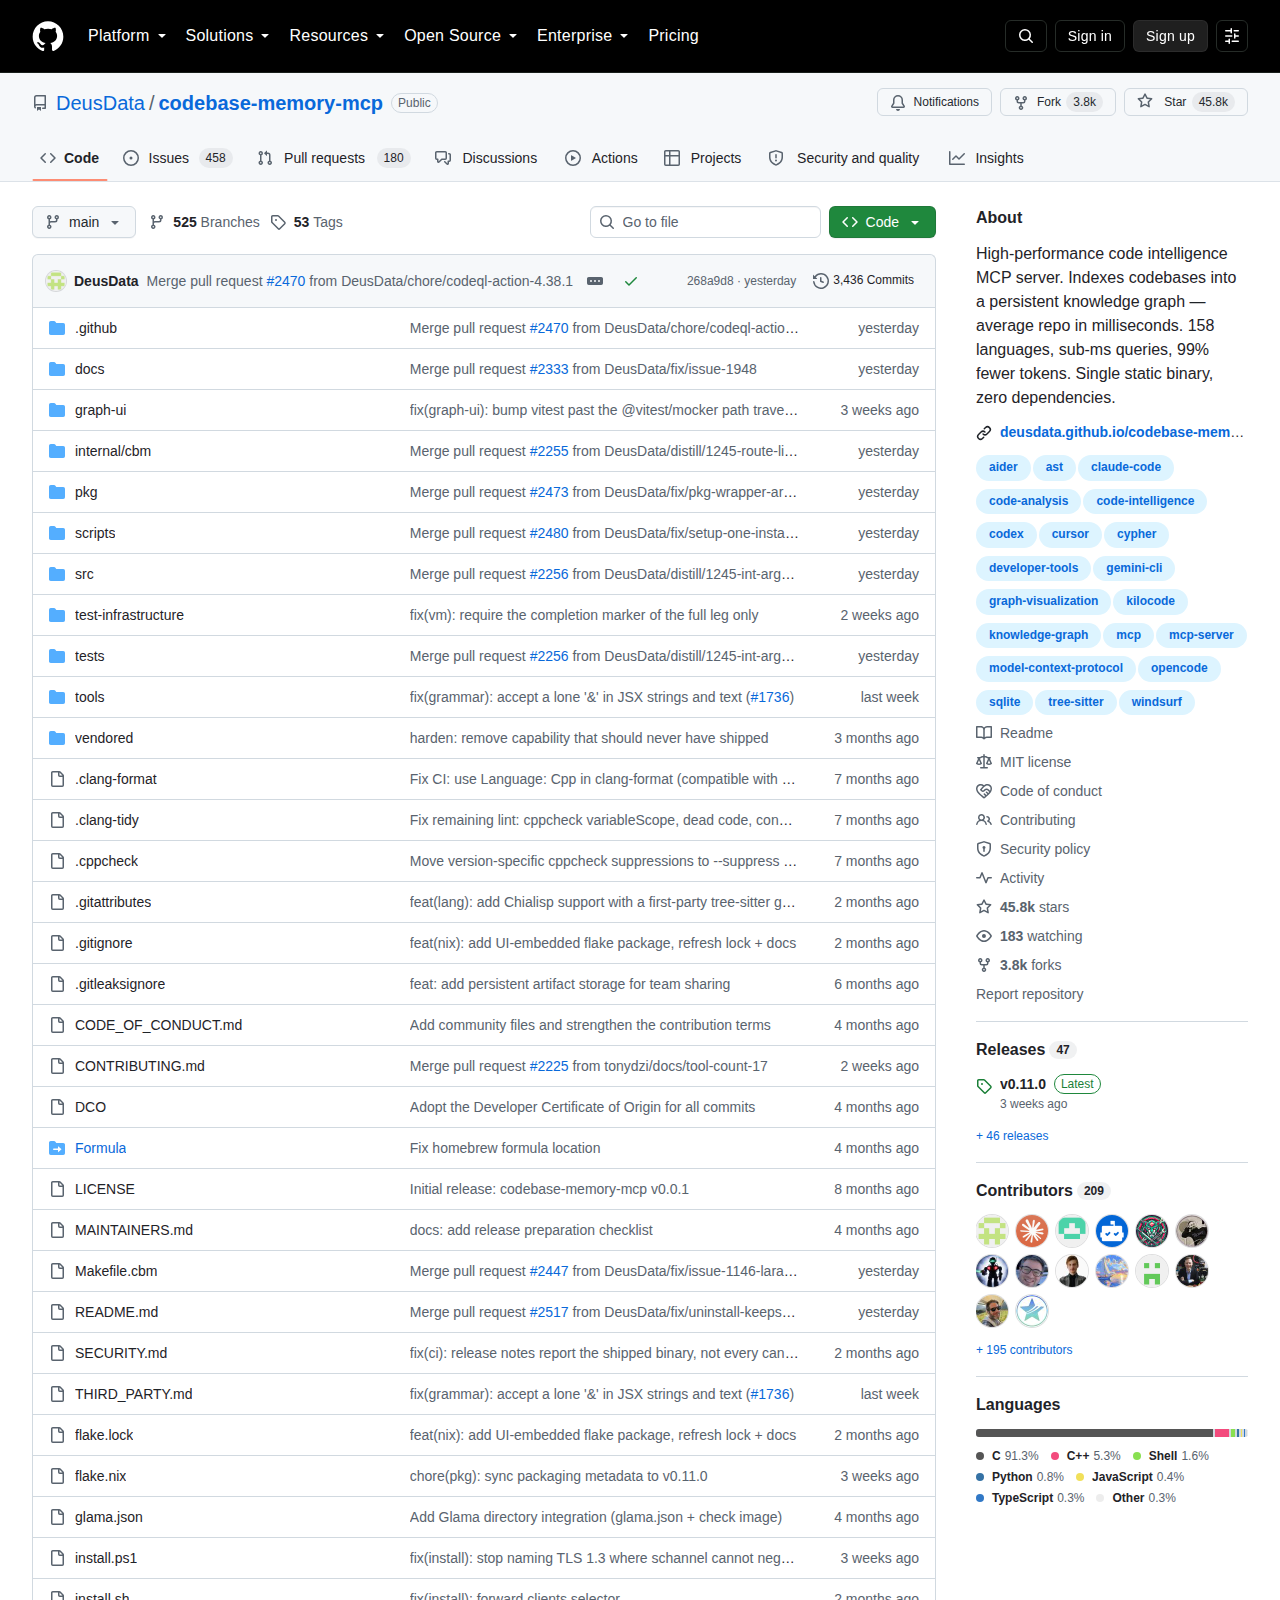
專案由 DeusData 維護,2026 年 2 月 24 日建立,最新發布版本為 v0.11.0。其設計與基準測試方法整理在 arXiv 論文 2603.27277,相關的安裝檔與文件則公開於 deusdata.github.io/codebase-memory-mcp。截至目前已有 169 位貢獻者、3,436 次提交,並在 GitHub 累積 45,834 顆星標與 638 個待處理議題。
codebase-memory-mcp 的索引速度與效能表現如何?
官方以 Apple M3 Pro 實測,Linux 核心完整索引 3 分鐘,產出 481 萬節點與 772 萬條邊;Django 全索引約 6 秒,Cypher 查詢低於 1 毫秒。
在官方公布於 Apple M3 Pro 的基準測試中,Linux 核心的完整索引耗時 3 分鐘,處理範圍為 2,800 萬行程式碼與 7.5 萬個檔案,產出 481 萬個節點與 772 萬條邊;若改用快速索引模式,同一份程式碼可在 1 分 12 秒內完成,節點數為 188 萬。中小型專案的速度差距更明顯,Django 的完整索引約 6 秒,即產生 4.9 萬個節點與 19.6 萬條邊。
查詢端的延遲同樣壓在毫秒等級。官方數據顯示,Cypher 關係遍歷低於 1 毫秒,名稱正規表達式搜尋低於 10 毫秒,深度為 5 的呼叫路徑追蹤同樣低於 10 毫秒,而需要掃描全圖的死碼偵測約需 150 毫秒。這些數字反映的是資料庫層的查詢成本,而非代理端往返對話的總時間。
達成這種速度的關鍵,是把索引流程設計為記憶體優先。專案以 LZ4 高壓縮讀取、記憶體內 SQLite 與單次落盤收尾,並在索引完成後把記憶體釋放回作業系統。對需要在 CI 環境或筆記型電腦上反覆重建圖譜的團隊而言,這種取捨直接決定了工具能否融入日常工作流程。
codebase-memory-mcp 如何降低 AI 代理的 token 消耗?
官方以 5 次結構查詢對照,透過圖查詢消耗約 3,400 個 token,改用逐檔 grep 探索則需約 41.2 萬個,減幅 99.2%,原因是單次圖查詢可取代數十輪讀檔。
專案在說明文件中以 5 次結構查詢作為對照:若透過圖查詢完成,累計消耗約 3,400 個 token;若改用逐檔 grep 與讀檔的傳統做法,同一組問題需要約 41.2 萬個 token,換算下來減少約 99.2%。這個差距並非來自摘要或壓縮技巧,而是查詢方式的根本差異。
傳統代理要回答「誰呼叫了 ProcessOrder」,通常必須先搜尋檔名、再開啟多個候選檔案、逐段確認呼叫位置,過程中大量與問題無關的程式碼一併進入上下文。codebase-memory-mcp 則把答案預先計算成圖上的邊,代理只需一次查詢即可取得呼叫鏈,前後投入的內容量因此差距懸殊。
這項特性對長時段、多輪次的代理工作尤其關鍵。上下文預算往往是最先耗盡的資源,減少無效讀檔不僅省下費用,也讓代理在單次工作階段內能處理更複雜的任務。官方強調,這個數字必須以相同輸入重現才具意義,因此文件同時提供量測方法供團隊在自身工作負載上驗證。
codebase-memory-mcp 的技術架構有什麼特色?
以純 C 實作,內建 158 套 tree-sitter 語法與 Hybrid LSP 型別推斷,採記憶體優先索引;對外提供 17 個 MCP 工具,並內建 3D 圖譜視覺化介面。
解析層採用 tree-sitter 抽象語法樹分析,把 158 套語法檔案直接編譯進執行檔,官方標示可解析 162 種語言,因此不需要額外安裝解析器。在此之上,專案以 Hybrid LSP 補足語意型別解析,涵蓋 Python、TypeScript 與其 JSX 變體、PHP、C#、Go、C、C++、Java、Kotlin、Rust 與 Perl,處理參數綁定、回傳型別推斷、泛型替換與方法多載等情形。
圖譜層把常見語言概念轉為節點與邊,包括呼叫關係的 CALLS、跨服務的 HTTP_CALLS 與 ASYNC_CALLS、事件通道的 EMITS 與 LISTENS_ON、資料流的 DATA_FLOWS,以及以 MinHash 相似度計算的 SIMILAR_TO。專案亦支援跨儲存庫的 CROSS 系列邊,讓多個 repo 索引在同一儲存區時可以一併查詢與視覺化。
對外介面共有 17 個 MCP 工具,涵蓋架構總覽、呼叫路徑追蹤、影響分析、索引覆蓋檢查、Cypher 查詢、死碼偵測與架構決策紀錄管理。搜尋能力則由三條路徑組成:以 Nomic 嵌入模型實作的語意搜尋、SQLite FTS5 的 BM25 全文檢索,以及圖上的結構化搜尋。語意搜尋的向量模型隨執行檔一同打包,不需 API 金鑰、Ollama 或 Docker。
在部署形態上,專案以單一原生執行檔提供,不依賴 Docker、語言執行環境或對外服務,資料落盤於本機快取目錄。它同時內建 3D 圖譜視覺化介面,預設在 localhost 的 9749 埠提供,並由共用的協調常駐程序管理,避免多個代理工作階段重複啟動伺服器。
codebase-memory-mcp 有哪些實際應用場景?
主要場景包括大型專案的架構導航、提交前的影響分析與風險分類、死碼清理、跨服務路由比對,以及以單一壓縮檔在團隊間共享圖譜、讓同事免去重新索引。
第一個場景是陌生或大型專案的架構導航。get_architecture 可在單次呼叫中回傳語言、套件、進入點、路由、熱點、邊界、分層與叢集,並以 Louvain 社群偵測歸納功能模組。對剛接手既有系統的代理而言,這能取代大量翻找目錄與猜測模組關係的過程。
第二個場景是提交前的影響分析。detect_changes 會把未提交的變動對應到受影響的符號,並附上風險分類;死碼偵測則找出沒有任何呼叫者的函式,同時排除合法的進入點。這兩項能力把「改動會影響什麼」從人工推測變成可查詢的結果。
第三個場景是跨服務與跨儲存庫的關聯分析。專案能比對 HTTP 路由與呼叫位置並附上信心分數,亦支援 gRPC、GraphQL 與 tRPC 的服務偵測。此外,團隊可以把圖譜匯出為 .codebase-memory 目錄下的單一 zstd 壓縮檔提交進儲存庫,同事首次執行時直接匯入,省下完整重建索引的成本;官方提醒這個檔案每次索引都會改寫,提交頻率需刻意控制,否則版控歷史會快速膨脹。
codebase-memory-mcp 的關鍵數據有哪些?
儲存庫累積 45,834 顆星標與 3,771 次複製,169 位貢獻者、3,436 次提交;最新版本 v0.11.0 於 2026 年 9 月 15 日發布,採 MIT 授權。
- 45,834星標
- 3,771複製數
- 169貢獻者
- 162支援語言
- 17MCP 工具
- MIT授權條款
- C主要語言
- v0.11.0最新版本
上述統計以 2026 年 10 月 5 日的儲存庫狀態為準。專案於 2026 年 2 月 24 日建立,至 10 月 5 日仍在持續提交,README 標示的 45 個代理介面、158 套 tree-sitter 語法與 162 種語言解析能力,均隨版本更新調整。v0.11.0 的發布頁面附有 49 個平台對應的建置資產,涵蓋 macOS、Linux 與 Windows。
codebase-memory-mcp 在開源程式碼智能生態中處於什麼位置?
它填補「AI 代理查詢程式碼結構」這一層,與 RAG 檢索互補;差異在於純 C 原生執行檔、無外部相依與遙測,也不綁定特定模型。
近兩年程式碼智能工具快速分化。一類偏向自然語言問答,把程式碼切片後交給向量資料庫檢索;另一類維持傳統搜尋與索引,強調速度與可預測性。codebase-memory-mcp 屬於後者,但把輸出物件定義為圖而非文字區塊,因此特別適合需要精確關係的查詢,例如呼叫鏈與影響範圍。
與同類專案相較,它的差異集中在部署與信任模型。純 C 實作與靜態連結意味著不需要 Python 或 Node 執行環境,安裝後即可執行;官方文件也強調執行檔不會自行發出網路請求,不在背景檢查版本,並不收集遙測。對於受規範或離線環境,這些條件往往比功能清單更具決定性。
值得注意的是,專案並未取代既有的檢索方案。語意搜尋在詞彙不匹配時仍有價值,而 BM25 全文檢索適合關鍵字明確的查詢,圖查詢則處理結構關係。三者互補而非互斥,官方在文件中亦將自身定位為既有生態的補強層,並以 OpenSSF Scorecard 與 SLSA 3 等級的建置流程強化供應鏈信任。
codebase-memory-mcp 如何安裝與開始使用?
macOS 與 Linux 可執行官方安裝腳本,Windows 用 PowerShell;亦可透過 npm、pip、Homebrew 安裝,執行 install 即完成設定。
官方提供的一行安裝指令透過 curl 取得安裝腳本並執行,Windows 則改以下載並執行 PowerShell 版本。若偏好套件管理員,專案已上架 npm、PyPI、Homebrew、Scoop、Winget、Chocolatey 與 AUR,也可透過 go install 取得。安裝完成後執行內建的 install 命令,會自動偵測並設定本機已存在的代理客戶端。
安裝程式支援 45 種自動或條件式客戶端介面,包含 Claude Code、Codex、Cursor、Gemini CLI、OpenCode、Windsurf、Kilo Code 與 Aider 等。對於需要額外設定檔或特定平台標記的客戶端,安裝程式只在其條件成立時才啟用,避免改動非預期項目。由於設計上不需要 API 金鑰或語言執行環境,安裝完成的判斷標準就是執行檔可執行、代理可連上 MCP。
啟用自動索引後,新專案會在首次連線時建立圖譜,既有專案則交由背景監看程序依 git 變更增量更新。官方亦提供命令列模式,可在不安裝代理的情況下直接下達圖查詢,以及在 localhost 的 9749 埠開啟 3D 圖譜介面。設定變更如停用監看,需先停止常駐程序再重新連線,因為部分選項只在程序啟動時讀取。
codebase-memory-mcp 的授權與隱私政策如何?
專案以 MIT 授權開源,可免費用於商業專案。所有索引與查詢在本機執行,不收集遙測,程式碼與查詢內容不會離開使用者機器;診斷記錄須由使用者主動開啟才會產生。
授權方面,專案採用 MIT 條款,允許自由使用、修改與再散布,包含商業用途。發行檔案附有 checksums.txt 提供 SHA-256 雜湊,官方並以 OpenSSF Scorecard 與 SLSA 3 等級的建置流程標示供應鏈完整性,每次發布亦經過 VirusTotal 掃描。
隱私方面,官方明確表示工具百分之百在本機執行且不收集遙測,程式碼、查詢內容、環境與使用情形都不會離開使用者的機器。由於執行檔不會自行發出網路請求,也不在背景檢查新版本,使用者需透過安裝腳本、套件管理員或 GitHub 得知更新。
這項保證也帶來取捨:當使用者遇到官方無法重現的問題時,維護者手上沒有資料可分析。因此專案提供以環境變數開啟的診斷模式,把記憶體軌跡與快照寫入本機暫存目錄,由使用者自行決定是否提供。這既是隱私設計的必然結果,也意味著回報問題時需要使用者主動配合。
出處連結有哪些?
本文資訊整理自 codebase-memory-mcp 的 GitHub 儲存庫、官方文件與 v0.11.0 發布說明,效能數據以專案 README 公布內容為依據。
- GitHub 儲存庫:https://github.com/DeusData/codebase-memory-mcp
- 官方文件網站:https://deusdata.github.io/codebase-memory-mcp/
- v0.11.0 發布說明:https://github.com/DeusData/codebase-memory-mcp/releases/tag/v0.11.0
- 設計與基準測試論文:https://arxiv.org/abs/2603.27277
常見問題有哪些?
常見疑問集中在是否需要 API 金鑰、支援的語言與代理範圍、與既有檢索工具的差異,以及團隊共享圖譜的提交策略,多數可在官方 README 與文件中找到說明。
使用 codebase-memory-mcp 需要 API 金鑰嗎?
不需要。工具本身不內建語言模型,語意搜尋所用的嵌入模型已隨執行檔打包,理解問題的工作由既有的 MCP 客戶端負責,因此無需額外金鑰、Ollama 或 Docker。
它支援哪些程式語言與代理?
官方標示可解析 162 種語言,語法檔案直接編譯進執行檔;Hybrid LSP 另針對 Python、TypeScript、Go、Rust、Java、C# 等提供語意型別解析。安裝程式支援 45 種自動或條件式的代理客戶端介面。
它與向量資料庫檢索有什麼不同?
向量檢索回傳的是相關程式碼片段,圖查詢回傳的是精確關係,例如呼叫鏈與影響範圍。兩者互補,官方亦將自身定位為既有檢索方案的補強層,而非替代品。
團隊可以共享索引結果嗎?
可以。索引時開啟持久化選項會產生 .codebase-memory 目錄下的單一 zstd 壓縮檔,提交後同事首次執行即可匯入。由於每次索引都會改寫該檔案,建議依發布或里程碑控制提交頻率,避免版控歷史膨脹。
索引會上傳到雲端嗎?
不會。索引與查詢全部在本機執行,資料存放於本機快取目錄,工具不收集遙測,也不主動發出網路請求。診斷記錄須由使用者以環境變數主動開啟。
如何更新到新版本?
更新由安裝腳本執行,而非執行檔本身。在 macOS 與 Linux 上重新執行 install.sh 即為更新,Windows 則重跑 install.ps1;若透過 npm 或 pip 安裝,改用對應的套件管理員指令升級。
總結:codebase-memory-mcp 適合什麼團隊?
適合以 AI 代理處理中大型程式碼庫、且重視本機執行與低 token 成本的團隊;若已依賴雲端索引服務,建議先以自身工作負載實測。
這個專案切中的問題相當具體:代理的能力上限,往往取決於它能多快取得正確的程式碼上下文。把結構關係預先計算成圖,讓查詢從多輪讀檔收斂為單次遍歷,既降低 token 成本,也縮短回應時間。純 C 原生執行檔與零外部相依的組合,則使它容易進入 CI、容器與離線環境。
判斷是否採用時,可以從三個條件檢視。若團隊的痛點在於代理反覆讀檔、上下文快速耗盡,或需要可靠的呼叫鏈與影響分析,這套工具的方向與需求高度一致;若工作負載以關鍵字檢索為主、專案規模不大,則既有工具的收益可能有限;若既有流程已深度綁定雲端索引服務,遷移成本需要一併評估。
以 45,834 顆星標、169 位貢獻者與半年內累積 3,436 次提交的節奏來看,專案仍處於快速迭代階段,v0.11.0 與 638 個待處理議題也反映功能與修補同步推進。對於願意跟隨版本更新、並重視本機執行的團隊而言,這是一項值得納入評估的工具。