
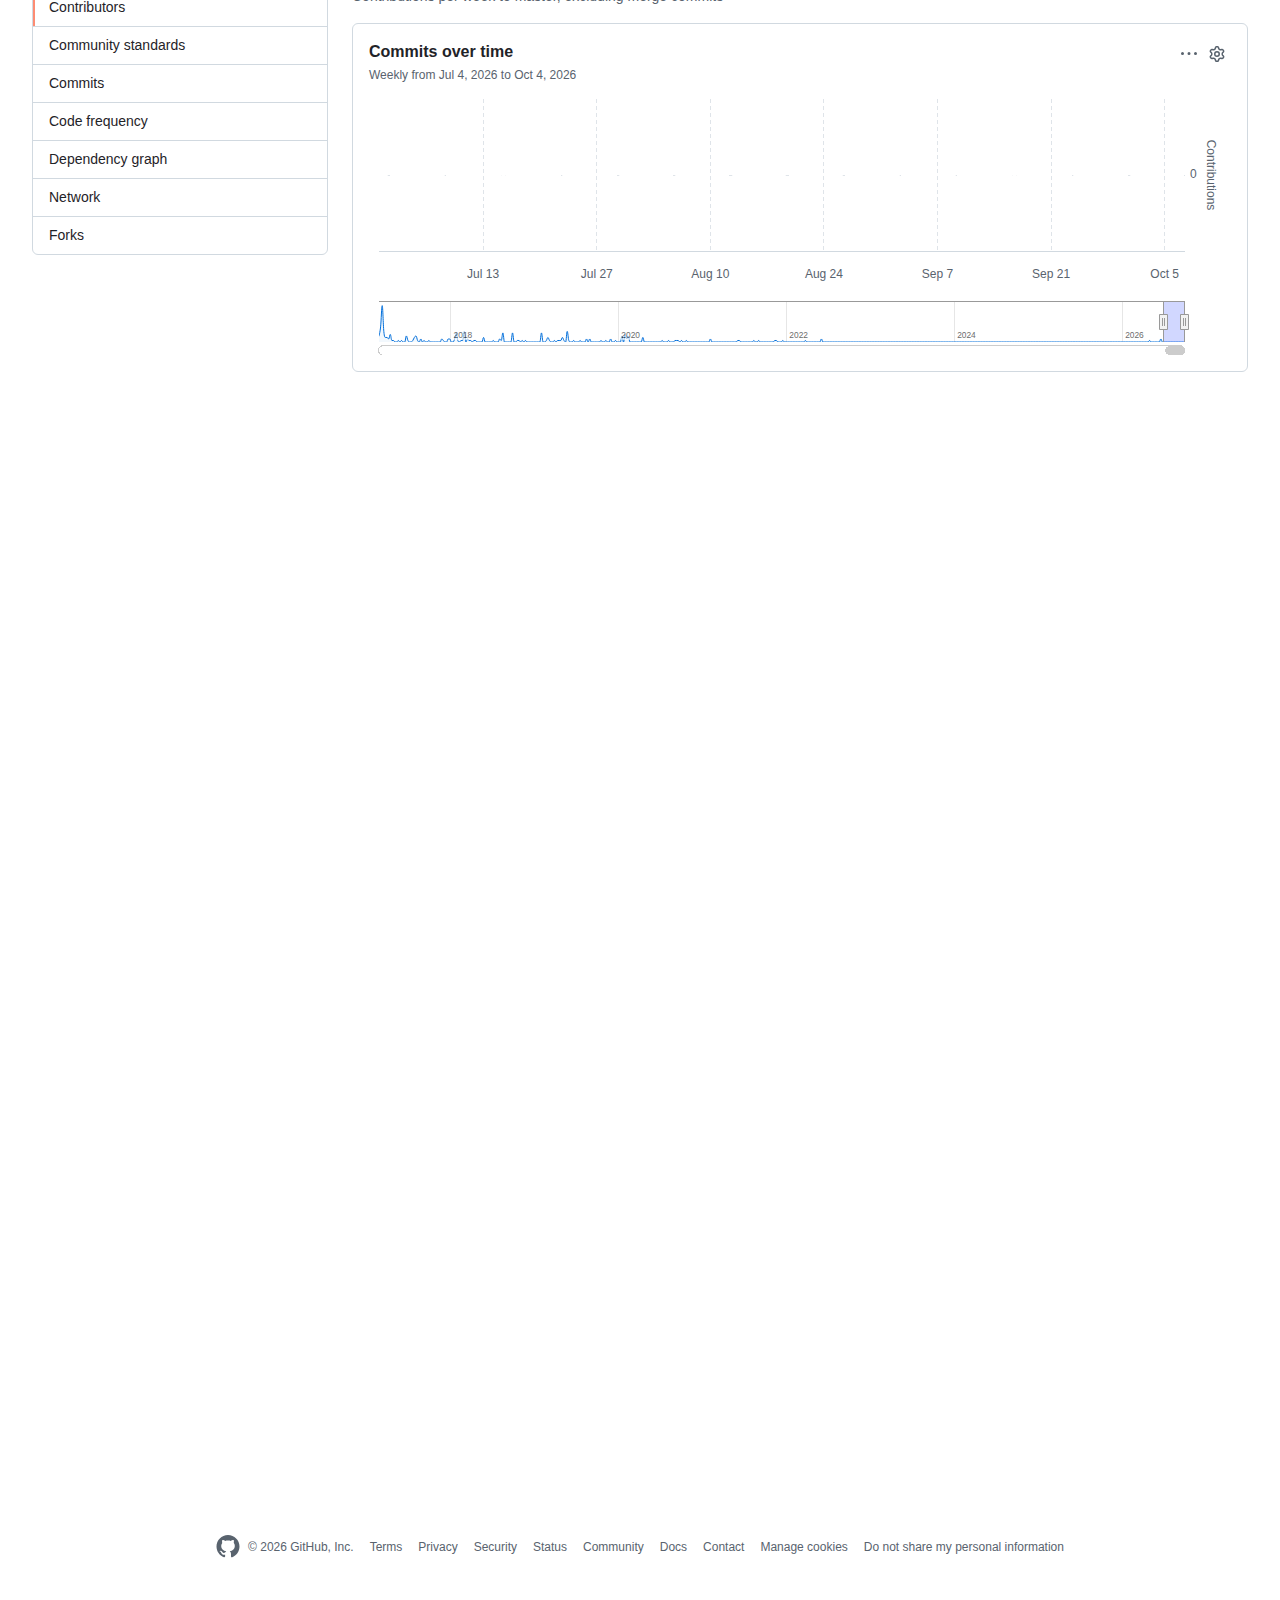
face_recognition 是 GitHub 上累積 56,804 顆星標與 13,675 次 fork 的 Python 人臉辨識函式庫,由開發者 Adam Geitgey 於 2017 年 3 月發布,採用 MIT 授權。該項目以 dlib 的深度學習人臉辨識模型為基礎,在 Labeled Faces in the Wild(LFW)基準測試中達到 99.38% 準確率,並把原本需要自行組合模型、對齊人臉、計算特徵向量的流程,簡化為數行程式碼即可呼叫的 API。時至 2026 年,該儲存庫仍維持每週更新的提交紀錄,是電腦視覺領域被引用最久、最廣泛的入門項目之一。
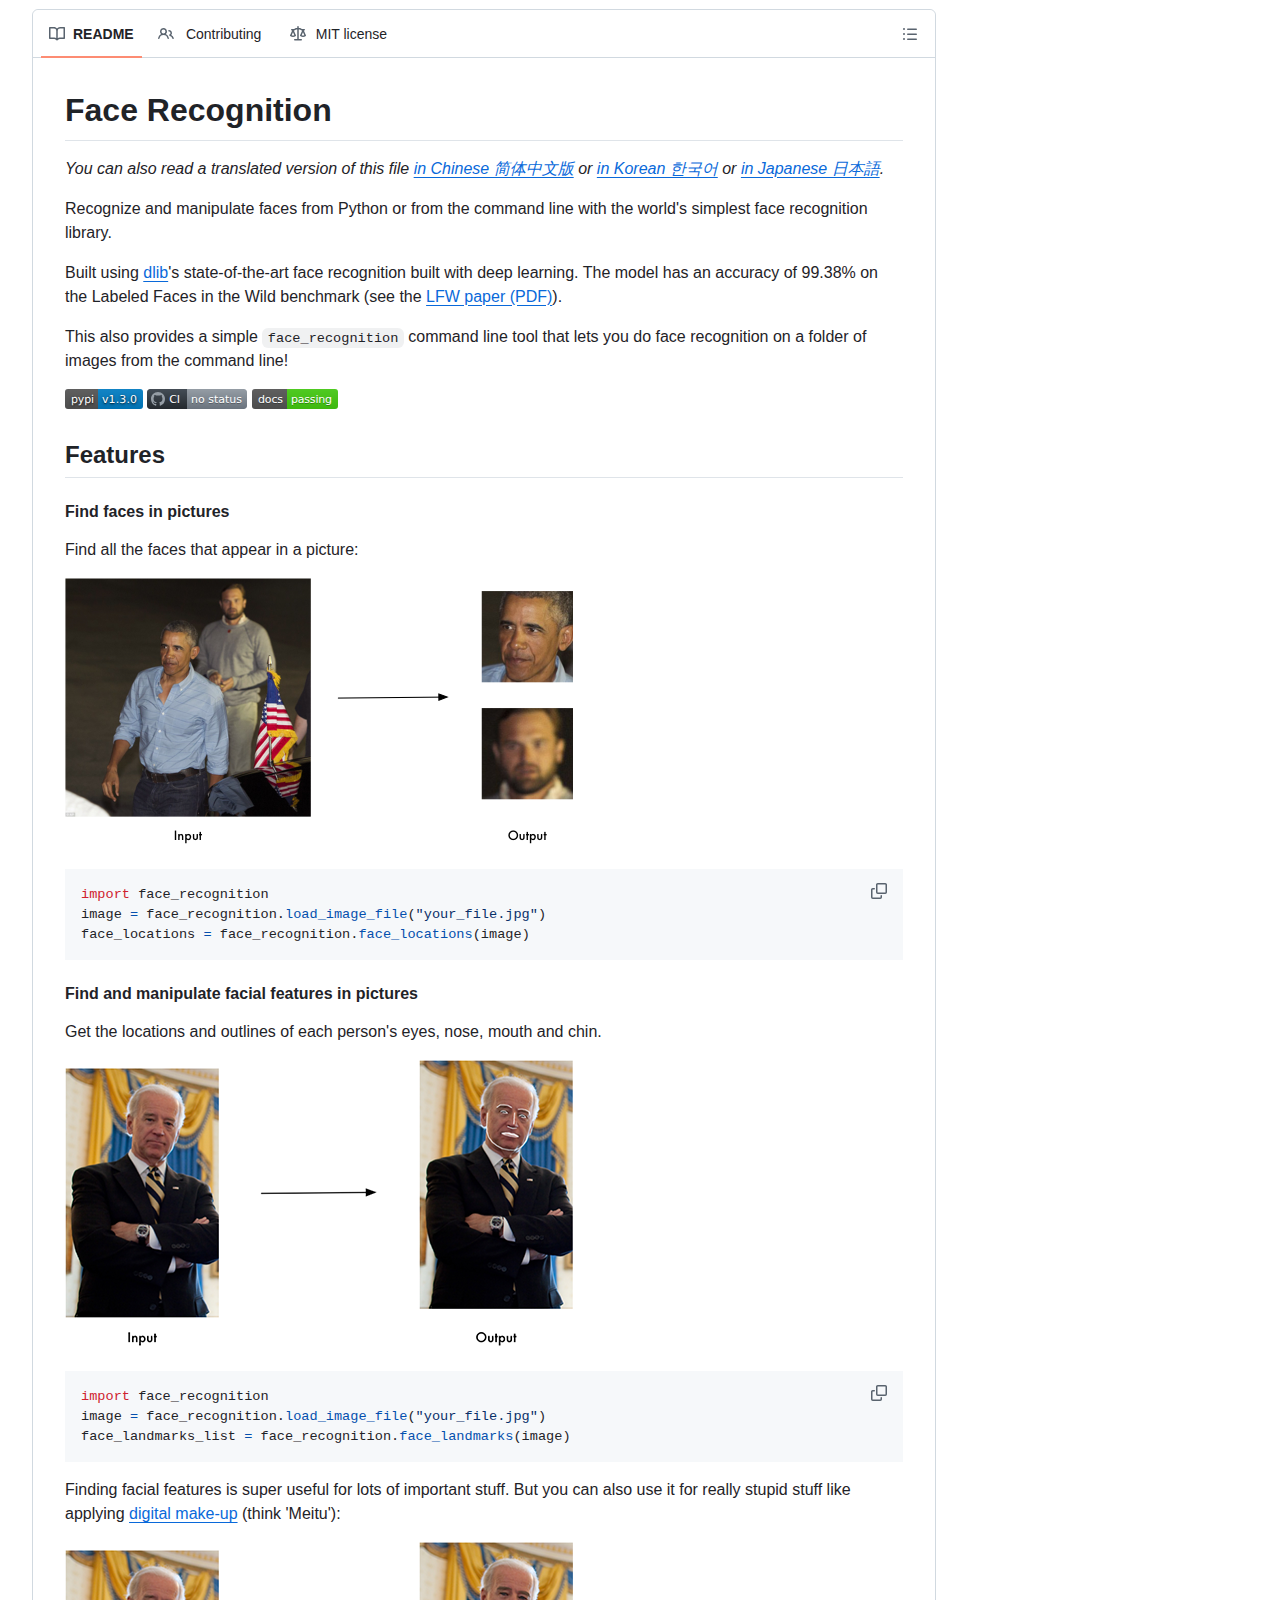
face_recognition 是以 dlib 為底層的 Python 人臉辨識函式庫,採 MIT 授權,LFW 基準準確率 99.38%,支援命令列與 Python API。
face_recognition 是什麼?
它把 dlib 深度學習模型包裝成人臉辨識 API,同時提供臉部偵測與身份比對工具,可輸出人臉座標、五官輪廓與比對結果。
該項目的定位十分明確:把學術等級的人臉辨識能力,包裝成一般開發者能在數分鐘內上手的工具。使用者安裝後會同時取得兩個命令列程式,其中 face_detection 負責找出圖片或資料夾中每張人臉的像素座標,face_recognition 則在偵測之上加入身份比對功能。兩者都能直接對整個資料夾批次處理,輸出格式為逗號分隔的純文字,方便接入既有腳本或資料流程。
在 Python 層面,該函式庫提供 load_image_file、face_locations、face_landmarks、face_encodings 與 compare_faces 等函式,把人臉偵測、五官定位與特徵向量比對各自獨立成單一入口。開發者無須理解 dlib 的內部結構,只要載入圖片、取得 128 維特徵向量,再比較向量距離,就能完成一次辨識。這種設計使該項目長年被列為電腦視覺教學的基礎教材,也讓它成為許多產品原型驗證階段的第一個選擇。
它的辨識準確率與技術架構如何?
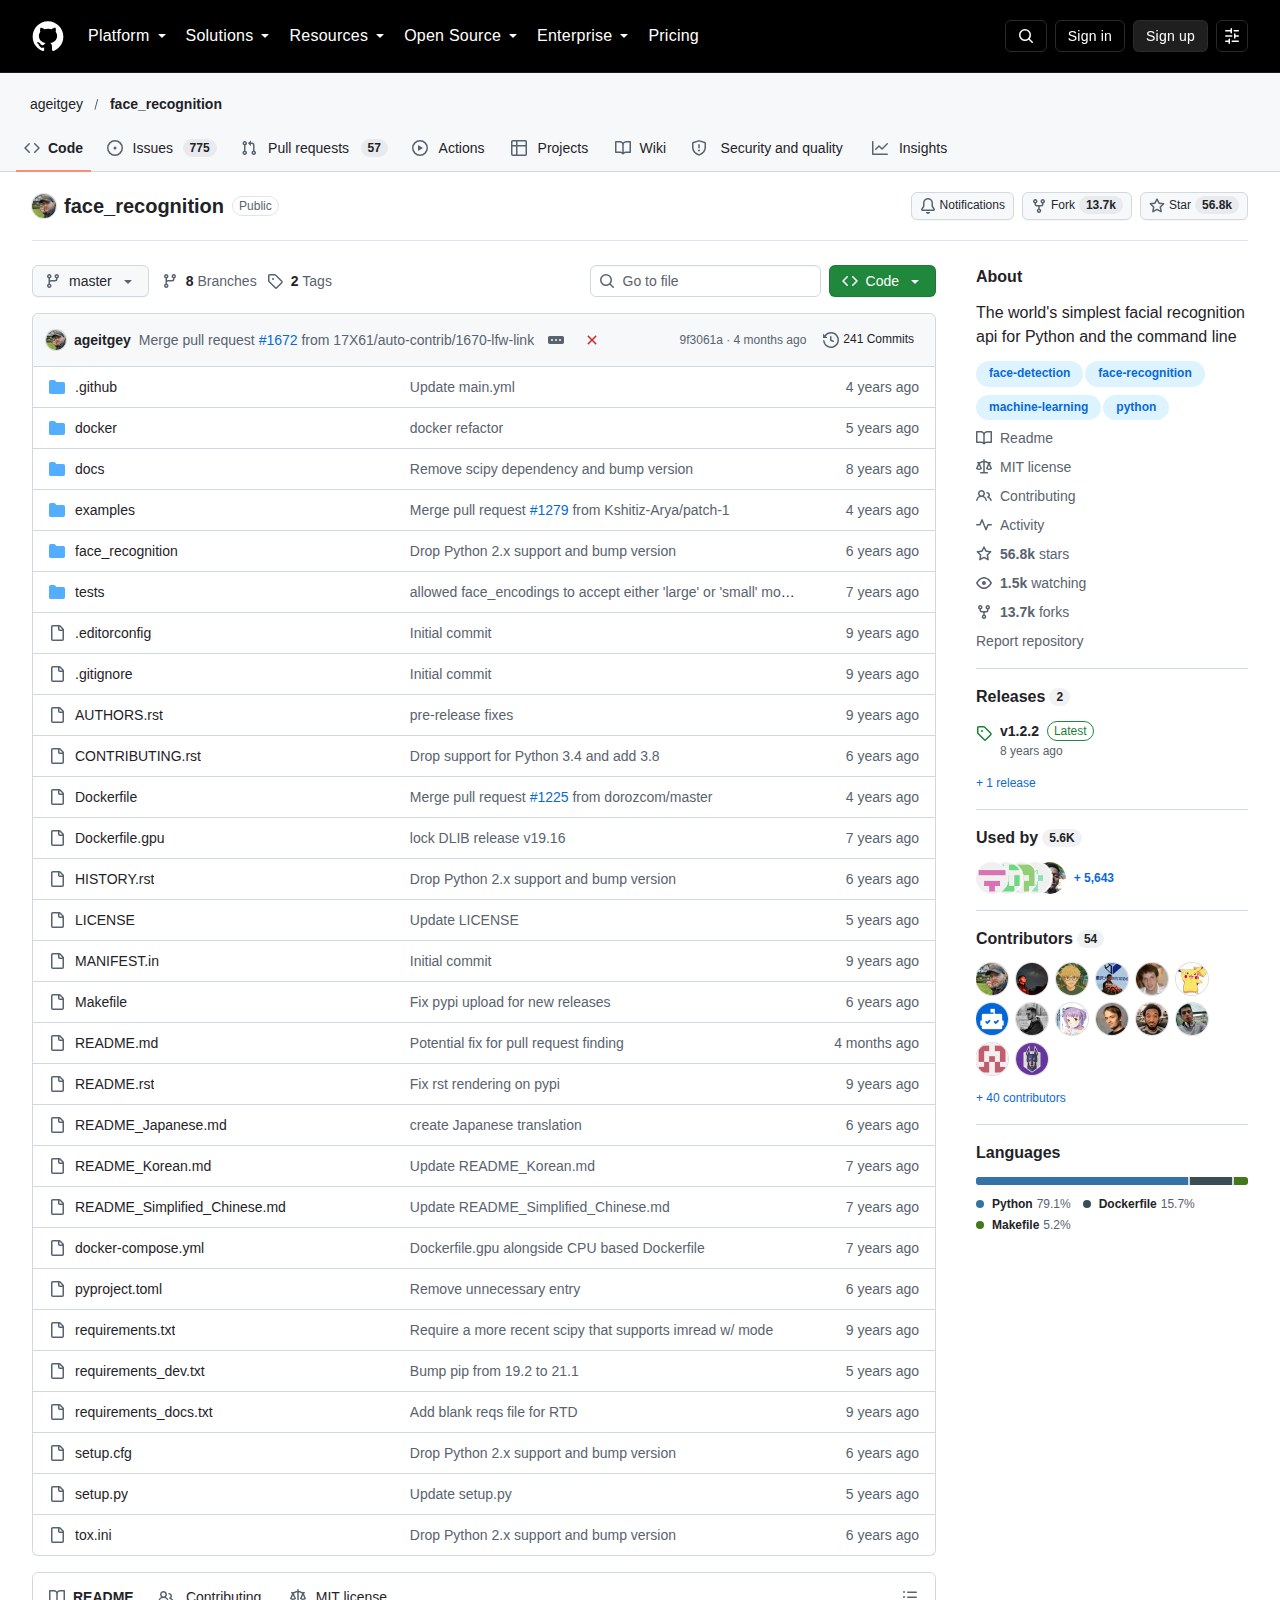
底層為 dlib 的深度學習人臉模型,LFW 準確率 99.38%;流程分偵測、五官對齊與 128 維特徵向量比對,並以歐氏距離及預設容差 0.6 判定。
官方 README 明確標示,該項目建構於 dlib 的人臉辨識模型之上,該模型在 LFW 基準測試的準確率為 99.38%。LFW 是學界常用的人臉驗證資料集,主要用於評估「這一張與那一張是否為同一人」的判定能力,因此這個數字代表的是成對驗證任務的表現,而非任意環境下的通用水準。
pipeline 由三個階段組成。第一階段是偵測,預設使用方向梯度直方圖(HOG)模型,在 CPU 上即可執行,若改用 model="cnn" 參數則會切換至基於 CNN 的偵測器,精確度更高但需要 NVidia CUDA 加速才有較好表現。第二階段是對齊與特徵抽取,系統會找出眼睛、鼻子、嘴巴與下巴的輪廓位置,據此校正姿態,再輸出 128 維的人臉特徵向量。第三階段是比對,透過比較兩組向量的歐氏距離判斷是否為同一人。
判定門檻由 --tolerance 參數控制,預設值為 0.6。距離數值越小代表兩張臉越接近,降低容差值可以讓比對更嚴格。README 指出,若同一人被重複辨識成多個結果,通常表示照片中的人物外觀相近,此時應調低容差。搭配 --show-distance true 參數,使用者可以印出每一筆比對的實際距離,據此反覆校準適合自身資料集的門檻,而不必憑感覺猜測。
值得留意的是模型的適用邊界。官方文件同時說明,該模型在兒童人臉與非白人族群的準確率存在落差,且對側臉、遮蔽與低光源環境較為敏感。這意味 99.38% 的數字必須放在 LFW 的資料分佈下理解,直接用於門禁、身分驗證等高風險場景之前,仍需要以自身資料重新評估誤判率。
如何開始使用 face_recognition?
先安裝 dlib 與 cmake,再以 pip 安裝,即可用 Python 模組或命令列操作;大量圖片可加 –cpus 參數平行加速。
安裝流程需要先處理相依項目。官方建議在 macOS 或 Linux 環境先從原始碼安裝帶有 Python 綁定的 dlib,並確保安裝 cmake,之後再以 pip3 install face_recognition 取得函式庫。README 亦列出 Docker、預先配置好的虛擬機映像,以及 FreeBSD 的套件安裝方式,降低環境準備的門檻。Windows 並非官方支援平台,但社群提供了可用的安裝指引。
命令列工具的使用方式相當直接。使用者準備一個每張照片對應一人的已知人物資料夾,以及一個待辨識的資料夾,執行 face_recognition ./pictures_of_people_i_know/ ./unknown_pictures/,程式便會逐張輸出檔名與對應人物名稱;無法匹配的臉孔會標記為 unknown_person。若只需要批次偵測臉部位置而不做身份比對,改用 face_detection 指令即可取得每張臉的左上、右上、右下與左下像素座標。
效能方面,該工具支援多核心平行處理。在 Python 3.4 以上的環境,加上 --cpus 4 參數即可指定使用的核心數量,--cpus -1 則會用盡系統所有核心;官方說明在四核心機器上,同樣時間內可處理的圖片量約為單核心的四倍。對於需要在邊緣裝置運作的場景,README 分別提供了 Nvidia Jetson Nano 與 Raspberry Pi 2 以上的安裝說明,後者更附上社群整理的操作指南。
它為什麼能長期保持高人氣?
它把學術級人臉辨識壓縮成數行 API,安裝文件涵蓋 macOS、Linux、Docker 與樹莓派,社群提交持續合併,使 5.7 萬星標的熱度橫跨九年未減。
該項目的人氣並非來自演算法創新,而是來自封裝品質。2017 年發布時,要在 Python 環境完成一次人臉辨識,往往需要自行編譯 dlib、處理模型檔案路徑、實作特徵比對邏輯,並各自解決跨平台編譯問題。該項目把這些步驟全部收斂為 pip3 install 加上數行程式碼,並針對安裝失敗最常見的作業系統情境逐一提供指引,直接降低初學者的放棄率。
文件完整度是第二個關鍵。README 除了 API 說明,還附上偵測、五官標記、數位化妝、即時網路攝影機辨識等可執行範例,開發者能從範例切入理解參數行為。中、日、韓文的社群翻譯版本進一步擴大了觸及範圍,使該項目在非英語系教學圈同樣廣為流傳。
第三個因素是維護節奏。儲存庫自 2017 年建立以來持續合併提交,2026 年 6 月仍有更新紀錄,社群成員不斷回報並修正不同平台的安裝問題。1,541 名關注者與超過 13,000 次 fork 形成穩定的外部貢獻來源,讓這個以入門定位為主的項目,在九年之後仍具備實用價值。同類競品多以更高的辨識精度或更新的模型架構為訴求,但需要更長的環境準備與調校時間,該項目的位置因此始終穩固。
face_recognition 的統計數據與授權條件是什麼?
該項目累積 56,804 顆星標、13,675 次 fork 與 1,541 名關注者,以 Python 撰寫、採 MIT 授權,允許商業使用與修改,最新提交紀錄為 2026 年 6 月。
出處連結有哪些?
本文資訊整理自 ageitgey/face_recognition 的 GitHub 儲存庫 README 與官方 API 文件,包括 LFW 基準數據、安裝指引與命令列參數說明。
- GitHub 儲存庫:https://github.com/ageitgey/face_recognition
- 官方 API 文件:https://face-recognition.readthedocs.io/en/latest/face_recognition.html
總結:face_recognition 適合什麼團隊?
它適合需要快速驗證人臉辨識概念的原型團隊、教學單位與邊緣裝置專案;若要投入高風險的身分驗證場景,須先以自身資料重新評估準確率與偏誤風險。
face_recognition 的價值在於把高門檻的電腦視覺能力轉為低門檻的工具鏈。對需要在一週內交出可運作原型的團隊、以人臉辨識為主題的課程設計者,或是想在樹莓派與 Jetson Nano 上實作邊緣應用的開發者而言,它依然是準備成本最低的切入點。相反的,若應用場景涉及門禁、支付或身份驗證等要求高可靠度的場合,則不宜直接採用單一模型輸出的判定結果,應先以自身資料集量測準確率,並評估不同族群與光線條件下的偏誤。
在生成式 AI 大量吸走開發者注意力的當下,這個 2017 年發布的專案仍以每週提交維持運作,說明基礎工具的生命週期往往長於熱潮本身。當電腦視覺能力被整合進更大型的代理系統時,這類穩定、文件齊全的底層函式庫,反而更可能成為被長期依賴的基礎設施。