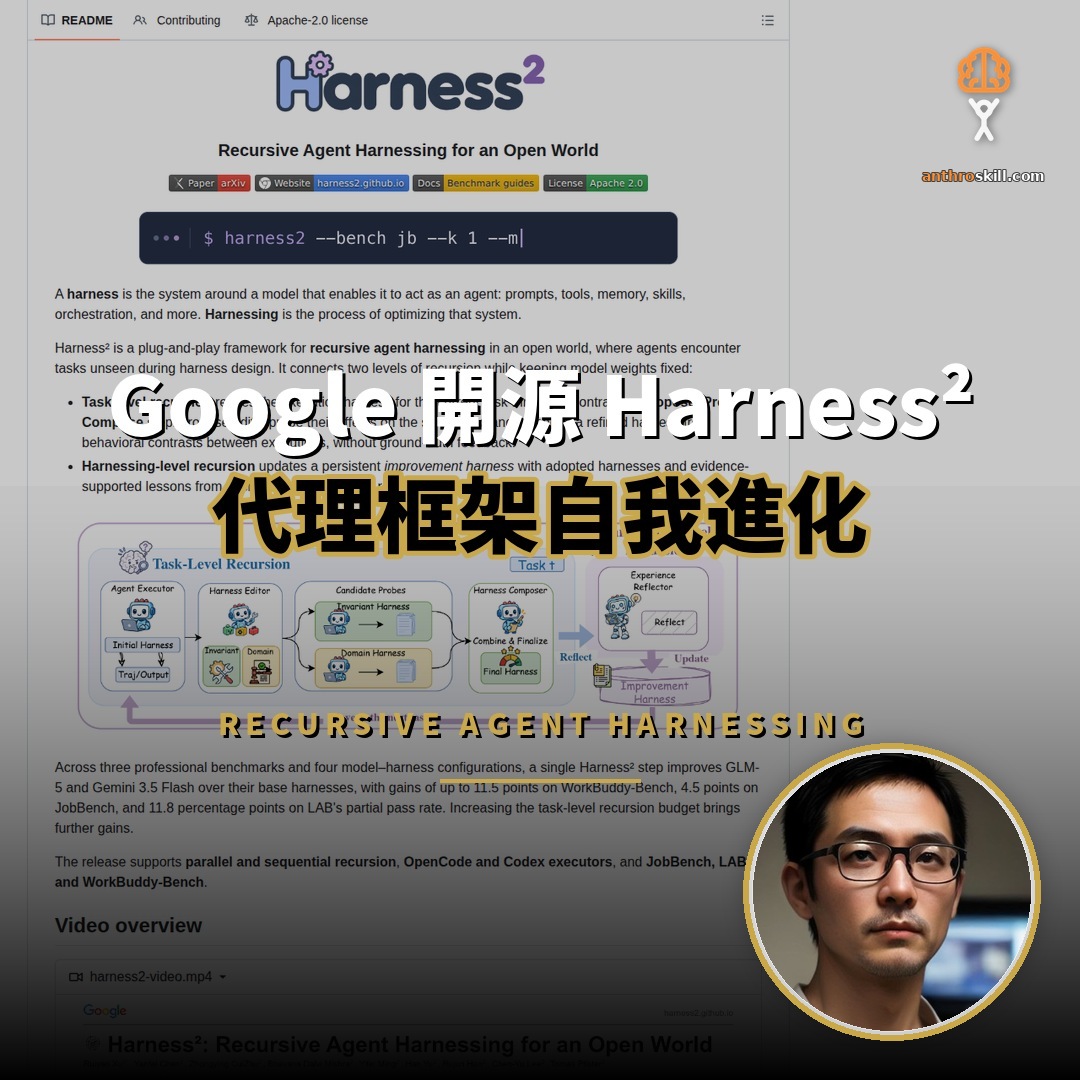
Google Research 於 2026 年 10 月 6 日在 GitHub 開源 Harness²(Harness squared),這是一套即插即用的遞迴代理約束框架(recursive agent harnessing),核心主張是在模型權重完全不變的前提下,透過兩級遞迴自動改寫模型外圍的執行框架,讓同一個模型在未見過的任務上取得更好表現。專案於兩週內累積 13,818 顆星標與 1,282 次分叉,採用 Apache 2.0 授權,論文同步發布於 arXiv(編號 2610.14224)。
這項發布的意義在於把「代理能力」的來源重新定位。過去兩年,業界的注意力集中在模型本身的規模與推理能力;Harness² 則主張,代理在真實任務中的表現同時取決於模型與其執行框架,而後者可以被系統性地演化。作者群來自 Google Research 與多間大學,涵蓋 Ruiyao Xu、Yanfei Chen、Bhavana Dalvi Mishra、Yifei Ming、Chen-Yu Lee 與 Tomas Pfister 等人。
Harness² 是什麼?
Harness² 是 Google Research 開源的遞迴代理約束框架,在模型權重不變下,透過任務層與約束層兩級遞迴改寫提示、工具與記憶,提升代理表現。
框架名稱中的 harness 指模型外圍使其得以行動的整套系統,包含提示、工具、記憶、技能與編排邏輯;harnessing 則是優化這套系統的過程。Harness² 的目標並非訓練更強的模型,而是讓框架在遇到新任務時自行調整,並把每次調整的經驗沉澱下來,供後續任務使用。
專案定位為 plug-and-play,意味著它不綁定特定模型或特定代理產品。官方支援 OpenCode 與 Codex 兩種執行器,並可切換平行與序列兩種遞迴模式,研究者可以在既有模型上直接套用,而無須重新訓練。
Harness² 的兩層遞迴如何運作?
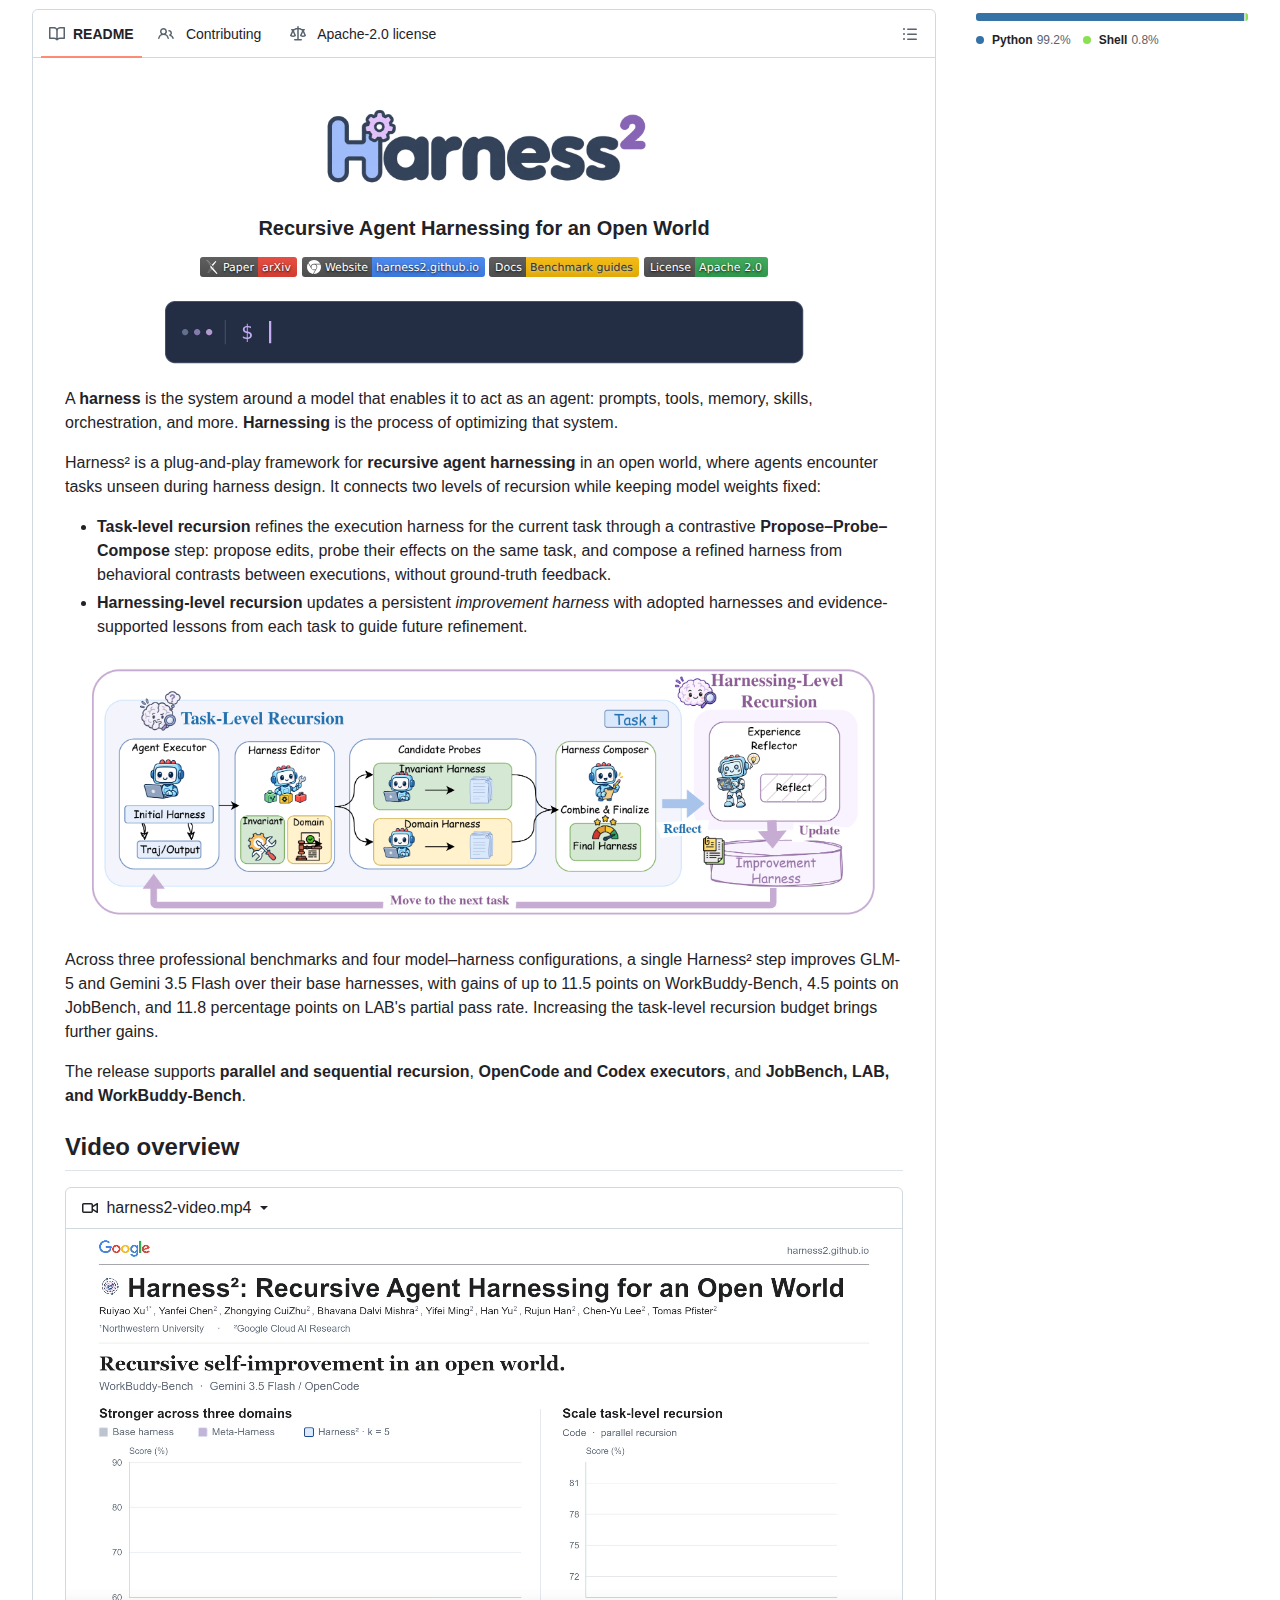
任務層遞迴針對當前任務反覆修正執行框架,約束層遞迴則把每次修正中被採用的框架與經驗寫入持續改進框架,用以指導下一個任務,形成跨任務的累積。
任務層遞迴(task-level recursion)處理的是單一任務的即時表現。當代理遇到一個從未見過的任務,框架會在執行過程中提出框架修改方案、實際測試這些修改對同一任務的影響,再從行為差異中組合出修訂後的框架。整個過程在任務內部完成,不依賴外部標註。
約束層遞迴(harnessing-level recursion)處理的是跨任務的遷移。每次任務結束後,被採用的框架與有證據支持的經驗會被寫入一個持續改進框架(improvement harness),成為下一個任務的起點。這個設計回應了遞迴自我改進在開放環境中的一個核心難題:單次任務的優化結果往往高度任務特定,難以泛化。
兩層遞迴的關係可以理解為短期適應與長期積累的分工。任務層負責當下的調整,約束層負責把調整轉化為可重用的知識,兩者共同構成官方所稱的「開放世界遞迴約束」。
Harness² 的 Propose–Probe–Compose 解決什麼問題?
它讓框架在沒有標準答案與驗證器的情況下仍能可靠地自我修改:先提出修改、再於同一任務上實測效果、最後依行為對比組合出修訂框架。
遞迴自我改進在開放世界部署時面臨兩項障礙。第一,真實任務通常未在框架設計階段出現,測試時屬於全新情境,因此沒有可靠的標準答案驗證器可以指導線上修改;若任由模型自行判斷修改是否有效,錯誤會被放大。第二,改進過程往往過度貼合單一任務,無法遷移到新場景。
Propose–Probe–Compose 正是針對第一項障礙設計的三段式流程。提出階段產生候選的框架修改,區分為通用修改與領域特定修改;探測階段把候選修改實際套用到同一任務執行,取得行為層面的證據;組合階段則比較不同執行之間的對比差異,從中組合出最終框架。整個流程以「行為對比」取代「標準答案」,因此無須 ground-truth 回饋即可運作。
官方把這套機制描述為對比式(contrastive)引導。其邏輯基礎在於:即使無法判斷哪個答案是正確的,仍可以判斷哪一組執行行為更接近任務要求,而這種相對判斷足以支撐框架的迭代。
Harness² 的八個可編輯元件有哪些?
八個元件分別是系統提示、防護規則、記憶、工具指引、子代理、技能、腳本與外掛,分別負責上下文建構、工具介面、委派編排與工具迴圈中的中介行為。
框架把可修改的範圍明確切分為八個元件,這種切分同時是工程介面與研究變數。系統提示、防護規則、記憶與技能屬於上下文建構層,決定模型在看到任務時掌握哪些資訊;工具指引與腳本屬於工具介面層,決定模型如何呼叫外部能力;子代理負責委派與編排;外掛則控制工具迴圈中的中介行為。
明確列舉元件的價值在於可重現性。當改進幅度出現時,研究者可以定位是哪一類元件造成差異,而非把整份提示視為不可分割的黑箱。對於想把框架改動納入內部平台治理的團隊,這樣的切分也提供了審查的粒度。
Harness² 有哪些基準測試成績?
在三項專業基準與四種模型組合下,單步遞迴即帶來最高 11.5 分(WorkBuddy-Bench)、4.5 分(JobBench)與 11.8 個百分點(LAB)的提升。
官方公布的數據集中在三個專業工作場景。WorkBuddy-Bench 涵蓋辦公室、網頁與程式三類任務,單步遞迴帶來最高 11.5 分的提升;JobBench 針對專業工作流程,提升幅度為 4.5 分;LAB 屬於法律工作基準,部分通過率提升 11.8 個百分點。
測試對象為 GLM-5 與 Gemini 3.5 Flash,兩者都在各自原有框架的基礎上被改善,而非與未經調校的裸模型比較。這一點值得留意:基準的對照組是「同一模型加上原本的框架」,因此數據反映的是框架優化本身的價值,而非模型替換的效果。
官方同時指出,增加任務層遞迴的預算可以帶來進一步增益,並提供平行與序列兩種擴展方式。平行遞迴同時探測多個候選框架以擴大探索範圍,序列遞迴則在連續步驟中逐步深化修訂。
平行與序列遞迴有何差別?
平行遞迴同時探測多個通用與領域特定候選框架,從共享證據產生多個組合;序列遞迴則把修訂後的框架與累積證據帶入下一步,逐步深化。
兩者的差異在於探索與深化的取捨。平行模式在單一步驟內同時啟動多個候選框架的探測,再把同一批執行證據交給多個組合器產生不同版本的框架,適合在有限步數內擴大搜索面。序列模式則把上一步的修訂結果與證據帶入下一步,逐步收斂,適合需要多輪打磨的複雜任務。
指令層面的對應相當直接。--k 1 表示執行一次完整的 Propose–Probe–Compose;--k K --mode parallel 會探測 K 個通用候選與 K 個領域特定候選,再產生 K 個組合;--k K --mode sequential 則連續執行 K 個步驟。官方建議評分與報告階段必須使用與修訂階段相同的基準、執行器、子集、--k、模式與隨機種子,以確保結果可比。
Harness² 與現有代理框架有何不同?
多數代理框架由開發者手動設計提示與工具;Harness² 把框架本身當作可優化對象,讓它在任務執行中自動演化,並把經驗跨任務累積,而非依賴人工調校。
現有主流做法是人工設計代理的系統提示與工具鏈,再透過離線評測調整。這種模式的瓶頸在於人力與迭代速度:每當任務分佈改變,框架需要重新設計,而設計品質取決於工程師對場景的理解。
Harness² 把框架視為可被搜尋的空間,並以任務執行本身作為評估訊號。與自動提示優化(prompt optimization)的差異在於範圍:後者通常只調整提示文字,Harness² 同時涵蓋工具指引、記憶結構、子代理編排與外掛中介等層面,且把改進結果持久化為跨任務的經驗。
另一個差異是對驗證器的依賴程度。許多自我改進方法假設存在可判分的驗證器,Harness² 則明確以行為對比取代標準答案,使其理論上可套用於沒有客觀評分的開放任務。
如何開始使用 Harness²?
需 Linux、Python 3.12 與 uv;建虛擬環境後安裝 render 依賴,再執行 harness2-demo 即可跑通兩種遞迴模式。
本地示範是最低門檻的入口。官方指令建立 Python 3.12 虛擬環境、安裝含渲染依賴的套件,然後執行 harness2-demo --output runs/demo --k 2。此示範使用確定性的編輯器與真實的 Python 執行,同時跑過平行與序列兩種遞迴模式,並且不需要任何模型憑證。
模型驅動的基準測試則需要額外準備 Node.js 20 以上、Google Cloud CLI 與各基準的相依套件。LAB 需要 Pandoc 與 Poppler,WorkBuddy-Bench 需要 Docker。設定方式是複製 .env.example 為 .env,填入 Vertex AI 專案與模型 ID,再以 gcloud auth application-default login 完成驗證。
執行流程分為五個指令:harness2-setup 安裝基準,harness2-check 檢查環境,harness2 執行修訂,harness2-judge 評分,harness2-report 產生報告。--dry-run 可在不呼叫模型的情況下預覽任務選擇,對於控制 API 成本相當實用。
Harness² 的網路存取風險是什麼?
執行器的網路存取預設不受限制,Codex 更在停用沙箱的狀態下運行;公開基準的評分標準可能在網路上取得,官方要求在評測前設定網路限制。
這是使用時最需要留意的設定。官方文件明確指出,執行器的網路存取不受限制,而 Codex 執行器以停用沙箱的方式運行。由於公開基準的評分標準與答案可能在網路上取得,若未加限制,代理有機會直接讀取評分依據,使測試結果失去意義。
文件要求使用者在評測前依實驗指南設定網路限制,封鎖基準答案與評分標準的可達路徑。對於把框架用於內部評測的團隊,這意味著網路隔離屬於前置條件,而非事後補救項目。
Harness² 的專案數據與生態現況如何?
專案以 Python 為主、Apache 2.0 授權,2026 年 10 月 6 日建立,兩週內累積 13,818 星與 1,282 次分叉,程式碼約 53.6 萬行 Python。
成長速度是這批數據中最值得注意的部分。建立後兩週即取得超過 1.3 萬顆星標與 1.2 千次分叉,分叉與星標的比例約為一比十一,顯示相當比例的使用者打算實際執行而非僅收藏。程式碼以 Python 為主,另有少量 Shell 腳本負責環境與流程銜接。
官方在文件中明確聲明,本專案並非 Google 正式支援的產品,亦不符合 Google 開源軟體漏洞獎勵計畫的資格。第三方目錄下的程式碼、基準與資料集各自沿用上游授權,使用前需逐一確認。
Harness² 有哪些限制與待驗證之處?
框架目前僅在三個專業基準與四種模型組合上驗證,且屬研究釋出而非正式產品;遞迴帶來的 API 成本、评比的可重現性與跨領域泛化仍待更多獨立測試。
驗證範圍是首要限制。三項基準分別對應專業工作、法律工作與辦公室場景,四種模型與框架組合則以 GLM-5 與 Gemini 3.5 Flash 為主。對於創意寫作、長流程自動化或需要人機協作的場景,目前沒有公開數據。
成本結構同樣需要評估。任務層遞迴的每一步都涉及多次模型呼叫,平行模式更會同時啟動多個候選探測,--k 提高帶來的增益必須與 API 支出一起衡量。官方建議從小型任務子集開始,並使用 --dry-run 預覽,正是回應這項顧慮。
研究釋出的定位也影響採用判斷。專案說明明確表示不是 Google 正式支援的產品,介面與實驗流程在後續版本中可能調整。企業若計畫把框架納入內部平台,宜先以自有任務集建立基線,而非直接引用論文中的提升幅度。
出處連結有哪些?
程式碼在 google-research/harness2,論文 arXiv 2610.14224,採 Apache 2.0 授權。
專案原始碼與文件託管於 https://github.com/google-research/harness2,包含基準安裝指南、實驗設定說明與各元件的實作細節。論文《Harness²: Recursive Agent Harnessing for an Open World》可於 https://arxiv.org/abs/2610.14224 取得,官方網站 https://harness2.github.io 提供示範影片與基準導覽。
總結:Harness² 適合什麼團隊?
適合正在自建代理系統、且有能力自行評測的團隊,特別是需要在同一模型上挖掘更多任務表現者;若僅需現成產品或缺乏評測資源,導入成本可能高於收益。
Harness² 的價值主張相當清楚:把代理框架從人工設計的產物,轉變為可被系統性演化的對象。在模型能力逐步趨同的階段,這種把優化重心移到模型外圍的思路,提供了另一條提升任務表現的路徑。
合理的採用順序是先跑本地示範,理解兩層遞迴的實際行為,再以自己的任務集建立基線與對照。若框架改動能在自有場景重現官方所述的增益,才值得投入整合與治理成本。對於把模型視為固定成本、並希望在既有算力上取得更多產出的團隊,這套框架提供了可檢驗的起點。
