Hindsight 是 Vectorize 開源的人工智慧代理記憶系統,在程式碼託管平台累積 50,056 顆星標與 6,085 次複製。專案以仿生記憶結構取代單一向量檢索,把代理的資訊拆成世界事實、經驗、觀察與心智模型四種型態,再透過 retain、recall、reflect 三個操作累積可複用的知識。本文依據儲存庫公開說明、官方文件與版本紀錄整理,分析其記憶架構、檢索設計、生態整合與專案現況。
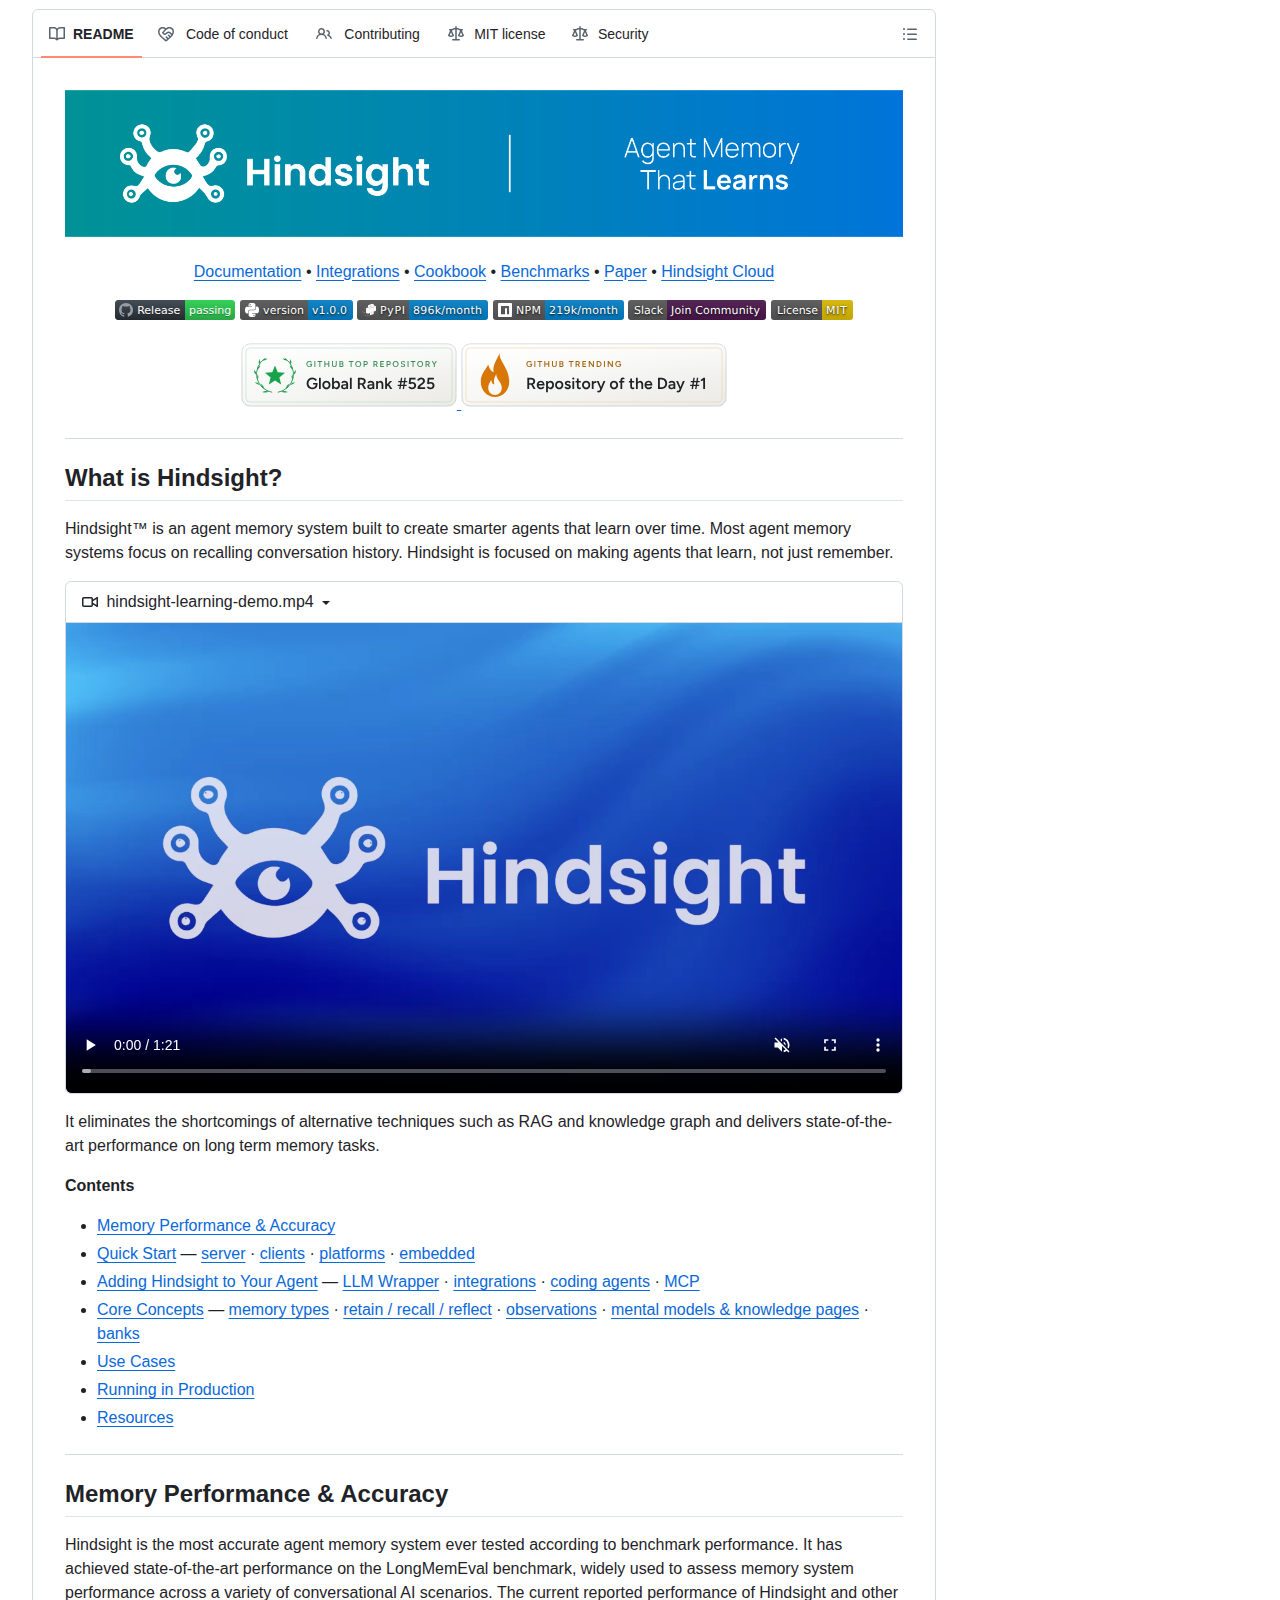
Hindsight 是什麼?
它是一套開源的代理記憶系統,以世界事實、經驗、觀察與心智模型四種結構儲存資訊,並透過 retain、recall、reflect 三個操作累積知識。
此專案的定位與常見的對話記憶方案不同。多數代理記憶系統處理的是「把先前對話找回來」,而 Hindsight 的設計目標是讓代理在既有記憶上形成新的理解。儲存庫說明直接指出,系統關注的是讓代理學習,而不只是記住。
專案由 Vectorize 維護,該公司同時經營代管服務 Hindsight Cloud。儲存庫於 2025 年 10 月建立,並在 2026 年 10 月 13 日發佈 1.0.0 版本,顯示專案已從實驗階段進入正式版本週期。儲存庫以 Python 為主要語言,採 MIT 授權,官方文件站台提供完整的概念說明、SDK 參考與部署指南。
技術定位方面,專案在說明中直接對標現有的檢索增強生成與知識圖譜做法。它認為這兩類技術在長期記憶任務上各有侷限,因此改用一組介於兩者之間的資料結構,把記憶表示為實體、關係與時間序列的組合。
Hindsight 的記憶架構有什麼特別之處?
它不依賴單一向量檢索,而是把記憶拆成世界事實與經驗兩條路徑,再以實體、關係與時間序列的稀疏與稠密向量表示,讓檢索能同時處理語意、時間與因果關聯。
記憶型態的區分是這套架構的基礎。系統把「世界是什麼」與「代理經歷了什麼」分開處理:世界事實記錄客觀陳述,例如某項設備會發熱;經驗則記錄代理自身的遭遇,例如觸碰後造成損傷。兩條路徑的內容在寫入時分別抽取,避免主觀經驗與客觀事實互相污染。
在此之上,系統進一步產生兩類衍生結構。觀察是從大量記憶中整併出的、附帶證據支撐的信念,每則觀察都保留來源引述與證據數量;新的證據到達時,觀察會被修訂而非直接覆寫,因此新資訊可以強化、削弱或延伸既有判斷。心智模型則是對某個問題的常設答案,使用者定義問題一次,系統負責撰寫答案並在背景持續改寫。
這種分層的實際效益出現在讀取端。心智模型的讀取屬於單純的資料庫查詢,不需要檢索流程,也不需要呼叫語言模型,代理因此能在工作階段開始時直接載入已沉澱的理解,而不必每次重新推導。
Hindsight 的三個核心操作是什麼?
retain 負責寫入並抽取關鍵事實與時間資訊,recall 以四種策略平行檢索並合併排序,reflect 則在既有記憶上推理,產出帶立場設定的回應。
retain 是寫入入口。呼叫時除了內容之外,還可以附帶情境描述與時間戳記。系統在背景使用語言模型抽取關鍵事實、時間資料、實體與關係,再經過正規化流程轉換為標準實體、時間序列與搜尋索引,這些表示即構成後續檢索的路徑。
recall 負責取回記憶,並同時執行四種檢索策略。語意策略處理向量相似度,關鍵字策略使用 BM25 精確比對,圖形策略沿實體、時間與因果連結擴散,時間策略則依時間範圍過濾。四組結果會先合併,再以倒數排名融合與交叉編碼器重排序模型決定順序,最後依權杖上限裁剪。
reflect 處理需要推理而非查詢的問題。它讓代理在既有記憶之間建立新連結,適用場景包括專案經理評估待處理風險、銷售代理分析哪些訊息獲得回覆,以及客服代理找出產品文件未能解答的問題。每座記憶庫可設定懷疑程度、字面程度與同理程度等傾向特徵,這些設定會影響 reflect 的推理方式。
Hindsight 的檢索效能與基準測試表現如何?
專案在 LongMemEval 基準測試取得領先成績,數據由維吉尼亞理工與《華盛頓郵報》獨立重現,其餘方案多為自行回報。
基準測試的可驗證性是此專案較少見的一項說明。專案指出其結果已在 LongMemEval 取得領先表現,該基準測試用於評估對話式人工智慧場景中的長期記憶能力。與一般開源專案不同的是,官方明確標示數據已由外部研究單位獨立重現,並指出其他方案的成績由供應商自行回報,兩者性質不同。
專案同時提供持續更新的線上結果頁面,公開各模型的準確率、延遲與成本,讓比較不只停留在單一時間點的截圖。儲存庫說明另提及,系統已在財星五百大企業與多家人工智慧新創的生產環境中使用,但仍將代管服務列為可選項而非必要條件。
需要說明的是,記憶系統的效能高度取決於使用場景。專案文件亦承認,對於以 n8n 等工具建構的簡單工作流程,導入這套系統可能超出實際需要,其設計目標落在需要長期累積與行為調整的開放式任務。
Hindsight 支援哪些整合與部署方式?
官方提供 60 多種整合,涵蓋 Claude Code、Codex、Cursor 與 n8n,也支援 LangGraph;部署可用 Docker、pip 或 Helm。
整合層是這套系統降低導入摩擦的主要手段。官方列出的整合超過六十項,多數不需要修改既有程式碼。代理工具方面涵蓋 Claude Code、Codex、Cursor、GitHub Copilot、opencode、Cline 與 Aider;代理框架方面涵蓋 LangGraph、LlamaIndex、CrewAI、Pydantic AI、OpenAI Agents SDK 與 Google ADK;低程式碼工具則涵蓋 n8n、Zapier、Dify 與 Flowise。
針對終端代理另有專用套件。使用者可透過單一指令安裝,為每個儲存庫建立依 Git 歷史與過往工作階段自動生成的記憶庫,並在代理啟動時注入,同時附上涵蓋架構、慣例與進行中工作的知識頁面。伺服器本身也內建模型情境協定端點,每座記憶庫一組,可將寫入、檢索與推理直接公開為工具。
部署選項涵蓋自架與代管兩端。自架可使用 Docker 映像、pip 安裝、Kubernetes Helm Chart,或改用外部 PostgreSQL 與 Oracle 資料庫;底層支援 25 種以上模型供應商,包含雲端服務、本機執行的 Ollama、LM Studio 與 llama.cpp,以及相容 OpenAI 介面的端點。既有訂閱亦可沿用,例如 ChatGPT、Claude、Cursor 與 GitHub Copilot 的方案皆不需要額外金鑰。
Hindsight 的安全與隱私機制如何運作?
每座記憶庫嚴格隔離且不互通,並可啟用 Memory Defense 政策,以 45 種規則掃描寫入內容中的密鑰與個人資料,選擇遮蔽或直接攔截。
隔離設計以記憶庫為單位。一座記憶庫對應一個使用者、代理或專案,官方強調不同記憶庫之間不會發生內容洩漏,這項邊界由儲存層而非應用層維持。多語言處理則採保留原文的策略,輸入語言會被偵測並貫穿整個流程,實體名稱維持原生文字,避免翻譯造成資訊失真。
敏感資料處理採可選政策。專案提供逐記憶庫啟用的 Memory Defense 機制,以 45 種樣式掃描每次寫入,命中時可選擇替換為標記或直接阻止該筆資料進入儲存。企業部署另提供階層式設定,由全域環境變數到租戶、再到單一記憶庫逐層覆寫,並附帶用於遷移、修復與卡住任務處理的管理命令列工具。
維運層面則提供 Prometheus 指標與儀表板,用於追蹤語言模型呼叫、權杖用量與延遲;寫入、整併與更新流程也提供 Webhook 事件,方便接入既有的監控與稽核流程。
Hindsight 的開源授權與專案現況如何?
專案採 MIT 授權,以 Python 撰寫,2025 年 10 月建立,2026 年 10 月 13 日發佈 1.0.0 版,儲存庫維持每日更新並附完整文件站台。
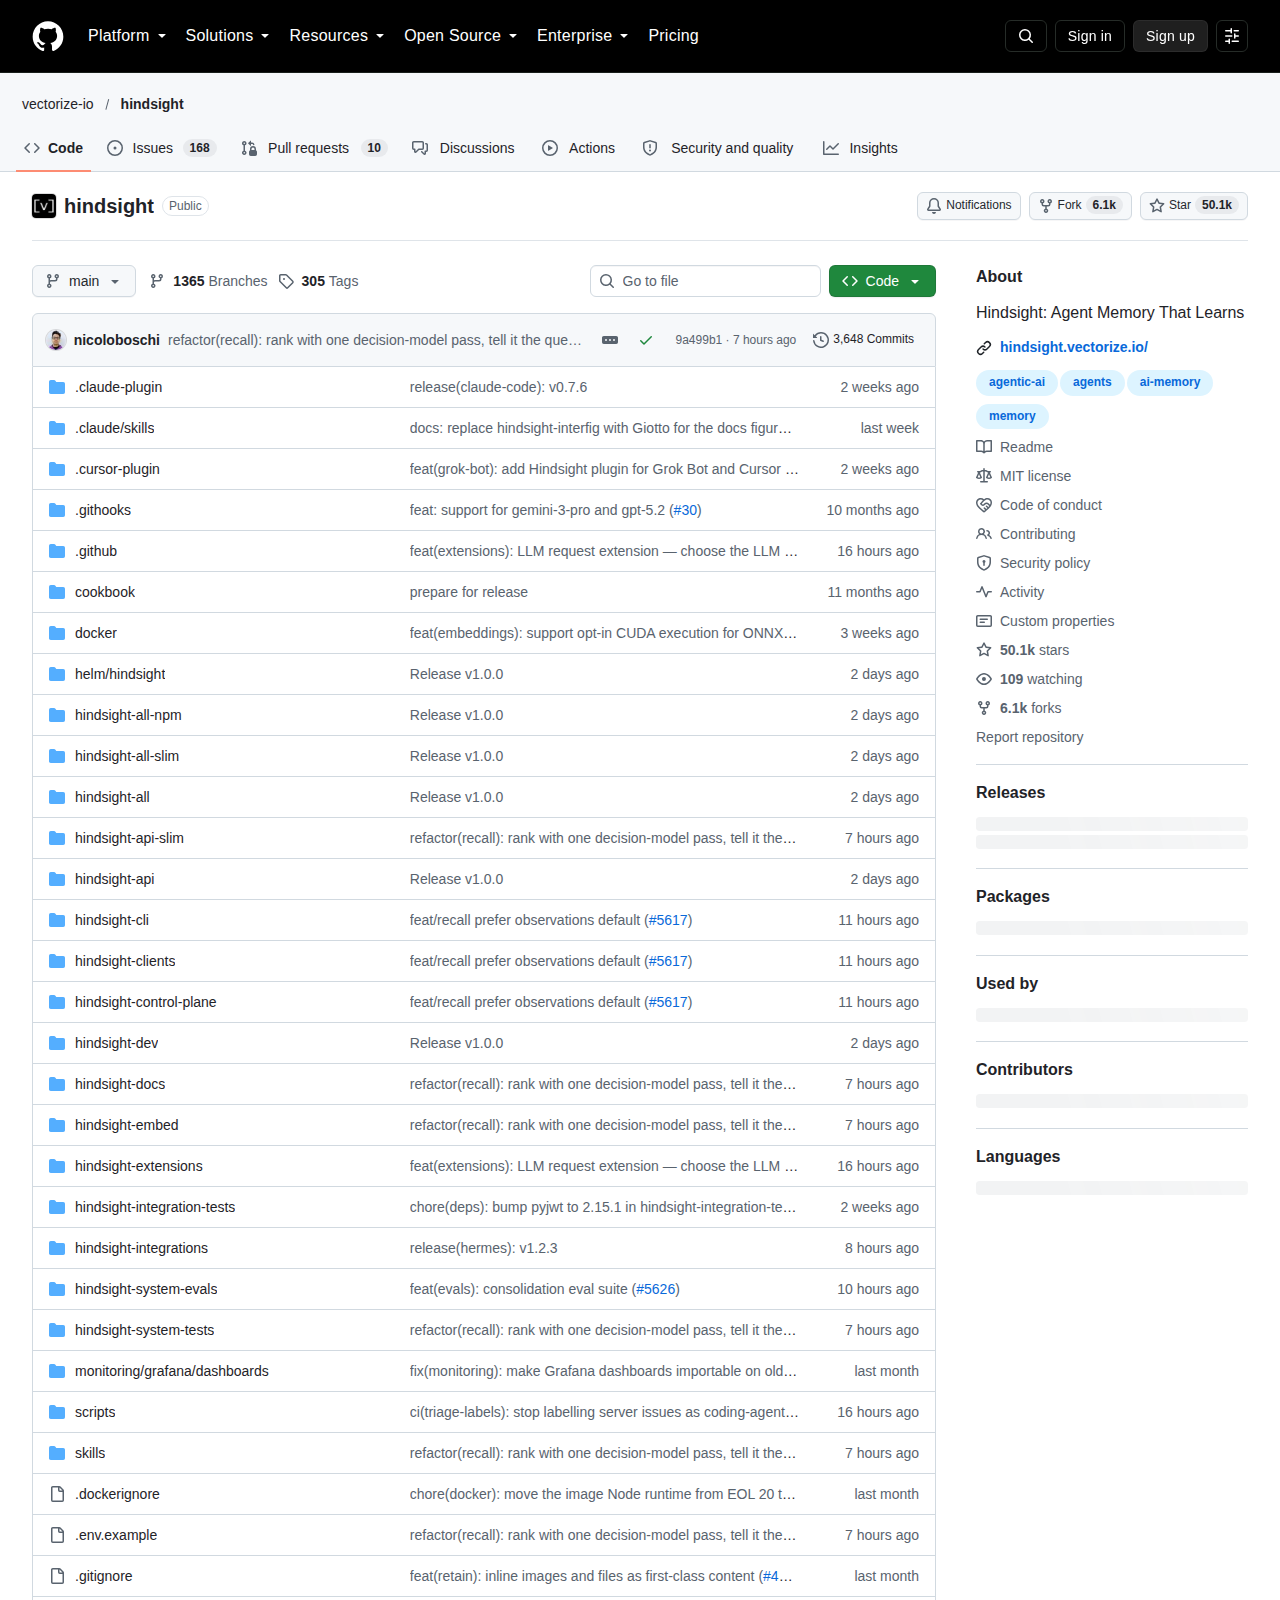
專案目前在 GitHub 累積 50,056 顆星標與 6,085 次複製,複製與星標的比例約為八分之一,屬於工具型專案的常見區間。授權採 MIT,允許商業使用與修改,程式碼以 Python 為主。儲存庫建立於 2025 年 10 月 30 日,最後更新時間為 2026 年 10 月 15 日,顯示維護活躍。
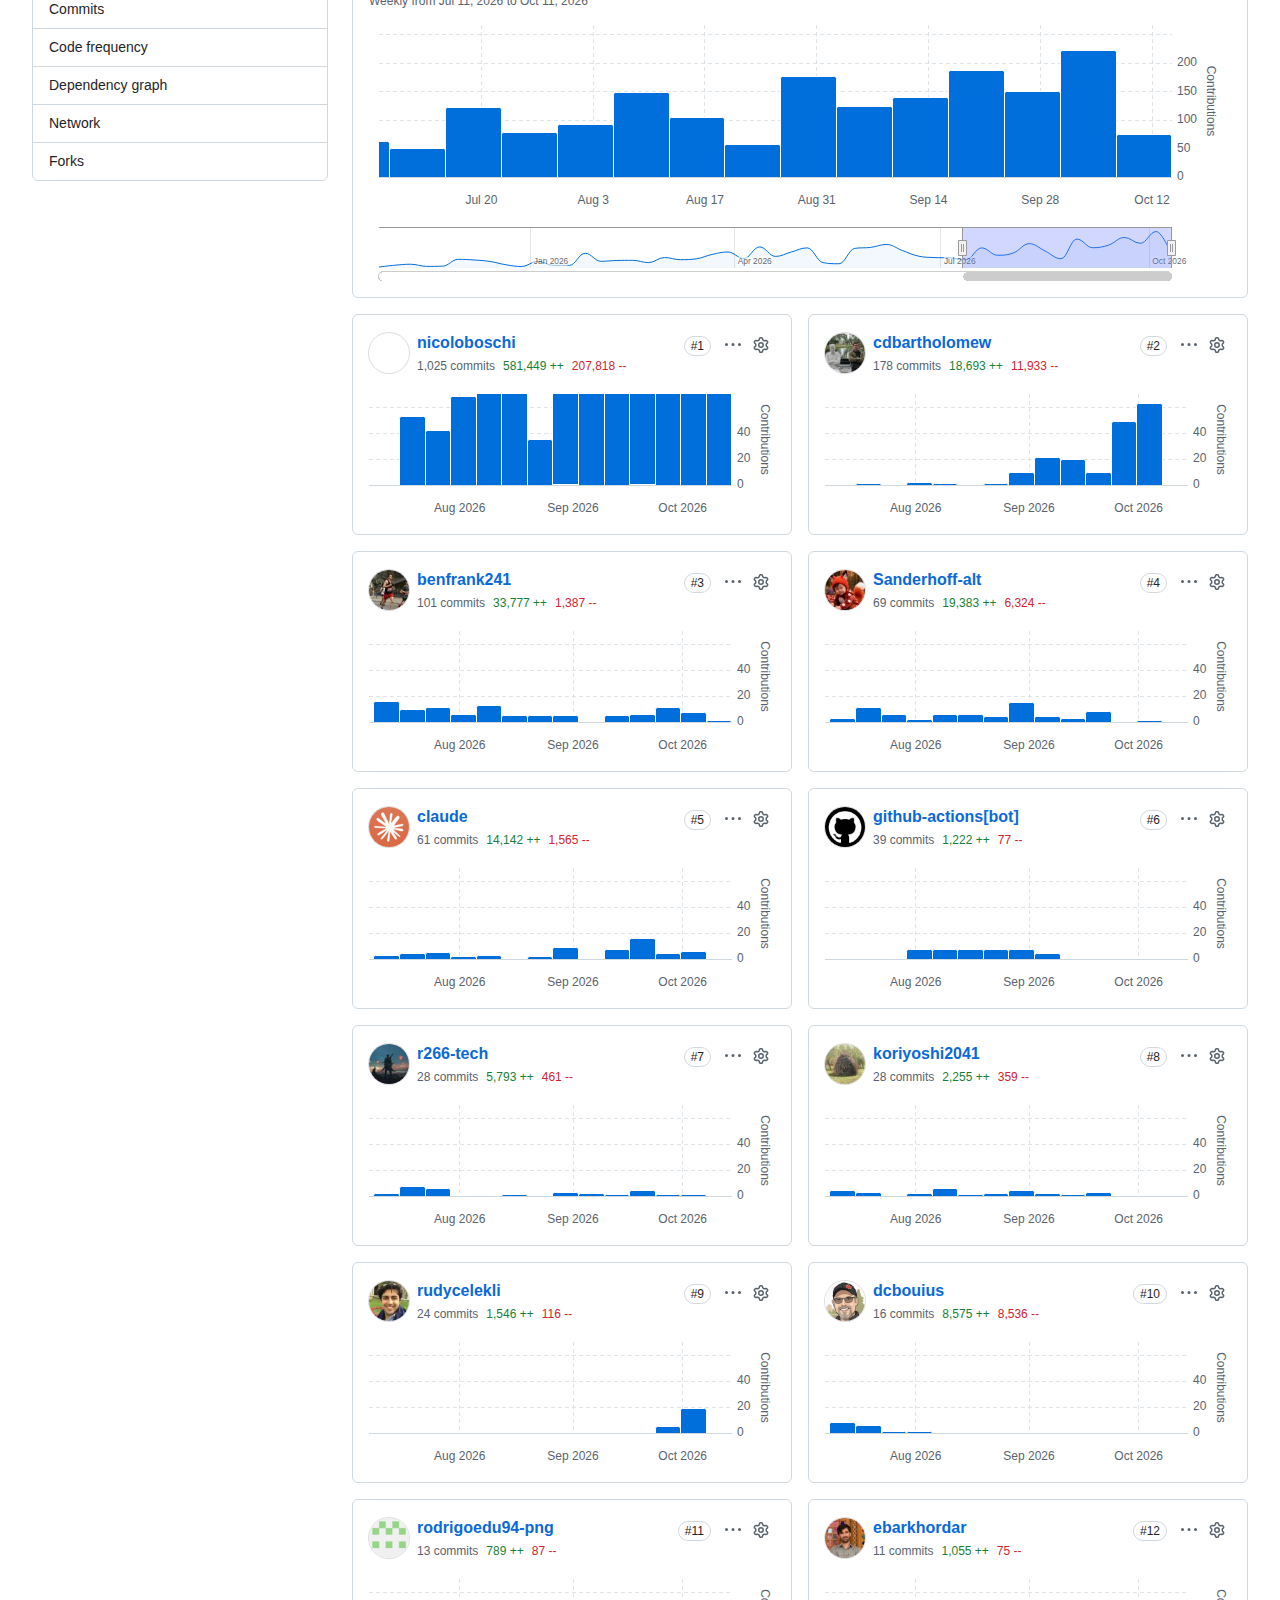
版本節奏反映專案已進入穩定階段。1.0.0 版在 2026 年 10 月 13 日發佈,前一版 0.10.3 於同月 8 日推出,之間僅隔五日。專案同時提供技術論文、線上基準測試頁面、整合目錄與說明文件,構成相對完整的生態入口。
出處連結有哪些?
主要出處為 GitHub 儲存庫 vectorize-io/hindsight、官方文件站 hindsight.vectorize.io 與 arXiv 論文。
本文內容依據儲存庫公開說明、官方文件與版本紀錄整理,原始出處如下:
- GitHub 儲存庫:https://github.com/vectorize-io/hindsight
- 官方文件與基準測試:https://hindsight.vectorize.io
- 技術論文:https://arxiv.org/abs/2512.12818
總結:Hindsight 適合什麼團隊?
此系統適合需要長期記憶與行為調整的代理場景,例如跨工作階段的專案管理、客服與銷售代理;若僅為單輪問答或簡單自動化,導入成本可能高於效益。
Hindsight 在本輪開源記憶方案中,選擇了一條與向量檢索不同的路線。它把記憶拆成可整併、可修訂的信念結構,並以心智模型讓讀取成本降到單次資料庫查詢,這些設計對需要跨工作階段累積判斷的代理具備實際價值。官方公開的獨立重現結果與持續更新的基準頁面,也讓效能主張相對容易被檢驗。
導入與否取決於任務性質。需要長期個人化、需依回饋調整行為、或需要處理開放式任務的團隊,較能從這套架構取得回報;反之,若應用只是單輪問答或固定流程自動化,官方文件亦建議評估是否真的需要記憶層。專案採 MIT 授權且有完整自架選項,對於在意資料落地位置的團隊,評估門檻相對低。
