
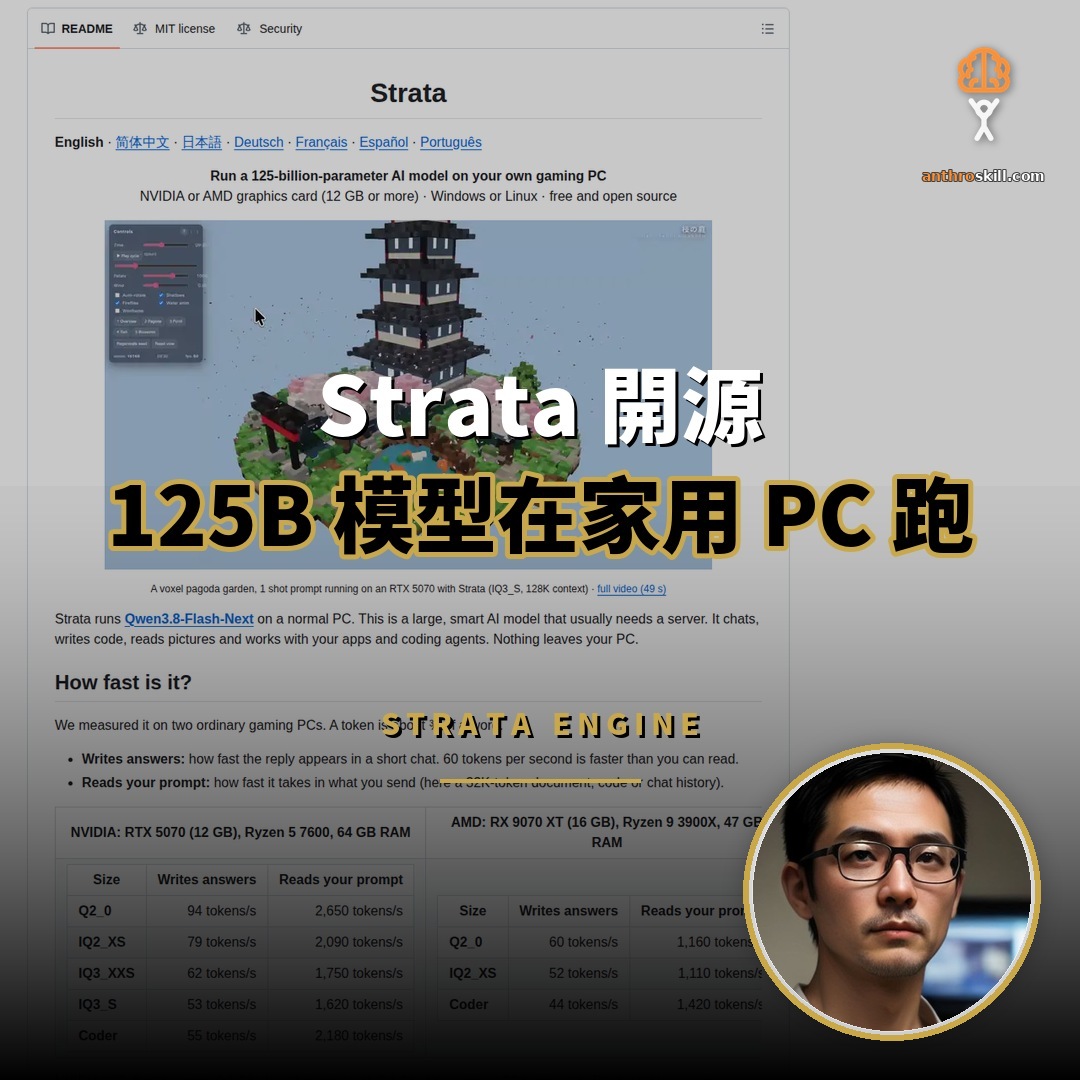
Strata 是一套以 C++ 撰寫的開源推論引擎,讓 1250 億參數的 Qwen3.8-Flash-Next 模型在配備 12GB 顯示記憶體的家用電腦上運行。截至二零二六年十月,專案在 GitHub 累積 12,526 顆星標與 1,058 次複製,於二零二六年九月二十四日建立後迅速受到關注,並在 Hacker News 累積逾八百點討論。它的核心主張相當明確:大型模型的推論不必依賴伺服器,一台搭載消費級顯示卡的個人電腦即可勝任。
Strata 是一套開源推論引擎,讓 1250 億參數的 Qwen3.8-Flash-Next 模型在 12GB 顯示記憶體的家用電腦上運行,支援 Windows 與 Linux。
Strata 是什麼?
Strata 是一套開源推論引擎,讓 1250 億參數的 Qwen3.8-Flash-Next 模型在 12GB 顯示記憶體的家用電腦上運行,支援 Windows 與 Linux。
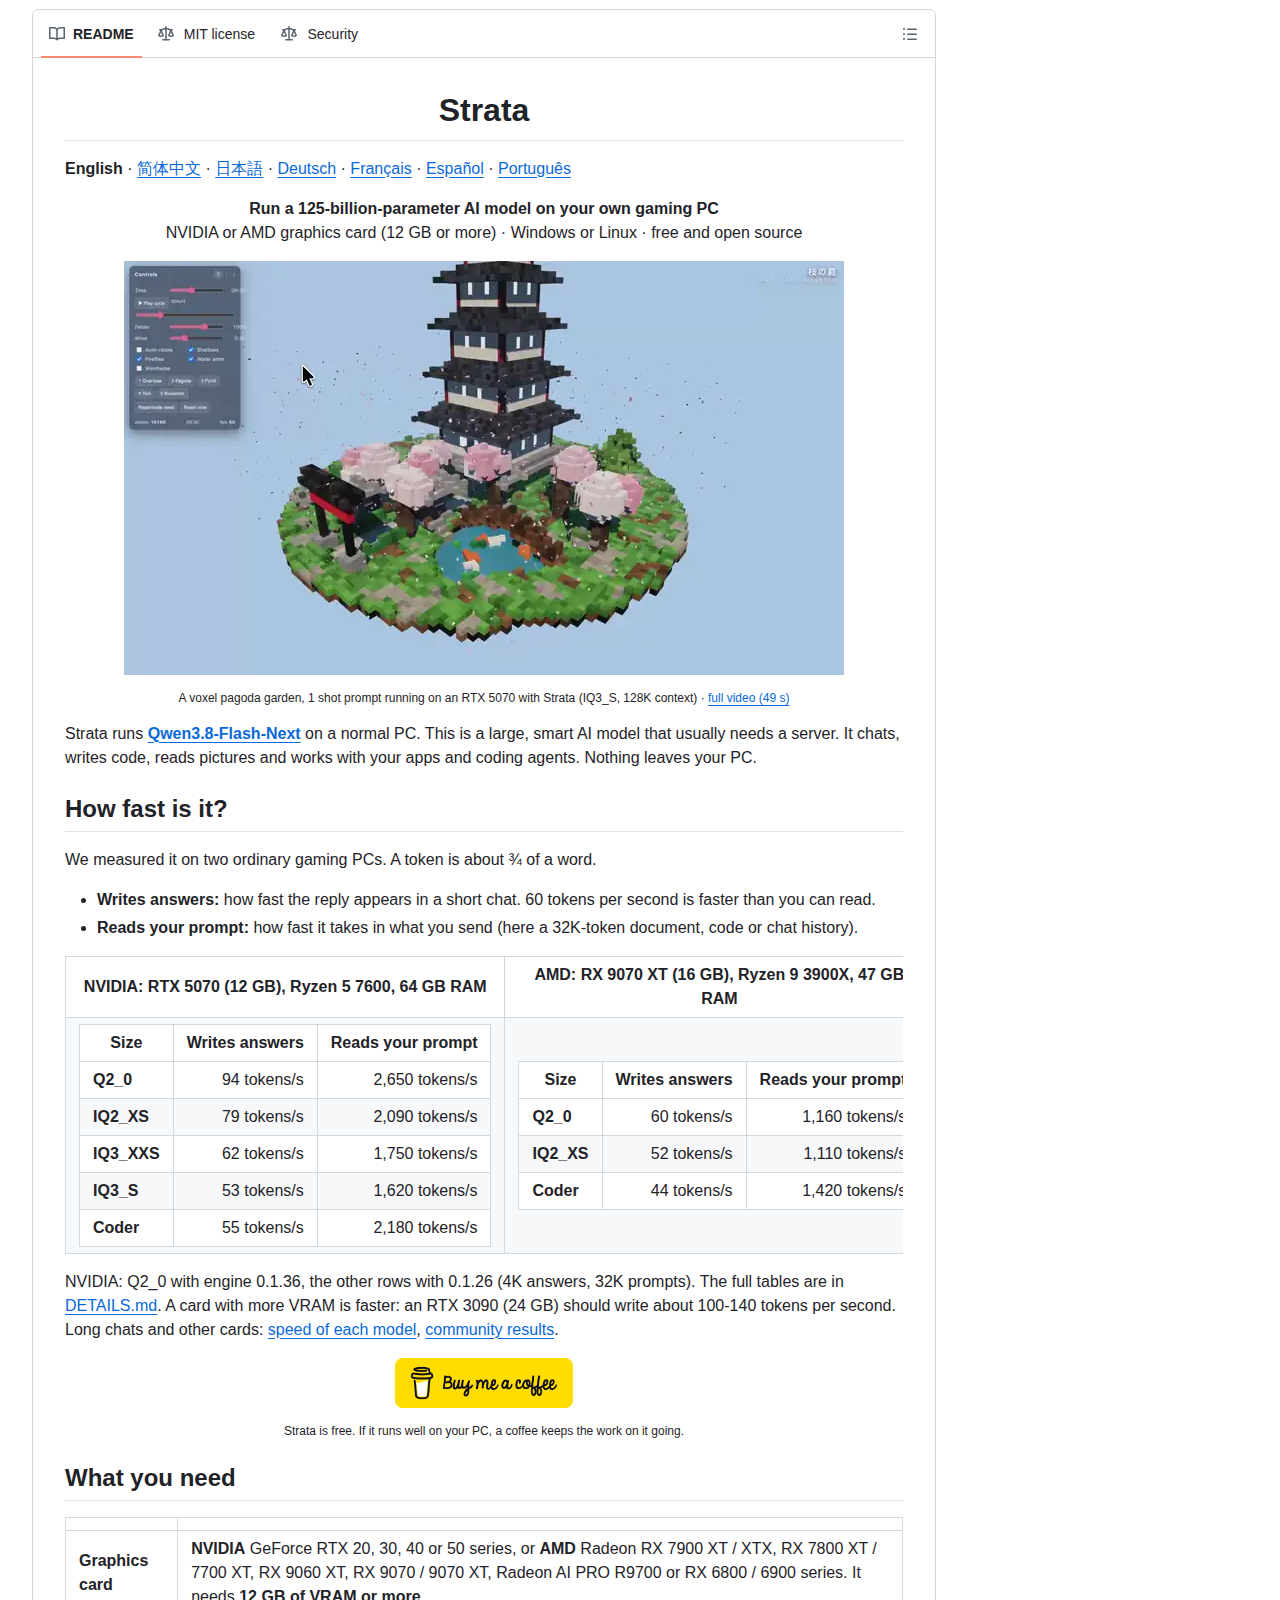
依照專案自述,Strata 的定位是「在你自己的遊戲電腦上運行 1250 億參數的模型」。它本身不是模型,而是模型之上的推論層,負責把一個原本需要伺服器等級顯示記憶體的大型模型,重新切分到個人電腦的顯示卡、記憶體、處理器與固態硬碟之中。
專案支援 NVIDIA 的 GeForce RTX 20、30、40 與 50 系列,以及 AMD 的 Radeon RX 7800、7900、9060、9070 等型號,顯示記憶體須達 12GB 以上,系統記憶體建議 32GB 起,並預留約 80GB 硬碟空間。安裝完成後,模型以本機網頁介面 http://127.0.0.1:8080 提供服務,並可作為 OpenAI 或 Anthropic 相容端點供其他應用呼叫。
Strata 由誰開發,為何在 Hacker News 掀起討論?
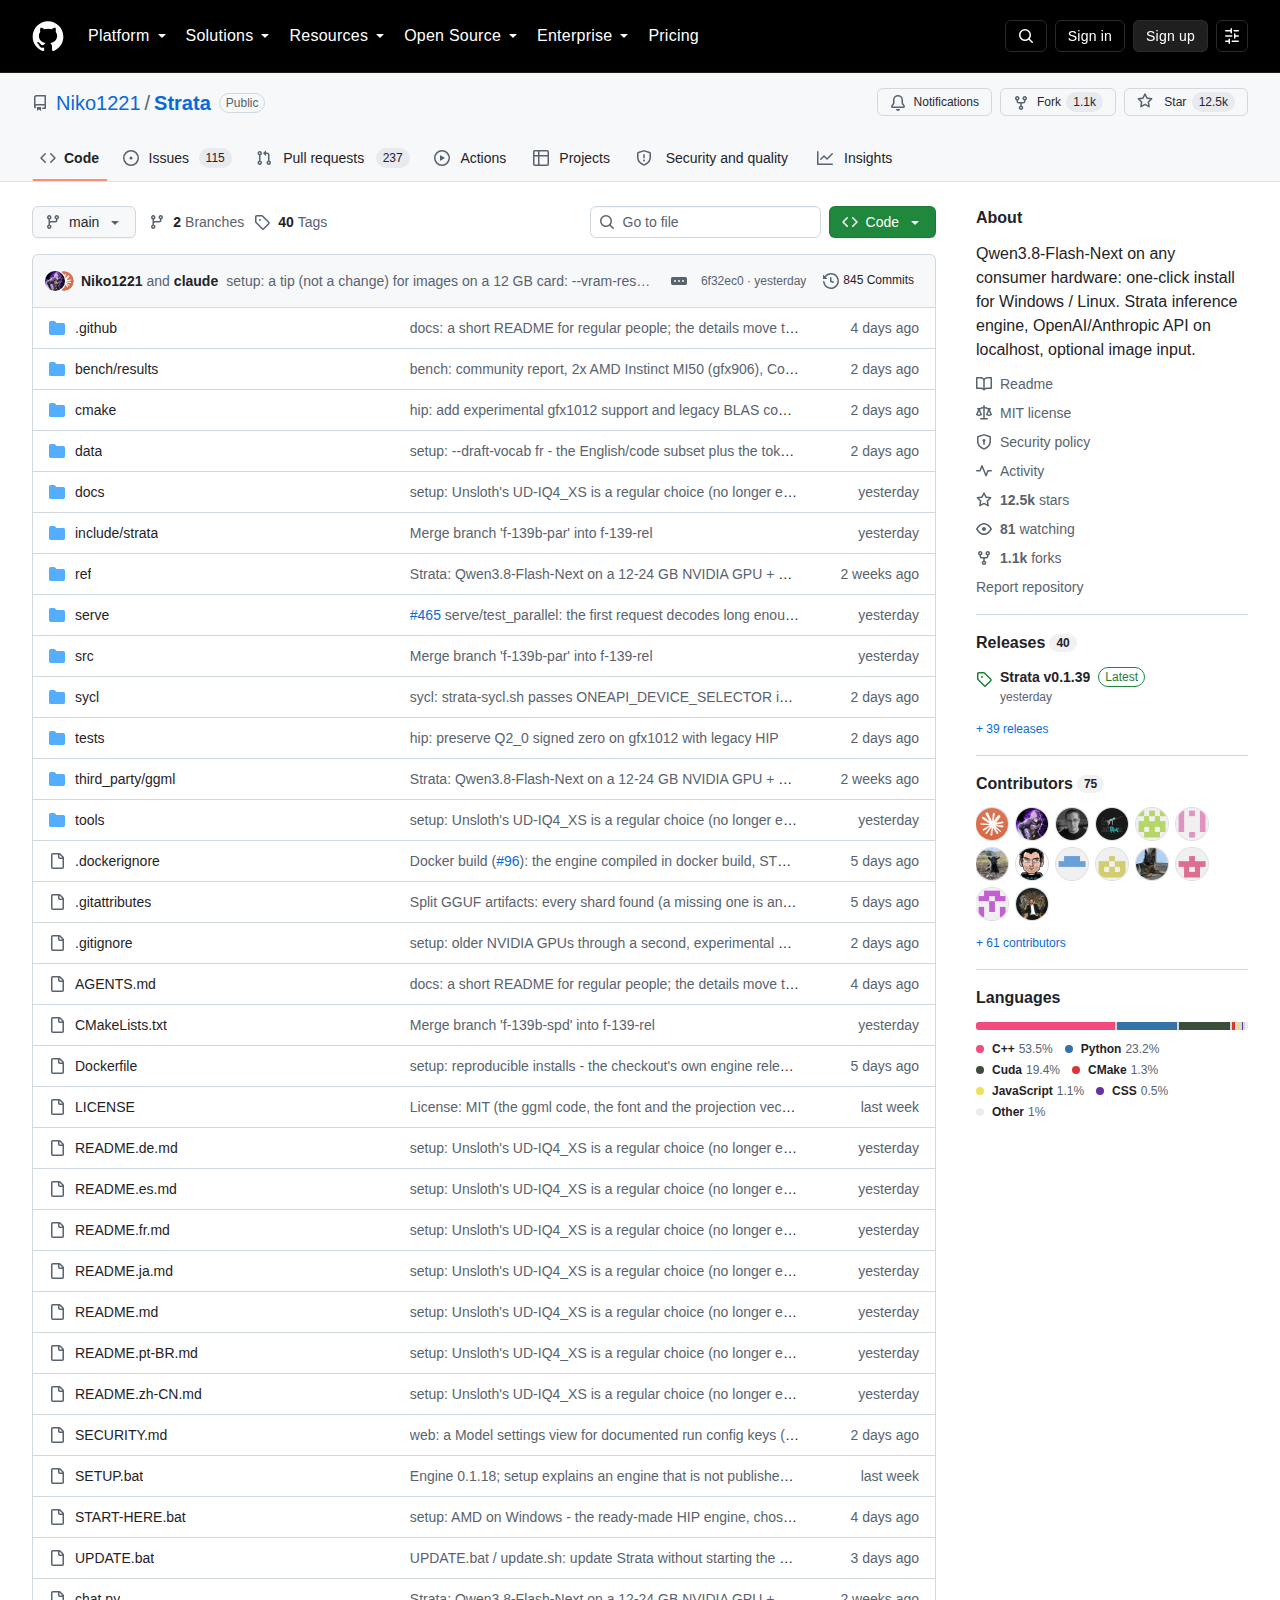
專案由開發者 Niko1221 於二零二六年九月建立,以 C++ 撰寫,採用 MIT 授權,推出數日即在 Hacker News 累積逾八百點討論。
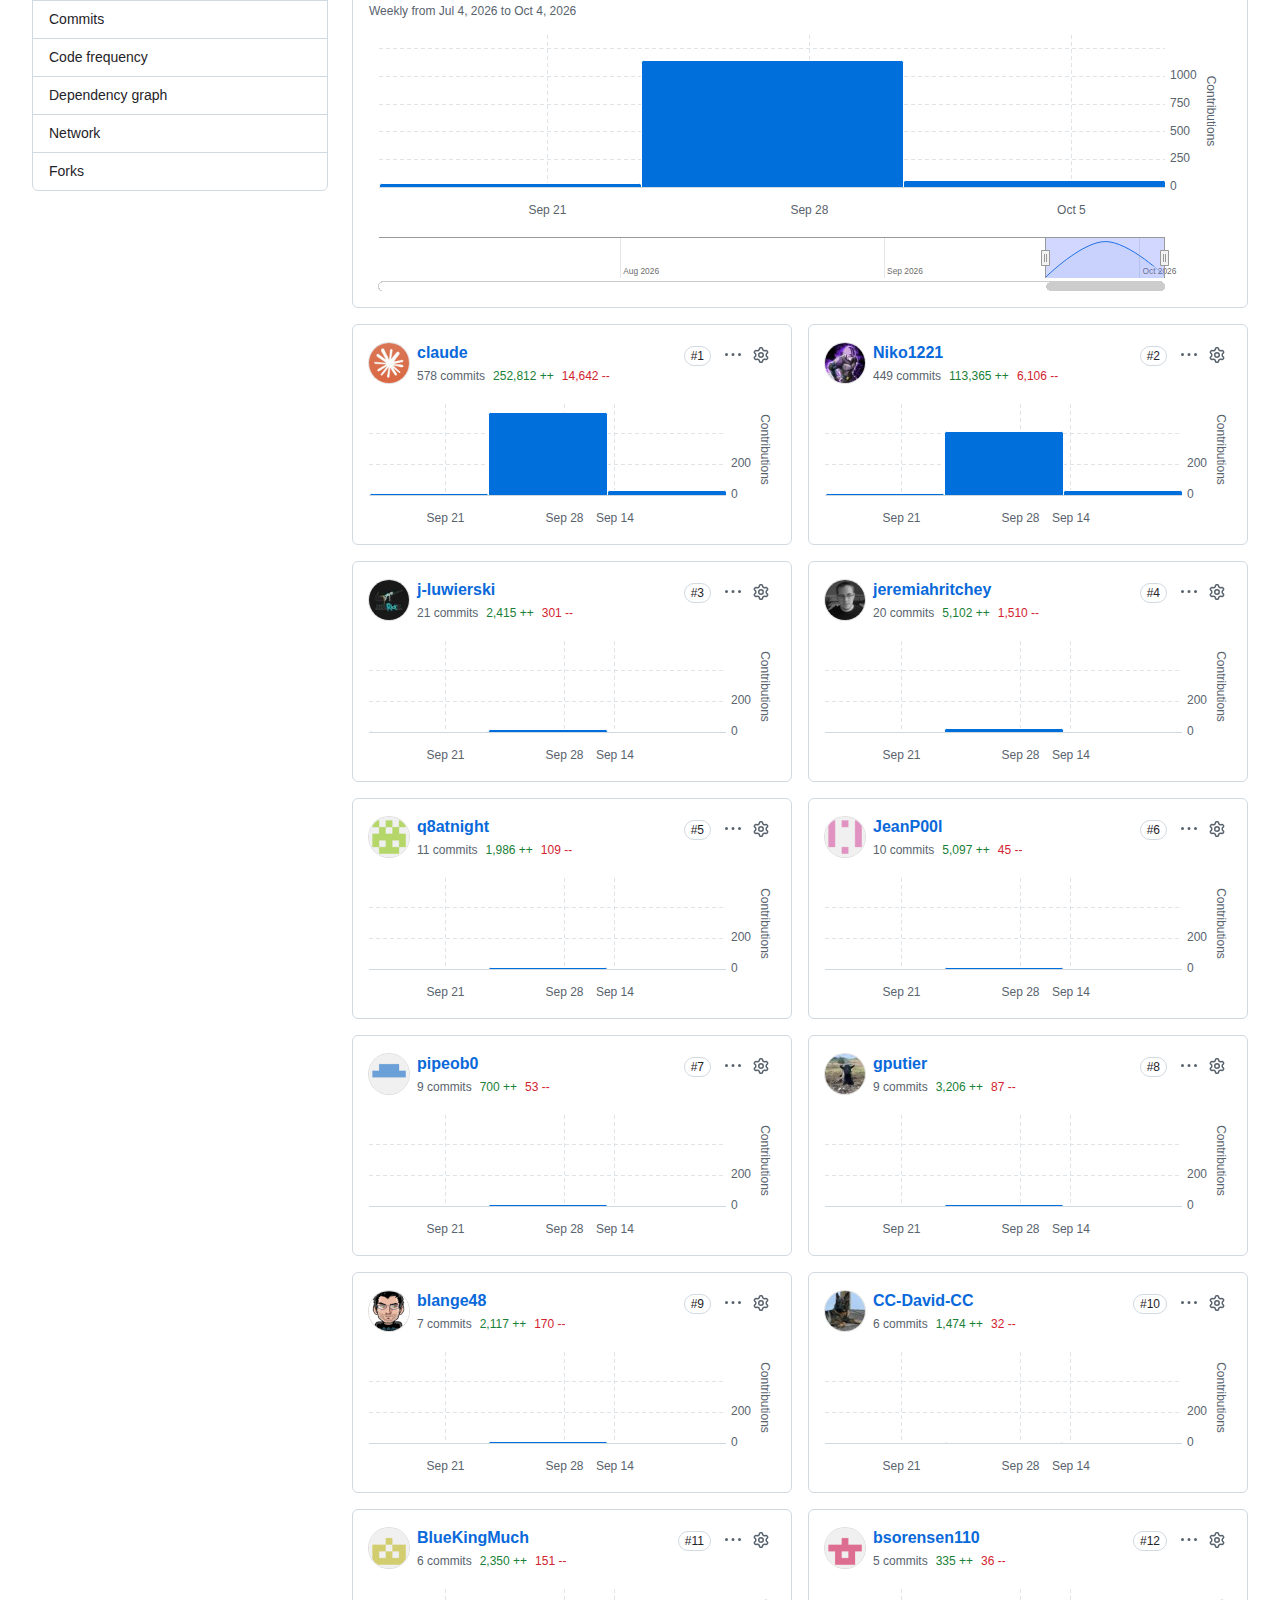
專案由開發者 Niko1221 於二零二六年九月二十四日建立,以 C++ 為主要語言,採用 MIT 授權。截至撰稿時,專案擁有 12,526 顆星標、1,058 次複製與八十一項訂閱,最近一次程式碼提交落在二零二六年十月四日,顯示活躍維護節奏。
討論熱度來自一個明確的技術門檻突破。過去要在本地運行千億參數等級的模型,通常需要多張高階顯示卡或伺服器等級的記憶體,成本與技術門檻皆高。Strata 把這個門檻壓到單張 12GB 顯示卡即可起步,因而在開發者社群引起廣泛關注。專案亦提供多語言說明文件,涵蓋中文、日文、德文、法文、西班牙文與葡萄牙文,降低了非英語使用者的進入障礙。
Strata 如何在 12GB 顯示記憶體上運行 125B 模型?
Strata 把混合專家的負載分散到整台電腦:顯示卡保留最常用的專家,系統記憶體容納全部,處理器分擔其餘運算,固態硬碟存放查找表。
關鍵在於模型本身的架構。Qwen3.8-Flash-Next 採用混合專家設計,內部由 24,576 個小型專家網路組成,而每個詞元僅需其中十個專家參與運算。Strata 便把這些專家依使用頻率分層擺放:最常被取用的數千個專家常駐顯示卡,全部專家保留在系統記憶體,其餘由處理器同步運算,固態硬碟則存放一份大型查找表。
第二項機制是加速取樣。小型輔助模型先猜測接下來數個詞元,再由大型模型一次核對並保留正確者,藉此在不改變輸出結果的前提下,把回應速度提升約 1.6 至 1.8 倍。長文本則以每批最多 8,192 個詞元的方式讀入,讀取速度可超過每秒一千個詞元。專案強調,這些做法讓模型「以廚房作比喻」——常用的器具留在檯面,其餘收納於儲藏室,需要時再取用。
Strata 的推論速度表現如何?
在 RTX 5070 搭配 64GB 記憶體的實測中,Q2_0 量化版本每秒可輸出 94 個詞元,IQ3_S 為 53 個;讀取長提示每秒超過一千個詞元。
專案在兩台一般遊戲電腦上公布實測數據。配備 RTX 5070、十二 GB 顯示記憶體與六十四 GB 記憶體的 NVIDIA 平台,Q2_0 量化版本每秒輸出 94 個詞元,IQ2_XS 為 79 個,IQ3_S 為 53 個,Coder 版本為 55 個;讀取提示的速度介於每秒 1,620 至 2,650 個詞元。至於配備 RX 9070 XT 與十六 GB 顯示記憶體的 AMD 平台,Q2_0 每秒輸出 60 個詞元,IQ2_XS 為 52 個。
專案說明,一般閱讀速度約為每秒數個詞元,因此每秒 60 個詞元已快於人工閱讀。顯示記憶體容量直接影響速度,擁有二十四 GB 顯示記憶體的 RTX 3090,預期可達每秒一百至一百四十個詞元。首次啟動時,Strata 會把三十五至五十五 GB 的模型載入系統記憶體並鎖定部分供顯示卡使用,過程中電腦可能遲滯一至三分鐘,這屬於正常現象。
Strata 提供哪些模型選擇?
Strata 提供多種量化版本,包括適合 32GB 記憶體的 Coder 版本、平衡品質的 IQ2_XS 與 IQ3_S,以及 Unsloth 四位元版本。
安裝程式會依系統記憶體推薦合適版本。三十二 GB 記憶體的使用者可選 Coder 版本,它移除半數專家以縮減體積,在 SWE-bench Verified 測試中達到完整模型 91% 的分數,適合程式碼任務,但在中文等非程式領域表現較弱。四十八 GB 記憶體建議使用 IQ2_XS,六十四 GB 則推薦 IQ2_XS,並可選用 IQ3_XXS 或品質最佳的 IQ3_S。
此外,專案列出數個由社群維護的變體。Swift 1.5 是縮短思考時間的微調版本,輸出更快而品質相近;Unsloth 的 UD-IQ4_XS 約為四位元,品質介於 IQ3_S 與 UD-Q4_K_XL 之間,下載約九十四 GB,需要較大記憶體;UD-Q4_K_XL 最接近完整模型,但多數資料需即時從固態硬碟讀取,在六十四 GB 電腦上僅能每秒輸出七至八點五個詞元。專案建議使用固態硬碟,以縮短首次啟動時間。
如何開始使用 Strata?
Windows 使用者雙擊 START-HERE.bat,Linux 使用者執行 setup.sh;安裝程式會偵測硬體並下載約 70GB 模型,完成後於瀏覽器開啟本機服務。
安裝方式分為兩種。若使用 Claude Code、Cursor、Codex 或 GitHub Copilot 等工具,可直接把專案的設定指示貼入其中,由 AI 助理依照 docs/AI_SETUP.md 檢查顯示卡、記憶體與硬碟,挑選合適模型後完成安裝與啟動。若不採用此方式,則下載或複製專案後,Windows 使用者雙擊 START-HERE.bat,Linux 使用者於資料夾中執行 setup.sh。
安裝程式會詢問模型與尺寸、上下文長度,以及是否啟用圖片輸入,多數情況直接按 Enter 採用建議值即可。接著下載約七十 GB 的模型,過程中斷可重新執行續傳。啟動後,瀏覽器會開啟 Strata 應用,內含聊天、即時監控模型與顯示卡狀態的 Monitor 分頁,以及顯示設定與位址的 About 分頁。關閉視窗即停止模型,日常只需重新執行啟動檔,更新則執行 UPDATE.bat 或 update.sh。
Strata 的 API 與工具整合能力如何?
Strata 在本地提供 OpenAI 相容端點與 Anthropic 訊息端點,可接入 Claude Code、Codex CLI 等工具,並以 MCP 伺服器支援自行啟停。
整合能力是此專案的另一個重點。使用者可在任何支援「OpenAI 相容供應商」的應用中,填入基底位址 http://127.0.0.1:8080/v1,任意 API 金鑰與模型名稱皆可接受。使用 Anthropic API 的應用則指向 http://127.0.0.1:8080/v1/messages,Claude Code 只需設定 ANTHROPIC_BASE_URL;Codex CLI 等使用 OpenAI Responses API 的應用則對應至 /v1/responses。
專案同時內建 MCP 伺服器,讓 AI 工具能自行安裝、啟動與停止 Strata。思考深度可選擇關閉、低、中或高,關閉最快,高適合困難問題。圖片輸入在設定時選擇啟用後即可使用,AMD 顯示卡在 Linux 透過處理器讀取圖片,Windows 則尚未支援。預設一次處理一個請求,其餘排隊等待,若需並行可調整設定,但在十二 GB 顯示卡上會使每次回應變慢。
Strata 與雲端模型服務有何差異?
差異在於資料主權與成本結構。Strata 的推論完全在使用者硬體上完成,對話不離開本機,亦無需按用量付費,但需自行負擔硬體與電力。
兩者的取捨集中在三個面向。第一是資料主權,雲端服務需把提示與對話傳送至第三方,Strata 則全部在本機處理,適合對資料外流敏感的個人與團隊。第二是成本結構,雲端採訂閱或按用量計費,Strata 為一次性硬體投入,長期高用量下可能更為經濟。第三是取得門檻,雲端服務註冊即可使用,Strata 需要十二 GB 以上顯示記憶體與三十二 GB 以上記憶體的中高階電腦,並須完成約八十 GB 的下載。
效能與品質亦是考量因素。消費級硬體上的量化模型,與雲端完整精度模型之間仍存在差距,專案亦坦言較小的量化版本較快、較大的版本較聰明。對於需要最高推論品質、或硬體條件有限的使用者,雲端服務仍是更直接的選擇;而對於重視隱私、具備合適硬體,並願意投入設定時間者,本地推論提供了另一條路徑。
出處連結有哪些?
本文資訊來源為 Strata 的 GitHub 儲存庫與官方文件,內容涵蓋專案定位、硬體需求、安裝方式與授權條款,讀者可透過下列連結查證。
- 12,526GitHub 星標
- 1,058複製次數
- 81訂閱者
- C++主要語言
- MIT授權條款
- 125B模型參數
- GitHub 儲存庫:https://github.com/Niko1221/Strata
- 模型(Qwen3.8-Flash-Next):https://huggingface.co/Qwen/Qwen3.8-Flash-Next
- 安裝文件:https://github.com/Niko1221/Strata/blob/main/docs/INSTALL.md
常見問題有哪些?
Strata 的常見疑問集中在硬體門檻、收費、語言支援與安全性;專案開源免費,建議配備 12GB 顯示記憶體與 64GB 系統記憶體,模型下載約需 80GB 空間。
Strata 是免費的嗎?
是。專案以 MIT 授權開源,可自由使用與修改;若運行順利,開發者接受贊助以維持後續維護。
運行 Strata 需要什麼硬體?
需要 NVIDIA RTX 20 至 50 系列或指定 AMD Radeon 型號、12GB 以上顯示記憶體、32GB 以上系統記憶體,以及約 80GB 硬碟空間,六十四 GB 記憶體可運行所有尺寸。
Strata 支援中文嗎?
支援。完整專家版本如 Q2_0、IQ2_XS 與 IQ3_S 可處理中文與其他東亞文字;移除半數專家的 Coder 版本在中文表現較弱。
Strata 的對話資料會上傳嗎?
不會。推論完全在本機完成,對話內容不離開使用者硬體;首次啟動需下載模型,之後可離線運行。
Strata 可以給多個應用同時使用嗎?
可以。它提供 OpenAI 與 Anthropic 相容端點供多個應用連接,但預設一次處理一個請求,其餘排隊,可調整設定開放並行。
總結:Strata 適合什麼使用者?
Strata 適合重視資料主權、擁有中高階顯示卡且願意調整設定的開發者與進階使用者;若追求即開即用或需要頂級推論品質,雲端服務仍是更簡單的選擇。
Strata 的價值在於把千億參數等級的模型推論,從伺服器機房帶回個人電腦,並以混合專家分層、加速取樣與批次讀取等機制,在十二 GB 顯示記憶體的硬體上維持可用的速度。專案在二零二六年九月建立後迅速累積 12,526 顆星標與 1,058 次複製,以 C++ 撰寫、採用 MIT 授權,並持續更新。對於擁有中高階顯示卡、重視資料不離開本機,且願意依記憶體容量挑選量化版本的使用者,它提供了一條低門檻且可自行掌握的本地推論路徑。