Google 於二零二六年十月二十三日發布 Agent Development Kit 2.13.0,把十二項成熟的實驗功能轉為正式,並讓字串模型代理的執行回合提速最多八倍。此版同時引入分類器節點、即時語音插話與 MongoDB 工作階段服務,遙測預設則切換至 OpenTelemetry GenAI v2。
Google ADK 2.13 是什麼?
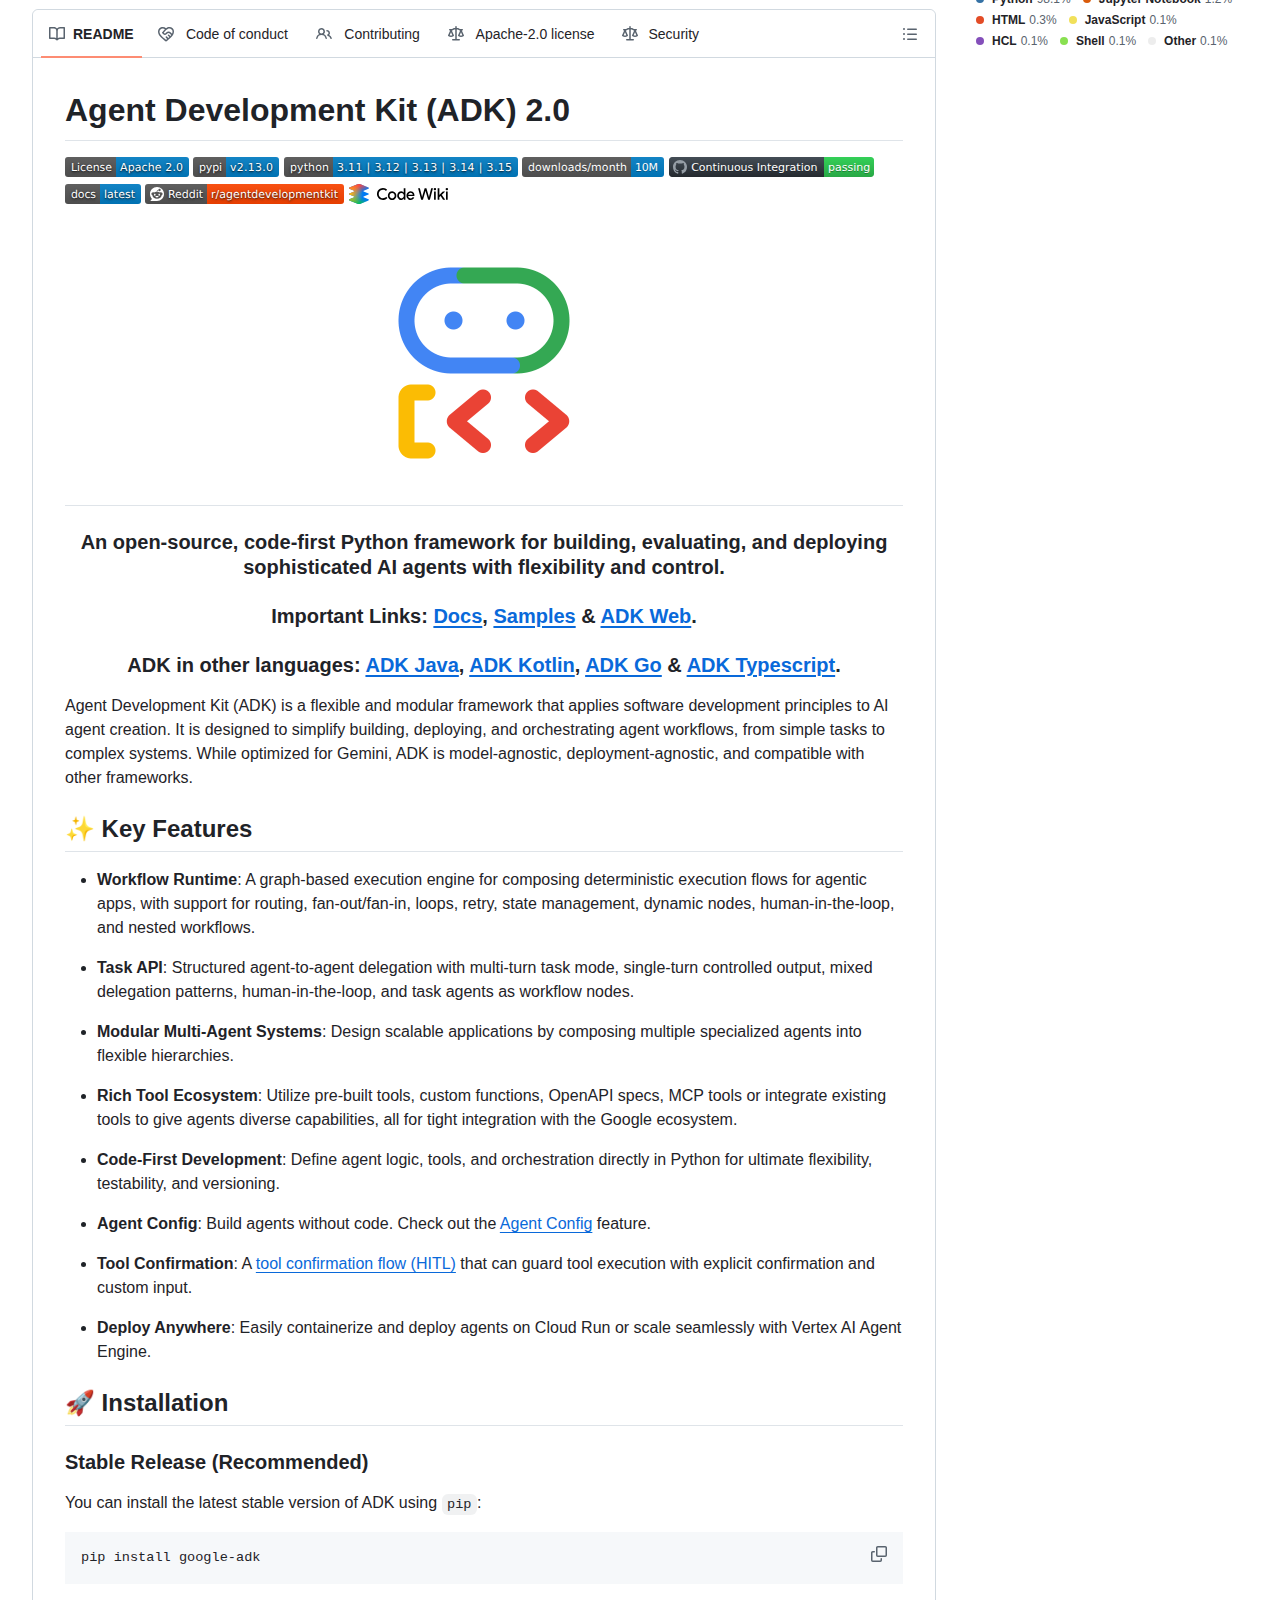
Google ADK 是開源的程式碼優先 Python 代理框架,二零二五年四月建立,採 Apache-2.0 授權。2.13.0 於二零二六年十月二十三日發布。
專案全名為 Agent Development Kit,儲存庫以 ADK 2.0 稱呼目前的架構。其定位是把軟體工程原則套用到代理開發,核心由兩個類別構成:Agent 定義模型、指令與工具,Workflow 以圖形邊界把多個代理與任務串成可預期的執行流程。這種分工讓開發者可以用節點描述分支、扇出與扇入、迴圈、重試、狀態管理與人工介入,而不必把控制邏輯寫散在提示詞裡。
框架自稱模型無關、部署無關。雖然對 Gemini 系列做最佳化,實際可搭配其他模型供應商與第三方框架,並提供 Java、Kotlin、Go 與 TypeScript 的移植版本。部署路徑包含本機 Docker 容器、Cloud Run 與 Vertex AI Agent Engine,指令分別為 adk deploy docker 與 adk deploy cloud_run。
使用規模已超出實驗階段。PyPI 套件 google-adk 近三十日下載一千零一十萬次,近七日二百三十一萬次,單日四十萬次。對一個 2025 年 4 月才建立的專案而言,這個下載量說明它已被放進實際的建置流程,而非僅停留在範例階段。
這次有哪些實驗功能轉為正式?
2.13.0 把十二項實驗階段功能升為正式,涵蓋工作流節點、工具確認與部署整合。清單集中在官方功能註冊表頁面,升級後不再觸發實驗警告。
版本說明把這一步列為首要亮點,措辭是穩定核心功能。ADK 過去一年採用「先以實驗旗號推出、再依使用回饋調整介面、最後轉正」的節奏,實驗狀態的功能會在執行時輸出警告,並可能在後續版本改變行為。十二項同時轉正意味著這批介面已定案,企業可以把它們納入長期維護的程式碼,不必每次升級都重新驗證。
配套改動是警告抑制機制。環境變數 ADK_SUPPRESS_EXPERIMENTAL_FEATURE_WARNINGS 現在會被正確尊重,先前對應的問題編號為 5114。對於仍使用其他實驗功能的團隊,這條路徑讓日誌保持乾淨,同時保留選擇性啟用的能力。
值得注意的是轉正清單的性質。工作流節點、工具確認流程與部署整合都屬於生產環境才會碰到的環節,而非單純的模型呼叫封裝。把這些環節定案,等於承認框架的主要使用者已從個人實驗轉向團隊維運。
八倍加速是怎麼做到的?
官方量測顯示字串模型代理的執行回合提速最多八倍,並降低事件載入開銷。改動集中在事件處理路徑與工作流節點的工具執行緒池設定。
加速的適用範圍寫得具體:字串模型代理。在 ADK 中宣告代理時可以直接填入模型名稱字串,也可以傳入 BaseLlm 實例。前者路徑在 2.13.0 之前的實作每次回合都重新解析模型資訊,長對話累積後成為固定開銷,此次改動把這層重複工作移除,官方給出的上限是八倍。
第二項是事件載入。代理執行時每一步都會產生事件並寫入工作階段,恢復長對話需要把事件序列讀回。2.13.0 降低了這段的處理成本,對動輒上百回合的代理任務影響明顯。第三項是工作流層:同步節點現在會尊重 tool_thread_pool_config,先前這個設定只對非同步路徑生效,導致同步節點的工具呼叫被迫序列執行。
觀測能力同步補上。評估結果中的呼叫耗時被拆成模型、工具與框架三段,先前只知道總時間,無法判斷延遲來自模型推理、外部工具或框架本身。搭配前一版 2.12.0 在長工作階段中把首次模型請求時間削減四成的改動,可以看出連續兩個版本都在處理同一個問題:代理執行時間越長,框架自身的固定成本佔比越高。
分類器節點如何改變工作流路由?
新增 BaseClassifier、ClassifierNode 與 LlmClassifier,並整合 TypeSafe Jev 模型。Jev 以單次前向傳遞輸出校準機率。
多代理系統的常見瓶頸是路由。使用者輸入進來後,要判斷交給哪個子代理、走哪條分支,傳統做法是請大型語言模型輸出一個標籤,代價是每次路由都要一次完整推理,延遲與費用隨流量線性上升。
2.13.0 引入的分類器把這件事拆成獨立抽象。BaseClassifier 定義帶型別的問題與答案,ClassifierNode 把分類器接進工作流的圖形邊界,官方同時提供 LlmClassifier 作為以語言模型為後端的基準實作。真正的新意在整合層:TypesafeClassifier 直接呼叫 TypeSafe 的 Jev 模型系列,這類模型以單次前向傳遞回傳校準過的機率分佈。
校準機率的價值在於可設定門檻。語言模型輸出的標籤只有對錯,沒有信心程度;校準機率讓工作流可以設定「低於某個信心值就轉人工」的規則,這正是人工介入機制能自動化的前提。對每天處理數萬次請求的客服或工單分流場景,把路由從大型模型換成小型分類器,是最直接的成本結構調整。
同一版還加入 ForceEscalationPlugin,用於決定性諮詢,並可量測升級次數、權杖與費用。這兩項改動指向同一個設計取向:把「昂貴的判斷」與「例行的判斷」分層,由框架負責調度。
即時語音與 MongoDB 整合帶來什麼?
CascadeLive 連線加入插話支援,並串接 Gemini 語音轉文字與文字轉語音。MongoDB 工作階段與記憶服務讓多個執行個體共用對話狀態。
語音部分補上的是打斷能力。CascadeLiveConnection 現在支援插話,使用者在模型說話途中開口,連線會中止目前的語音輸出並切換到監聽。這在客服與語音助理場景是基本要求,缺了這一項,對話節奏就會僵在「你講完我才講」。同一版把 Gemini 的語音轉文字與文字轉語音接進這條連線,並加入以 ZIP_STORED 打包視覺影格的方法,供需要同步畫面的場景使用。
資料層的改動更值得企業留意。MongoDbSessionService 把工作階段存進 MongoDB,多個執行個體可共用同一份對話狀態,這是水平擴展時的必要條件,先前使用記憶體內工作階段的部署只能靠黏性路由。MongoDbMemoryService 則處理長期記憶,做法是關鍵字比對而非向量相似度,因此不需要嵌入模型,也不需要建立向量索引,任何 MongoDB 部署都能執行。
工具層同步調整。MongoDbToolset 現在可被序列化,部署到 Agent Engine 時不必把連線字串放進封裝;搜尋查詢可交給 Atlas 的自動化嵌入在伺服器端處理,省掉一次 Google 嵌入呼叫與相應憑證。這幾項合起來,把「以 MongoDB 作為代理記憶體」從可能變成可部署的方案。
安全與沙箱也在同版推進。RestApiTool 加入 SSRF 防護,沙箱資源改為每次工具呼叫綁定,而非整個電腦層級共用;新增的 OpenSandbox 環境與 AgentEngineEnvironment 讓程式碼執行可以落在隔離環境。工具層同時支援 Gemini 3.x 的電腦操作瀏覽器動作結構,這是把瀏覽器自動化納入同一套工具定義的前置工作。
升級到 2.13 有哪些破壞性變更?
遙測預設改用 OpenTelemetry GenAI v2,call_llm 跨度被移除。要保留舊格式,可設定環境變數切回 1.36 版語意慣例。
版本說明把這一項單獨列為破壞性變更。舊版發出名為 call_llm 的跨度,新版改用語意慣例 1.44 的標準屬性,模型呼叫的資訊掛在通用跨度上。任何依賴跨度名稱建立的儀表板、告警規則或成本統計腳本,升級後都會收不到資料,而且不會拋出錯誤,只會安靜地歸零。
保留舊格式的方法已寫在版本說明:設定 ADK_TELEMETRY_SCHEMA_VERSION_OPT_IN 為 otel_semconv_1_36。這是過渡手段,官方把預設值往前推,意味著舊格式的支援期有限,較穩妥的做法是升級前先匯出一段真實流量,在新格式下重建面板並比對數字。
其餘修正同樣值得掃過一遍。adk eval 的結束碼現在會反映通過或失敗,先前一律回傳成功,把它接進持續整合管線的團隊在升級後才會真正擋下失敗的評估。本機程式碼執行器不再無限等待,Bigtable 與 LiteLLM 相關的相容問題也有處理,其中 litellm 被限制在 1.106.3 以下。安裝層面要求 Python 3.11 以上,官方另提供 3.11 至 3.15 的約束檔,用以固定間接相依版本。
Google ADK 的數據表現如何?
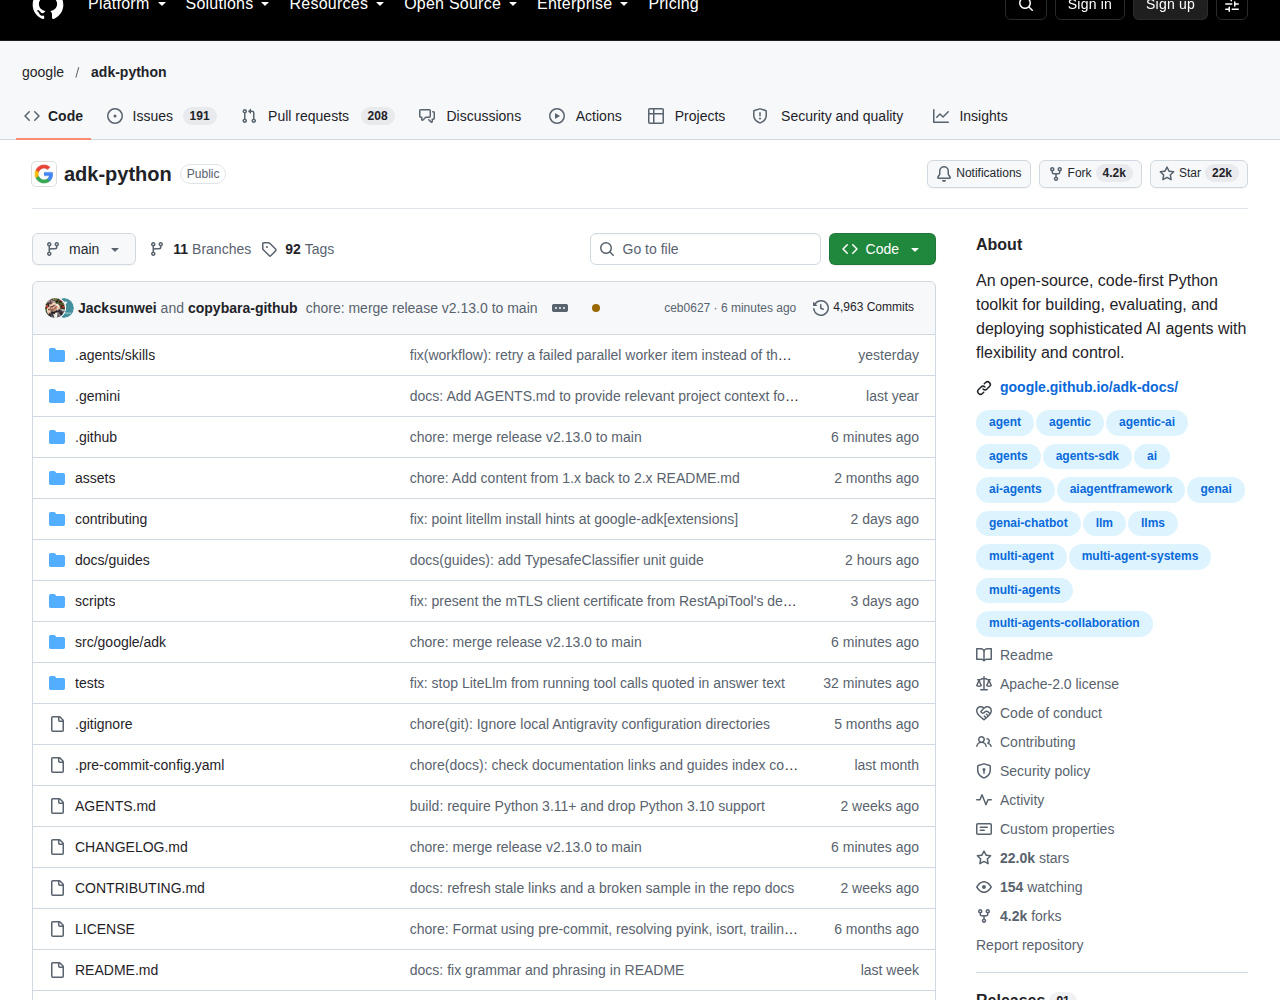
星標 21,983、分支 4,223、註冊貢獻者 429 位、提交 4,963 次,主要語言為 Python,採 Apache-2.0 授權,標註十七個主題標籤。
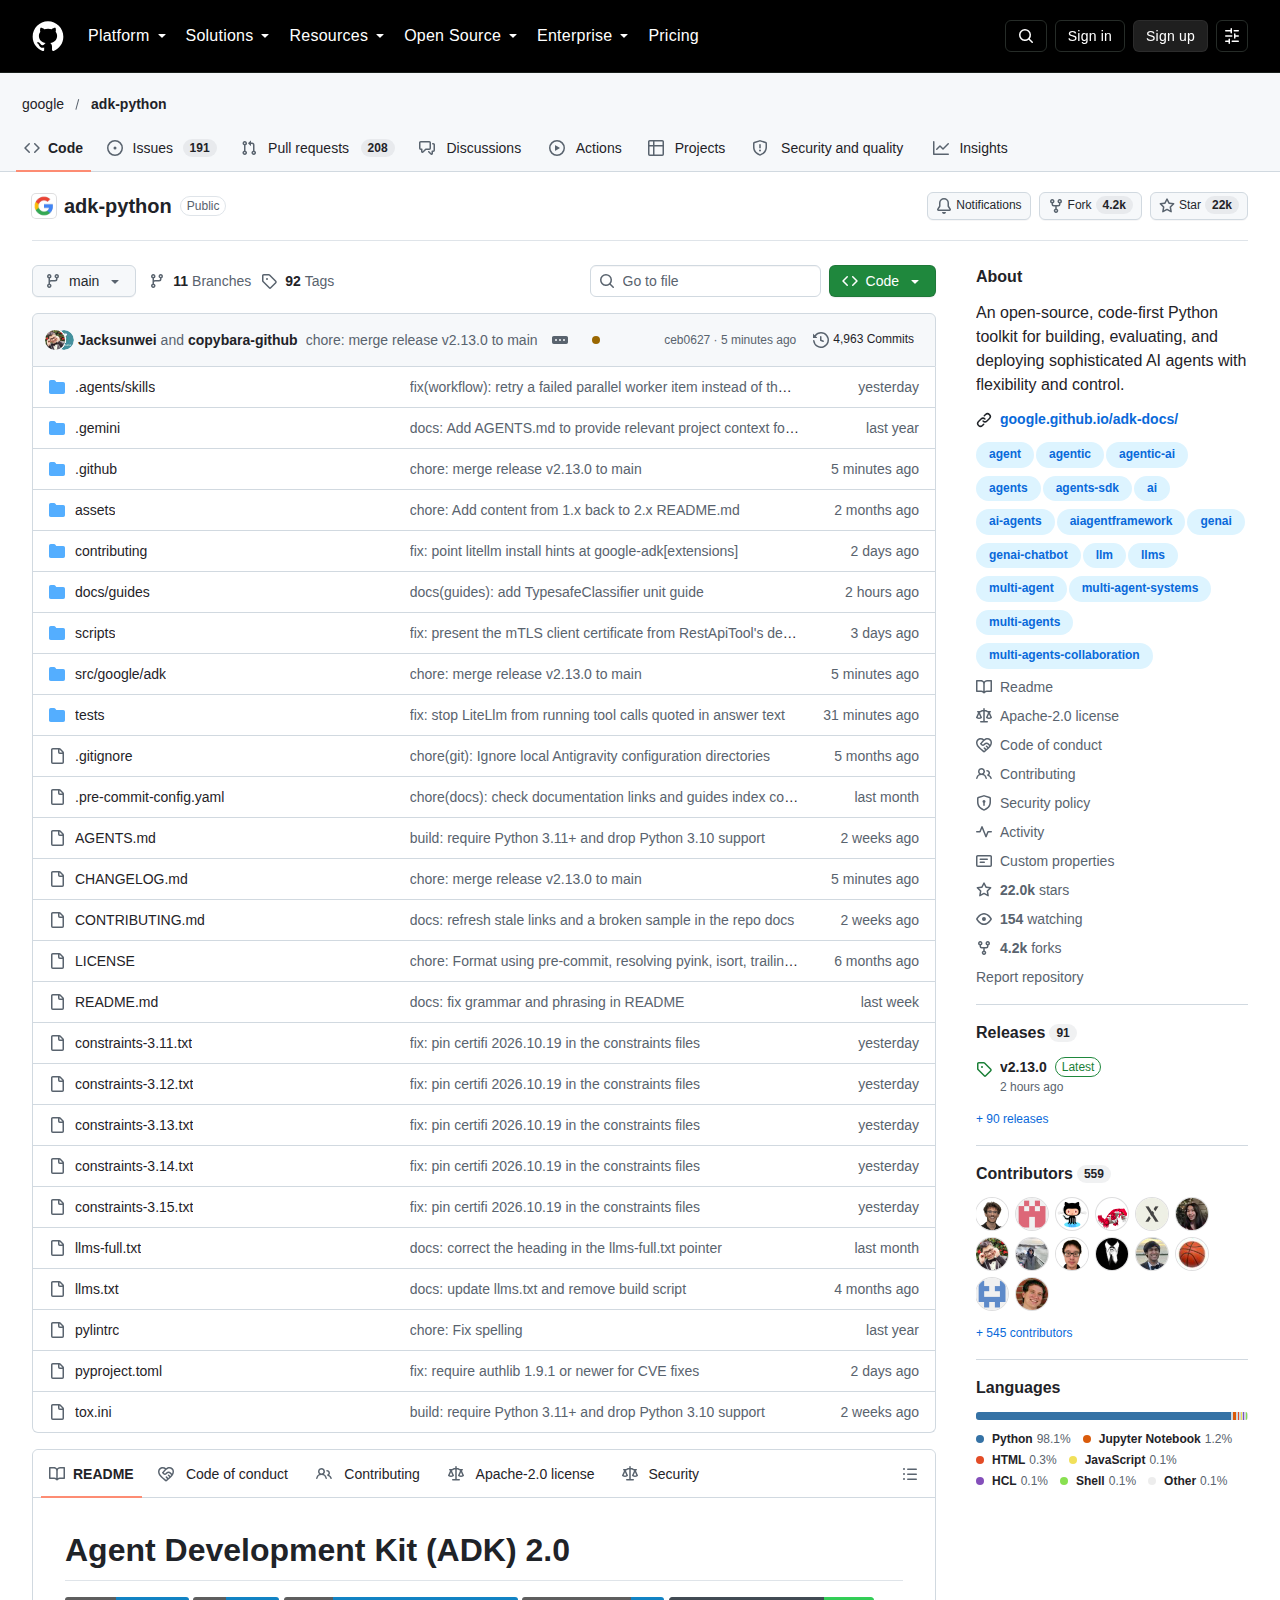
專案在二零二五年四月建立,一年半累積接近二萬二千顆星標。貢獻者結構值得注意:具名註冊者四百二十九位,若計入未註冊的提交者則達六百零四位,提交總數四千九百六十三次。這個比例說明專案吸收了大量一次性貢獻,同時維持由核心團隊主導的節奏。
發布頻率相當規律。2.9.2 於九月十八日、2.10.0 於九月二十五日、2.11.0 於十月二日、2.12.0 於十月十三日、2.13.0 於十月二十三日,大致維持每兩週一次主版本。對照 PyPI 近三十日一千零一十萬次下載,等於每天約三十三萬次安裝,這種規模下任何破壞性變更都會沿著相依鏈擴散,官方把遙測切換寫進版本說明的最上層,是必要的做法。
生態延伸也已成體系。官方維護樣本集 adk-recipes、網頁除錯介面 adk-web 與社群儲存庫 adk-python-community,文件站 adk.dev 另提供 llms.txt 與 llms-full.txt 兩份純文字文件,供開發者直接作為模型上下文使用。這種把文件為模型準備一份的做法,說明團隊已把「代理會讀文件」納入產品設計假設。
出處連結有哪些?
原始碼位於 GitHub 的 google/adk-python,官方文件在 adk.dev,2.13.0 發布頁附完整變更清單與升級注意事項。
專案位址為 https://github.com/google/adk-python,版本頁面列出全部功能、修正與提交編號,功能註冊表的單元指南則說明十二項轉正功能的個別狀態。分類器與即時語音的實作細節分別記錄在分類器節點與串接式即時連線的指南頁,MongoDB 整合另有工作階段服務、記憶服務與工具集三份獨立文件。
若需要評估導入,起點建議是快速入門的兩個類別範例:以 Agent 定義單一代理,以 Workflow 的邊界把 START 接到第一個代理,再串到第二個。這段程式碼不到二十行,足以驗證環境與模型憑證,也能看出框架對控制流程的表達方式是否符合團隊習慣。
總結:Google ADK 2.13 適合哪些團隊?
已用 ADK 建構多代理工作流的團隊可升級,但須先檢查遙測儀表板與評估管線。選型中的團隊可從八倍提速、分類器路由與 MongoDB 記憶判斷是否符合成本結構。
這個版本的訊號意義大於單一功能。十二項功能同時轉正,加上把遙測預設推向新的語意慣例,顯示專案正在從「快速擴張介面」轉向「收斂與定案」。代價是這次升級不像過去幾版可以無痛帶過,凡是接了觀測或評估的管線,都需要安排一次驗證。
適用判斷可以落在兩個條件上。若團隊的核心需求是讓多個代理依固定流程協作、並需要人工介入節點,ADK 的圖形工作流與任務委派提供了比提示詞堆疊更可維護的路徑。若團隊只是需要單次模型呼叫與工具封裝,框架帶來的抽象層反而是負擔,直接使用模型供應商的軟體開發套件更輕。
值得留意的方向是分類器。把例行路由從大型模型剝離到校準機率模型,是目前代理系統成本結構最直接的調整點,而 ADK 把它做成了工作流的一個節點,而不是另一套需要自行拼接的外部服務。這項設計在下一輪實驗功能轉正時,很可能成為主要賣點。
