LiteParse 是 run-llama 於 2026 年 2 月開源的 PDF 解析工具,以 Rust 撰寫、Apache 2.0 授權,GitHub 累積 13,052 顆星。它不呼叫大型語言模型,只以 PDFium 抽取文字、座標與版面區塊,官方基準每頁 2 至 5 毫秒,輸出可直接餵入 RAG 管線的 Markdown 與結構化 JSON。
LiteParse 是什麼?
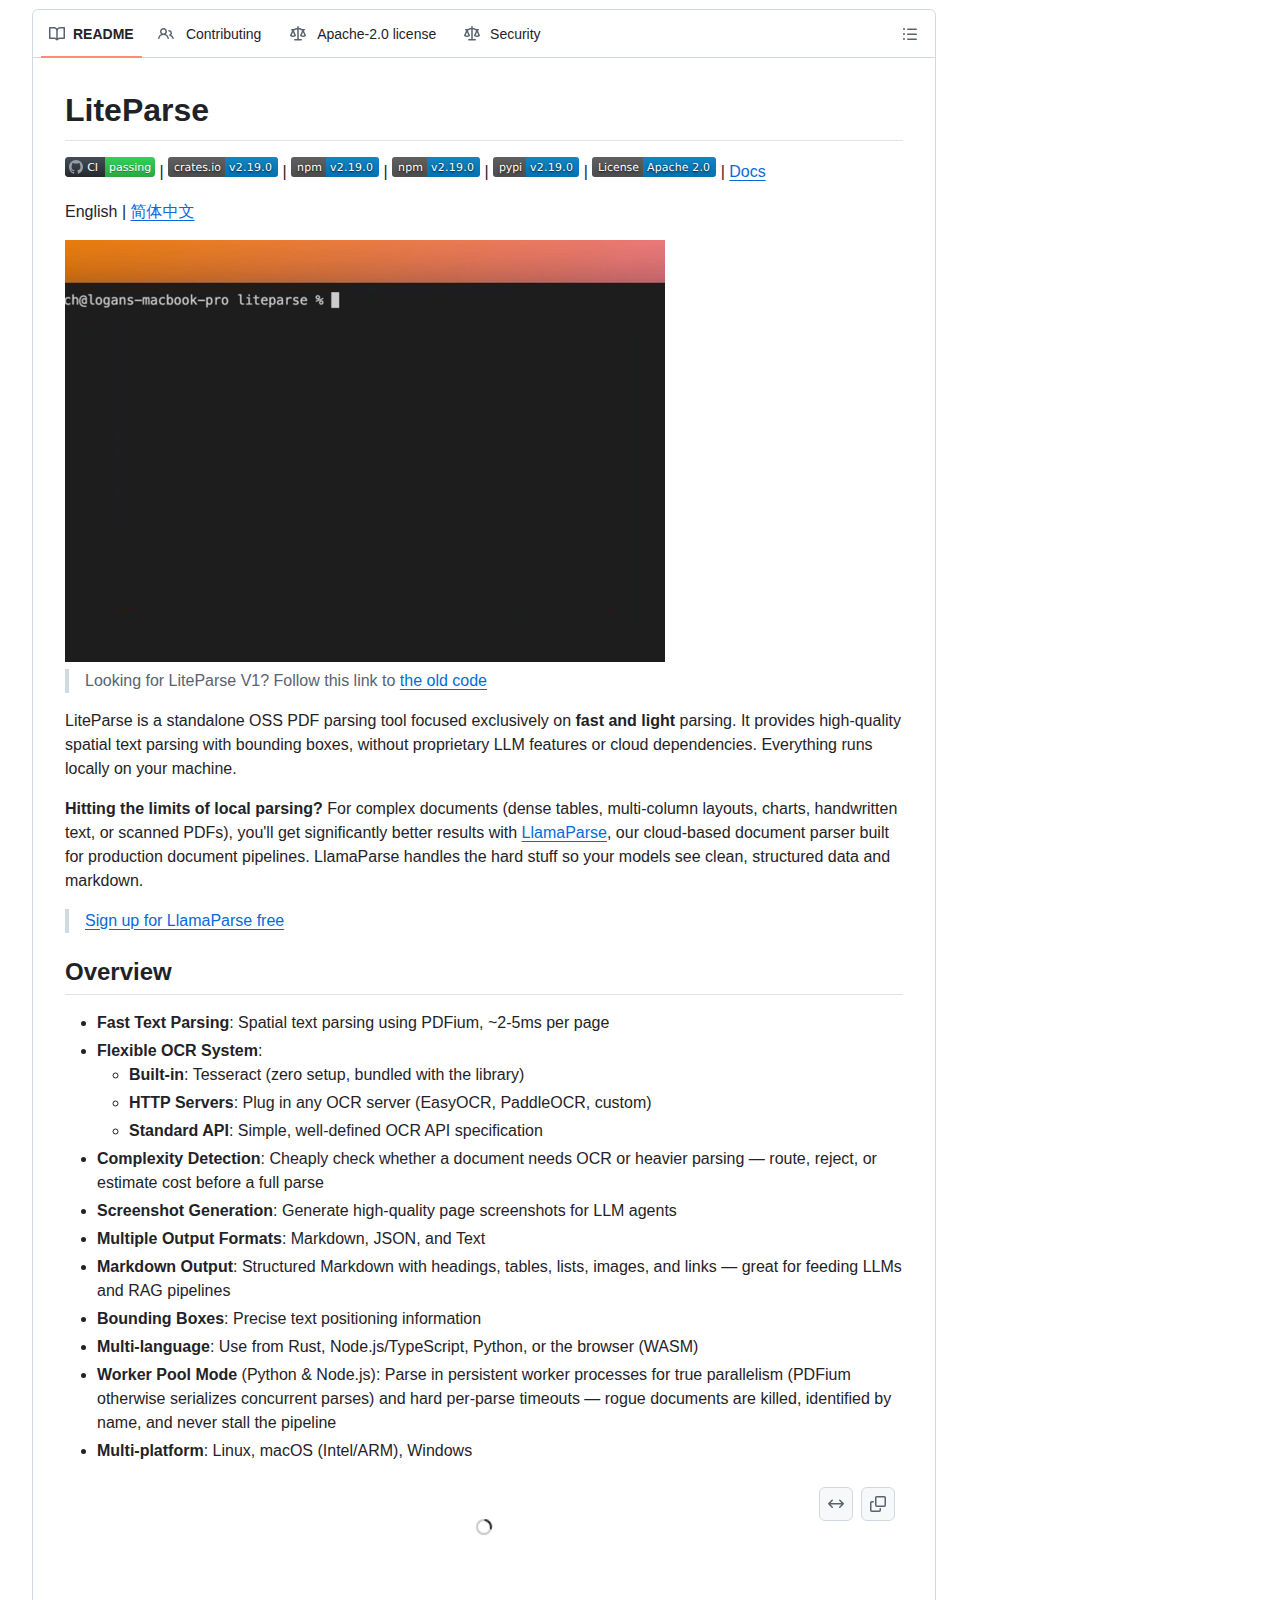
LiteParse 是 run-llama 開源的 PDF 解析工具,以 Rust 撰寫,透過 PDFium 抽取文字與版面座標,在本機輸出 Markdown。
專案由 LlamaIndex 團隊維護,該公司同時經營商業化的雲端文件平台 LlamaParse。LiteParse 的定位與雲端產品刻意分開:只做輕量、本機、無模型依賴的解析,遇到密表格、多欄排版、手寫字或掃描件的難題時,README 直接建議改用 LlamaParse。這種分層在開源專案中並不常見,等於把最容易變現的複雜文件留給商業產品,把速度與可預測性留給開源社群。
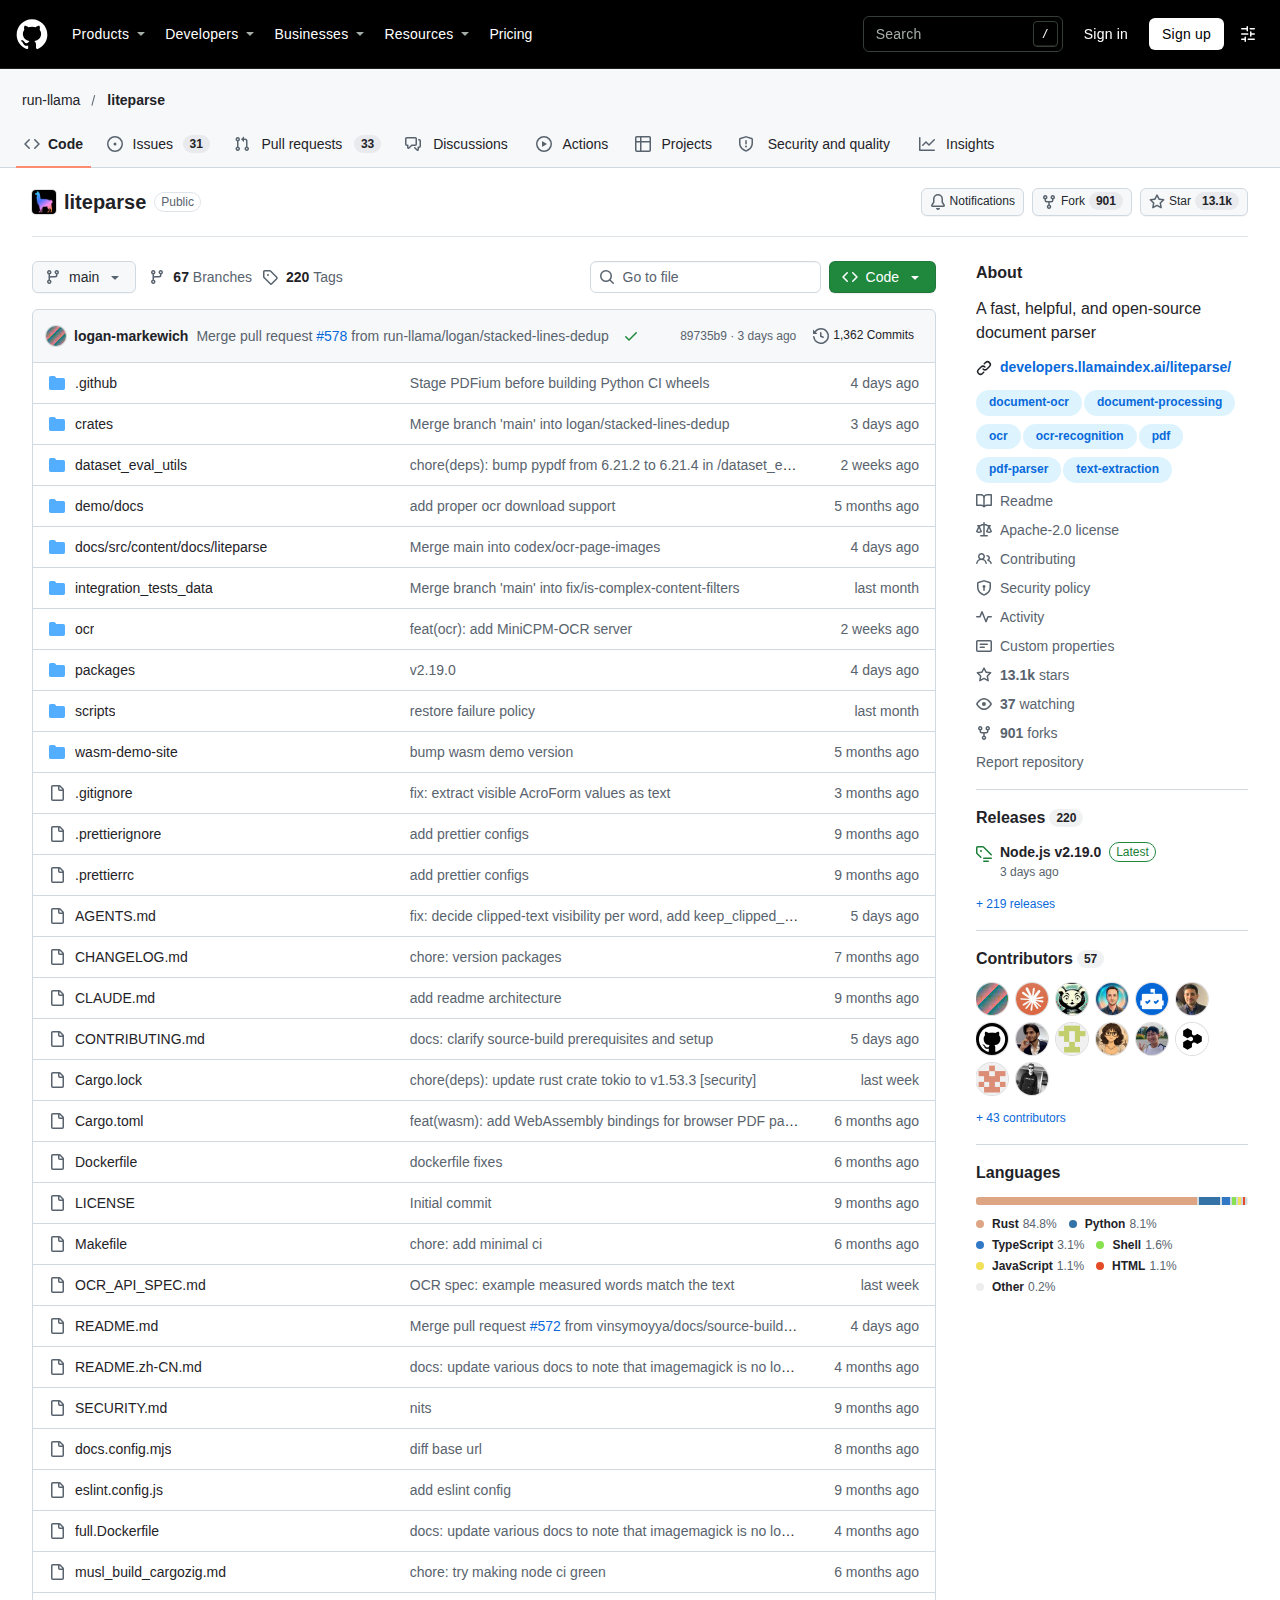
專案在 2026 年 2 月建立,至今累積 219 個版本標籤與 57 位貢獻者,主要語言為 Rust(84.8%),其次為 Python(8.1%)與 TypeScript(3.1%)。README 另有一段說明:早期以其他語言實作的 LiteParse V1 已停止維護,現行程式碼是全面改寫的版本,舊版原始碼仍保留在獨立分支供對照。
LiteParse 的解析速度與準確度表現如何?
官方公布單頁 2 至 5 毫秒。ParseBench 平均 0.389、opendataloader 0.901、olmOCR 通過率 42.2%,同組第一。
README 附上三套公開基準的完整分數,並註明測試在同一部機器上以單一指令重跑,所有工具均為 2026 年 9 月 9 日的最新版本,超連結語法統一關閉。這種把重現指令一併公開的做法,讓分數可以被外部驗證,而不只是專案自述。
| 基準測試 | 量度項目 | LiteParse(無 OCR) | 加 Tesseract | 加 PaddleOCR | 最佳同類免費工具 |
|---|---|---|---|---|---|
| ParseBench(2,049 份) | 五類平均 | 0.364 | 0.380 | 0.389 | pdf-inspector 0.283 |
| opendataloader-bench(200 份) | 閱讀順序、表格、標題階層 | 0.886 | 0.896 | 0.901 | opendataloader 0.842 |
| olmOCR-bench(1,403 頁) | 測試通過率 | 39.6% | 41.1% | 42.2% | pdf-inspector 33.7% |
值得留意的是 OCR 帶來的增益幅度。三套基準中,外接 PaddleOCR 只令總分提升約 0.02 至 2.6 個百分點,說明在原生文字層完整的 PDF 上,主要工作量來自版面重建而非字元辨識。專案亦在文件中如實列出反向結果:標題與頁尾類別加上 OCR 後分數反而下降,原因是 OCR 會把商標與地址圖像中的文字讀回來,而該類別的評分標準要求這些重複內容消失。團隊明言選擇不按頁面位置刪字,這種取態令分數略低,但避免誤刪正文。
LiteParse 的技術架構有什麼特點?
架構分五段:格式轉換、PDFium 文字抽取、選擇性 OCR、OCR 與原生文字合併、網格投影重建版面。輸出 JSON 保留邊界框,可回溯頁面位置。
輸入層支援 PDF、DOCX、XLSX、PPTX 與圖片,非 PDF 格式先經 LibreOffice 或 Rust 的影像與向量繪圖函式庫轉換成 PDF 再進入主流程。核心以 PDFium 抽取文字與座標,再按需要啟動 OCR,最後把 OCR 結果與原生文字層合併,交由網格投影演算法還原閱讀順序、欄位與表格結構。
輸出除了純文字與 Markdown,還有結構化 JSON。JSON 內每個文字項附邊界框,開發者可選擇額外匯出向量圖形(含描邊、填色與貝茲曲線旗標)、PDF 邏輯結構樹、註釋、AcroForm 表單欄位,以及分類後的版面區塊。表單欄位會一併修復記憶體中失去父節點的孤立元件,這對處理政府與金融表單類文件相當實用。
LiteParse 如何處理掃描件與 OCR?
內建 Tesseract 無需額外設定,亦可經標準 HTTP 介面接上 PaddleOCR 等外部服務。複雜度偵測指令可在完整解析前判斷哪些頁面需要 OCR。
專案定義了一份 OCR HTTP API 規格,任何符合規格的伺服器都可以掛上,這使 OCR 引擎的替換成本降到只改一個網址參數。官方倉庫內同時提供 PaddleOCR 與 RapidOCR 兩份參考實作,後者以 ONNX Runtime 執行同一組模型,在純 CPU 機器上單頁速度比前者快 20 至 40 倍。
複雜度偵測是另一項針對生產環境的設計。lit is-complex 只讀文字層,逐頁輸出是否需要 OCR 及原因,包括掃描頁、無文字、文字稀疏、內嵌圖像、字元錯亂、向量文字與註釋文字七類,並在需要 OCR 時回傳非零結束碼。管線可以據此把文件分流、拒收或先估算成本,避免對上千頁檔案做無謂的完整解析。
LiteParse 支援哪些語言與平台?
提供 Rust、Node.js、Python 與瀏覽器 WASM 四種綁定,另有統一命令列工具,支援 Linux、macOS 與 Windows。
四種綁定的安裝方式分別對應各自的套件管理器:Rust 用 cargo、Node.js 用 npm、Python 用 pip、瀏覽器用獨立的 WASM 套件。命令列工具在所有安裝方式下行為一致,方便在容器與本機之間遷移。
Python 與 Node.js 另提供工作者集區模式。由於 PDFium 本身會序列化同時進行的解析,單一行程無法真正並行,工作者集區把解析分散到常駐子行程,並為每次解析設定硬性逾時。逾時的文件會被終止並記錄檔名,不會拖住整條管線,這是批次處理場景中相當關鍵的保護。
如何快速開始使用 LiteParse?
以 pip 安裝後用 lit parse 加 format 參數輸出 Markdown。批次處理用 batch-parse,截圖用 screenshot。
# 安裝(Python)
pip install liteparse

# 解析為 Markdown
lit parse document.pdf --format markdown -o output.md

# 先判斷是否需要 OCR,簡單文件跳過 OCR 以省時間
lit is-complex document.pdf --quiet && lit parse document.pdf --no-ocr

# 批次處理整個目錄
lit batch-parse ./input-directory ./output-directory

# 為語言模型代理生成頁面截圖
lit screenshot document.pdf -o ./screenshots --dpi 300
若把 LiteParse 當作代理技能使用,專案亦提供一行的技能安裝指令,把解析能力掛進支援技能機制的編碼代理。對於需要在本機批次處理數千份 PDF 的團隊,這種「先判斷、再解析」的兩段式流程,比一律開啟 OCR 更省時間。
LiteParse 與 LlamaParse、MarkItDown 如何分工?
LiteParse 免費、本機、無模型,適合原生文字 PDF 前置處理。MarkItDown 分數較低,LlamaParse 是雲端商業服務。
在 opendataloader-bench 上,LiteParse 加 PaddleOCR 得 0.901,MarkItDown 為 0.589,差距主要來自表格結構與標題階層兩項。MarkItDown 的表格分數僅 0.273、標題階層為 0.000,反映其設計重心在於快速抽取純文字而非還原版面;先前對 MarkItDown 的整理 亦提到同一項取捨。
與 LlamaParse 的關係則是互補而非競爭。專案在 README 中明言,本地解析遇到極限時應改用雲端服務,等於承認規則式方法在難例上的天花板。對企業而言,這種分工可以按文件難度分層計費:八成常規文件留在本機處理,兩成難例才付費上雲。
LiteParse 有哪些限制與實際應用場景?
限制集中在圖表與數學公式:ParseBench 圖表類僅得 0.013,數學類別在所有受測工具中均為零。適用 RAG 前置清洗、合約歸檔與代理截圖。
專案自己公布的數據顯示,圖表類別對所有參與測試的免費工具都接近零分,原因是這些工具都不重建圖表背後的數據。數學類別要求輸出 LaTeX,LiteParse 同樣為零,卻仍計入平均分,這一點在解讀總分時需要留意。表格結構分數雖然領先同類,但 0.832 的 TEDS 意味著仍有一定比例的表格無法完全還原。
同類工具中,Marker 2.1 走的是模型加規則的混合路線,Docling 則以版面模型處理表格,三者可依文件難度分工。
在實際場景上,最直接的用途是 RAG 管線的前置清洗。原生文字 PDF 佔企業文件大多數,用本機工具以毫秒級速度轉成 Markdown,可以大幅降低雲端解析費用。其次是為視覺型代理生成頁面截圖與文字座標,讓模型在沒有 OCR 的情況下仍能定位內容。第三類是合規與歸檔場景,全程本機執行代表文件不出內網,對法律與醫療文件尤其重要。
出處連結有哪些?
原始碼、完整文件與基準測試腳本均位於 GitHub 的 run-llama/liteparse 儲存庫,官方另設文件站提供各語言綁定的用法與 API 參考。
- GitHub 儲存庫:https://github.com/run-llama/liteparse
- 官方文件:https://developers.llamaindex.ai/liteparse/
- 基準測試重現腳本:儲存庫根目錄的 run_benchmarks.sh
總結:LiteParse 適合什麼團隊?
適合需在本機批次處理大量原生文字 PDF、又不願為每份文件支付雲端解析費用的工程團隊。若文件以掃描件、手寫表格或圖表為主,雲端服務仍是更現實的選擇。
LiteParse 的價值在於把「解析」與「理解」兩件事分開。它不假裝能讀懂圖表,也不內建語言模型修正,只把版面忠實還原成帶座標的結構化資料,剩下的交由下游模型處理。13,052 顆星與持續的版本節奏,反映這種定位在 RAG 工程圈確實有需求。
對正在建構文件管線的團隊,合理的入門方式是先用複雜度偵測掃一遍現有檔案,統計需要 OCR 的比例,再決定要投入多少在本機流程、多少交給雲端。這種先量測後採購的順序,比直接比較單頁價格更能反映實際總成本。
