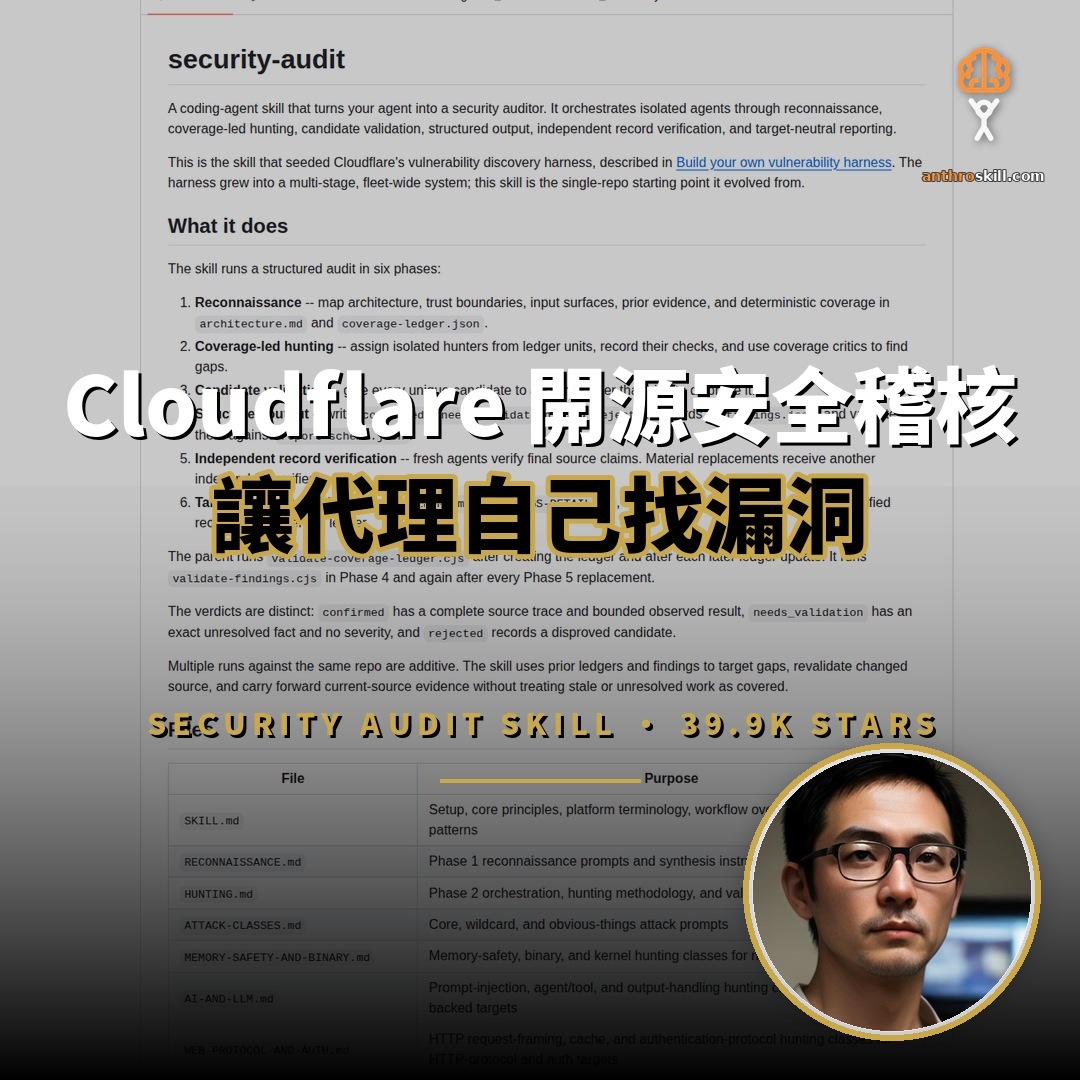
Cloudflare 於 2026 年 6 月開源的 security-audit 技能,在 GitHub 累積三萬九千九百餘顆星標,把通用寫碼代理改造成六階段安全稽核流程:偵察、覆蓋導向搜尋、候選驗證、結構化輸出、獨立複核與中立報告。它是該公司漏洞探索系統的起點版本,採 MIT 授權。
這個技能是什麼?
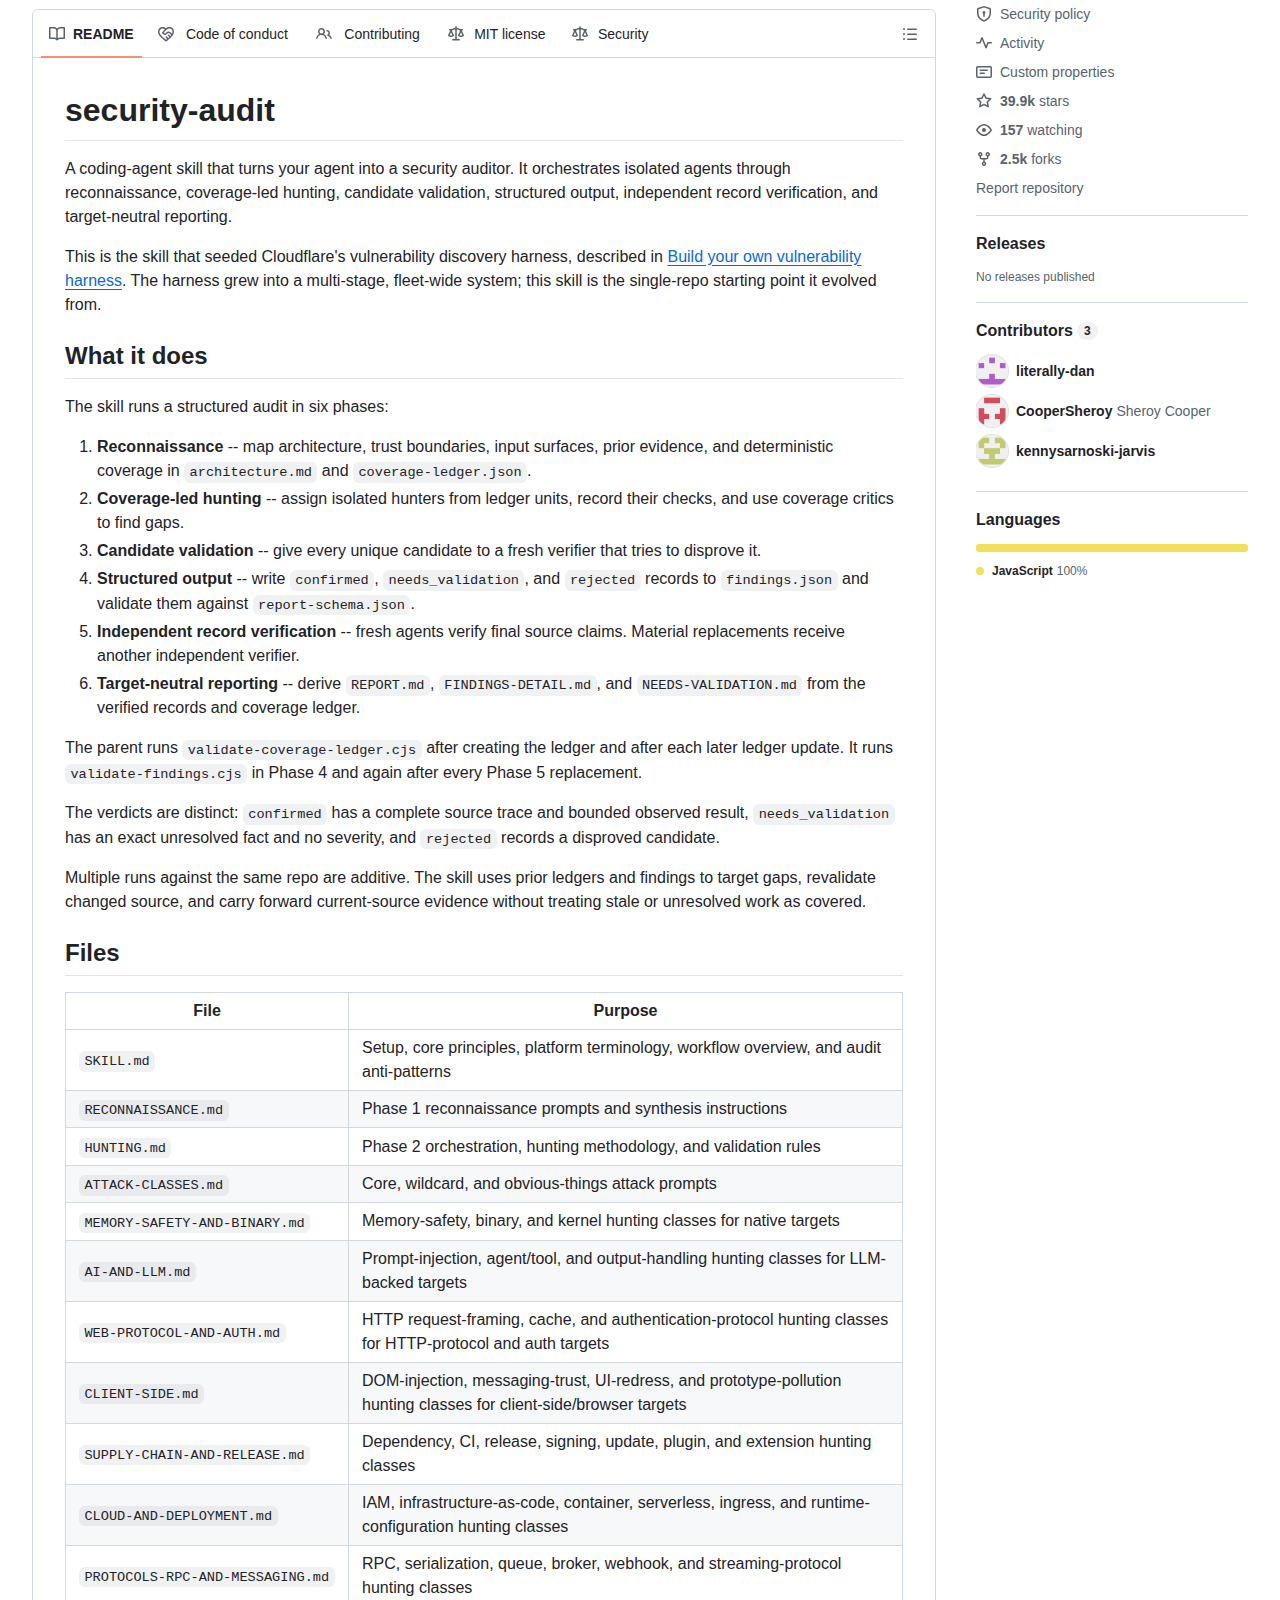
它是一套寫給寫碼代理的指令集與驗證腳本,並非獨立掃描器。代理讀取專案後依六個階段產生架構文件、覆蓋帳本與結構化發現,最後輸出人類可讀報告。
技能的定位與常見靜態分析工具不同。它不解析語法樹,也不依賴規則庫比對,而是讓具備工具調用能力的代理實際閱讀、編譯與執行目標程式,再由另一批代理審查前一批代理的結論。儲存庫內的 SKILL.md 負責設定與原則,其餘十多份文件分別對應不同攻擊類別,涵蓋記憶體安全、提示注入、HTTP 協定框架、客戶端注入、供應鏈與雲端部署等面向。
這種設計的前提假設相當明確:模型本身會產生看似合理但實質空洞的發現,因此流程的可信度必須建立在對抗結構上,而非單一模型的判斷力。專案文件把三種結論嚴格區分為已確認、待驗證與已否證,其中待驗證狀態必須附上一個尚未解決的具體事實,且不得標註嚴重程度。
Cloudflare 為什麼把它開源?
官方部落格說明,這份約四百五十行的技能是整個漏洞探索系統的種子。把它單獨開源,等於公開一套可直接執行的起點,而非企業級編排平台的完整原始碼。
根據 Cloudflare 於官方部落格發表的技術說明,團隊最初在一份儲存庫上手寫約四百五十行的 security-audit 技能,反覆調整提示語直到找出真實缺陷。後來才在其上加入編排層,把每個階段獨立成代理、背後接上資料庫、前方加上協調器,六週內擴展成可覆蓋一百二十八個儲存庫的艦隊掃描系統。
值得留意的是專案對價值的判斷。文件明確指出真正的資產在提示語本身,攻擊情境、缺陷類別與反模式偵測幾乎原封不動地沿用到後來的系統;編排層則被視為可替換的管線。這種切割讓開源版本保持輕量,也讓外部團隊能在不承擔平台複雜度的情況下,先取得最核心的部分。
六個階段如何運作?
流程依序為偵察、覆蓋導向搜尋、候選驗證、結構化輸出、獨立複核與中立報告。前三階段產出與攻擊嘗試並行,後三階段負責把候選轉成可稽核的紀錄。
第一階段由多個平行代理測繪架構、信任邊界與輸入面,產出 architecture.md 與 coverage-ledger.json。第二階段依帳本切分單位,指派隔離的搜尋代理逐格嘗試,並由覆蓋審查者找出尚未觸及的空白區域。
第三階段是整個流程的分水嶺。每個唯一候選都交給一個全新的驗證代理,其任務不是確認,而是盡力否證;只有無法被推翻的候選才進入第四階段,寫入 findings.json 並依 report-schema.json 校驗。第五階段再由未參與前序工作的代理複核原始碼主張,若涉及實質替換,還要再交給另一位獨立驗證者。第六階段純粹由紀錄推導報告,不含模型判斷。
儲存庫附帶兩支零依賴的 Node.js 校驗腳本,分別檢查覆蓋帳本與發現檔案的結構。這種機械檢查只能保證格式與行號指向存在,無法保證結論正確,專案文件對此有明確區分。
為什麼同一個發現要交給另一個代理推翻?
因為代理會為了讓攻擊成立而修改原始碼,再回報自己製造的缺陷。由未參與發現的代理重新驗證,可過濾這類自我實現的假陽性,也讓結論由不同模型交叉檢視。
專案點出三種典型失敗模式:代理改動目標程式使漏洞成立、寫出「執行函式會執行東西」這類同義反覆的證明、以及建構出可運行卻無法證明任何事情的攻擊腳本。對抗式驗證是針對這三種失敗的結構性回應。
更進一步的要求體現在輸出格式。搜尋代理在提交任何發現之前,必須先聲明威脅模型,說明攻擊者是誰、跨越了哪一條邊界或破壞了哪一項假設;欄位順序在結構定義中強制執行這項要求。專案文件指出,這條規則直接淘汰了「若使用者具備資料庫寫入權限即可寫入資料庫」這種空洞結論。
在艦隊層級,Cloudflare 進一步把探索與驗證拆成兩套系統,並刻意使用不同供應商的模型。驗證端以另一組權重與訓練資料審視探索端的輸出,同時讓整個架構對模型版本變動保持鈍感。
實際運行規模與數據如何?
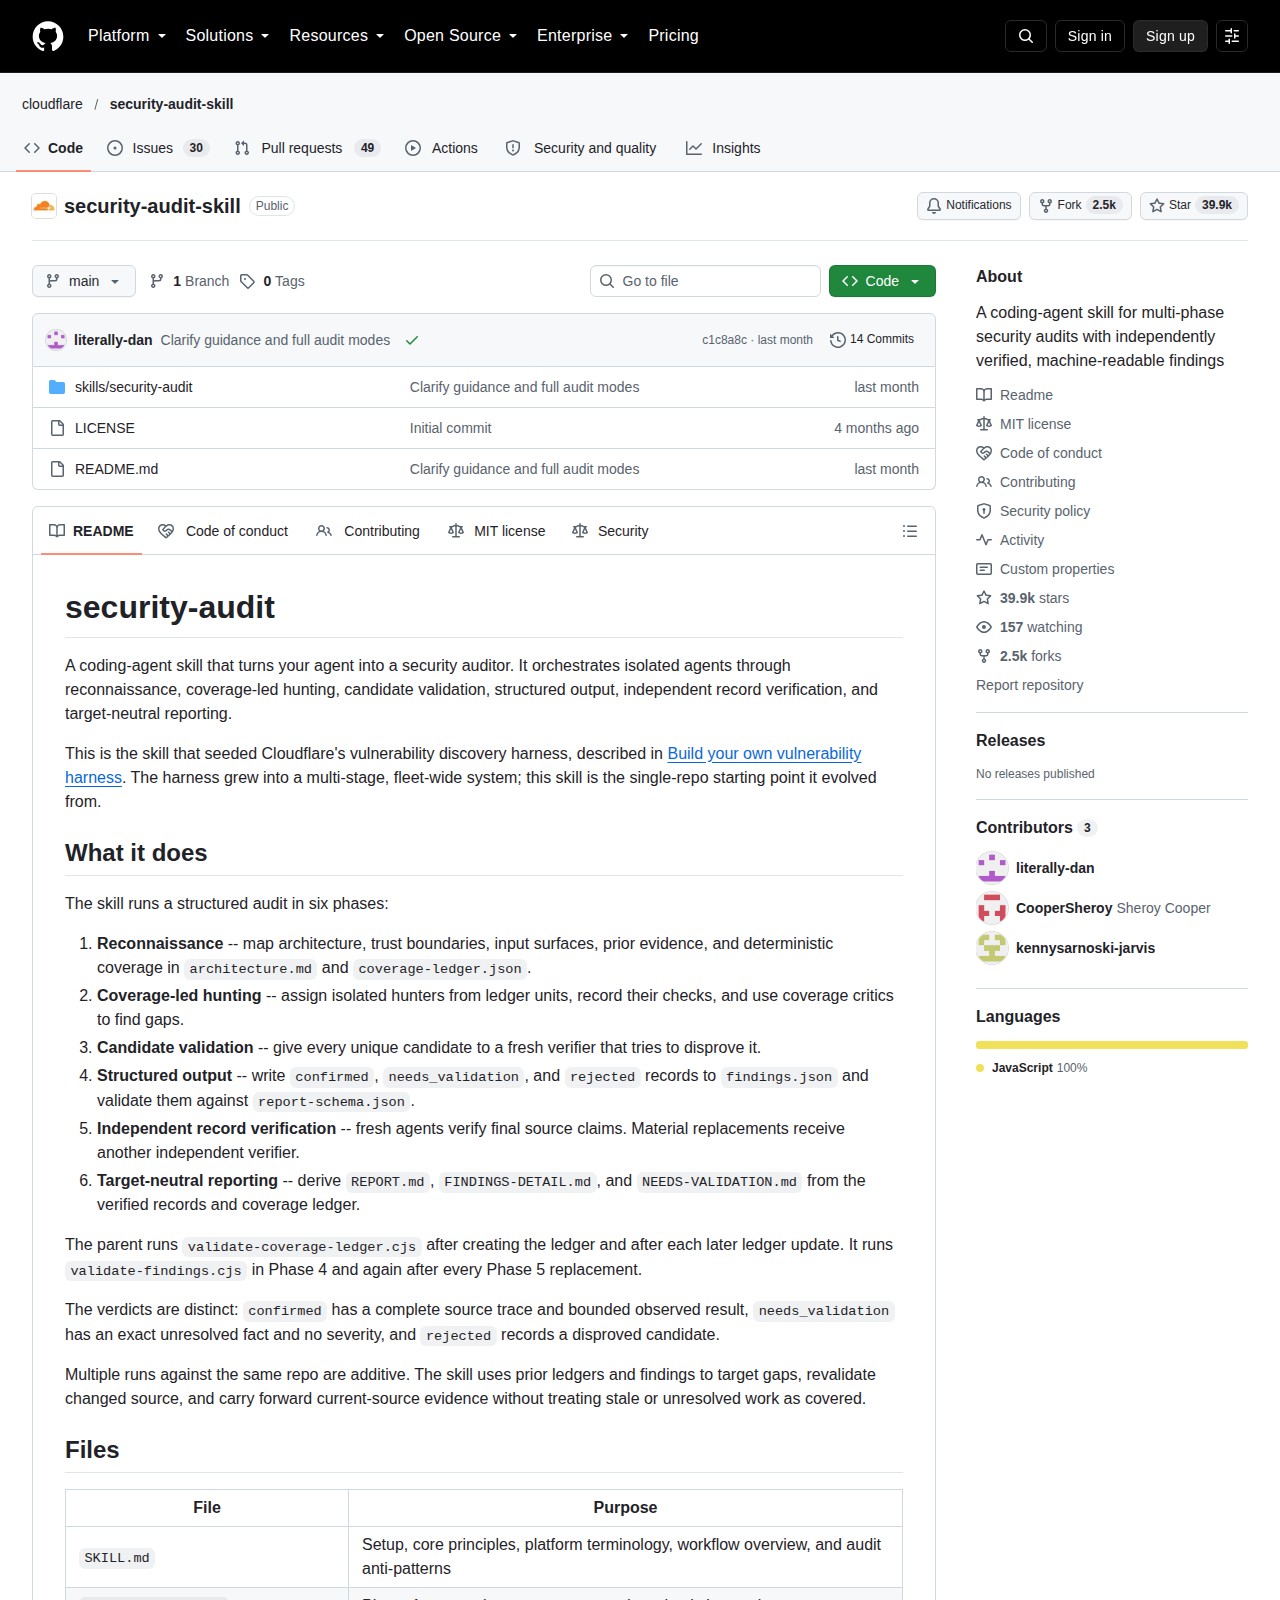
儲存庫累積三萬九千九百餘顆星標、二千四百九十個分支,但提交僅十四次。實際運行層面,願望清單工具累計被寫入二萬五千餘次,跨一百二十八個儲存庫。
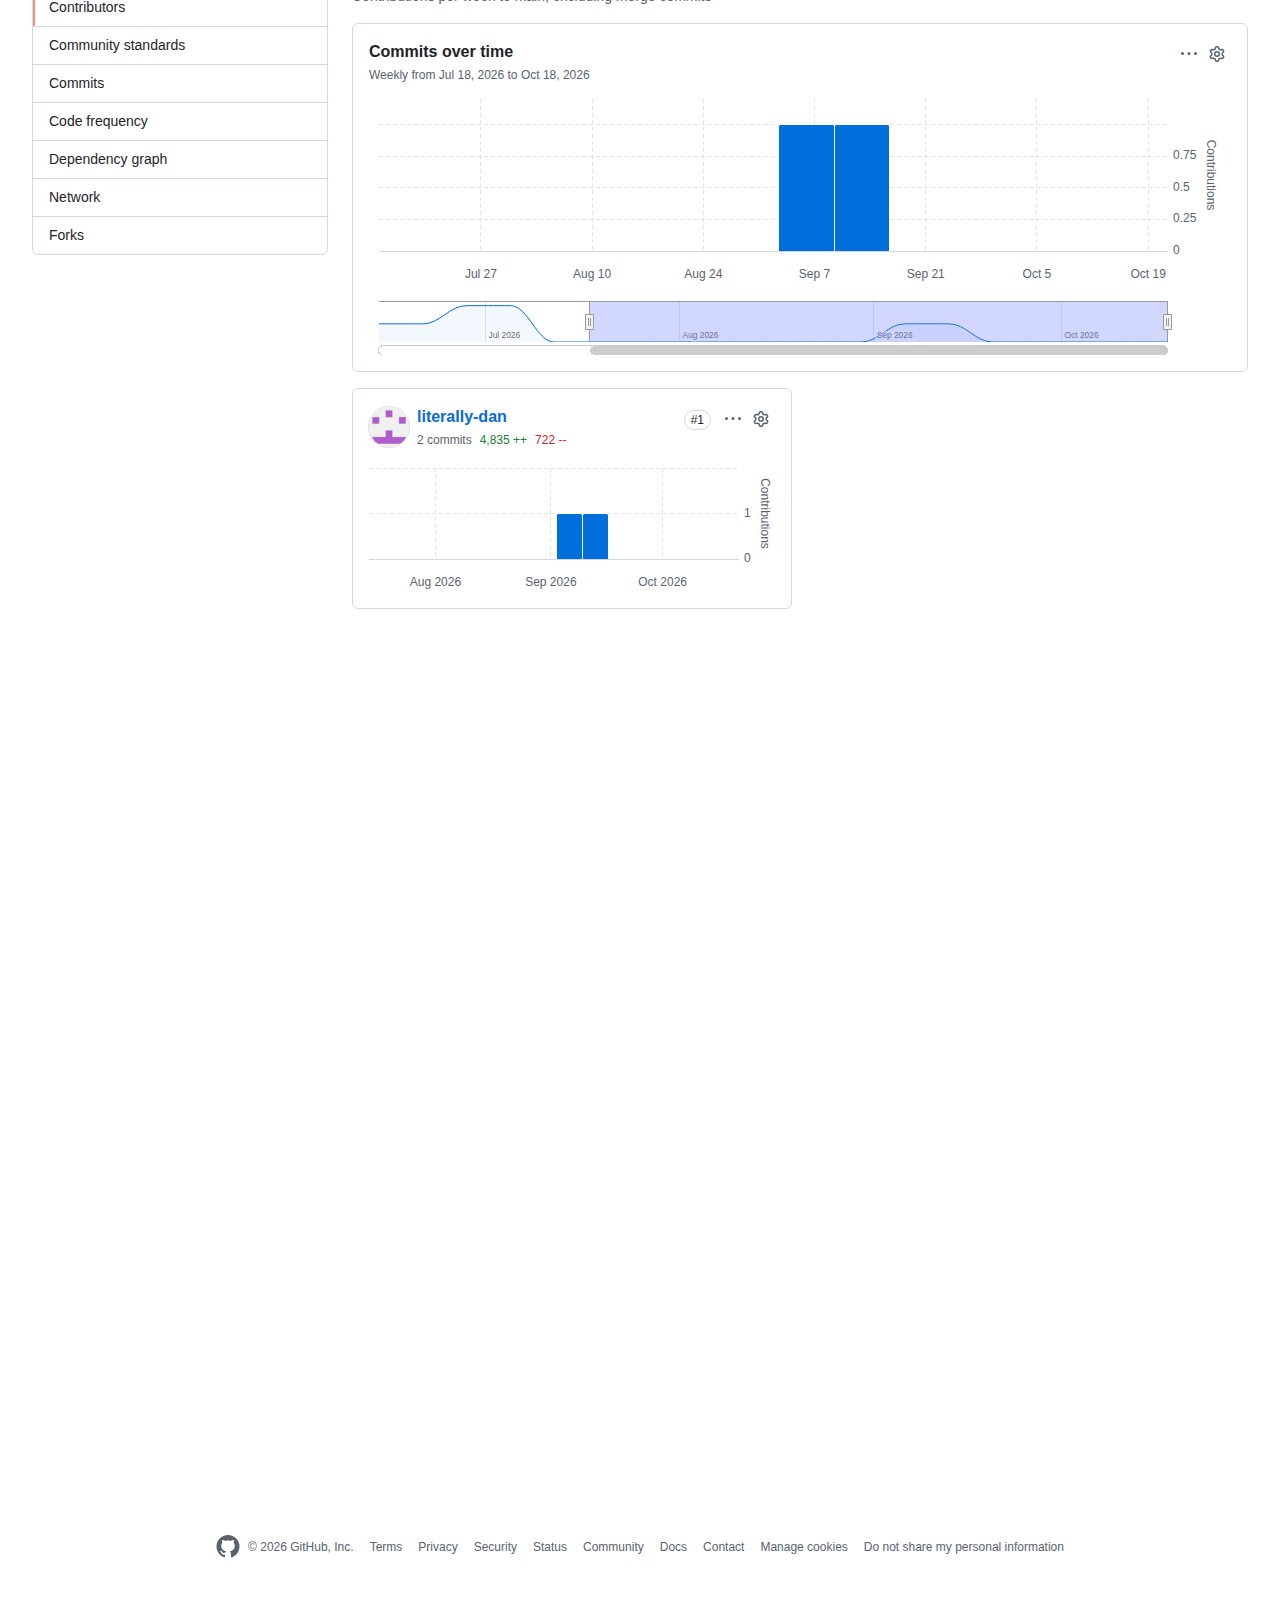
專案自 2026 年 6 月 18 日建立至今,提交次數僅十四次,版本節奏平緩,但社群關注度快速累積。官方部落格披露的運行數據則揭示另一種規模:願望清單工具在加入後累計被寫入二萬五千四百七十二次,跨一百二十八個儲存庫;搜尋代理自行分叉出的同類任務約佔整體任務的百分之九,比例隨模型不同在近乎零到五分之一之間浮動。
使用前需要哪些條件?
需要支援工具調用與平行子代理的寫碼代理、用於校驗腳本的 Node.js,以及具備網路隔離與資源限制的沙箱。缺少沙箱時結論只停留在待驗證。
安裝方式相當輕量,透過 Skills CLI 一行指令即可加入,並可選擇全域安裝。實際觸發靠自然語言請求,例如要求代理對指定目錄進行安全稽核,技能會在請求符合觸發條件時自動啟用;直接要求稽核或滲透測試會進入完整模式,一般性提問則走指引模式。
沙箱條件是整套流程的硬性前提。專案要求沙箱必須關閉外部網路、使用經過清理的允許清單環境、實施資源上限,且只允許寫入指派的暫存路徑。若缺乏這些控制,流程不會執行由目標專案控制的建置、測試、程序、瀏覽器或模糊測試,而是把線索保留為待驗證狀態,並記錄尚未解決的具體事實。
這個做法有哪些限制?
單次執行大約只能找出重複執行總量的一半缺陷,且偏向較簡單的問題。流程也不會自動修補,只產出報告;覆蓋率偏低或噪音過多時,仍需要人工判斷是否值得繼續。
官方在部落格中給出相當直白的自評:觀察覆蓋指標後發現,單次執行找到的缺陷大約只有多次執行總和的一半,且問題偏向表層。當流程退化為「執行十次再人工比對差異」,就代表需要更完整的編排架構。
其他限制包括重複發現的整併。專案指出,判斷兩個複雜邏輯缺陷是否源於同一個根因需要大量推理,因此艦隊版本必須部署專門的整併代理,而非依賴字串比對或路徑檢查。另一個反直覺的觀察是靜態分析工具的實際使用率:團隊把 Semgrep 接入管線後,搜尋代理在一個月內完全沒有調用它,寧願自行閱讀與執行程式碼。
對單一儲存庫的小型團隊而言,這些限制意味著此技能的價值在於流程紀律,而不在於取代既有掃描工具。它產出的是可追蹤的稽核軌跡,不是一份完整的安全清單。
與一般 AI 程式碼審查有何不同?
一般審查由單一代理一次讀完程式碼並列出問題;此技能把工作切成隔離任務,記錄每個覆蓋單位,並要求發現必須通過機械校驗與獨立複核才能成立。
差異首先在狀態管理。單一代理的上下文窗口很快填滿,一旦觸發壓縮便會遺忘先前追蹤的線索;技能把狀態外置成架構文件與覆蓋帳本,讓每次執行可接續前次的缺口,同一儲存庫的多次執行屬於累加關係,變更過的原始碼會重新驗證。
其次是責任分離。發現者不得擔任驗證者,驗證者也不得提交自己的發現,這種設計在傳統人工流程中屬常規,在代理流程中卻需要刻意以結構強制。最後是結論的顆粒度:一般審查傾向輸出一段建議,此技能輸出三種狀態明確的紀錄,其中待驗證狀態必須攜帶一個精確的未解事實,方便後續補齊。
資料來源有哪些?
本文資料來源為 Cloudflare 的 security-audit-skill 儲存庫與流程文件,以及官方部落格關於漏洞探索系統架構的技術文章。
- GitHub 儲存庫:https://github.com/cloudflare/security-audit-skill
- 技術說明文章:https://blog.cloudflare.com/build-your-own-vulnerability-harness
- 技能安裝入口:https://skills.sh
- 授權條款:MIT
總結:值得團隊採用嗎?
具備沙箱環境與維運能力、且需要可追蹤稽核紀錄的團隊值得一試;只想要快速清單或缺乏隔離環境者,導入成本高於效益。
三萬九千餘顆星標與二千四百餘個分支,反映市場對「代理做安全稽核」這個題目的高度興趣,但專案本身的提交節奏與文件規模,說明它仍是一份精煉的起點而非成熟產品。它真正提供的是一套可驗證的方法論:把不可靠的模型輸出,透過隔離、對抗與機械校驗層層收斂成可審查的紀錄。
評估時值得注意兩個實際門檻。其一是沙箱,沒有網路隔離與資源限制的環境,流程會退回只讀模式,價值大幅下降。其二是人力,重複執行的成本、待驗證項目的追蹤與整併,都需要具備安全背景的人員介入,模型只承擔蒐集與初步篩選。
對於正在建立內部安全流程的組織,務實的做法是先以單一儲存庫跑完整一輪,檢查產出的覆蓋帳本是否真實反映測試範圍,再決定是否擴大。專案的 MIT 授權降低了試用成本,但紀律帶來的額外工時才是長期成本所在。
