
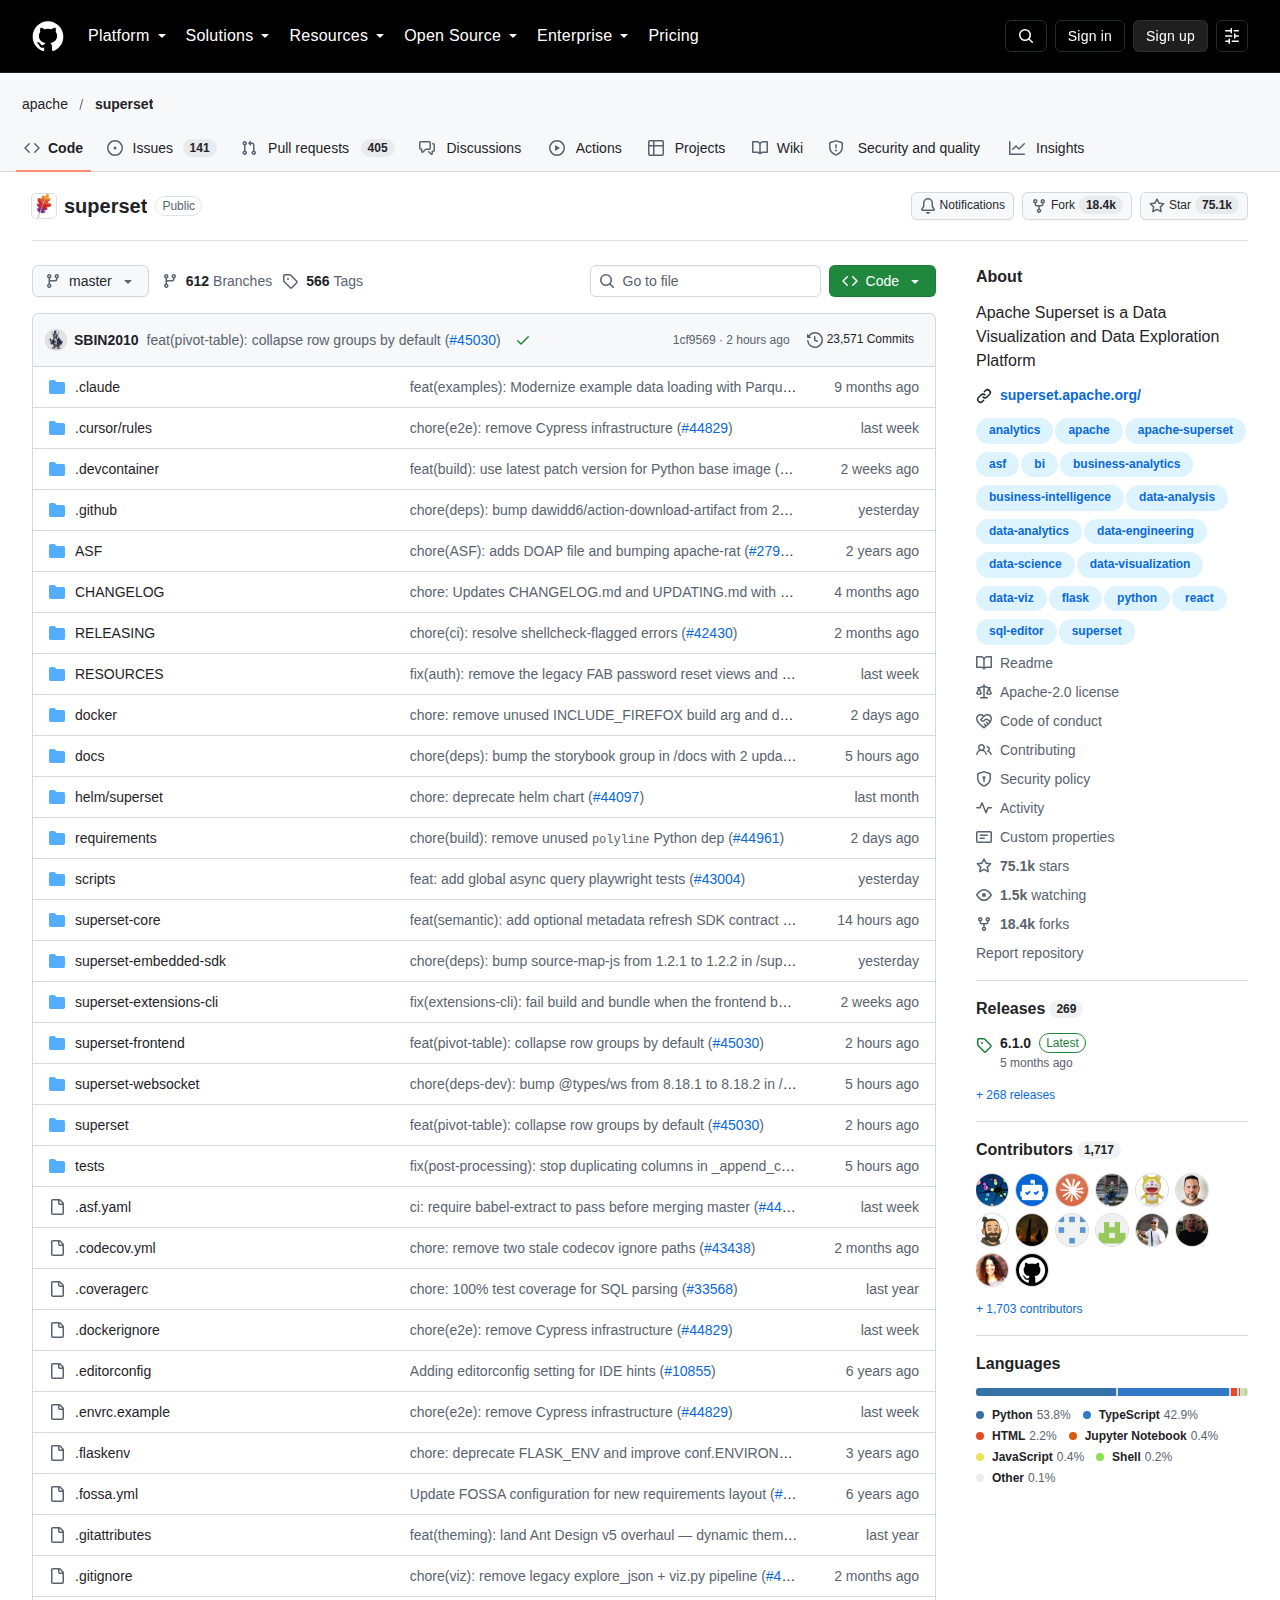
Apache Superset 是 GitHub 上累積 75,063 顆星標與 18,436 次 fork 的開源商業智慧與資料視覺化平台,以 Python 撰寫、採用 Apache-2.0 授權,由 Apache 軟體基金會維護,專案自 2015 年 7 月 21 日建立至今已超過十年。它的定位十分明確:讓分析人員與業務人員在同一個網頁介面上探索資料、建立圖表與組裝儀表板,而不必為每一張報表排隊等待工程資源。專案最新的正式版本為 6.1.0,於 2026 年 5 月 13 日發布。
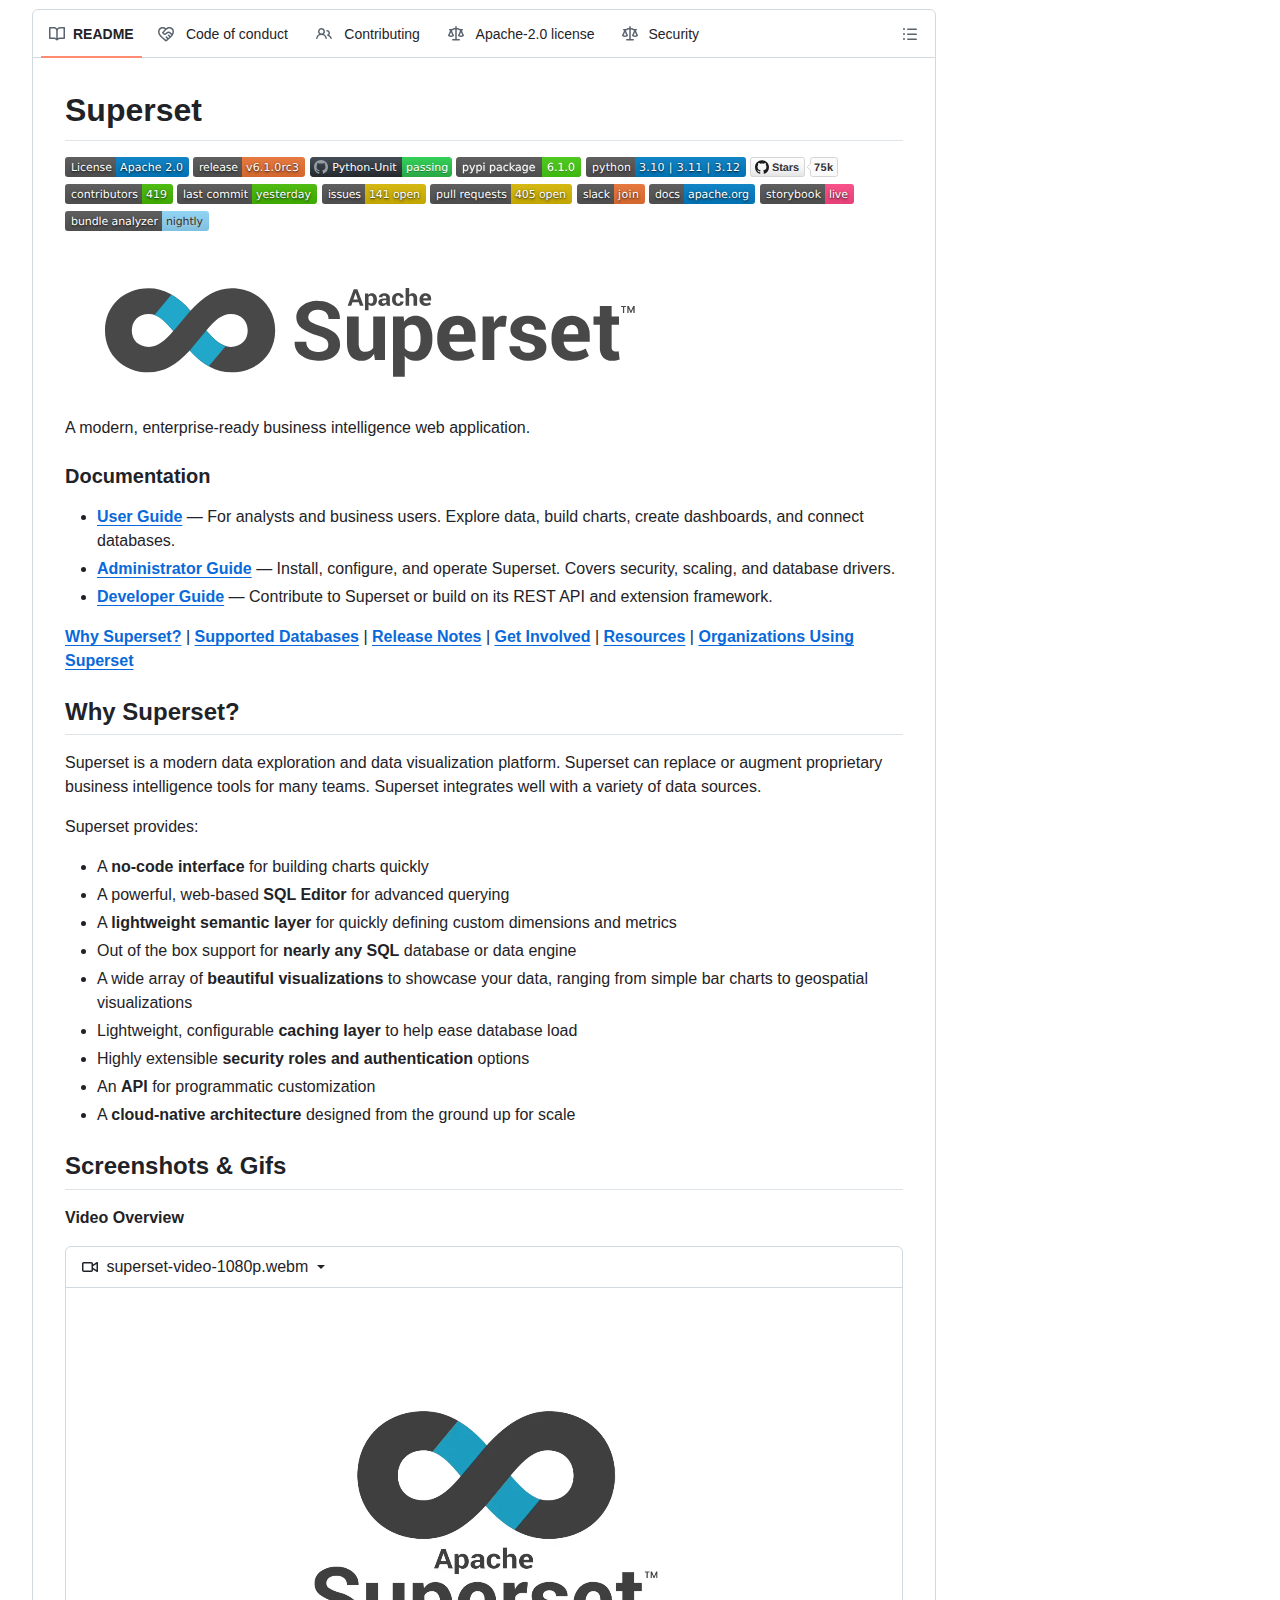
Apache Superset 是一套以 Python 撰寫的開源商業智慧平台,採 Apache-2.0 授權,提供免程式碼圖表建構器與網頁版 SQL 編輯器。
Apache Superset 是什麼?
它是用來探索資料與製作儀表板的網頁應用,具備免程式碼圖表介面、網頁版 SQL 編輯器、輕量語意層與快取層,可接入幾乎任何支援 SQL 的資料庫。
該項目的功能定位可以概括為:把資料庫裡的原始表格轉換成可被業務人員理解的視覺化成果。使用者不必撰寫前端程式碼,只要在介面上選擇資料集、拖拉維度與指標,就能產出長條圖、折線圖乃至地理空間圖層。對於需要深入查詢的情境,平台另提供網頁版 SQL 編輯器,讓具備 SQL 能力的分析人員直接在瀏覽器中執行查詢、檢視結果並將查詢保存為虛擬資料集。
在圖表之外,該項目也重視多使用者協作所需的治理能力。平台內建以角色為基礎的存取控制,可細分誰能檢視、編輯或發布特定儀表板,並支援多種身分驗證方式與可設定的安全角色。對於資料量龐大的組織,它提供輕量的快取層以降低資料庫負載,並可透過 API 進行程式化設定。這些能力使它同時適用於單一部門的內部報表,以及需要跨團隊共用指標的企業環境。
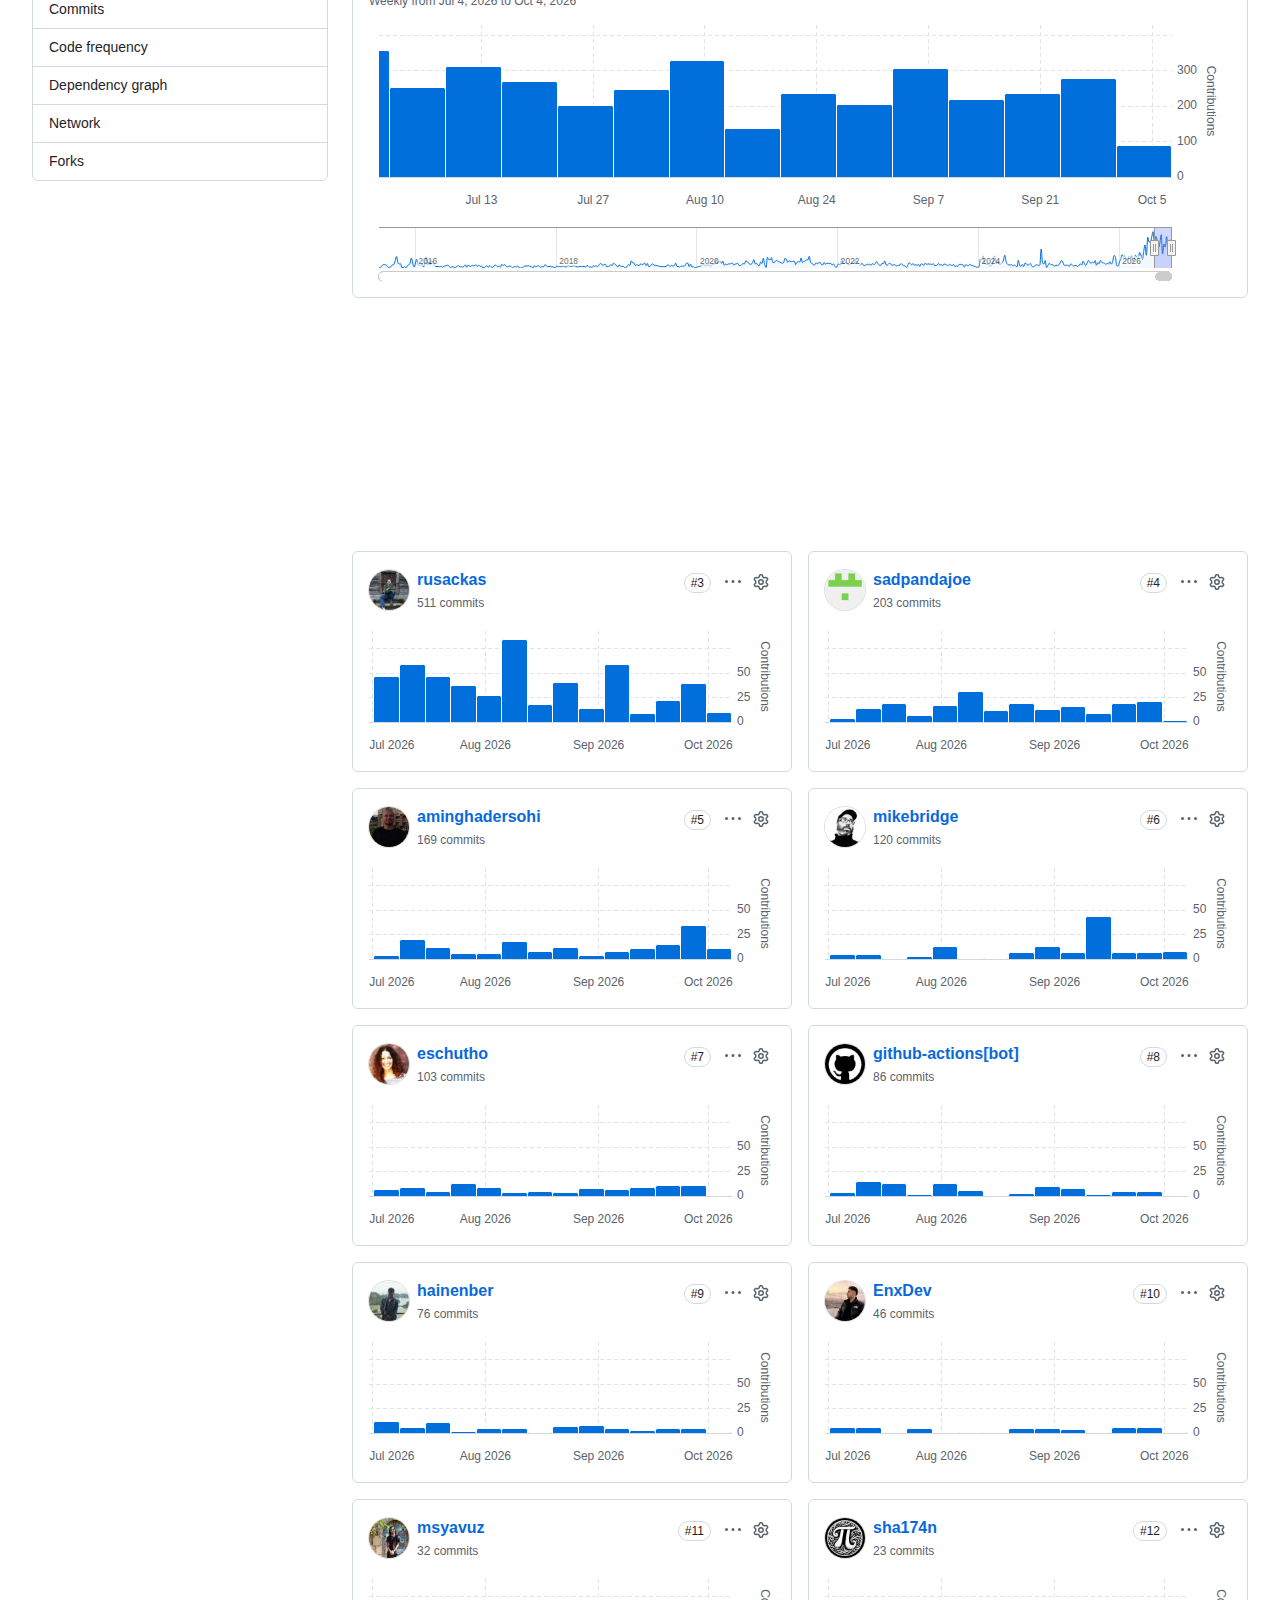
專案的成長軌跡反映其在生態中的位置。它源自 Airbnb 內部的資料探索工具,其後捐贈給 Apache 軟體基金會並成為頂級專案,累計提交數超過兩萬三千次,貢獻者總數接近一千八百名。官方另維護一份「In the Wild」名單,記錄各組織實際導入的案例,並透過社群論壇、Slack 頻道與改善提案機制協調後續發展。
Superset 的技術架構有什麼特點?
它採前後端分離與雲端原生設計,後端為 Python 服務並以 SQLAlchemy 銜接資料庫,前端為模組化元件,圖層可透過外掛擴充。
架構上,該項目把資料探索流程拆解成可獨立擴充的層級。最底層是資料庫連接層,透過 SQLAlchemy 方言與 Python 資料庫驅動與各種資料引擎溝通;其上是查詢與快取層,負責產生 SQL、執行查詢並暫存結果;再往上則是語意層與視覺化層,把查詢結果映射成圖表設定與儀表板版面。這種分層讓新增資料來源、替換視覺化元件與調整快取策略可以各自進行,而不必改動整體流程。
前端採用模組化設計,圖表類型以獨立外掛形式存在,因此社群可以自行開發並部署客製化的視覺化元件,而不必等待官方版本。官方也為這些元件維護 Storybook 展示站與 bundle 分析工具,方便貢獻者檢視元件行為與打包體積。整體架構在設計之初即以水平擴展為前提,可配合容器化與 Kubernetes 部署,對應不同規模的負載。
在資料建模上,該項目提供的不是完整的語意建模系統,而是一層輕量語意層。分析人員可以在資料集上定義自訂的維度與指標,把常用的計算邏輯封裝起來重複使用,藉此降低不同報表之間口徑不一致的風險。這種取捨讓平台維持較低的學習曲線,但對於需要嚴格一致定義的大型組織,仍建議搭配既有的資料倉儲或轉換工具一併規劃。
Superset 支援哪些資料來源與視覺化能力?
只要引擎具備 Python 驅動與 SQLAlchemy 方言即可接入,官方清單涵蓋 BigQuery、Snowflake、ClickHouse 等數十種資料庫。
資料來源面向的支援相當廣泛。官方的支援清單涵蓋 Amazon Athena、BigQuery、ClickHouse、Databricks、DuckDB、Elasticsearch、Greenplum、IBM Db2、MariaDB、Microsoft SQL Server、MongoDB、MySQL、Oracle、PostgreSQL、Presto、Snowflake、SQLite、StarRocks、Teradata、TimescaleDB、Trino 與 Vertica 等數十種資料引擎,並包含 Amazon Redshift 與 Azure Synapse 等雲端倉儲。核心條件是該引擎具備 Python DB-API 驅動與對應的 SQLAlchemy 方言。
這種設計讓平台能同時扮演「單一查詢入口」與「跨來源彙整層」。分析人員可以在同一個介面上連接多個資料庫,針對不同來源建立各自的圖表,再放到同一個儀表板中呈現。對於已採用資料湖或湖倉架構的團隊,這意味著不必先把所有資料搬進單一倉儲,就能先產出可用的視覺化成果。
視覺化能力方面,平台提供從基本長條圖、折線圖、圓餅圖到地理空間圖層、熱力圖與時間序列的多元圖表,並支援以 Apache ECharts 為基礎的元件。使用者可以透過拖放設定指標與維度,也可套用篩選器與互動式連動,讓檢視者在儀表板上自行切換關注的範圍。這種自助式設計,正是它被視為可替代或補強商業授權 BI 工具的主要原因。
如何開始使用 Apache Superset?
官方提供快速入門指南與多種生產部署架構,最快可透過 Docker Compose 在數分鐘內啟動,並可依需要安裝對應的資料庫驅動。
入門流程相對直接。官方文件提供快速入門指南,最快可透過 Docker Compose 在本機數分鐘內啟動完整環境,另有官方 Docker 映像與 Helm Chart 供正式部署使用。部署時需依實際連接的資料庫安裝對應驅動,官方文件針對各資料來源提供設定說明,並另有一份完整的支援清單供查閱。
在功能層面,官方將文件區分為使用者、管理員與開發者三種角色。使用者指南說明如何連接資料庫、建立圖表與組裝儀表板;管理員指南涵蓋安裝、安全設定、擴展與驅動管理;開發者指南則說明如何透過 REST API 擴充,或依規範開發新的視覺化外掛與資料庫連接器。這種分工讓不同職責的成員都能找到對應的起點。
以下為該專案的關鍵數據與授權資訊。
Superset 的統計數據與授權條件為何?
該專案累積 75,063 顆星標、18,436 次 fork 與 1,539 名關注者,以 Python 撰寫、採 Apache-2.0 授權,最新正式版本為 6.1.0。
該項目採用 Apache License 2.0,屬於寬鬆型授權,允許商業使用、修改與再散布,且不要求衍生作品以相同授權釋出。對於企業而言,這意味著可以在內部產品或對外服務中整合該平台,而不必公開自有程式碼或支付授權費用,這是它在商業部署場景中被廣泛採用的重要原因之一。專案同時遵循 Apache 基金會的商標與貢獻規範,並維護安全問題回報管道。
維護節奏方面,專案由 Apache 軟體基金會的提交者社群共同推進,累計提交數超過兩萬三千次,貢獻者總數接近一千八百名。儲存庫的更新時間顯示為 2026 年 10 月 7 日,開放的議題數量約五百多條,並持續維持活躍的合併請求與版本發布。除核心程式庫外,官方另發布 Helm Chart 供 Kubernetes 環境使用,近期版本發布時間集中在 2026 年下半年。
出處連結有哪些?
本文資訊整理自 apache/superset 的 GitHub 儲存庫與官方網站,包括專案說明、支援資料庫清單、安裝與部署指引。
- GitHub 儲存庫:https://github.com/apache/superset
- 官方網站:https://superset.apache.org/
- 使用者文件:https://superset.apache.org/user-docs/
- 管理員文件:https://superset.apache.org/admin-docs/
總結:Apache Superset 適合什麼團隊?
它適合需要自架報表平台、重視授權成本與資料自主的團隊;若組織缺乏維運人力或只需少量固定報表,託管式服務仍較省事。
該項目的價值在於把商業智慧工具的取得成本與資料流向控制權一併交還給使用組織。對已有資料倉儲或資料庫、需要讓業務與分析人員自行探索資料,或必須把資料留在內部網路的團隊而言,它提供了一條成熟且授權寬鬆的建置路徑,並可透過同一套介面在不同雲端與地端環境之間遷移。來自 Apache 基金會與近一千八百名貢獻者的長期投入,也讓它在資料來源與視覺化支援上保持穩定更新。
不過,自助式平台同時意味著治理責任。導入者需要自行規劃資料庫驅動安裝、身分驗證整合、角色權限設計與快取策略,並處理服務監控、擴縮容與版本升級。對於報表需求單純、缺乏維運人力的組織而言,直接採用託管式商業服務仍是更務實的選擇;該項目更適合定位為需要掌握成本與資料主權時的長期基礎設施。