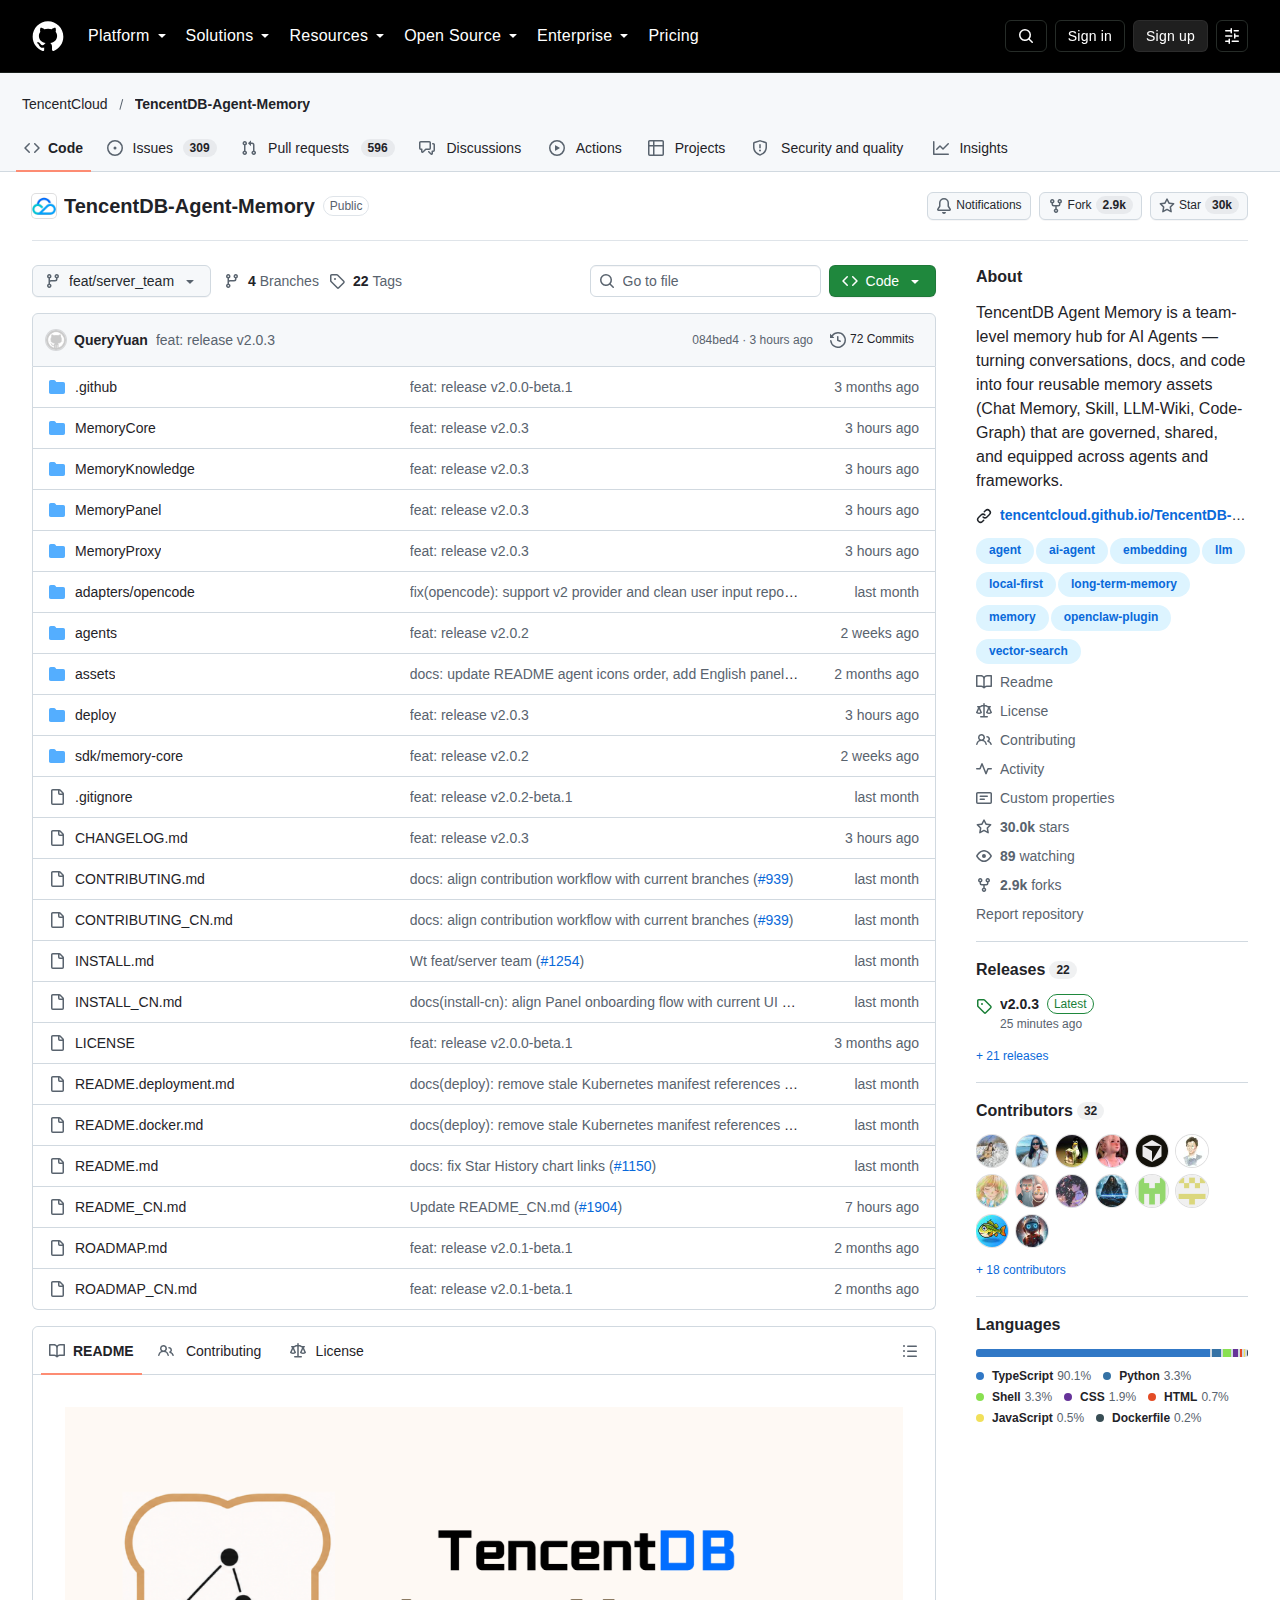
TencentDB Agent Memory 是騰訊雲開源的團隊級記憶中樞,把對話、文件與程式碼整理成可複用的記憶資產。專案於二零二六年四月建立,累積 29,972 顆星標與 2,911 個分支,採 MIT 授權,以 TypeScript 開發。十月二十六日發布的 v2.0.3 補上會話預設綁定與富文件匯入能力。
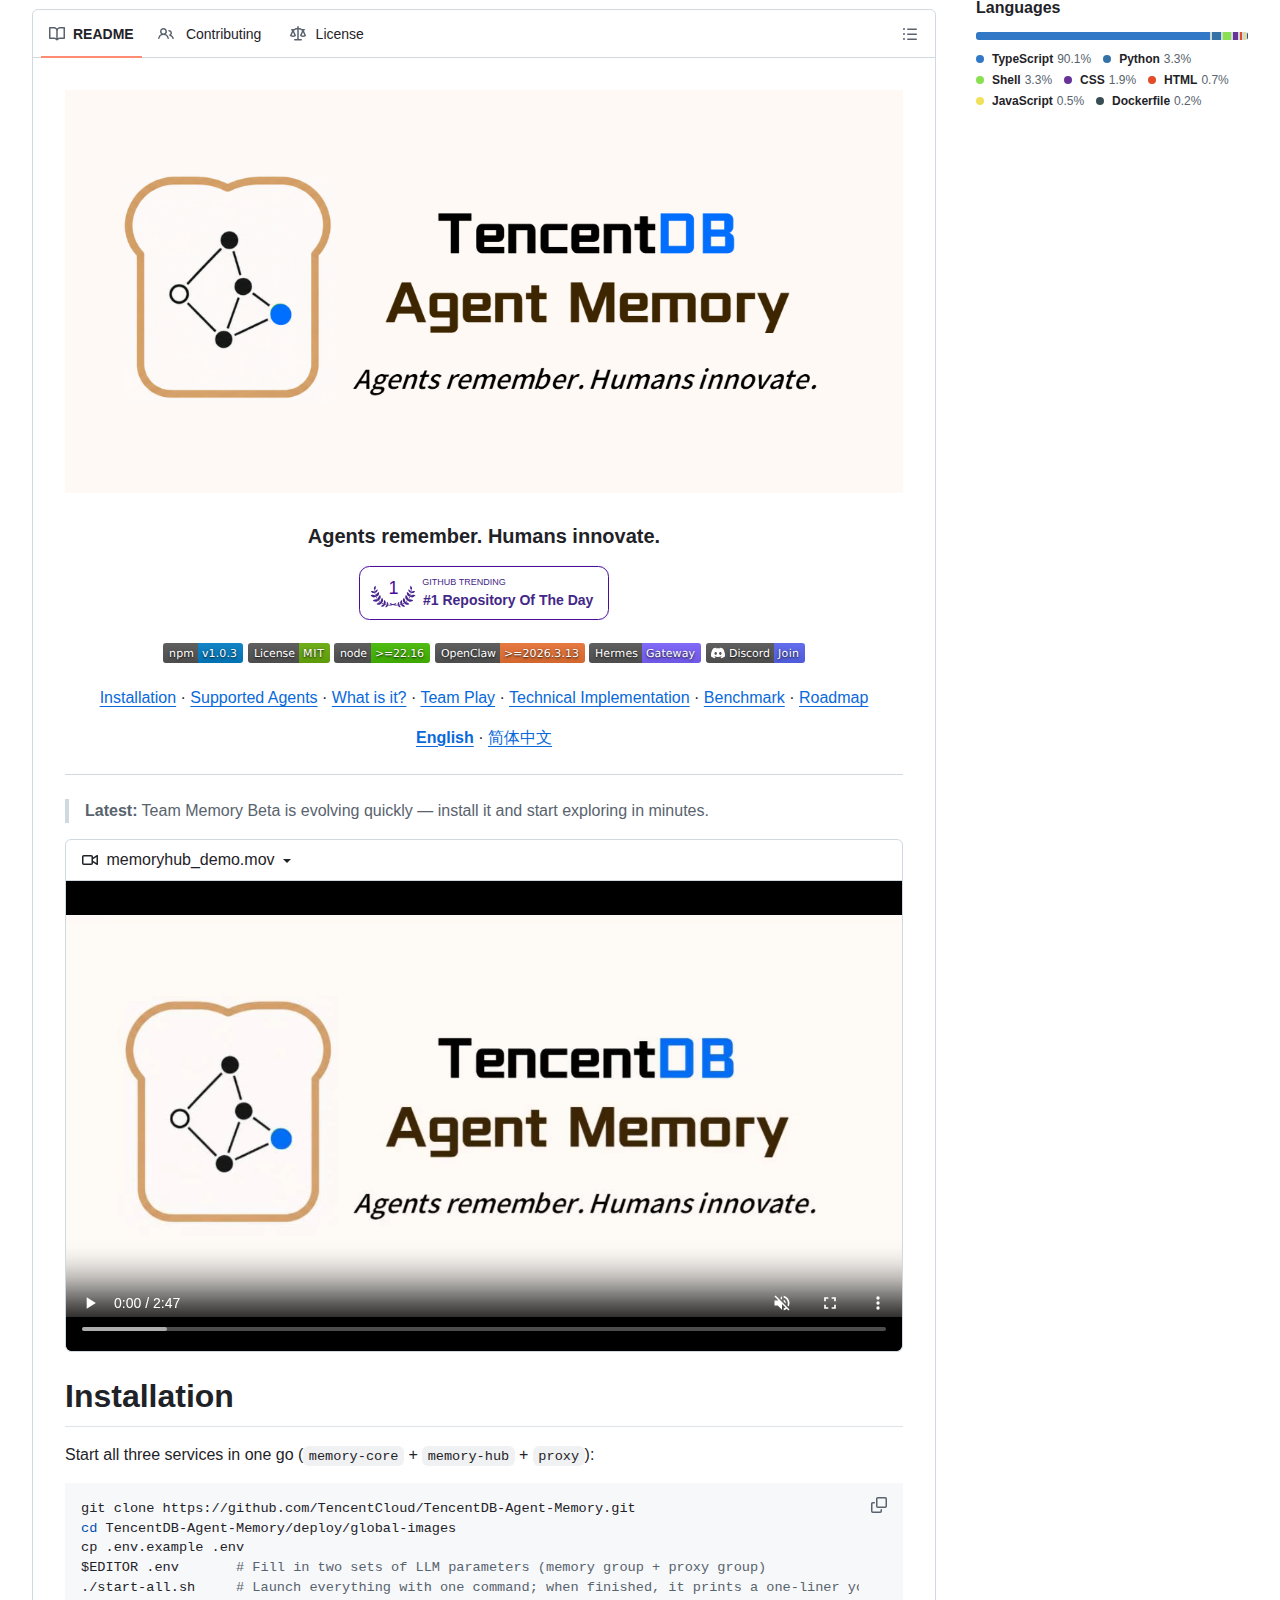
TencentDB Agent Memory 是什麼?
它是騰訊雲開源的團隊級記憶中樞,把對話、文件與程式碼轉成四類記憶資產,再以權限、版本與綁定機制分派給不同代理使用。
專案在 README 開頭先提出一個實務問題:使用代理時,如何減少重複勞動。專案團隊的觀察是,專案背景若已解釋過,就不該在新會話再解釋一次;文件若已讀過,每個代理不該從第一頁重來;已驗證可用的流程,也不該每次重新摸索。
這種定位與一般「記住對話」的記憶工具不同。專案把任何能讓下一個代理少走冤枉路的資訊,都視為應該保存、整理與複用的資產。這個定義放寬之後,文件與程式碼就自然被納入記憶範圍,而非只存在於檢索層。
專案由騰訊雲團隊主導,貢獻者三十人,設有 Discussions 與完整的路線圖。授權為 MIT,商業使用沒有障礙。倉庫同時提供英文與簡體中文文件,安裝指南另有中文版本,對華語團隊相對友善。
為何記憶要拆成四類資產?
因為對話、技能、文件與程式碼的更新頻率與使用方式各異。拆成四類之後,每類可獨立設版本、擁有者與可見範圍,代理按角色取用需要的部分。
第一類是對話記憶,負責保存偏好、事實、決策與互動歷史。第二類是技能,從完成的複雜任務中萃取,帶有版本、資源檔、觸發邊界、執行步驟與驗證規則,並非單純的提示片段。
第三類是文件 Wiki,把產品文件、設計規格與維運手冊整理成具連結圖的結構化頁面。第四類是程式碼圖譜,索引檔案、符號、呼叫關係與影響路徑,讓代理在修改前先確認影響範圍。
四類共用同一套治理欄位:擁有者、版本、狀態、可見性、使用次數與代理綁定。這個設計讓記憶從「一堆向量」變成可盤點的資產,也讓團隊能回答誰在用、哪個版本有效、應該發給哪個代理。
L0 到 L3 的記憶分層如何運作?
對話先以 L0 原文保存,再由非同步流程逐層提煉為 L1 事實、L2 情境與 L3 人物側寫。檢索時高層負責快速進入狀況,需要精確事實才回退低層。
分層的實際價值在於控制上下文用量。多數記憶系統把檢索結果直接塞進提示,條目一多就擠掉真正的工作內容。此專案把生成與檢索都分層,日常以 L2 與 L3 建立背景,需要具體細節時才以關鍵字檢索、向量檢索與倒數排名融合回退至 L1 與 L0。
回退結果另有三重上限:條目數、字元預算與逾時限制。這三項是工程上的必要防護,因為記憶系統最常見的失敗模式並非查不到,而是查到太多。
L1 的提煉由非同步流程完成,因此剛結束的對話不會即時出現在高層記憶。這個延遲在設計上可接受,但對需要即時延續情境的場景,仍要依賴 L0 原文。
v2.0.3 更新了哪些重點?
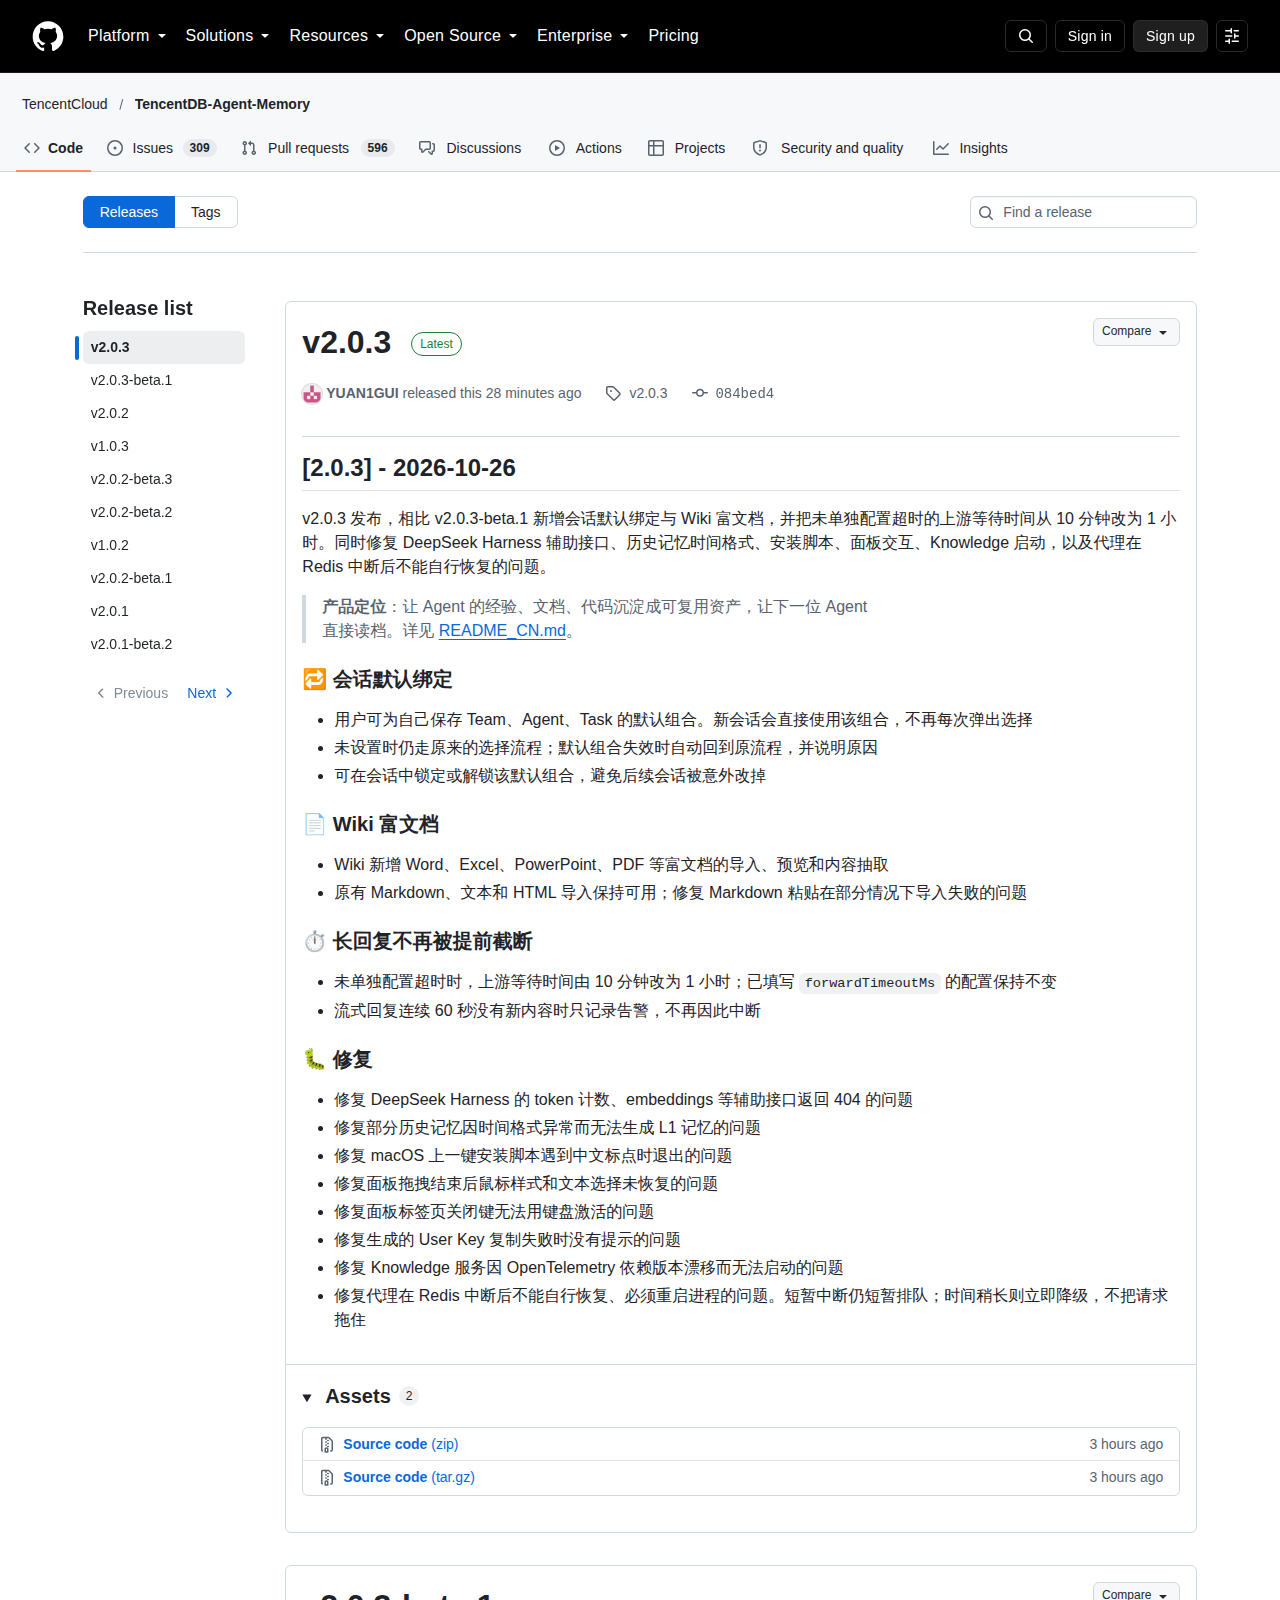
v2.0.3 新增會話預設綁定與 Wiki 富文件匯入,把未設定逾時的上游等待由十分鐘延長至一小時,並修復多項介面與安裝問題。
會話預設綁定解決的是重複選擇的摩擦。使用者可為自己保存團隊、代理與任務的固定組合,新會話直接套用,不必每次彈出選單;組合失效時自動回到原流程並說明原因。會話中亦可鎖定或解鎖,避免後續被意外改動。
Wiki 支援 Word、Excel、PowerPoint 與 PDF 的匯入、預覽與內容抽取,原有的 Markdown、純文字與 HTML 流程維持可用。這對企業場景意義明顯,因為多數規格文件與維運手冊仍以辦公格式流通。
長回覆截斷問題同時處理。未單獨設定逾時時,上游等待時間由十分鐘改為一小時;串流回覆連續六十秒沒有新內容只記錄告警,不再中斷連線。修復清單另包括 DeepSeek Harness 的 token 計數與向量化輔助介面、歷史記憶時間格式導致的 L1 生成失敗、macOS 安裝腳本遇中文標點退出,以及面板的拖拽樣式與鍵盤可達性。
PersonaMem 基準的升幅代表什麼?
PersonaMem 測試代理在長期互動後能否正確理解並套用使用者資訊。此專案由 48% 提升至 76%,相對改善 59%,屬記憶層的實質增益。
這項基準的設計貼近真實痛點。多數代理在單輪任務表現良好,一旦跨越數十輪對話,就開始遺漏先前的限制條件與偏好。PersonaMem 正是量度這種長期一致性。
由 48% 升至 76% 意味著錯誤率從五成以上降到約四分之一。對需要長期協作的場景,這個差距直接影響使用者是否願意持續委派任務。
需要留意的是單一基準的解釋力有限。專案目前只公布 PersonaMem 一項數據,尚未提供長上下文檢索、多代理協作或跨框架遷移的對照結果。這些缺口在評估時應一併考慮。
團隊權限與資產治理如何設計?
資產分為私有、團隊、受限與代理四種可見性。私有僅擁有者可見,受限以使用者、角色與代理層級控管,並設系統管理員與團隊角色兩層權限。
預設值選擇值得肯定。新建的對話記憶與技能預設為私有,分享是明確動作而非預設外洩,這一點在企業導入時常被忽略。
權限分兩層:全域系統管理員負責使用者與團隊,並可使用 Wiki、程式碼圖譜與技能等管理功能;團隊層則分管理員與成員,處理團隊內的協作與存取控制。資產擁有者自動取得該資產的管理權限。
綁定機制是治理的落點。團隊先以團隊、使用者、代理與可見性縮小範圍,再依當前查詢檢索。這讓不同角色拿到不同裝備,研究代理取得訪談記憶與市場 Wiki,審查代理取得事故記憶與發布檢查清單。
與現有 RAG 方案有何分別?
檢索增強只回答找得到什麼。此專案額外處理誰能用、哪個版本有效、應發給哪個代理,把記憶從查詢結果升級為可治理資產。
差異可以用一張對照表說明。專案在 README 中以聊天歷史、標準檢索增強與自身方案三者並列,逐項標示能力覆蓋程度。
| 能力 | 聊天歷史 | 標準 RAG | TencentDB Agent Memory |
|---|---|---|---|
| 跨會話的使用者理解 | 部分 | 部分 | 對話記憶 |
| 可執行的經驗萃取 | 無 | 無 | 技能 |
| 文件結構與關聯 | 無 | 分塊檢索 | Wiki 與連結圖 |
| 程式碼呼叫圖與影響範圍 | 無 | 文字比對 | 程式碼圖譜 |
| 擁有者、版本與狀態 | 無 | 無 | 完整支援 |
| 團隊分享與代理裝備 | 無 | 無 | 完整支援 |
表格反映的是設計取向,而非效能排名。若團隊只需要在單一專案內檢索文件,標準檢索增強仍是最省成本的選擇;當代理數量增加、需要跨框架共用經驗時,治理層的價值才顯現。
安裝與整合需要什麼條件?
需要 Node 22.16 以上版本與兩組模型參數。三個服務可以一鍵啟動,完成後面板位於本機 8125 埠,代理只需把基底網址指向代理層。
部署流程集中在一個目錄。複製環境範例檔、填入記憶群組與代理群組兩組模型參數,執行啟動腳本即可拉起記憶核心、記憶中樞與代理層三個服務,腳本結束時會輸出一行可直接貼入 Claude 的設定。
整合方式是其設計重點。代理端不需要外掛、鉤子或 MCP 伺服器,只要把基底網址指向代理層,協定維持不變。這降低了既有流程的改造成本,也讓同一套記憶能同時服務多個框架。
官方文件點名支援 DeepSeek Harness、Claude Code、Codex、CodeBuddy、WorkBuddy、Hermes 與 OpenClaw,其餘框架另有通用整合指引。儲存後端以內建方案為主,MongoDB 支援仍屬實驗性質,預設關閉。
出處連結有哪些?
主要來源為 GitHub 的 TencentDB-Agent-Memory 倉庫,版本細節取自 v2.0.3 發布說明,功能描述引用官方 README 與安裝文件。
倉庫網址為 https://github.com/TencentCloud/TencentDB-Agent-Memory,README 載明四類資產定義、分層架構、權限模型、基準數據與各框架的整合方式。安裝指南另有獨立文件,涵蓋單獨部署記憶中樞、代理層與客戶端搭配、停止與清理、埠號對照等細節。
基準數據取自 README 的 Benchmark 段落,僅列出 PersonaMem 一項。專案在致謝段落說明部分模組沿用社群專案:程式碼圖譜使用 codegraph 的設計,技能管理部分使用 Hermes Agent 的程式碼,Wiki 層則受 Karpathy 的 LLM Wiki 構想影響。
總結:TencentDB Agent Memory 適合什麼團隊?
適合已同時使用多個代理框架、需要共用經驗與權限隔離的團隊。若只是單人短期使用,直接開啟會話歷史的成本更低,未必需要完整的治理層。
此專案處理的是代理協作的組織問題。當團隊從一個代理擴展到數個角色,重複解釋背景與重建情境的成本會快速累積。把經驗沉澱為可綁定的資產,等於為團隊建立一份可繼承的存檔。
限制同樣清楚。文件與程式碼的索引為非同步建立,需要等待處理完成;程式碼圖譜目前以公開 HTTPS 倉庫為主,私有倉庫與 SSH 憑證仍在完善;資產綁定以手動為主,自動路由尚未成熟。這些在文件中如實列出,採用者需要自行評估過渡期的操作負擔。
對正在評估代理架構的團隊,較務實的做法是先以一組代理與一個專案倉庫試行,觀察記憶資產的實際命中率與維護成本,再決定是否擴展到整個團隊。治理層的價值通常在代理數量增加之後才會顯現,過早導入反而增加設定負擔。
