Google 在 2026 年 4 月把 TorchTPU 開源,這是一套以 PyTorch PrivateUse1 介面實作的 TPU 原生後端。開發者只要把初始化裝置改成 tpu,既有訓練腳本即可在張量處理器上執行,不需要改寫核心邏輯。專案在 10 月登上 Hacker News 首頁並累積 351 分,GitHub 儲存庫現有 493 顆星標、25 個分支與約 4,470 次提交。技術重點包括三種 Eager 執行模式、可跨主機共享的編譯快取,以及從 Torch Dynamo 到 XLA 的完整編譯路徑。
TorchTPU 是什麼?
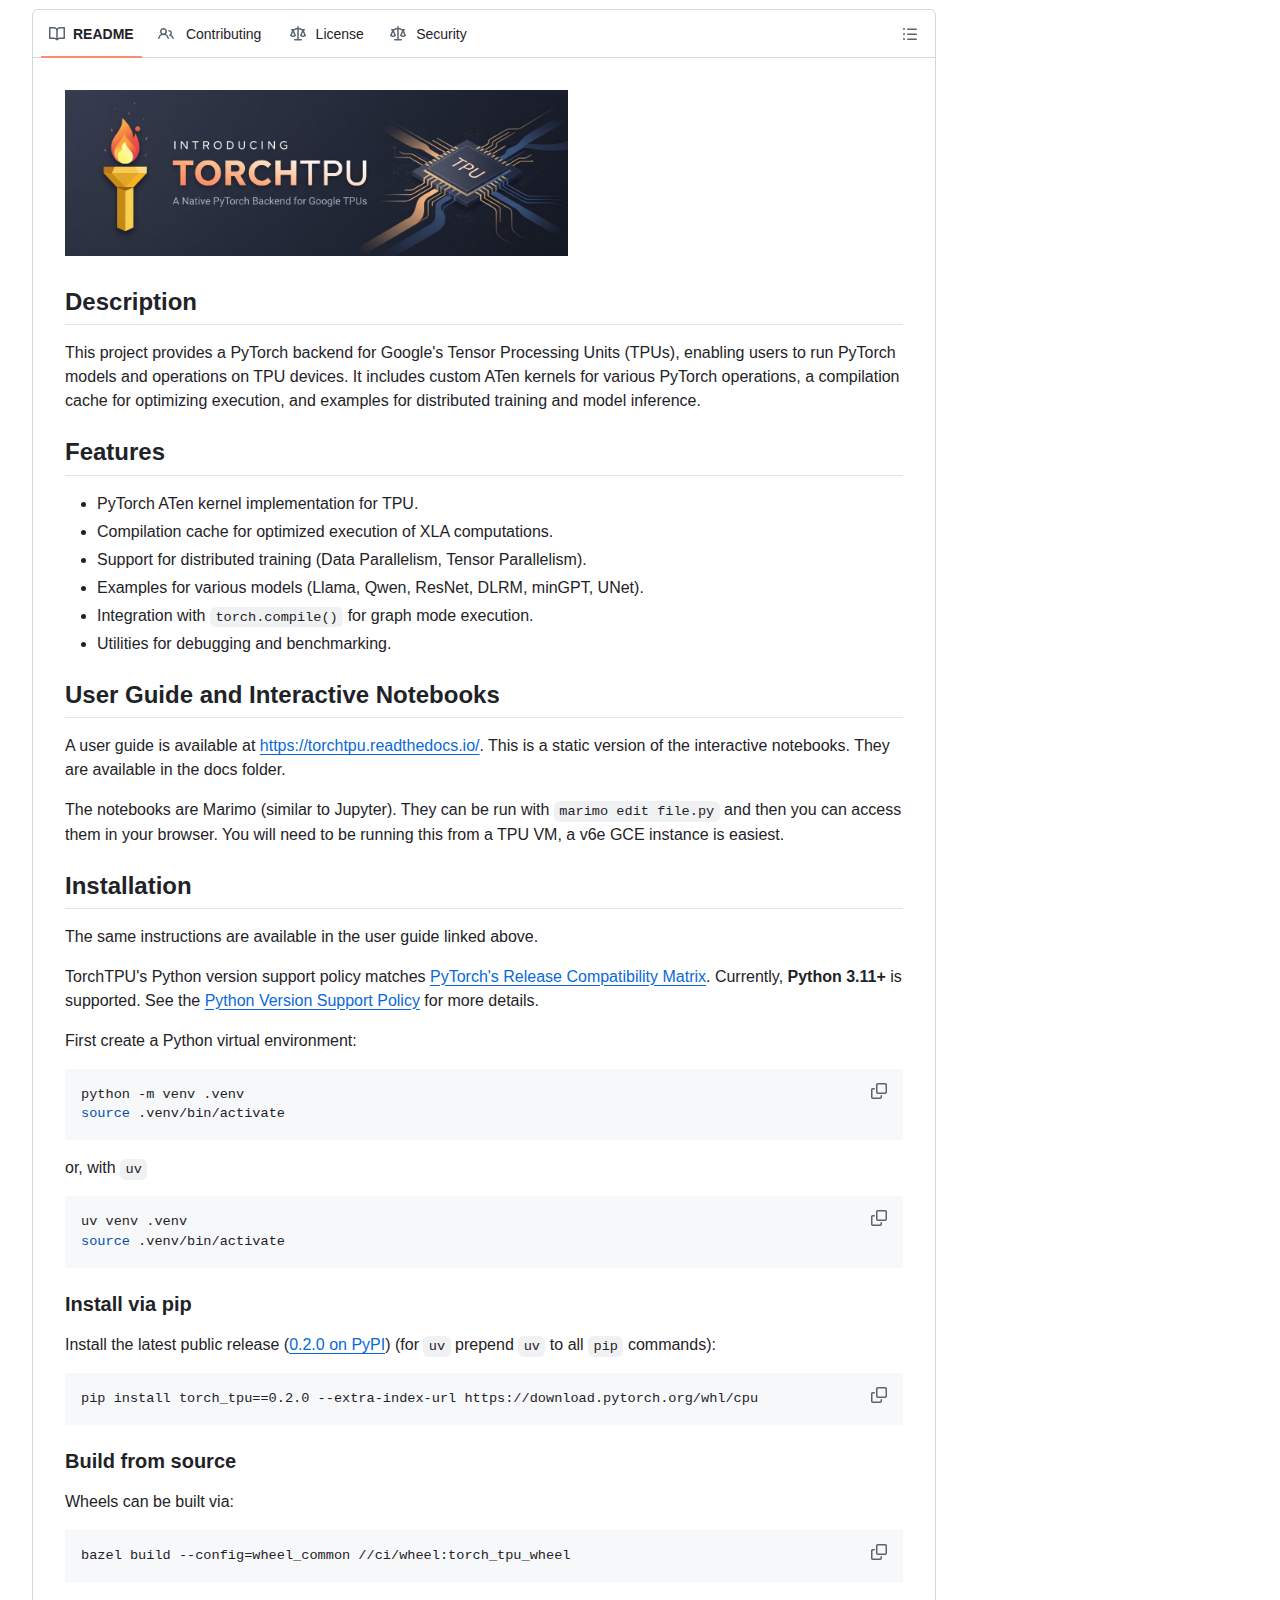
TorchTPU 是 Google 為 TPU 開發的 PyTorch 原生後端,以 PrivateUse1 介面接入,既有程式改裝置名稱即可訓練與推論。
這個專案的目標寫在官方部落格的開場:PyTorch 在 TPU 上應該「感覺就像 PyTorch」。具體作法是接管裝置註冊層,不使用子類別封裝,也不額外套一層轉接介面,開發者拿到的張量就是一般的 PyTorch 張量,只是實際運算落在 TPU 的 TensorCore 與 SparseCore 上。
儲存庫建立在 Google 既有的 PyTorch 生態投入之上。專案以 Bazel 管理相依,語言組成以 C++ 約 897 萬位元組與 Python 約 810 萬位元組為主,另有 Starlark 建置腳本約 135 萬位元組。Python 版本要求 3.11 以上,與 PyTorch 官方的版本支援矩陣對齊。
套件已發布至 PyPI,目前版本為 0.2.0,可直接以 pip 安裝。文件站 torchtpu.readthedocs.io 提供使用者指南與 Marimo 互動筆記本,範例涵蓋 Llama、Qwen、ResNet、DLRM、minGPT 與 UNet,涵蓋語言模型、推薦系統與影像模型三條主線。
TorchTPU 與 PyTorch/XLA 有什麼差別?
前代 PyTorch/XLA 只支援 SPMD,各 rank 必須執行相同程式碼;TorchTPU 加入 MPMD,允許差異並隔離通訊以維持正確。
舊架構的限制在實務上相當具體。XLA 以全域視角最佳化分散式程式,當 rank 0 需要額外記錄日誌或輸出分析數據時,這種不對稱行為會破壞編譯假設,開發者只能自己想辦法移除分支。TorchTPU 選擇在架構層處理,把發散執行隔離到必要範圍,代價降到最低。
這項差異對研究型工作負載尤其明顯。多階段訓練、條件式評估與除錯輸出,經常讓不同 rank 走上不同路徑,若工具鏈要求完全對稱,團隊往往得改寫訓練邏輯來遷就編譯器。原生支援 MPMD 意味著這類改寫可以省下。
另一個差別在裝置語意。TorchTPU 直接註冊為 PyTorch 的原生裝置,而非以 XLA 張量包裝既有張量,因此在 torch.compile、自動混合精度與分散式 API 上的行為,較容易與 GPU 版本保持一致。
三種 Eager 模式如何運作?
TorchTPU 有三種 Eager 模式:Debug 逐項同步便於除錯,Strict 非同步派遣,Fused 在執行期融合運算,官方稱快 50% 以上。
三種模式對應開發生命週期的不同階段。Debug Eager 每次運算後與 CPU 同步,速度最慢,但能精確定位形狀不匹配、NaN 值與記憶體溢出,適合首次移植模型時使用。Strict Eager 維持單一運算派遣,改為非同步執行,讓 CPU 與 TPU 同時工作,直到腳本遇到同步點。
Fused Eager 是整個堆疊的關鍵設計。它對運算流做自動反射,在執行期把連續步驟融合成較大、計算密度較高的區塊,再交給 TPU 執行,藉此提高 TensorCore 使用率並降低記憶體頻寬開銷。這個過程不需要開發者設定,官方量測的加速幅度為嚴格模式的 1.5 倍至 2 倍以上。
三種模式共用同一套編譯快取。快取可運作於單一主機,也可設定為多主機持續保存,讓同一工作負載在第二次執行時減少重複編譯。對於反覆調參與長時間訓練的場景,這項設計直接影響迭代速度。
torch.compile 在 TPU 上如何運作?
TorchTPU 以 Dynamo 擷取 FX 圖,跳過 Inductor,改由 XLA 編譯,並把 PyTorch 運算子映射至 StableHLO 產生 TPU 二進位。
跳過 Inductor 是刻意的架構選擇。XLA 長期針對 TPU 拓撲調校,理解稠密運算與集合通訊在晶片間互連上的重疊方式,這是通用後端難以複製的知識。透過 StableHLO 作為中介表示,PyTorch 的運算能直接進入 XLA 的核心下放流程,同時沿用 Eager 模式已建立的執行路徑。
自訂核心的擴充路徑也已打通。開發者可用 Pallas 或 JAX 撰寫低階硬體指令,透過 @torch_tpu.pallas.custom_jax_kernel 裝飾器接入下放流程,讓特殊運算在不犧牲整體編譯最佳化的前提下運作。官方表示 Helion 核心的支援仍在進行中。
這條路徑的意義在於避免兩套堆疊各自演化。過去在 TPU 上追求極致效能,往往需要脫離 PyTorch 生態改用 JAX,現在同一個模型可以在熟悉的框架內取得接近硬體極限的表現,維運成本因此下降。
分散式訓練支援哪些模式?
TorchTPU 開箱支援 DDP、FSDPv2 與 DTensor,既有分散式函式庫多可直接沿用,並以 MPMD 處理各 rank 差異。
官方說明指出,許多建立在 PyTorch 分散式 API 上的第三方函式庫,無需修改即可在 TorchTPU 上運作。這種相容性來自 API 層的對齊,而非逐一移植,對於已經投資在既有訓練框架的團隊,遷移成本因此可控。
TPU 的硬體結構也影響了分散式設計。單一主機連接多顆晶片,晶片之間透過 Inter-Chip Interconnect 組成二維或三維環面拓撲,形成大規模擴展而不經過傳統網路瓶頸。TorchTPU 在這個基礎上處理通訊與運算的重疊,讓集合通訊盡量藏在計算之後。
快取機制在分散式場景更為關鍵。多主機共享的持續性編譯快取,能避免每個節點重複付出編譯成本,對於動輒數百顆晶片的訓練任務,這段落差會直接反映在啟動時間上。
TPU 硬體特性如何影響模型設計?
TPU 矩陣乘法在維度 128 或 256 時效率最高,模型卻常沿用 GPU 慣例設為 64;調整維度可提升實際吞吐量。
官方文件用一個具體例子說明這件事:模型經常把注意力頭維度硬編碼為 64,現世代 TPU 的 TensorCore 卻在 128 或 256 維度達到峰值效率。調整維度能更充分利用晶片上大而稠密的運算單元,差別不在模型的正確性,而在實際吞吐量。
可攜性並不消除硬體現實,這是官方明確的立場。TorchTPU 因此採取分層工作流:先讓模型正確執行,再依即將發布的深度指引辨識次佳架構,必要時改寫結構或注入自訂核心。這種順序避免了移植初期同時處理正確性與效能兩個變數。
對於以 GPU 為主要開發環境的團隊,這代表移植並非單純換裝置字串。模型超參數與平行化策略值得重新檢視,特別是序列長度、批次大小與注意力切分方式,這些選擇在環面拓撲上的成本結構與 GPU 叢集並不相同。
如何安裝與開始使用 TorchTPU?
建立 Python 3.11 以上虛擬環境,執行 pip install torch_tpu==0.2.0 並指定 PyTorch CPU 索引;實際執行需 TPU 環境。
安裝指令的重點在於索引來源。官方要求加上 --extra-index-url https://download.pytorch.org/whl/cpu,否則 pip 會安裝 CUDA 版本的 PyTorch,與 TPU 後端並不相容。使用 uv 的環境可在指令前加上 uv,其餘步驟相同。
從原始碼建置的情境較複雜。建置必須帶 --config=wheel_common,否則每個版本會各自攜帶一份後端,載入時因靜態註冊重複而中止。沒有遠端建置憑證的環境需追加 --config=no_rbe,且該參數必須放在 wheel_common 之後,因為後者才會覆蓋遠端快取設定。
實際執行需要有 TPU 的環境。官方建議使用 v6e 的 GCE 執行個體,Marimo 筆記本可在該環境以 marimo edit 啟動。若只是評估 API 與程式碼結構,閱讀文件站的靜態版本已足夠,無需先配置硬體。
TorchTPU 的主要數據有哪些?
儲存庫有 493 顆星標、25 個分支、272 個未結議題與約 4,470 次提交,主要語言為 C++ 與 Python,版本 0.2.0。
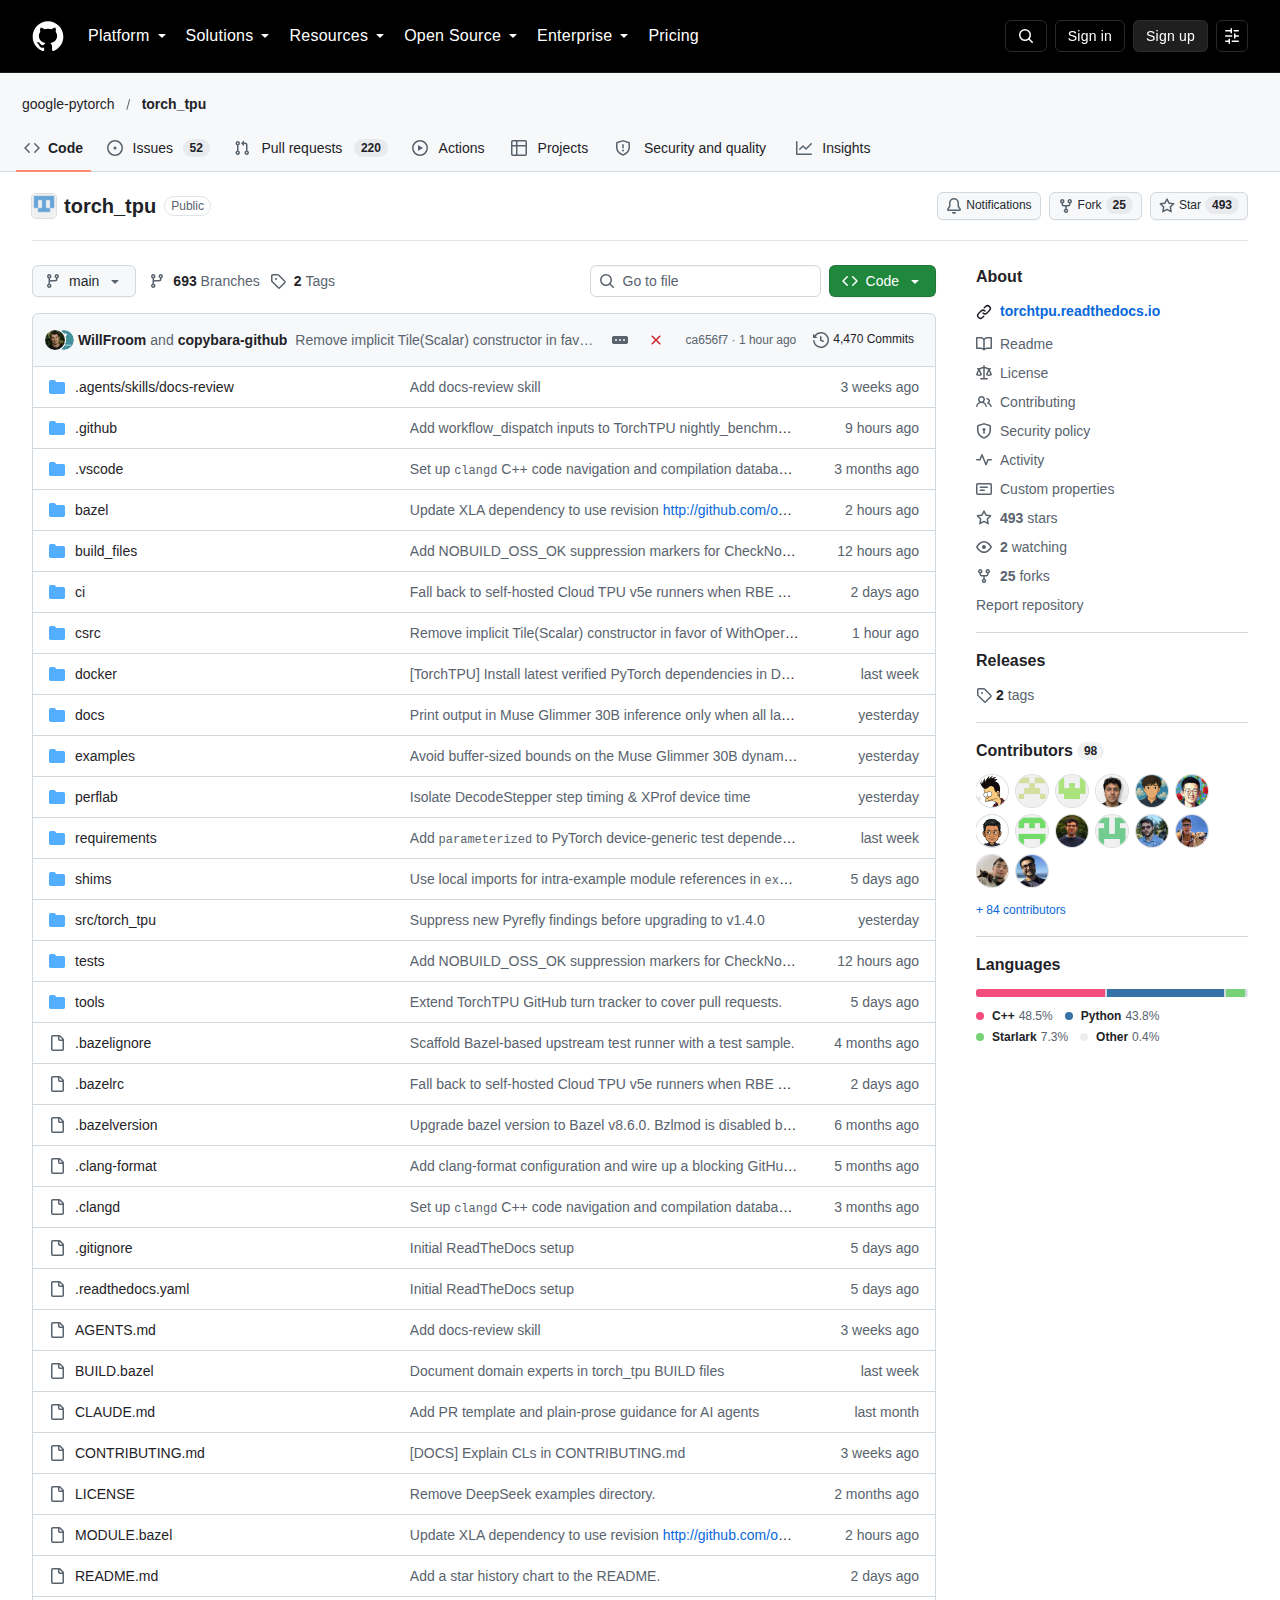
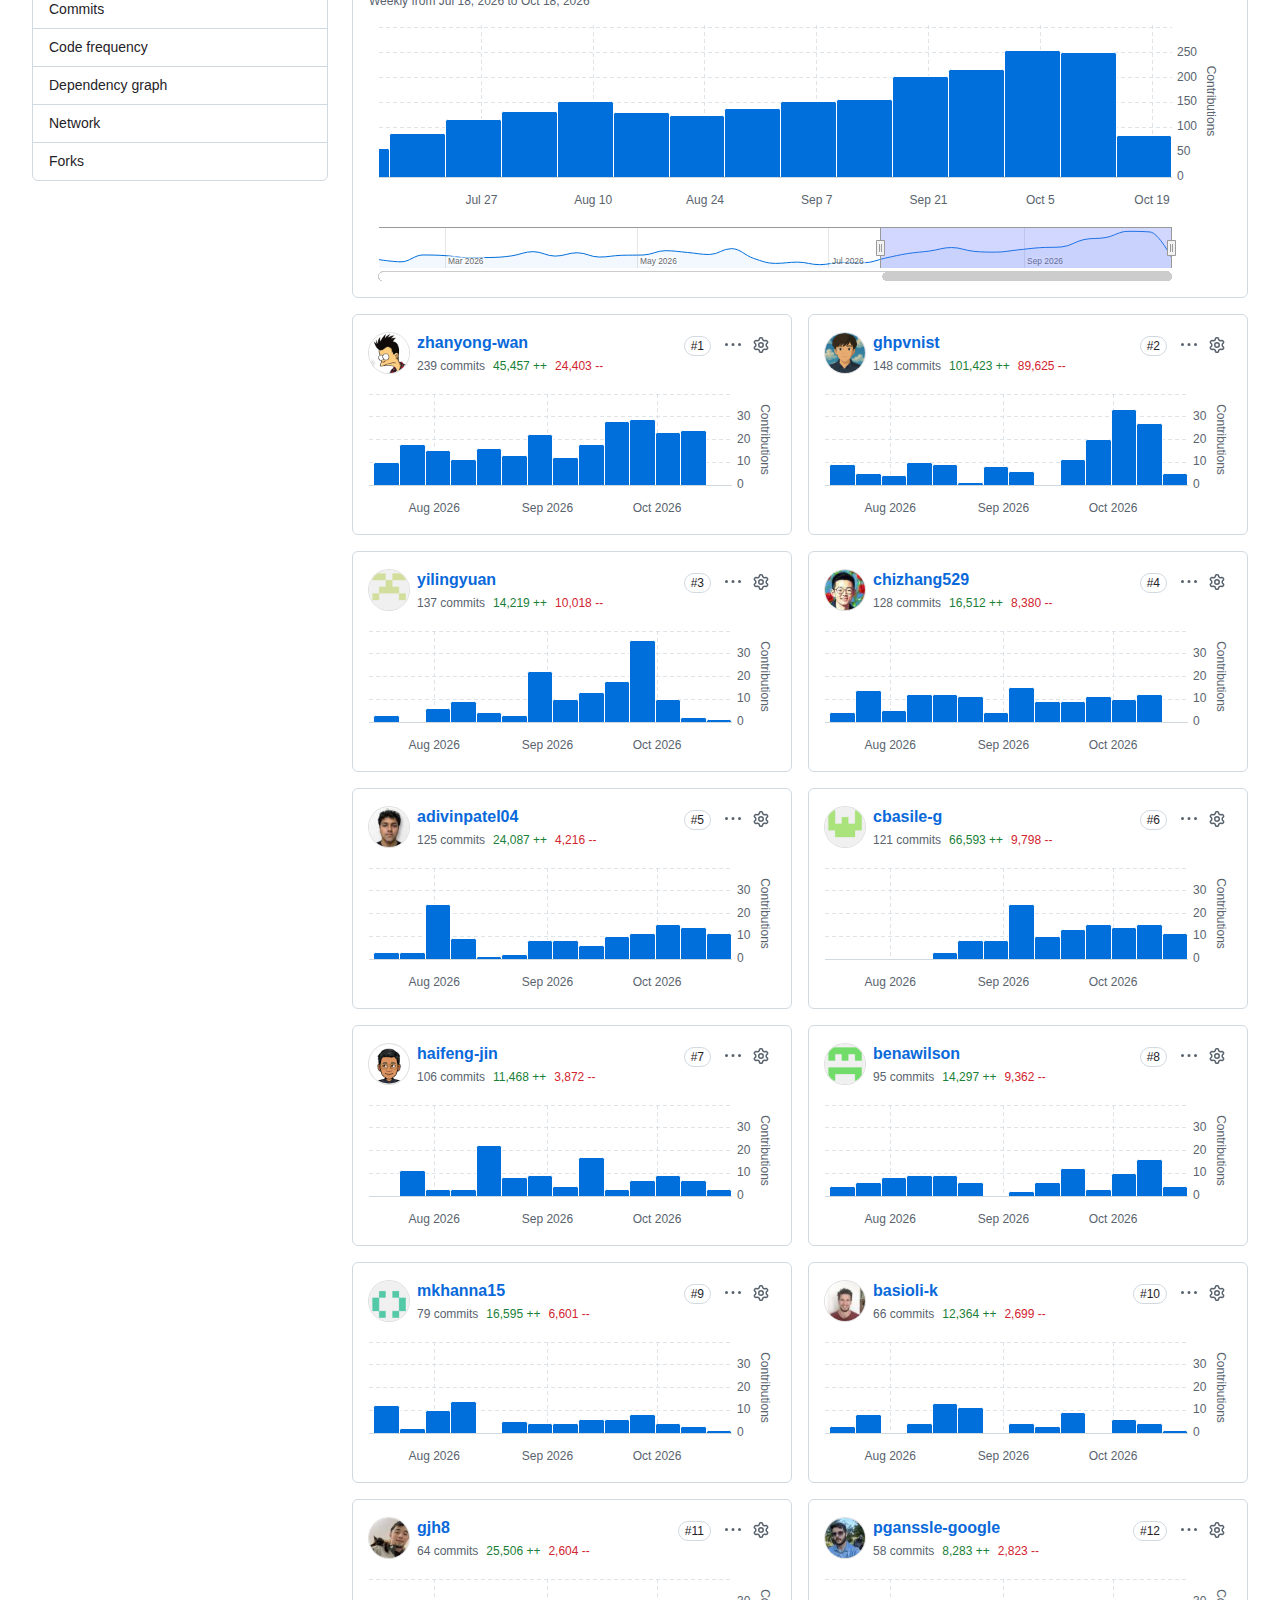
專案建立於 2026 年 3 月 9 日,最新提交發生在 10 月 21 日,開發節奏維持每日多次更新。約 4,470 次提交分布在七個月內,平均每月超過六百次,對於一個由單一機構主導的硬體後端而言,這個密度說明內部已有實際工作負載在驗證。
星標數與議題數的比例值得留意。493 顆星標對上 272 個未結議題,顯示關注度仍在早期,但已有相當比例的使用者實際下載並回報問題。授權欄位標示為 Other 而非標準 SPDX 識別碼,企業採用前應由法務確認條款範圍。
2026 下半年有哪些發展路線?
官方列出六項:降低動態形狀重編譯、預編譯核心庫、Helion 整合、動態形狀支援、多佇列,以及 vLLM 與 TorchTitan 整合。
重新編譯是首要問題。動態序列長度與批次大小會觸發 XLA 重複編譯,官方計畫在 XLA 內實作有界動態性,讓形狀變化不必付出編譯成本,這對逐 token 生成的推論工作負載影響最大。
預編譯核心庫針對首次執行的延遲。把標準運算預先編譯,可大幅縮短第一個迭代的等待時間,對於需要快速啟動的推論服務與短任務訓練特別有用。
生態整合則決定長期採用意願。vLLM 是當前主流推論伺服框架,TorchTitan 是 PyTorch 官方的大規模訓練參考實作,兩者完成整合後,多數團隊可以在既有工具鏈內使用 TPU,不必另行維護分叉版本。官方同時提到驗證至完整 Pod 規模的線性擴展。
哪些團隊適合評估 TorchTPU?
既有 TPU 使用者與面臨 GPU 供應壓力的訓練團隊最適合評估;若以小型實驗為主,或需要成熟穩定的硬體後端,現階段宜暫緩。
第一類是既有 TPU 使用者。過去這批團隊若以 PyTorch 為主要框架,往往得在 PyTorch/XLA 的限制下調整程式,或改寫成 JAX。原生後端減少了這層摩擦,也讓同一份程式碼能在 TPU 與 GPU 之間切換,降低對單一硬體的依賴。
第二類是面臨供應與成本壓力的訓練團隊。當 GPU 叢集的取得週期與價格波動成為專案風險,多一條硬體路徑本身就是保險。TorchTPU 的價值不在於立刻取代 GPU,而在於讓轉換成本從「重寫訓練堆疊」降到「調整設定與部分超參數」。
需要謹慎的情況同樣清楚。專案仍在 0.2.0 版本,272 個未結議題與每日多次提交意味著介面可能變動;授權條款非標準 SPDX 格式,商業採用需先確認;繁體中文資源幾乎不存在,文件與社群討論以英文為主。較穩妥的做法是先以單一模型與小規模任務驗證,確認工具鏈與自家程式庫的相容程度,再評估擴大。
出處連結有哪些?
本文整理自 Google 官方部落格與 TorchTPU 儲存庫,涵蓋架構設計、硬體說明、安裝指引與 2026 年發展路線。
儲存庫網址:https://github.com/google-pytorch/torch_tpu
官方技術說明:https://developers.googleblog.com/torchtpu-running-pytorch-natively-on-tpus-at-google-scale/
使用者指南:https://torchtpu.readthedocs.io/
套件頁面:https://pypi.org/project/torch-tpu/0.2.0/
總結:TorchTPU 值得關注嗎?
值得關注,但現階段適合評估而非全面採用。它把 PyTorch 在 TPU 的門檻降到接近零,但版本尚淺、授權條款待確認。
這個專案處理的是生態系層級的問題,而非單一模型的速度。當訓練框架與硬體綁定過深,使用者的議價能力會隨時間流失;把 PyTorch 做成 TPU 的一等公民,等於讓硬體選擇回到可替換的狀態。從這個角度看,493 顆星標的專案所代表的戰略意義,遠大於數字本身。
技術取捨也值得其他硬體廠商參考。選擇以 PrivateUse1 接入而非包裝既有張量,換來的是與上游 PyTorch 行為一致;選擇 XLA 而非通用後端,換來的是對拓撲與通訊的理解。兩項決定都偏向長期正確而非短期省事。
實際導入的建議仍然務實:先確認授權條款,再以一個中等規模的模型跑通端到端流程,量測專案關心的指標,最後才談遷移範圍。硬體後端的成熟度,從來不是靠發布會決定,而是靠第一批生產工作負載的壓力測試。
