Ultralytics 於 2026 年 11 月 7 日發布 8.4.205,在套件內加入 solutions.OCR,把場景文字偵測與字元辨識串成單一流程。方案由 YOLO26-Text 定位文字,再交由 PaddleOCR 或自訂辨識器讀字,輸出文字、信心分數與原圖多邊形,並按閱讀順序排序。
同版一併公開 Scene Text OBB 資料集,涵蓋 65,325 張影像與約 129 萬個詞多邊形。核心 Results 介面保持不變,既有推論程式碼無須改寫。
Ultralytics 8.4.205 加入了什麼功能?
8.4.205 在套件內新增 solutions.OCR,把文字偵測、可選的字元辨識與閱讀順序排序組成單一介面,核心 Results 介面維持不變,既有程式碼無須改寫。
過去處理發票、招牌或收據時,開發者要自行完成三件事:把文字區域裁切出來、逐塊送入辨識引擎、再把零散的結果按版面重新排序。每一步都不難,但三者的座標與信心值往往不同步,出錯時難以定位是哪一環節。
新方案把這段流程收進套件。一次呼叫即可取得結構化結果,每個項目同時帶有辨識文字、辨識信心、偵測信心、原圖多邊形與檢測索引,排序依閱讀順序處理,直接可用於後續的欄位抽取或表格還原。
內建 OCR 方案如何運作?
偵測模型先以偵測框、旋轉框或分割遮罩界定文字多邊形,裁切後交由辨識器讀字;PaddleOCR 屬可選依賴,自訂辨識器接收裁切圖並回傳文字與信心值。
偵測層可選三種幾何:一般偵測框適合橫排文字,旋轉框處理傾斜招牌,分割遮罩對彎曲或透視變形的版面較穩定。裁切沿用專案既有的座標工具,因此輸出多邊形與原圖座標一致,不需要另做換算。
辨識層的預設選項是 PaddleOCR,但它並非硬性依賴。只有在參數指定 PaddleOCR 時,系統才透過依賴檢查安裝並載入;若使用自訂辨識器,只需提供一個接收單張裁切圖並回傳文字與信心值的函式,即可接入自家模型或商用光學辨識服務。
為什麼要把文字偵測與辨識分成兩步?
分開處理讓兩層可獨立替換,換辨識語言或模型時不必重新訓練偵測器;偵測層只需判斷文字位置,對字體、語言與內容變化不敏感,維護成本明顯較低。
單一模型直接輸出字串的做法,在版面密集或字體多變時容易整段失效,而且錯誤難以歸因。拆成兩步之後,定位錯誤與辨識錯誤可以分開量測:多邊形偏移屬於偵測問題,多邊形正確但字串有誤則屬辨識問題,調校方向因此明確。
這一步的代價是延遲。專案的做法是以批次辨識攤平成本,把多個裁切圖一次送入辨識引擎,暖機後處理 63 個裁切圖的時間由 1.204 秒降至 0.425 秒,約為原本的 2.8 倍。對於需要即時回應的場景,這個差距直接決定能否在單一幀內完成。
傾斜文字過去為什麼讀錯?
舊版裁切跟隨正規化框參數,逆時針傾斜的文字會被轉成 90 度,PaddleOCR 曾把 ULTRALYTICS 2026 讀成 208;新版改以跨越最寬的一邊為上緣。
8.4.205 的修正範圍比表面看來更廣,因為同一個裁切函式同時服務儲存裁切圖與物件裁切功能。舊邏輯下,只要文字傾斜方向與正規化參數不一致,輸出的圖就會側躺,後續辨識自然全錯,而且錯誤訊息只會顯示辨識失敗,不會提示問題出在裁切。
新規則以幾何決定方向:跨越最左至最右的邊作為上緣,接近正方的小框保持直立,細長且傾斜的框則沿長邊躺平,與閱讀方向一致。官方以 PaddleOCR 實測,ULTRALYTICS 2026 這類字串在負 90 度至正 90 度之間由 22/32 提升至 28/32,走完整 OCR 流程則由 13/26 提升至 22/26。仍會失手的只有近乎垂直、由下往上書寫的文字,單靠外框無法判斷閱讀方向。
YOLO26-Text 模型有哪些規格?
YOLO26-Text 提供 n、s、m、l、x 五種尺寸,權重發佈於 Ultralytics 平台,可與偵測、旋轉框與分割模型組合,作為文字定位層使用。
這個模型家族專門處理場景文字定位,與通用物件偵測模型的分工在於訓練資料與錨點設計。尺寸選擇與其他 YOLO 系列一致:n 與 s 適合邊緣裝置與影片串流,m 與 l 用於伺服器端批次處理,x 則用於準確度優先的離線任務。
搭配方式相當直接,載入偵測模型指定 yolo26n-text 一類權重,再於 OCR 方案中宣告辨識器即可。官方測試涵蓋一般偵測、旋轉框與分割三種幾何組合,端到端流程均能產生標註圖與結構化紀錄;中文帳單影像可輸出 63 筆紀錄,Unicode 標籤亦能正常渲染。
新的場景文字資料集包含什麼?
Scene Text OBB 資料集結合 COCO-Text 與 HierText,共 65,325 張影像與 129 萬個詞多邊形,標註文字位置但不含轉錄字串,辨識語料須另備。
資料集的價值在於覆蓋面。COCO-Text 來自日常場景,HierText 則針對段落與密集版面,兩者合併後同時包含稀疏招牌與緊密文件,對訓練詞級偵測器較為完整。標註形式為旋轉框,適合處理傾斜與透視變形的文字。
限制也需要說明。這份資料集只有位置標註,沒有逐詞轉錄,因此無法直接用於辨識模型訓練。若目標是訓練自家辨識器,仍需另備含文字內容的語料,並自行處理字元集與語言分佈。
8.4.206 至 8.4.208 修正了哪些問題?
8.4.206 加入文字方向分類器處理倒轉文字;8.4.207 修復 PaddlePaddle 匯出;8.4.208 把預測與追蹤的 NMS IoU 預設由 0.7 改為 0.5。
倒轉文字的處理方式值得記錄。8.4.206 以文字行方向分類器判斷裁切圖是否上下顛倒,對可疑的裁切圖嘗試兩種方向,保留信心較高的一次,因此由下往上書寫的文字也能讀出。這項修正只作用於 PaddleOCR 路徑,自訂辨識器仍需自行處理方向。
8.4.207 處理的是環境問題。PaddlePaddle 在新安裝與 CUDA 機器上的匯出曾失敗,該版補回設定步驟並更新部分容器基底映像。8.4.208 則改動預設值:未指定參數時,預測與追蹤的交並比門檻由 0.7 降為 0.5,驗證流程保持 0.7 不變,擁擠場景的重疊框因此減少,代價是相近物件可能被一併抑制。同版亦讓類別顏色可隨資料集中介資料一併保存,並在匯出的模型中沿用。
YOLO27 的預覽數據代表什麼?
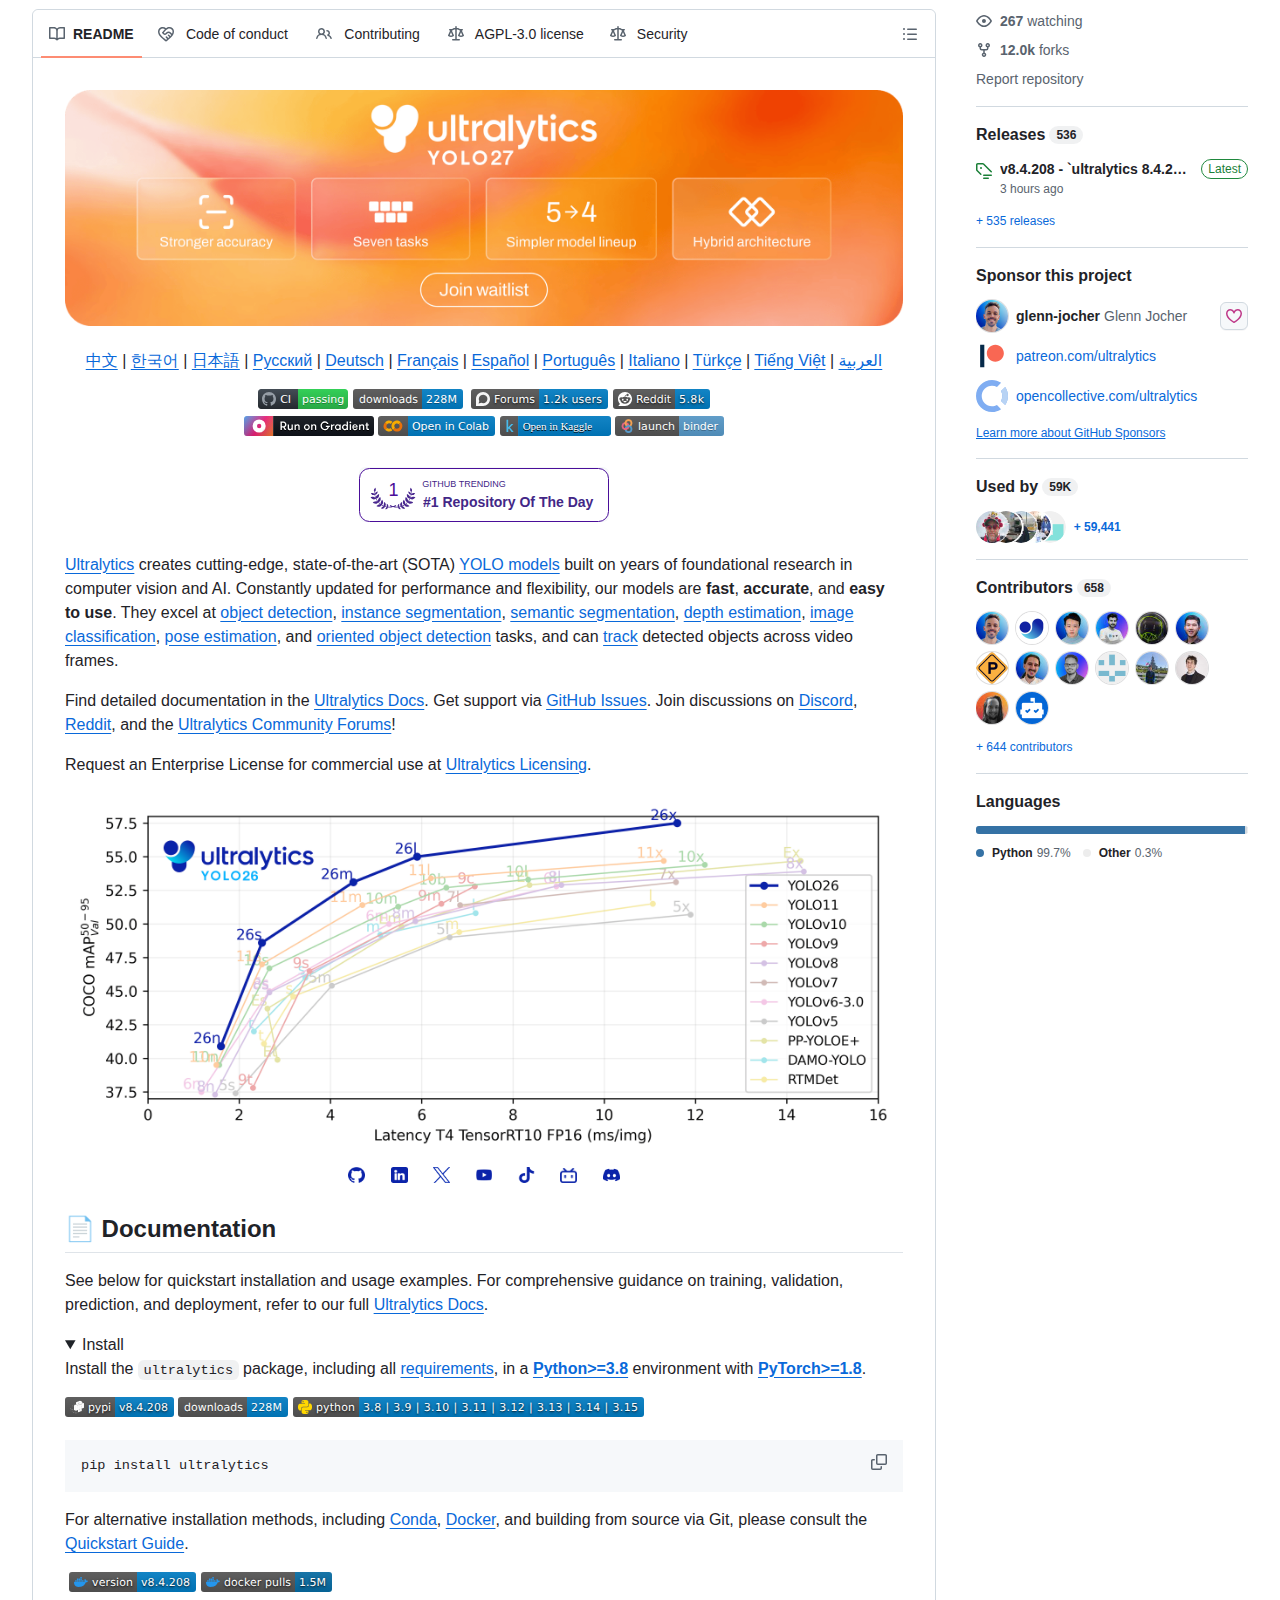
YOLO27 尚未發佈,預覽顯示四個尺度在 COCO 取得 42.6 至 60.5 mAP,YOLO27l 以 800 像素輸入達 61.4 mAP,是系列首個突破 60 mAP 的模型。
架構分成兩條路徑。n 與 s 採精簡卷積網路,捨去中尺度預測圖,只保留細尺度與粗尺度,並以固定縮放平衡兩者,藉此削減檢測頭運算量;m 與 l 改用查詢式解碼器,直接輸出最終檢測框,免除非極大值抑制的後處理,主幹則換成在深層使用自注意力機制的 UltraViT。
訓練層面另有一項設計。額外的輕量分支只在訓練時學習分辨物件與背景,用來拉近一對多監督與一對一輸出之間的差距,官方數據顯示該差距由 YOLO26n/s 的 0.9 與 0.8 mAP 收窄至 0.4 mAP;分支在推論與匯出時移除,部署成本為零。
參數與運算量方面,YOLO27n 為 3.0M 參數與 7.2 GFLOPs,YOLO27s 為 11.8M 與 28.2,YOLO27m 為 24.6M 與 64.6,YOLO27l 為 72.3M 與 166.7。官方文件同時提醒,這些數據屬研究階段結果,公開權重與重現指令會隨正式發佈一併提供,現階段專案應繼續使用 YOLO26。
專案目前的規模與授權如何?
儲存庫累積 63,219 顆星標、11,973 次複製與 267 位關注者,以 Python 撰寫並採 AGPL-3.0 授權,累計 536 個版本、658 位貢獻者。
授權是採用前必須確認的一項。AGPL-3.0 要求修改後的程式在提供網路服務時同樣開源,對內部工具影響有限,但整合進對外產品時通常需要商業授權,專案首頁已提供企業授權的申請入口。這個條款過去令部分團隊改用其他授權較寬鬆的推論框架。
版本節奏則是另一面。536 個版本意味著平均每兩至三日就有一次發佈,修補到達得快,但每次升級都要重新確認行為差異。8.4.208 改動交並比預設值即為一例:同一個門檻在驗證與推論之間分離,若下游程式依賴舊行為,結果會靜靜改變。
出處連結有哪些?
主要出處為 GitHub 儲存庫 ultralytics/ultralytics 及 8.4.205、8.4.208 發布說明,另含 YOLO27 預覽頁與 OCR 文件。
本文數據取自專案公開資料,包括儲存庫統計、各版本發布說明與官方文件的模型規格。讀者如需核對個別技術細節,可依下列連結前往原始來源。
- 儲存庫:https://github.com/ultralytics/ultralytics
- 8.4.205 發布說明:https://github.com/ultralytics/ultralytics/releases/tag/v8.4.205
- 8.4.208 發布說明:https://github.com/ultralytics/ultralytics/releases/tag/v8.4.208
- OCR 方案拉取請求:https://github.com/ultralytics/ultralytics/pull/27061
- YOLO27 預覽文件:https://docs.ultralytics.com/models/yolo27/
總結:哪些團隊適合採用這套 OCR 方案?
已在用 YOLO 系列、需要把文件或場景文字轉成結構化資料的團隊最適合,可沿用既有環境與介面;若產品對外提供服務,須先確認 AGPL-3.0 的開源義務。
這批更新的實際價值在於把一段常見但零散的工程收進套件。定位、裁切、批次辨識與閱讀順序排序過去需要自行拼裝,現在由同一組介面承擔,錯誤也能按層歸因;對已經在使用 YOLO 的專案而言,接入成本主要在於多一個可選依賴。同類的文件解析工程可對照 Marker 2.1 與 Surya 的版面辨識流程 與 OpenCV 5.1 的新推論引擎。
需要謹慎的地方同樣清楚。PaddleOCR 與 PaddlePaddle 屬可選依賴,版本門檻為 3.7 與 3.1 以上,舊環境需要先升級;8.4.208 的交並比預設值變動會影響既有輸出的框數;授權條款則決定這套方案能否直接進入商業產品。對於以文件數碼化、票據欄位抽取或車牌辨識為主業的團隊,這一輪更新的效益高於調校成本;若目前只需偶爾讀取少量文字,先沿用既有雲端光學辨識服務、觀察一至兩個版本週期再評估,亦屬合理選擇。
