
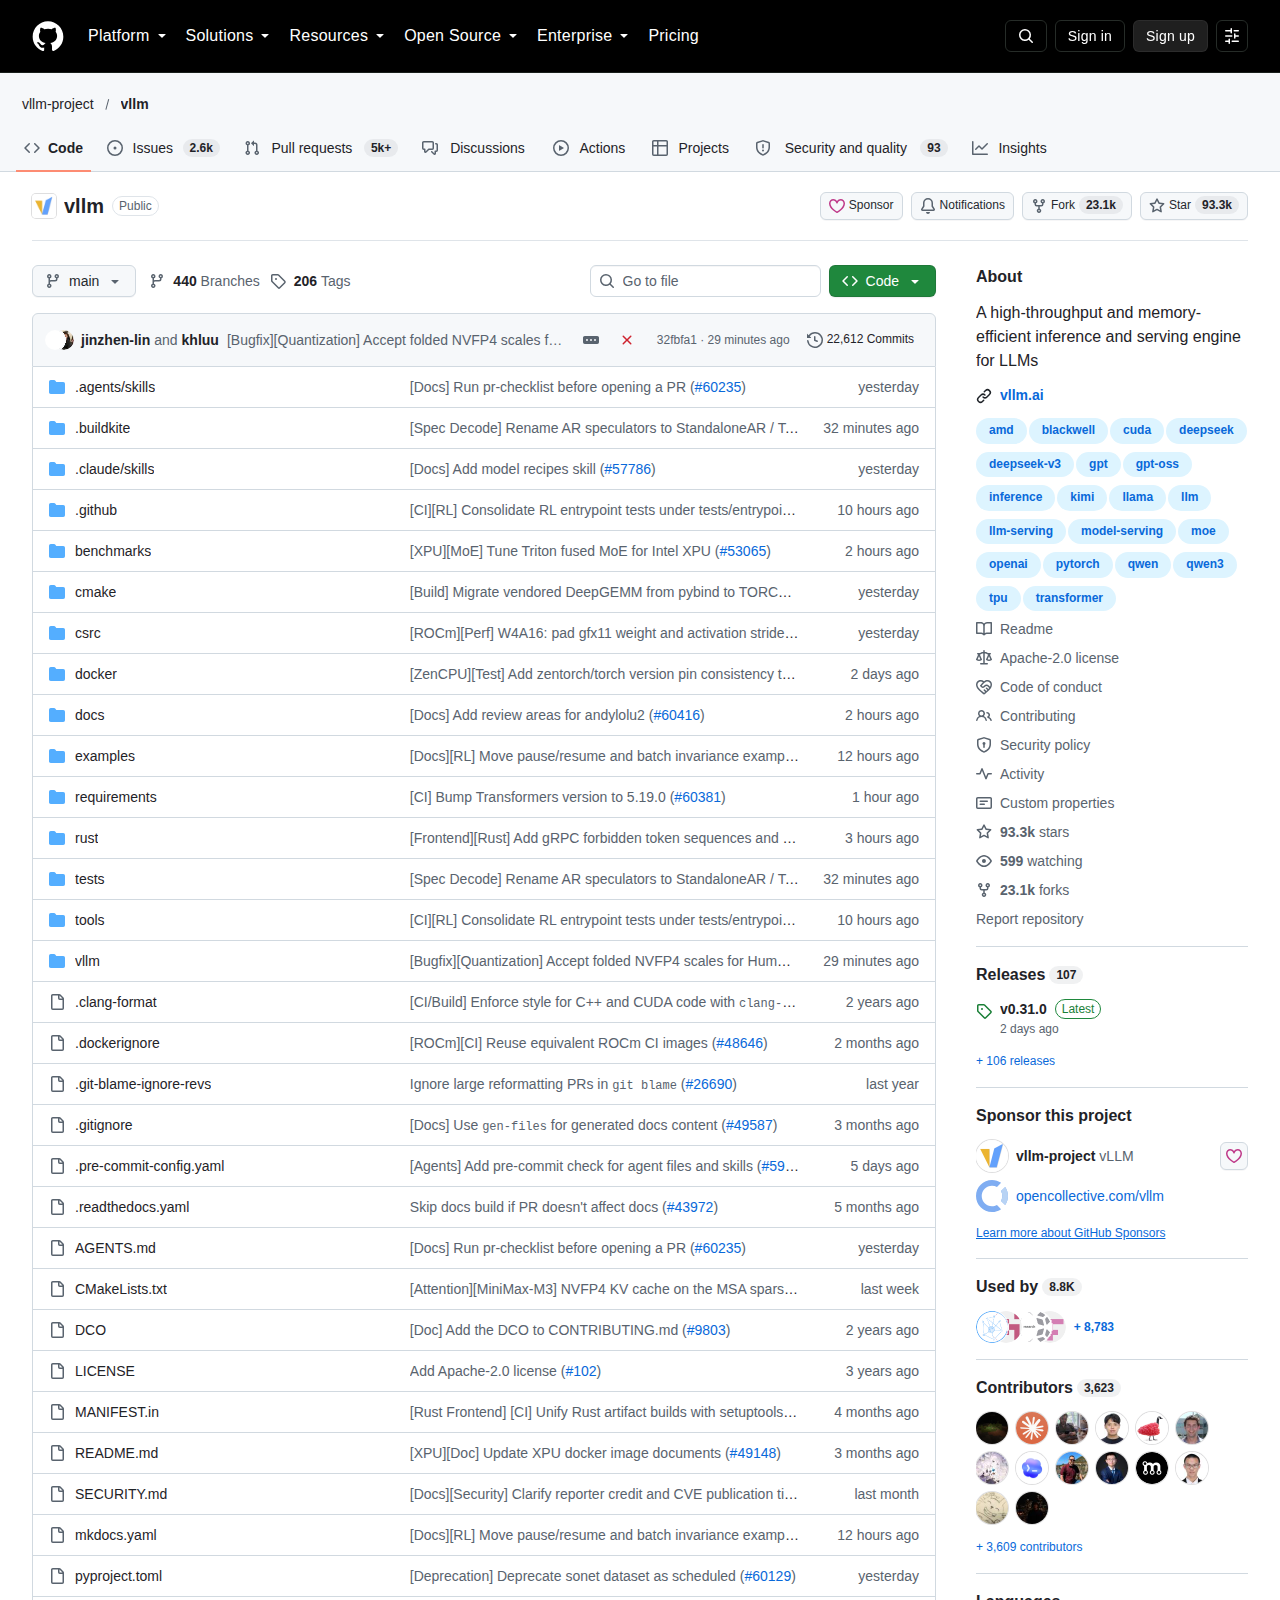
vLLM 是 GitHub 上累積 93,336 顆星標與 23,089 次 fork 的開源大型語言模型推理與服務引擎,以 Python 撰寫、採用 Apache-2.0 授權,由加州大學柏克萊分校 Sky Computing Lab 於 2023 年 2 月 9 日建立。該項目的定位十分明確:把模型權重轉換成可對外服務的推論端點,並在相同硬體上取得更高的吞吐量。專案於 2026 年 10 月 5 日發布 v0.31.0 版本,累計提交數達 22,612 次,官方描述其目標為「讓每個人都能輕鬆、快速且低成本地部署語言模型服務」。
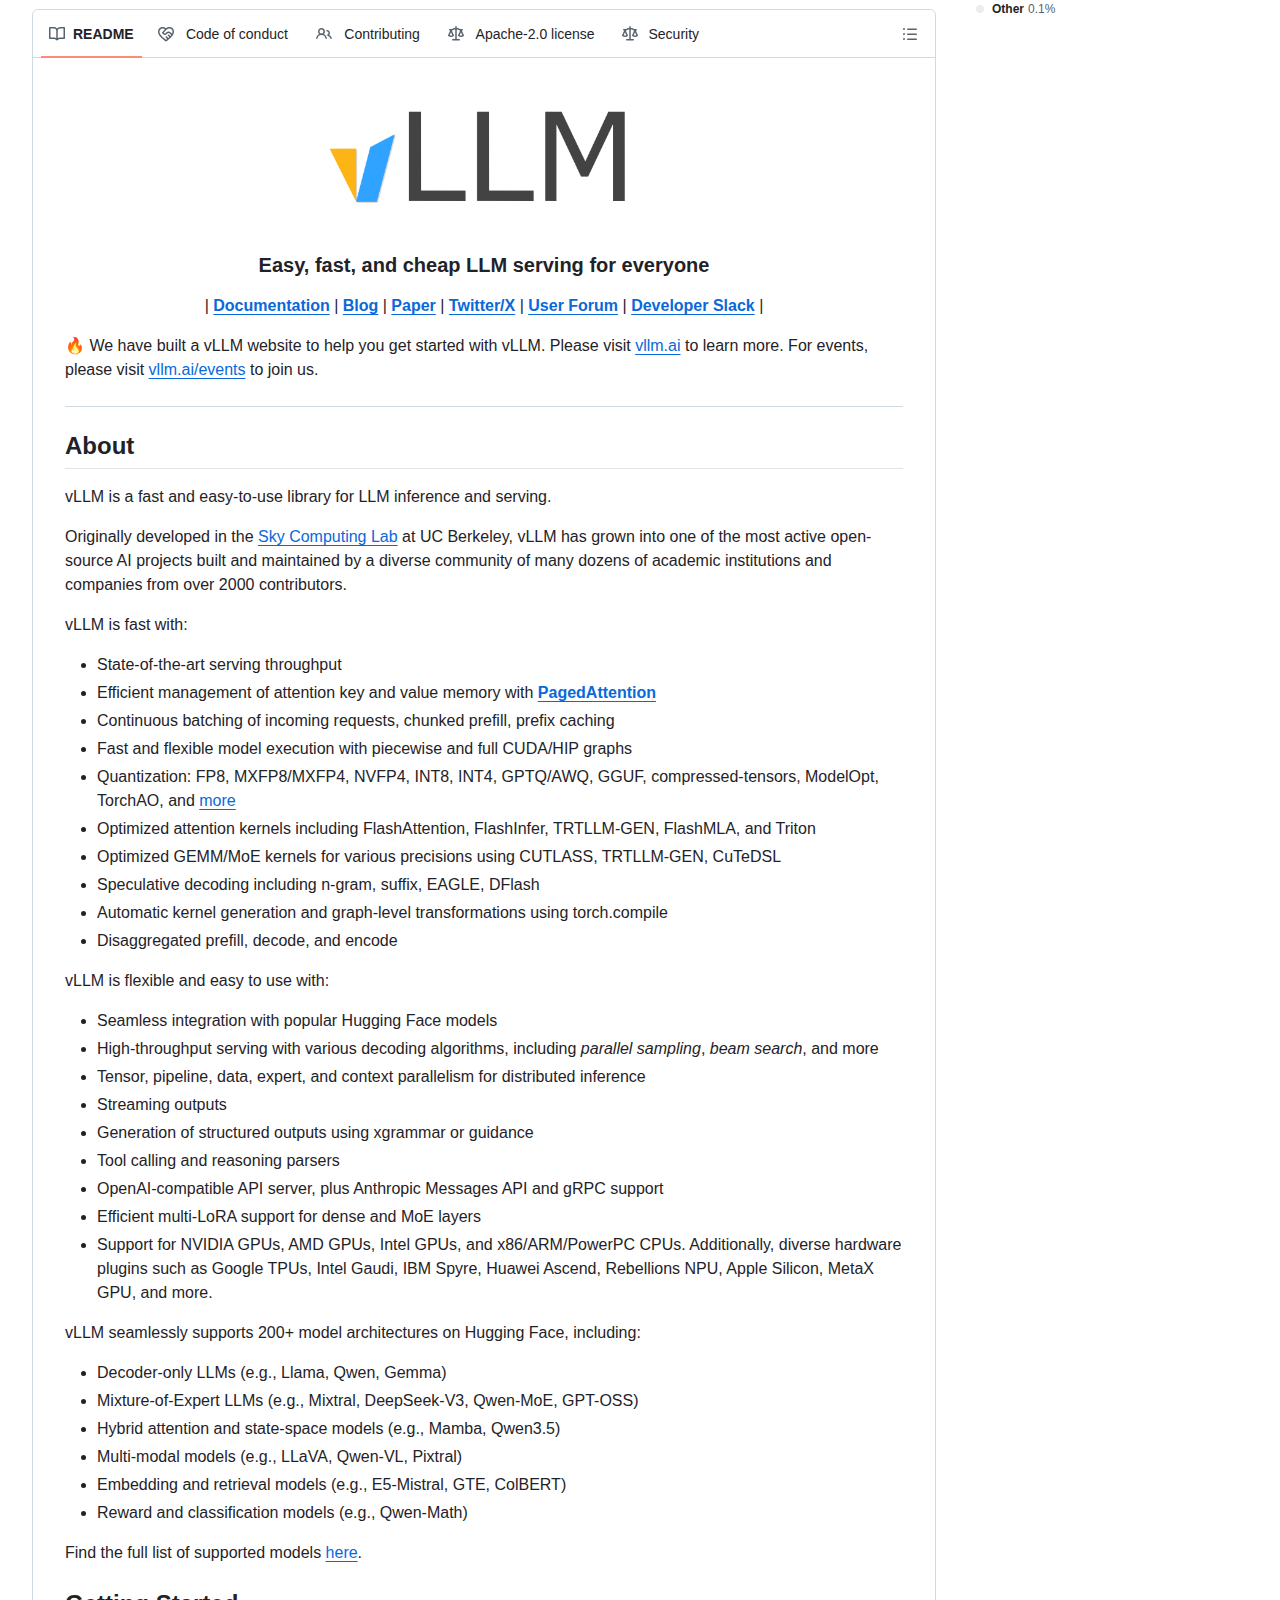
vLLM 是以 Python 撰寫的開源大型語言模型推理引擎,源自 UC Berkeley,採 Apache-2.0 授權,並提供 OpenAI 相容 API。
vLLM 是什麼?
它是一套把模型權重變成推論服務的函式庫:載入模型後以 HTTP 介面回應請求,支援 OpenAI 相容 API、Anthropic Messages API 與 gRPC。
該項目的功能定位可以概括為:在伺服器端載入一個或多個語言模型,並以標準化介面回應推論請求。使用者不需要自行處理批次排程、記憶體配置或並行運算,只要啟動服務並指向模型路徑,就能取得相容於主流雲端介面的端點。這種設計讓既有依賴 OpenAI 介面的應用程式,可以在幾乎不改動程式碼的前提下改為呼叫自架模型。
專案的成長軌跡反映其在生態中的位置。專案最初在 Sky Computing Lab 內部誕生,用來支撐研究團隊的模型服務需求,其後逐步開放。官方說明,該專案現由來自數十個學術機構與企業的社群共同維護,貢獻者超過 2,000 名,已成為最活躍的開源 AI 專案之一。這個組成也解釋了其功能廣度:不同機構帶著各自的硬體與模型需求參與,使支援範圍持續擴張。
在介面之外,該項目也提供多種部署層級的能力。服務端可同時掛載多個模型並以參數切換,支援串流輸出與結構化輸出,並內建工具呼叫與推理結果解析器。對於需要多租戶或客製化模型的情境,它提供多 LoRA 支援,可在同一份基礎權重上切換不同微調版本。這些能力使它同時適用於研究原型與生產環境。
vLLM 的技術架構有什麼特點?
它以分頁式鍵值記憶體管理為核心,搭配連續批次處理、分塊預填充與前綴快取,並可用張量、管線與專家等平行方式分散到多張加速卡。
架構上,該項目把推論流程拆解成多個可獨立最佳化的環節。記憶體管理負責決定每個請求能在裝置上佔用多少空間,批次排程決定同一時間要處理哪些請求,模型執行層則負責把運算映射到實際的加速核心。這種分層讓不同層級的改進可以各自進行,而不必重新設計整體流程。
排程層的關鍵設計是連續批次處理。傳統做法會等待一批請求全部完成後才送入下一批,導致長短請求互相拖累;連續批次處理則在單一請求生成結束後立即補入新請求,使裝置在整個過程中維持滿載。配合分塊預填充,長提示的處理可以被切分成較小的段落,避免單一長請求長時間佔用資源。前綴快取則讓共用相同開頭的多個請求重複使用已計算的內容,進一步降低重複運算。
執行層的優化集中在核心運算與平行策略。專案內建多種注意力核心實作,包括 FlashAttention、FlashInfer、FlashMLA 與 Triton 版本,並針對不同精度提供最佳化的矩陣乘法與混合專家核心。投機解碼讓模型可以一次驗證多個候選詞,減少逐詞生成的往返成本;torch.compile 則用於自動產生核心與進行圖層級轉換。在分散式部署上,它支援張量、管線、資料、專家與上下文等多種平行方式,並可把預填充、解碼與編碼階段拆到不同裝置執行。
PagedAttention 為何被視為關鍵創新?
它借鏡作業系統的虛擬記憶體分頁,把鍵值快取切成固定大小的區塊並以索引表管理,減少記憶體碎片與浪費,讓同一張顯示卡能同時服務更多請求。
該項目最常被引用的技術貢獻是 PagedAttention,相關論文於 2023 年發表在 ACM SIGOPS 作業系統原理研討會,題為《Efficient Memory Management for Large Language Model Serving with PagedAttention》,作者包括 Woosuk Kwon、Zhuohan Li 等研究者。論文指出,語言模型服務的記憶體瓶頸往往不在權重本身,而在生成過程中持續累積的鍵值快取。
傳統實作會為每個請求預留一段連續記憶體,長度以最大可能輸出為準,結果是實際用量遠低於保留量。PagedAttention 借用作業系統處理虛擬記憶體的方式,把快取切成固定大小的區塊,再用一張索引表記錄各區塊的位置。如此一來,記憶體不必連續,區塊可以在請求之間共享或回收,內部碎片大幅降低,同一張加速卡便能同時容納更多並行請求。
這項設計的影響超出記憶體本身。由於區塊可以共享,當多個請求沿用相同的前綴提示時,系統可以只保留一份對應的鍵值內容,直接降低重複運算與佔用。同一套機制也簡化了多序列解碼與平行取樣的實作,因為分支序列可以各自指向不同的區塊組合。這種由底層記憶體管理帶動的上層能力,是該項目在多數基準測試中維持高吞吐的重要原因。
vLLM 的硬體與模型支援範圍有多大?
它原生支援 NVIDIA、AMD 與 Intel 顯示卡及 CPU,並可透過外掛接入 TPU、Gaudi、Ascend 等加速器,同時相容超過 200 種模型架構。
硬體面向的支援相當廣泛。專案原生支援 NVIDIA、AMD 與 Intel 的顯示卡,以及 x86、ARM 與 PowerPC 架構的中央處理器。在此之外,它透過外掛機制接入多種加速器,包括 Google TPU、Intel Gaudi、IBM Spyre、華為 Ascend、Rebellions NPU、Apple Silicon 與 MetaX 等平台。這種設計讓同一套服務程式碼可以在不同硬體上重複使用,對於需要跨雲與地端混合部署的團隊尤其重要。
模型支援方面,官方文件列出超過 200 種架構,涵蓋僅解碼器的語言模型如 Llama、Qwen 與 Gemma,混合專家模型如 Mixtral、DeepSeek-V3 與 GPT-OSS,混合注意力與狀態空間模型如 Mamba 與 Qwen3.5,以及多模態、嵌入檢索與獎勵分類模型。這種廣度讓它不只是聊天模型的服務工具,也能支撐檢索、排序與評估等周邊任務。
在輸出控制上,專案支援以約束解碼產生結構化結果,可搭配 xgrammar 或 guidance 等工具,並內建工具呼叫與推理內容解析器。量化方面則涵蓋 FP8、MXFP8、MXFP4、NVFP4、INT8、INT4、GPTQ、AWQ 與 GGUF 等多種格式,讓使用者能在精度與記憶體之間取得平衡。這些能力共同構成從原型到生產環境所需的完整鏈路。
如何開始使用 vLLM?
官方建議以 uv 或 pip 安裝 vllm 套件,安裝完成後即可在 Python 中載入模型或啟動服務;如需特定硬體支援或自行修改,則可依文件從原始碼建置。
入門流程相對直接。官方建議使用 uv 套件管理工具安裝,指令為 uv pip install vllm,也可改用 pip 安裝。安裝完成後,使用者可以在 Python 程式中載入模型並直接產生結果,或啟動內建的服務端程式,以 HTTP 介面提供推論。官方網站 vllm.ai 與文件站 docs.vllm.ai 提供快速入門、安裝說明與支援模型清單。
若執行環境需要特定硬體支援、自訂核心或最新功能,官方建議從原始碼建置對應的套件。文件另提供各階段的指引,涵蓋分散式部署、量化設定、結構化輸出與多 LoRA 等進階主題。專案社群同時維護使用者論壇與開發者通訊管道,方便回報問題與協調貢獻。
以下為該專案的關鍵數據與授權資訊。
vLLM 的統計數據與授權條件為何?
該專案累積 93,336 顆星標、23,089 次 fork 與 599 名關注者,以 Python 撰寫、採 Apache-2.0 授權,最新版本為 v0.31.0。
該項目採用 Apache License 2.0,屬於寬鬆型授權,允許商業使用、修改與再散布,且不要求衍生作品以相同授權釋出。對於企業而言,這意味著可以在產品中整合該引擎而不必公開自有程式碼,這是它在商業部署場景中被廣泛採用的重要原因之一。專案同時提供安全問題回報管道,並維護媒體資源庫說明商標使用方式。
版本節奏方面,專案維持約每兩週一次的功能版本發布。近期版本依序為 2026 年 8 月 26 日的 v0.28.0、9 月 9 日的 v0.29.0、9 月 22 日的 v0.30.0,以及 10 月 5 日的 v0.31.0。儲存庫的更新時間顯示為 2026 年 10 月 7 日,開放的議題與合併請求數量維持在數千條規模,反映社群參與度與維護工作量。
出處連結有哪些?
本文資訊整理自 vllm-project/vllm 的 GitHub 儲存庫與官方文件,包括專案說明、支援模型清單、安裝指引與 PagedAttention 論文。
- GitHub 儲存庫:https://github.com/vllm-project/vllm
- 官方網站:https://vllm.ai
- 官方文件:https://docs.vllm.ai
- PagedAttention 論文:https://arxiv.org/abs/2309.06180
總結:vLLM 適合什麼團隊?
它適合需要自架或大規模部署語言模型服務的團隊,尤其是重視吞吐量、成本與硬體彈性者;若只需要少量推論或無維運人力,託管式介面仍較省事。
此專案的價值在於把推論服務的技術門檻與硬體成本一併壓低。對擁有自有加速卡、需要處理大量並行請求,或必須把模型留在內部網路的團隊而言,它提供了一條成熟且授權寬鬆的部署路徑,並可透過同一套介面在雲端與地端之間遷移。來自 2,000 名以上貢獻者與數十個機構的持續投入,也讓它在模型與硬體支援上保持領先。
不過,高效能同時意味著較高的維運要求。部署者需要理解記憶體與批次設定對效能的影響,具備對應硬體與驅動環境,並自行處理服務監控、擴縮容與版本升級。對於推論量不大、缺乏維運人力的團隊而言,直接使用託管式介面仍是更務實的選擇;該項目更適合定位為需要掌握成本與資料流向時的自建服務層。