VoxCPM2 是 OpenBMB 於二零二六年四月發佈的開源語音合成模型,GitHub 累積 40,734 顆星標。它採免分詞的擴散自回歸架構,在音訊潛在空間生成連續語音,2B 參數在兩百萬小時多語語音上訓練,支援三十種語言與九種中文方言,原生輸出 48kHz。
VoxCPM2 是什麼?
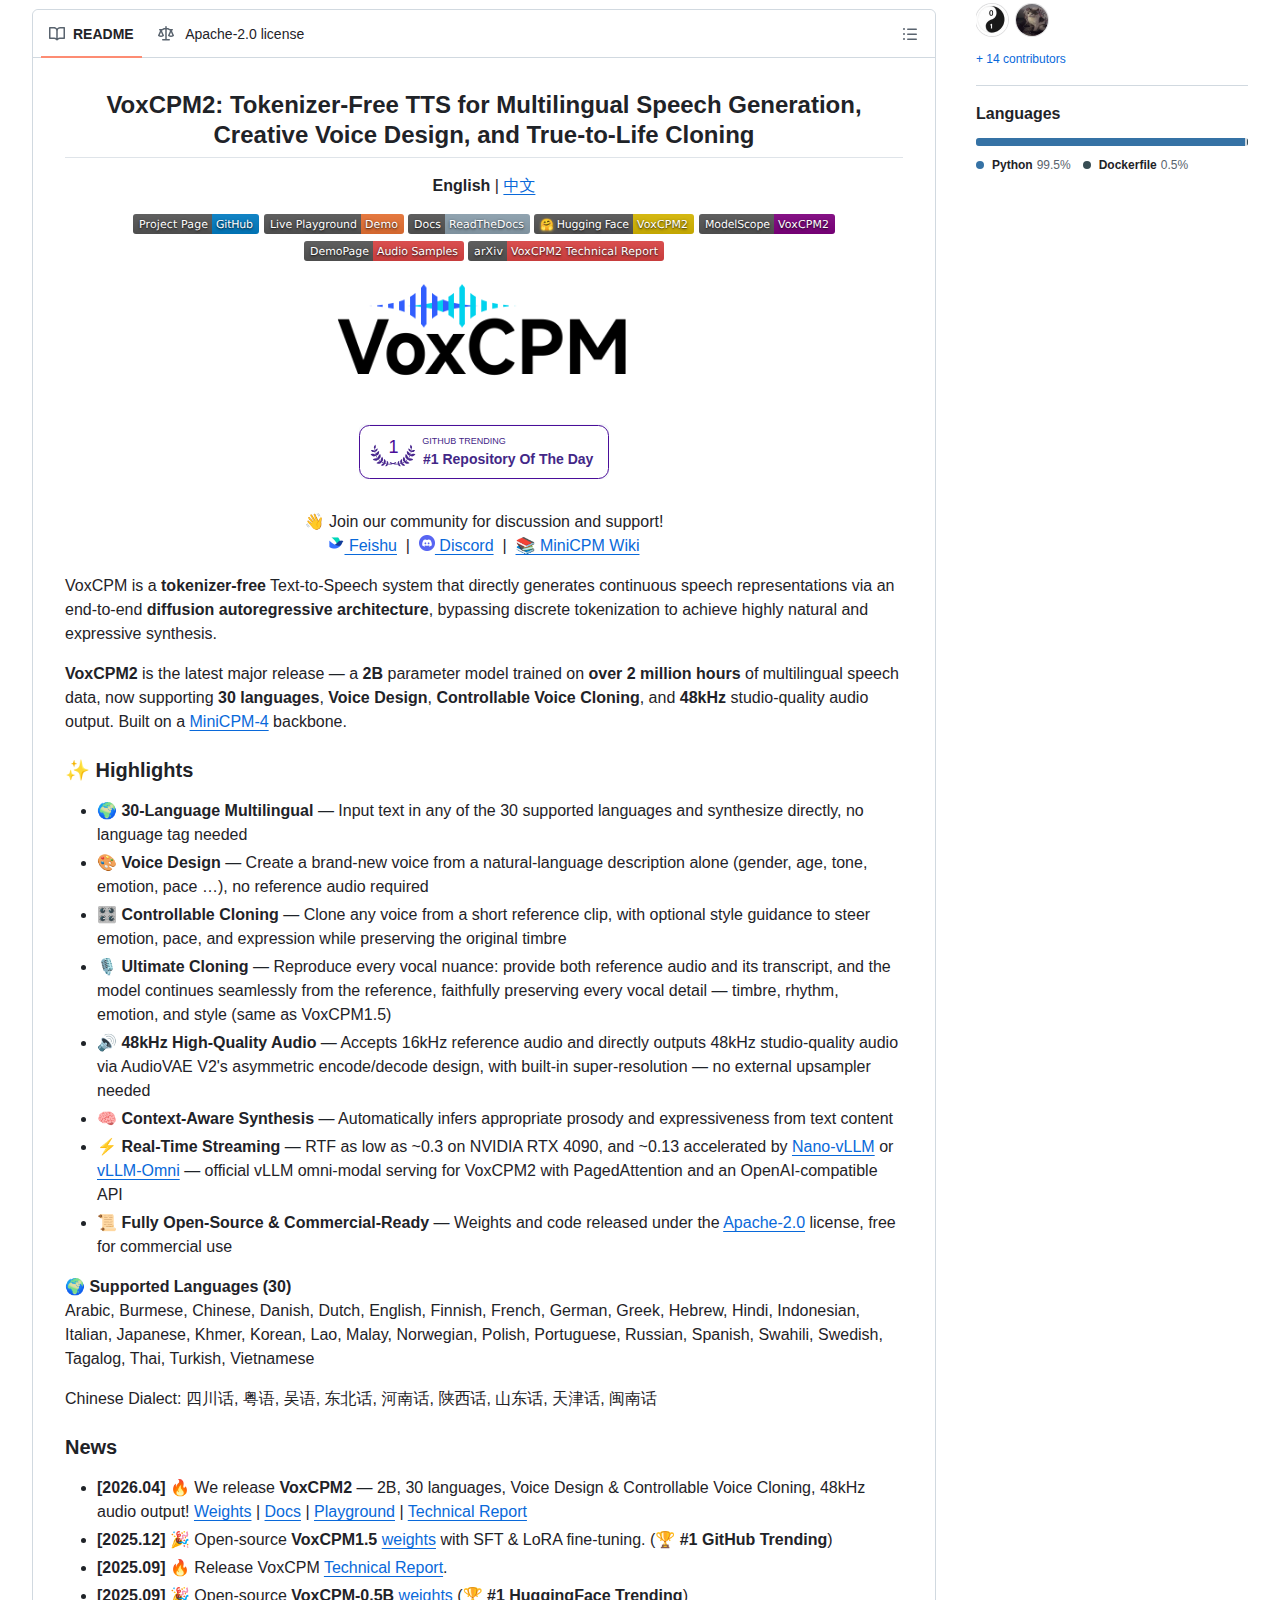
VoxCPM2 是 OpenBMB 的開源語音合成模型,2B 參數、Apache-2.0 授權,支援三十種語言與九種中文方言,原生輸出 48kHz,在音訊潛在空間生成語音。
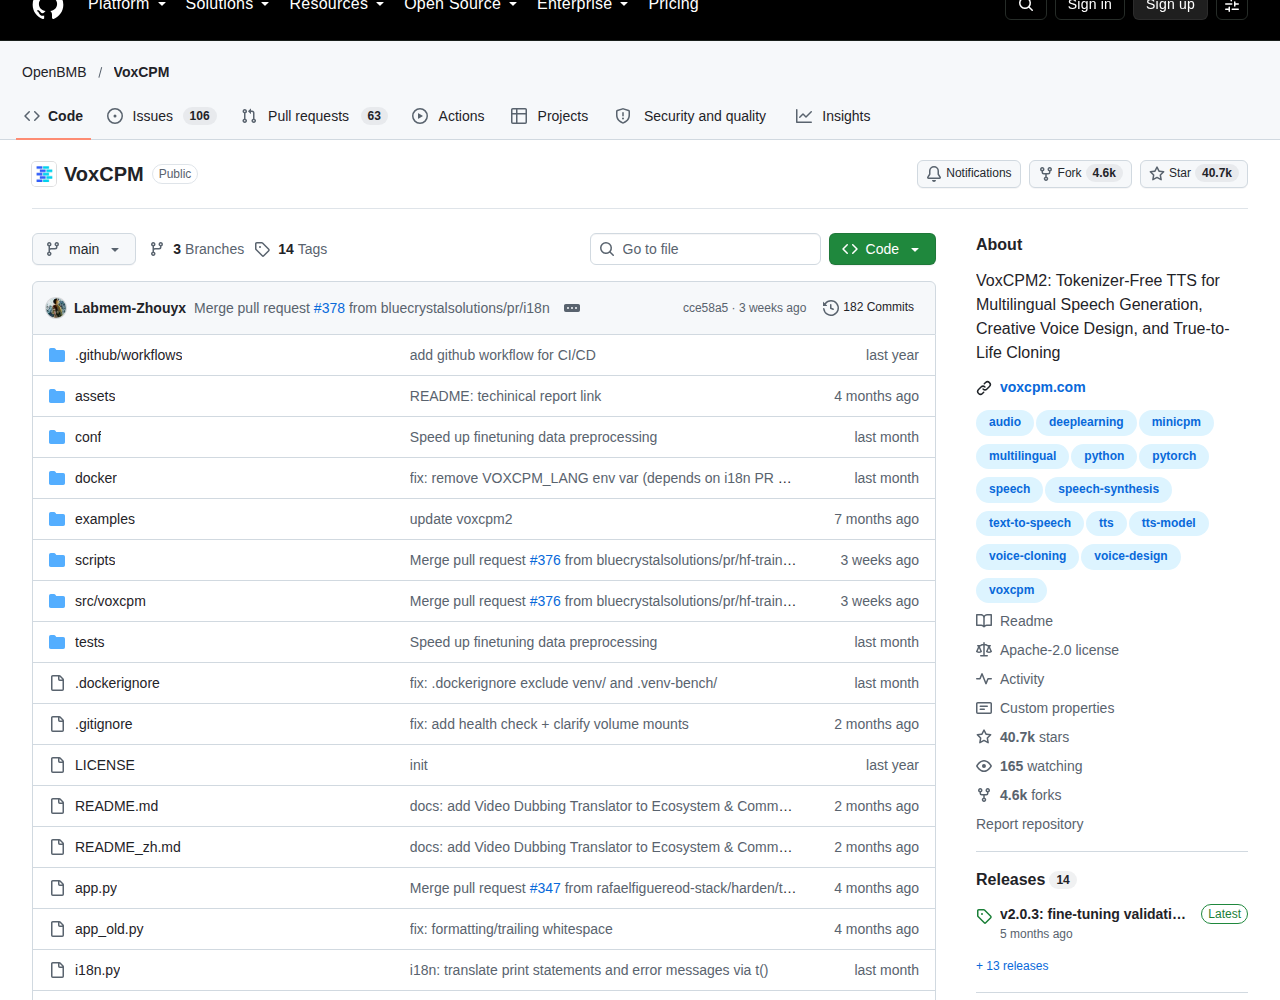
此項目由 ModelBest 與清華大學人機語音交互實驗室共同維護,底層語言模型沿用 MiniCPM-4。儲存庫在二零二五年九月建立,至今累積 4,635 次複製、165 位關注者與 28 位貢獻者,主要語言為 Python,佔程式碼 99.5%。
版本線共有三代。最新一代 VoxCPM2 為 2B 參數、輸出 48kHz;上一代 VoxCPM1.5 為 0.6B 參數、輸出 44.1kHz、僅支援中英雙語;初代 VoxCPM-0.5B 輸出 16kHz,現已標記為舊版。
免分詞架構解決了什麼問題?
傳統語音合成先切成離散標記再還原,量化會丟失細節。VoxCPM2 改在 AudioVAE V2 連續潛在空間運作,流程為 LocEnc、TSLM、RALM 與 LocDiT。
離散標記化的代價出現在音色與韻律的細節上。量化把連續波形壓成有限詞彙表,呼吸、尾音與情緒起伏容易在還原時被抹平。連續潛在空間繞開這層壓縮,模型可以保留較多原始聲學資訊。
四階段流程各有分工。LocEnc 先把文字與參考音訊編碼成局部表徵,TSLM 負責整體語意與韻律規劃,RALM 補上殘差細節,最後由 LocDiT 以流匹配方式還原波形。
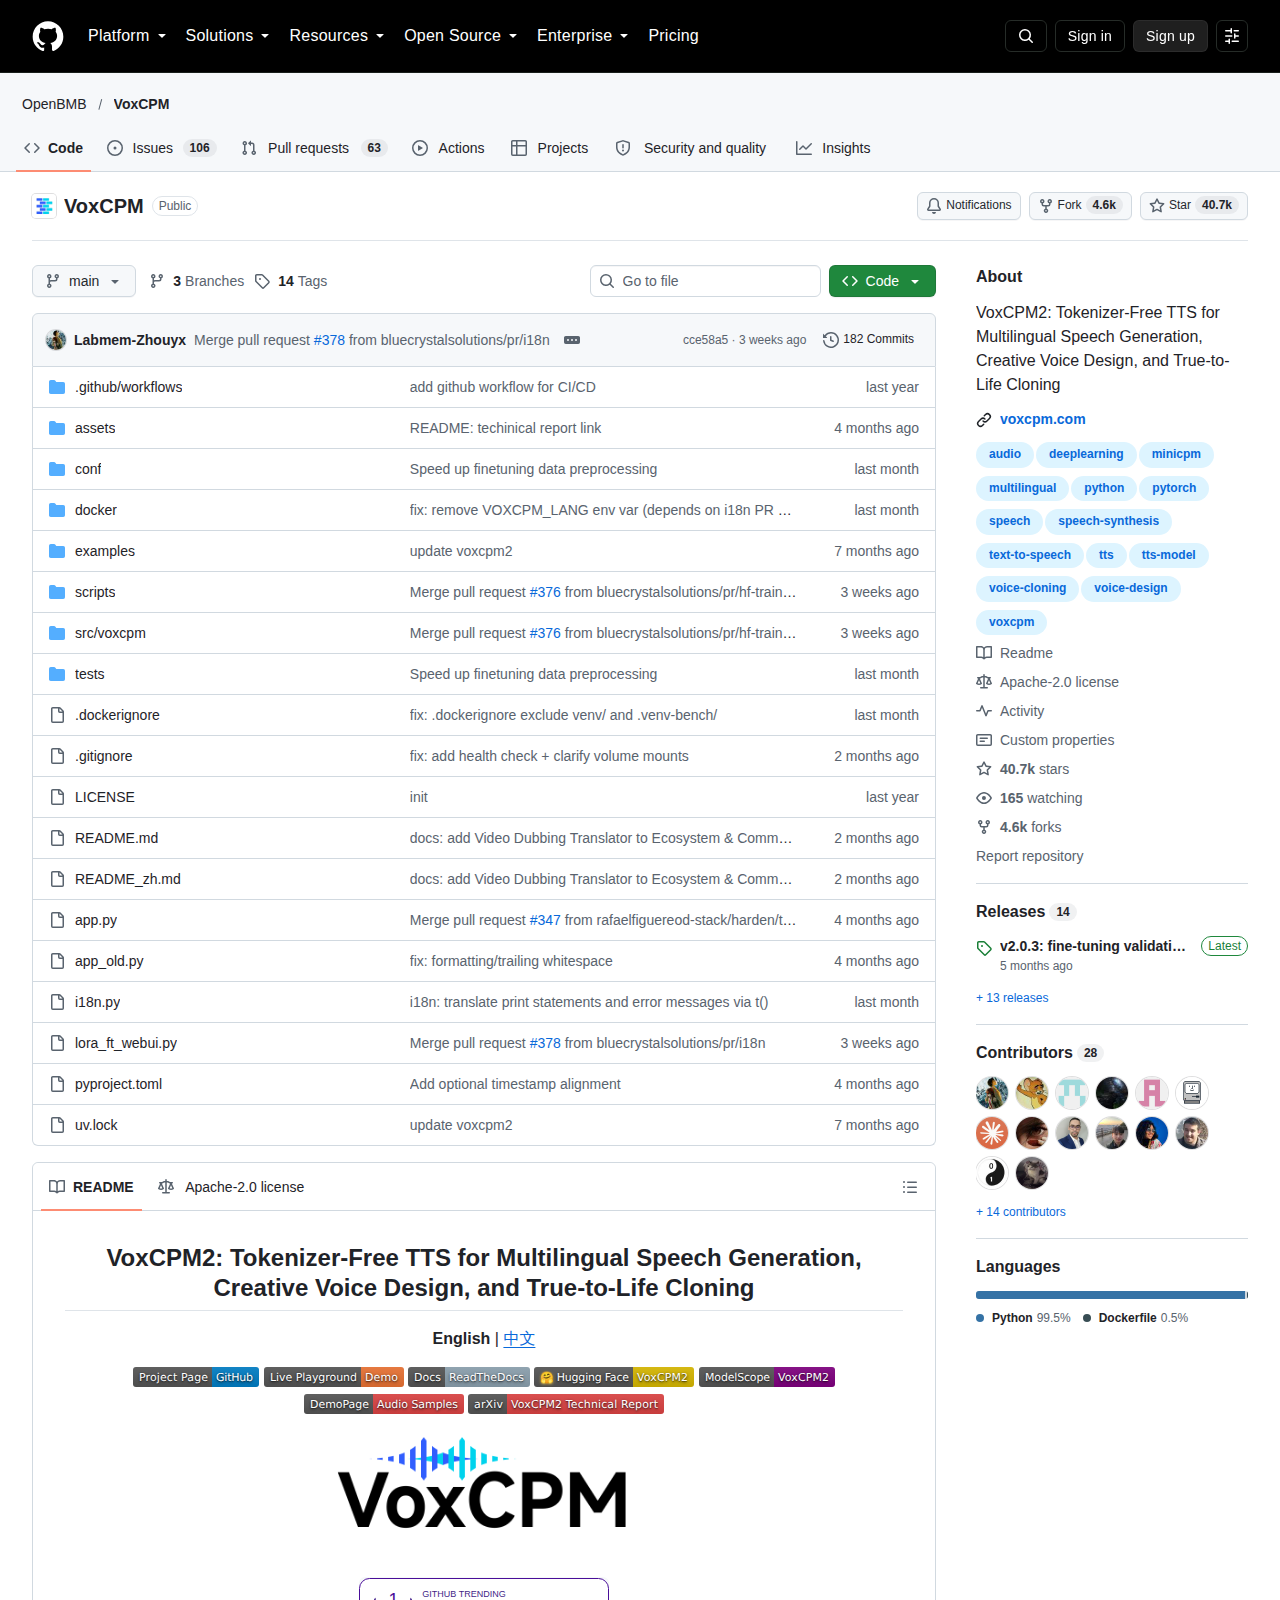
這套設計的副產品是取樣率。因為解碼端不再受離散詞彙表限制,AudioVAE V2 可以採非對稱編解碼,接受 16kHz 參考音訊而直接輸出 48kHz,內建超解析度,不需要外部升頻工具。
三十種語言與粵語支援的實際表現如何?
官方列出三十種語言,另含粵語、四川、吳語等九種漢語方言。公開基準顯示中英文接近商用模型,粵語字錯率 38.58% 明顯落後同類。
MiniMax 多語測試集提供了一組可直接對照的數字。中文字錯率為 1.136%,低於 ElevenLabs 的 16.026%,高於 FishAudio S2 的 0.730%。英文詞錯率 2.289%,與 ElevenLabs 的 2.339% 接近,落後 Qwen3-TTS 的 0.934%。
粵語是明顯的弱項。VoxCPM2 在該測試集錄得 38.584% 字錯率,FishAudio S2 為 30.670%,Minimax 為 34.111%,ElevenLabs 則高達 51.513%。整體數字偏高,說明這個語言的公開評測本身難度較大,但四者差距仍然清楚。
歐洲語言的分佈並不平均。德文 0.679%、荷蘭文 0.913%、芬蘭文 2.632% 屬於可用水平;捷克文 24.132%、阿拉伯文 13.046%、印地文 19.699% 則明顯未達實用標準。選型前必須以自己的目標語言實測,不能只看語言清單的長度。
聲音設計與可控複製要怎麼用?
聲音設計不需參考音訊,把描述放在文字開頭括號內即可生成新音色。可控複製則提供一段參考錄音,再以括號指令調整語速、情緒與風格,同時保留原始音色。
兩種模式的差別在輸入。聲音設計只吃文字描述,格式為括號包住描述後緊接要唸的句子;可控複製需要 reference_wav_path 指向一段參考錄音,模型先取音色,再接受風格指令。
# 聲音設計:不需參考音訊
wav = model.generate(
    text="(A young woman, gentle and sweet voice)Hello, welcome to VoxCPM2!",
    cfg_value=2.0,
    inference_timesteps=10,
    seed=42,
)

# 可控複製:參考音訊 + 風格指令
wav = model.generate(
    text="(slightly faster, cheerful tone)This is a cloned voice.",
    reference_wav_path="path/to/voice.wav",
    cfg_value=2.0,
    inference_timesteps=10,
    seed=42,
)
第三種模式叫極致複製。它同時要求參考音訊與該段錄音的精確逐字稿,模型以音訊續寫的方式接續,音色、節奏、情緒一併延續,相似度在三者中最高。
命令列工具把三種模式包成子命令。voxcpm design 對應聲音設計與可控複製,voxcpm clone 對應複製,voxcpm batch 可讀取文字檔批次生成,另可加裝時間戳模組輸出詞級或字級對齊。
InstructTTSEval 是用來衡量指令遵循的公開基準。VoxCPM2 在中文取得 85.2 分,與 Qwen3TTS-12Hz-1.7B-VD 同分;英文取得 84.2 分,高於 Hume 的 83.0 分。描述一致性與韻律保持兩項,英文表現優於中文。
硬體需求與即時率表現如何?
VoxCPM2 在 RTX 4090 上即時率約 0.30,改用 Nano-vLLM 可降至 0.13,顯示記憶體約 8GB。舊版 0.5B 約 5GB,輸出僅 16kHz。
即時率低於一代表生成速度快於播放速度。0.30 意味著每秒音訊約需 0.3 秒運算,單張消費級旗艦卡足以支撐離線批量生成。0.13 則來自專用的 Nano-vLLM 推理引擎,官方稱之為加速版部署路徑。
門檻落在顯示記憶體。2B 模型需要約 8GB,比上一代的 6GB 與初代的 5GB 都有提升。這個數字不含推論時的批次擴張,若同時處理多條請求,實際佔用會再上升。
生產環境有兩條官方路徑。Nano-vLLM-VoxCPM 提供非同步 API 與併發請求;vLLM-Omni 屬 vLLM 專案的模態擴充,支援分頁注意力與連續批次,並提供 OpenAI 相容的 /v1/audio/speech 端點。
行動與嵌入式場景另有 llama.cpp-omni 路徑。Apple Silicon 機器則可在網頁示範中以 MPS 後端執行,--device auto 會自動選擇可用後端。
微調需要多少資料?
官方稱五到十分鐘音訊即可完成調適,支援全參數微調與 LoRA 兩種方式,腳本為 train_voxcpm_finetune.py,分別讀取兩份設定檔。
這個門檻對個人創作者相當友善。五到十分鐘的乾淨錄音,足以讓模型貼近特定說話者的音色與咬字習慣,不需要自行從零訓練聲學模型。
兩種微調路線的取捨在資源。LoRA 只更新少量低秩參數,節省記憶體與時間,適合單一音色或單一領域;全參數微調改動整份權重,效果上限較高,但需要更多顯示記憶體與更長的訓練時間。
部署條件另有基本要求。Python 需為 3.10 以上且低於 3.13,PyTorch 需 2.5.0 以上,CUDA 需 12.0 以上,pip install voxcpm 可完成安裝。
40,734 星與 Apache-2.0 授權意味什麼?
Apache-2.0 允許商用、修改與再散布,只需保留版權聲明與授權副本。多數同類模型僅開放研究用途,這項差異對企業整合是關鍵。
語音合成領域的授權分歧很大。部分高效能模型僅開放研究用途,商用需要另談授權;VoxCPM2 直接採 Apache-2.0,權重與程式碼同一條款,企業可直接嵌入產品。
星標數在這個領域具有指標意義。四萬餘顆星標讓它成為中文圈最受注目的開源語音項目之一,並且曾在 Hugging Face 與 GitHub 雙平台登上趨勢榜首位。
專案活躍度維持穩定。最近一次推送為二零二六年十月八日,GitHub 上仍有 169 個待處理議題,開發並未停滯。生態方面已有 ComfyUI 工作流、TTS WebUI 擴充與影片配音工具等多個第三方整合。
使用上有哪些限制與風險?
官方明列三項限制:聲音複製可被濫用於冒充與詐騙,可控生成每次結果會有差異且可能需重試一到三次,三十種語言以外的語種未經正式驗證。
第一項屬於倫理風險而非技術缺陷。專案在 README 中明文禁止用於冒充、詐騙與散布不實資訊,並建議明確標示人工生成內容。部署於對外服務時,這條界線需要寫進使用條款。
第二項影響產品體驗。聲音設計與可控複製的結果在每次執行間會有變動,官方建議重試一到三次以取得理想音色。若用於需要穩定一致輸出的場景,必須固定隨機種子並建立人工篩選流程。
第三項關於語言覆蓋。清單以外的語種可以自行測試或微調,但官方不做效果保證。前面提到的捷克文、阿拉伯文與印地文數據,正好說明清單內與清單外的界線並不以語言數量劃分。
出處連結有哪些?
本文數據來自 OpenBMB/VoxCPM 儲存庫的 README 與公開基準,統計由 GitHub API 於二零二六年十月二十八日取得。
- 儲存庫:https://github.com/OpenBMB/VoxCPM
- 模型權重:https://huggingface.co/openbmb/VoxCPM2
- 技術報告:https://arxiv.org/abs/2606.06928
- 文件:https://voxcpm.readthedocs.io/en/latest/
- 線上示範:https://huggingface.co/spaces/OpenBMB/VoxCPM-Demo
常見問題有哪些?
以下六項涵蓋安裝條件、硬體選擇、粵語適用性、商用授權、與商用服務的差距,以及微調資料需求,均以官方文件與公開基準為依據。
總結:VoxCPM2 適合什麼團隊?
需要中文或英文語音、具備八 GB 顯示記憶體、且要自行掌握資料的團隊最適合。Apache-2.0 讓商用無授權障礙,但粵語與部分歐洲語言仍需實測後才決定。
VoxCPM2 的價值在於把三件事同時做到。免分詞架構讓音質上限提高,Apache-2.0 讓商用無須談判,五到十分鐘微調讓個人創作者也能建立專屬音色。
限制同樣清楚。粵語 38.584% 的字錯率、可控生成的重試需求、以及部分語種明顯落後的數據,都說明它並非通用解法。選型時應以目標語言與使用場景的實測結果為準。
對已在使用 MiniCPM 生態的團隊,這套語音模型的整合成本最低。對需要大規模併發的服務,vLLM-Omni 的 OpenAI 相容端點可以縮短改接時間。
