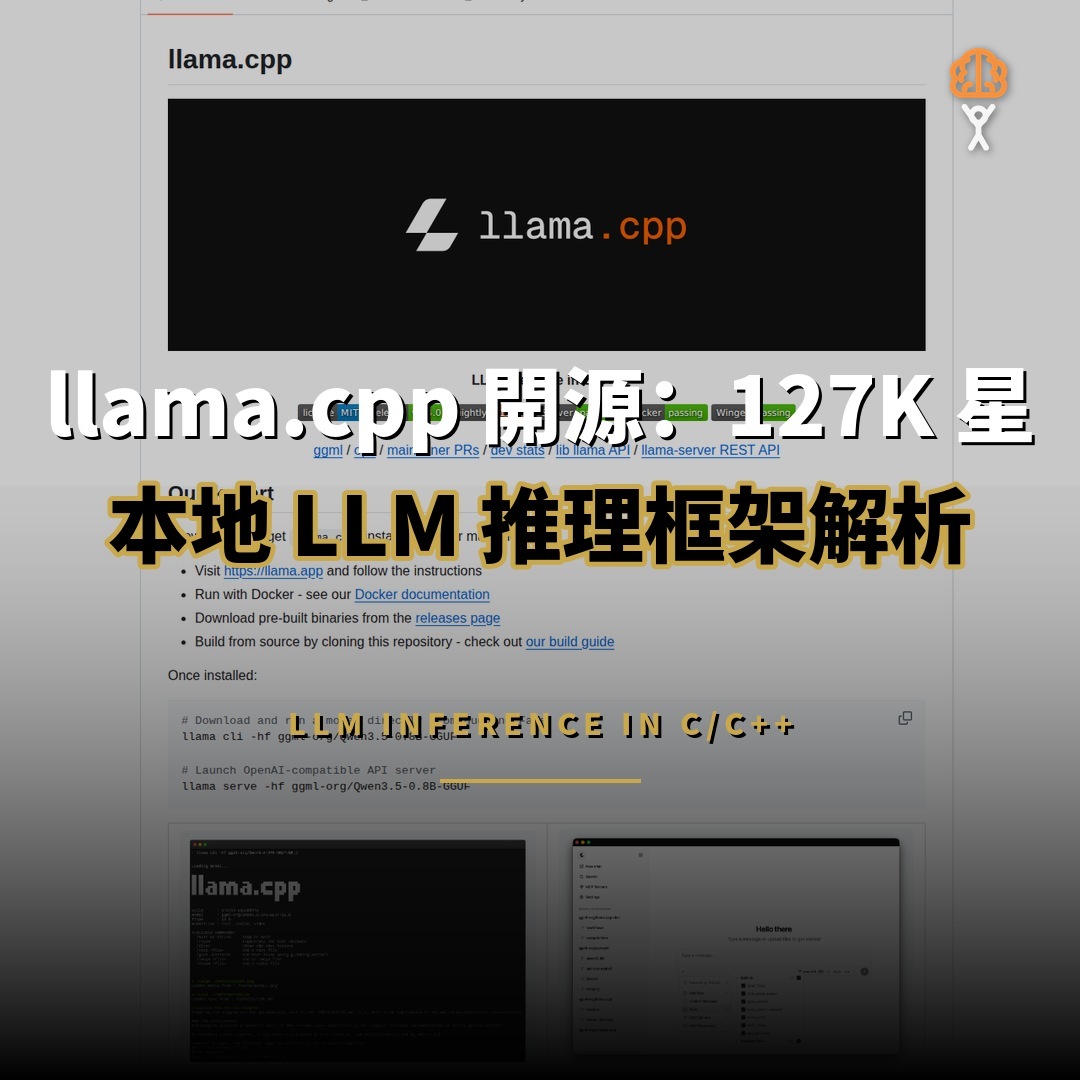
llama.cpp 是 ggml-org 開發的開源 LLM 推理引擎,以純 C/C++ 實作、零依賴,在 GitHub 獲得 126,107 顆星與 22,354 個 fork,採用 MIT 許可證。它讓大型語言模型可以在普通消費級硬件上以量化方式本地運行,並支援從 CPU、GPU 到 NPU 的完整硬件後端。
本地 AI 推理從雲端走向個人電腦,最關鍵的推動力量之一,就是 ggml-org 維護的 llama.cpp 專案。這套以純 C/C++ 撰寫的推理引擎,截至 2026 年 8 月已在 GitHub 累積 126,107 顆星,最新版本 v0.3.0 於 2026 年 8 月 25 日發佈。它證明了大語言模型可以在不需要大型資料中心的情況下,於 Apple Silicon 筆電、消費級顯示卡甚至嵌入式設備上高效運行。
llama.cpp 是什麼?
llama.cpp 是以 C/C++ 實作的開源 LLM 與 VLM 推理引擎,目標是以最少的設定步驟、在廣泛的硬件上提供頂尖性能。它不依賴任何外部函式庫,支援多種整數量化格式,並透過 ggml 張量函式庫為 CPU、GPU、NPU 等後端提供統一的運算抽象。
llama.cpp 的核心定位,是讓 LLM 與視覺語言模型(VLM)的推理,在本地與雲端各種硬件上以「最少設定、頂尖性能」運行。專案名稱源自最初為 Meta 的 Llama 模型而設計,後來逐步擴展為支援 Qwen、DeepSeek、GLM 等眾多開源模型家族的通用推理引擎。整個專案建構在 ggml 張量函式庫之上,以純粹 C/C++ 撰寫,沒有任何執行期依賴。
這套引擎最實用的部分是它的開箱即用體驗:使用者只需一條指令,從 Hugging Face 下載 GGUF 格式的量化模型,即可直接開始對話或啟動 OpenAI 相容的 API 伺服器。README 中的快速開始範例,展示了以 llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF 執行命令列對話,以及以 llama serve 啟動相容伺服器兩種用法,內建網頁介面讓使用者可以直接在瀏覽器中與模型互動。

llama.cpp 的核心技術亮點有哪些?
llama.cpp 的技術亮點包括:純 C/C++ 零依賴實作;支援 1.5-bit 至 8-bit 共七級整數量化以節省記憶體並加速推理;為 NVIDIA、AMD、Moore Threads GPU 撰寫自訂 CUDA/HIP/MUSA 核心;以及 CPU 與 GPU 混合推理,可在視訊記憶體不足時以 CPU 補充運算。
llama.cpp 的第一個技術亮點,是它的量化系統。專案支援 1.5-bit、2-bit、3-bit、4-bit、5-bit、6-bit 與 8-bit 共七級整數量化,讓模型權重以遠低於原始精度的格式儲存。4-bit 量化是實務上最常用的設定,能將數十 GB 的模型壓縮至數 GB,同時保持可接受的輸出品質,這正是消費級硬件得以運行大型模型的關鍵。
第二個亮點在於硬件加速的廣度與深度。開發團隊為 NVIDIA GPU 撰寫自訂 CUDA 核心,並透過 HIP 支援 AMD GPU、透過 MUSA 支援 Moore Threads GPU;Apple Silicon 透過 ARM NEON、Accelerate 與 Metal 框架獲得一等公民支援;x86 架構則涵蓋 AVX、AVX2、AVX512 與 AMX 指令集。此外還提供 Vulkan、SYCL、OpenCL、WebGPU 等多種後端,覆蓋幾乎所有主流運算設備。
第三個亮點是 CPU 與 GPU 的混合推理能力。當模型的體積超過顯示卡視訊記憶體總容量時,llama.cpp 可以將部分層放在 CPU 上運算,其餘留在 GPU,透過智慧排程同時使用兩邊的運算資源,讓大型模型在記憶體受限的環境中依然可以完整運行。對於單卡無法容納的模型,多 GPU 配置同樣受到支援,這項設計大幅擴展了硬件的適用範圍。

為什麼 llama.cpp 能在如此多硬件上運行?
llama.cpp 之所以能覆蓋眾多硬件,是因為它建構在 ggml 張量函式庫之上,將運算抽象為統一的張量操作;底層則針對 ARM NEON、AVX、RVV、CUDA、Metal、Vulkan 等不同指令集與框架撰寫最佳化核心,讓同一套模型格式可以無縫在不同設備間切換。
多硬件支援的根基,在於 llama.cpp 對底層指令集的細緻最佳化。在 ARM 平台上,它利用 NEON 指令與 Apple 的 Accelerate、Metal 框架;在 x86 平台,它涵蓋 AVX 到 AVX512 與 AMX;在 RISC-V 平台,則支援 RVV、ZVFH、ZFH、ZICBOP 與 ZIHINTPAUSE 等向量擴展。每一種後端都由對應領域的貢獻者持續維護,形成一個分工明確的生態。
這種設計讓同一個 GGUF 模型檔案,可以在不同設備間直接搬移使用,不需要重新轉換。使用者在家用 NVIDIA 顯示卡上跑順的模型,換到 MacBook 或支援 Vulkan 的設備上,只需重新載入即可運行。這種可攜性,是 llama.cpp 相對其他推理框架最顯著的差異之一,也是它在開源社群中被大量採用的原因。
如何快速開始使用 llama.cpp?
開始使用 llama.cpp 有四種途徑:直接造訪 llama.app 安裝桌面應用;使用 Docker 容器;下載預建置二進位檔;或從原始碼編譯。安裝後只需一條指令下載 GGUF 格式模型,即可用命令列對話或啟動 OpenAI 相容 API 伺服器。
對一般使用者而言,最簡單的途徑是造訪 llama.app 官方網站,依照指示下載桌面應用程式,無需處理編譯環境。偏好容器化的使用者可以參考 Docker 文件,在數分鐘內建立可重現的執行環境;追求穩定版本的使用者,則可直接從 releases 頁面下載預建置二進位檔,這些二進位檔涵蓋 Windows、macOS 與 Linux 主要平台。
具備開發經驗的使用者可選擇從原始碼編譯,官方提供詳細的建置指南,涵蓋 CUDA、HIP、Metal、Vulkan 等後端的啟用方式。無論選擇哪一條路徑,安裝完成後的核心用法都是一致的:以 llama cli 執行命令列對話,或以 llama serve 啟動具備網頁介面的伺服器。專案同時提供 GBNF 文法約束功能,可限制輸出格式,讓模型生成結構化 JSON 或符合特定語法的內容。
llama.cpp 的生態與影響力如何?
llama.cpp 已經成為本地 AI 生態的基礎設施:GGUF 成為事實上的本地模型格式標準,llama-server 提供 OpenAI 相容 API 作為整合橋樑,眾多桌面應用、手機應用與雲端服務皆以它為底層引擎,其影響力從個人開發者延伸到企業部署。
llama.cpp 的生態影響力,首先體現在它定義了 GGUF 這個本地模型格式標準。Hugging Face 上大量模型以 GGUF 格式發佈,使用者只需一行指令即可下載運行,這種低摩擦的模型分發方式,大幅降低了本地 AI 的入門門檻。llama-server 提供的 OpenAI 相容 API,則讓既有應用可以無痛接入本地推理,只需更換 API 端點。
在商業化路徑上,llama.cpp 以 MIT 許可證發佈,允許任何個人與企業自由使用、修改與再分發。許多桌面聊天應用、行動端推理工具與私有雲部署方案,都以它作為底層推理引擎。對獨立開發者而言,它提供了一條完全掌控資料隱私的推理路徑;對企業而言,它是成本可控、無需外送資料的本地化 AI 方案,這使得它在隱私敏感場景中特別有價值。

出處連結有哪些?
本文資訊來源為 llama.cpp 的 GitHub 儲存庫(ggml-org/llama.cpp),包括其 README、技術文件與版本發佈紀錄。讀者可前往該儲存庫查看完整的後端支援清單、建置指南與最新發展動態。
本文的原始資訊來源為 llama.cpp 官方 GitHub 儲存庫:https://github.com/ggml-org/llama.cpp。該儲存庫包含完整的 README、後端支援矩陣、建置指南、Docker 文件與 Android 建置說明,是了解此專案最權威的參考資料。版本發佈紀錄顯示最新版本 v0.3.0 於 2026 年 8 月 25 日發佈,專案仍保持非常活躍的開發節奏。
總結:llama.cpp 適合什麼團隊?
llama.cpp 適合需要本地化、低成本或資料隱私可控的 AI 推理場景:個人開發者追求在自己的設備上自由運行模型;企業需要將 LLM 部署在內網或邊緣設備;研究人員希望在消費級硬件上進行模型實驗。它以 MIT 許可證提供極高的自由度與硬件覆蓋率。
綜合來看,llama.cpp 以純 C/C++ 實作、七級量化與橫跨 CPU、GPU、NPU 的後端支援,成為本地 LLM 推理領域最具影響力的開源專案之一。12.6 萬顆星背後,是數千名貢獻者對硬件最佳化的持續投入,以及整個開源社群對「AI 不應只屬於雲端」這一信念的共同實踐。
對個人開發者而言,它提供了在自有設備上自由運行模型的完整工具鏈;對企業而言,它是以 MIT 許可證為基礎、可任意整合的本地化推理方案;對研究者而言,它是一個開放、可驗證、可擴展的實驗平台。隨著模型量化技術與硬件加速持續演進,llama.cpp 在本地 AI 生態中的基礎地位,預計還會持續強化。
