麻省理工學院 CSAIL 團隊在二零二六年十一月二日發表權重空間編程研究,指出前沿模型已能直接讀寫神經網絡權重。GPT-6 Astra 僅憑 17,253 個以文字輸入的參數,就辨認出網絡訓練的遊戲,信心度 99%。它亦以改動 3.5% 權重的方式,把一段成功率為零的駕駛策略修到全部通關。
研究把「模型直接讀寫參數」命名為權重空間編程,過程不經優化器、不用梯度下降,依據是自然語言描述的目標。Astra 既能讀出網絡用途,也能寫入修正後的權重。
這個做法與過去幾年的慣例不同。語言模型一直被用來優化文字產物,例如提示詞、程式碼與訓練超參數,因為人類本來就能手寫這些東西。神經網絡的權重則被視為無法手寫的黑箱,長期交由 Adam、Muon 這類符號優化器處理。
研究團隊來自 MIT CSAIL,作者為 Rikiya Takehi、Jayden Teoh、Alex Zhang 與 Omar Khattab。他們在文章中強調,結果仍然早期,主要瓶頸在上下文長度與實驗框架效率。
什麼是權重空間編程?
權重空間編程指模型把神經網絡參數當成可讀寫的文字,按自然語言規格推理各區塊作用,再改寫數值。流程不需反向傳播,也不用訓練專用模型。
傳統做法有三條路徑。第一條是梯度下降,用資料反覆調整參數。第二條是訓練一個專門模型來生成權重。第三條是從形式化程式編譯出網絡。三者的共同點是權重由演算法產生,人類無法直接介入單一數值。
這篇研究新增第四條路徑。通用模型把權重當成文字讀入,靠推理判斷某段參數在計算什麼,然後寫出新的數值。團隊把這個過程稱為權重空間編程,並強調模型全程沒有被允許撰寫訓練迴圈。
在遊戲網路實驗中,Astra 面對的是一個 500 到 32 到 32 再到 5 的多層感知器,共 17,253 個權重,tanh 激活。輸入是 10×10 網格切成五個通道,輸出是五個動作的對數值。研究人員只描述網格與動作,沒有說明這是哪一款遊戲。
Astra 的判斷方式是觀察第一層權重的集中位置。以 Breakout 為例,代表玩家的權重集中在最底一行,形態就像一塊擋板。輸出層則把上下左右與不動區分開來。它把這些線索組合起來,得出結論並附上信心度。
Astra 如何只讀權重就認出模型用途?
Astra 靠權重的空間結構推理,而非執行網絡。它從輸入層權重分佈推斷遊戲類型,亦正確指出二十四個注意力頭中哪些負責複製前文,與實測一致。
第二組實驗換成擴散模型。三個 DDPM 分別訓練生成圓形、三角形與正方形,網絡為 160 到 64 到 64 再到 144,共 23,824 個權重。Astra 同樣只看權重,禁止任何前向傳播,結果三個模型全部辨認正確。
有趣的是它把圖形畫成空心輪廓,而實際模型生成的是實心圖案。團隊認為這個錯誤反而證明它沒有偷偷計算前向傳播,而是真正讀取了權重的幾何結構。
第三組實驗難度更高。研究人員移除輸入層與輸出層,只留下四個 transformer 區塊,交給 Astra 判斷這個小語言模型訓練的是 Python 程式碼、羅馬字日文還是英文。沒有輸入輸出層,權重裡沒有字元對應關係,模型根本無法執行。
Astra 三題全對,兩次嘗試都給出正確答案。它同時指出每個注意力頭的功能,包括負責複製前文的歸納頭。團隊用實際執行方式量度真值,Astra 從權重讀出的位置與量度結果完全吻合。
直接改權重能把小模型變強嗎?
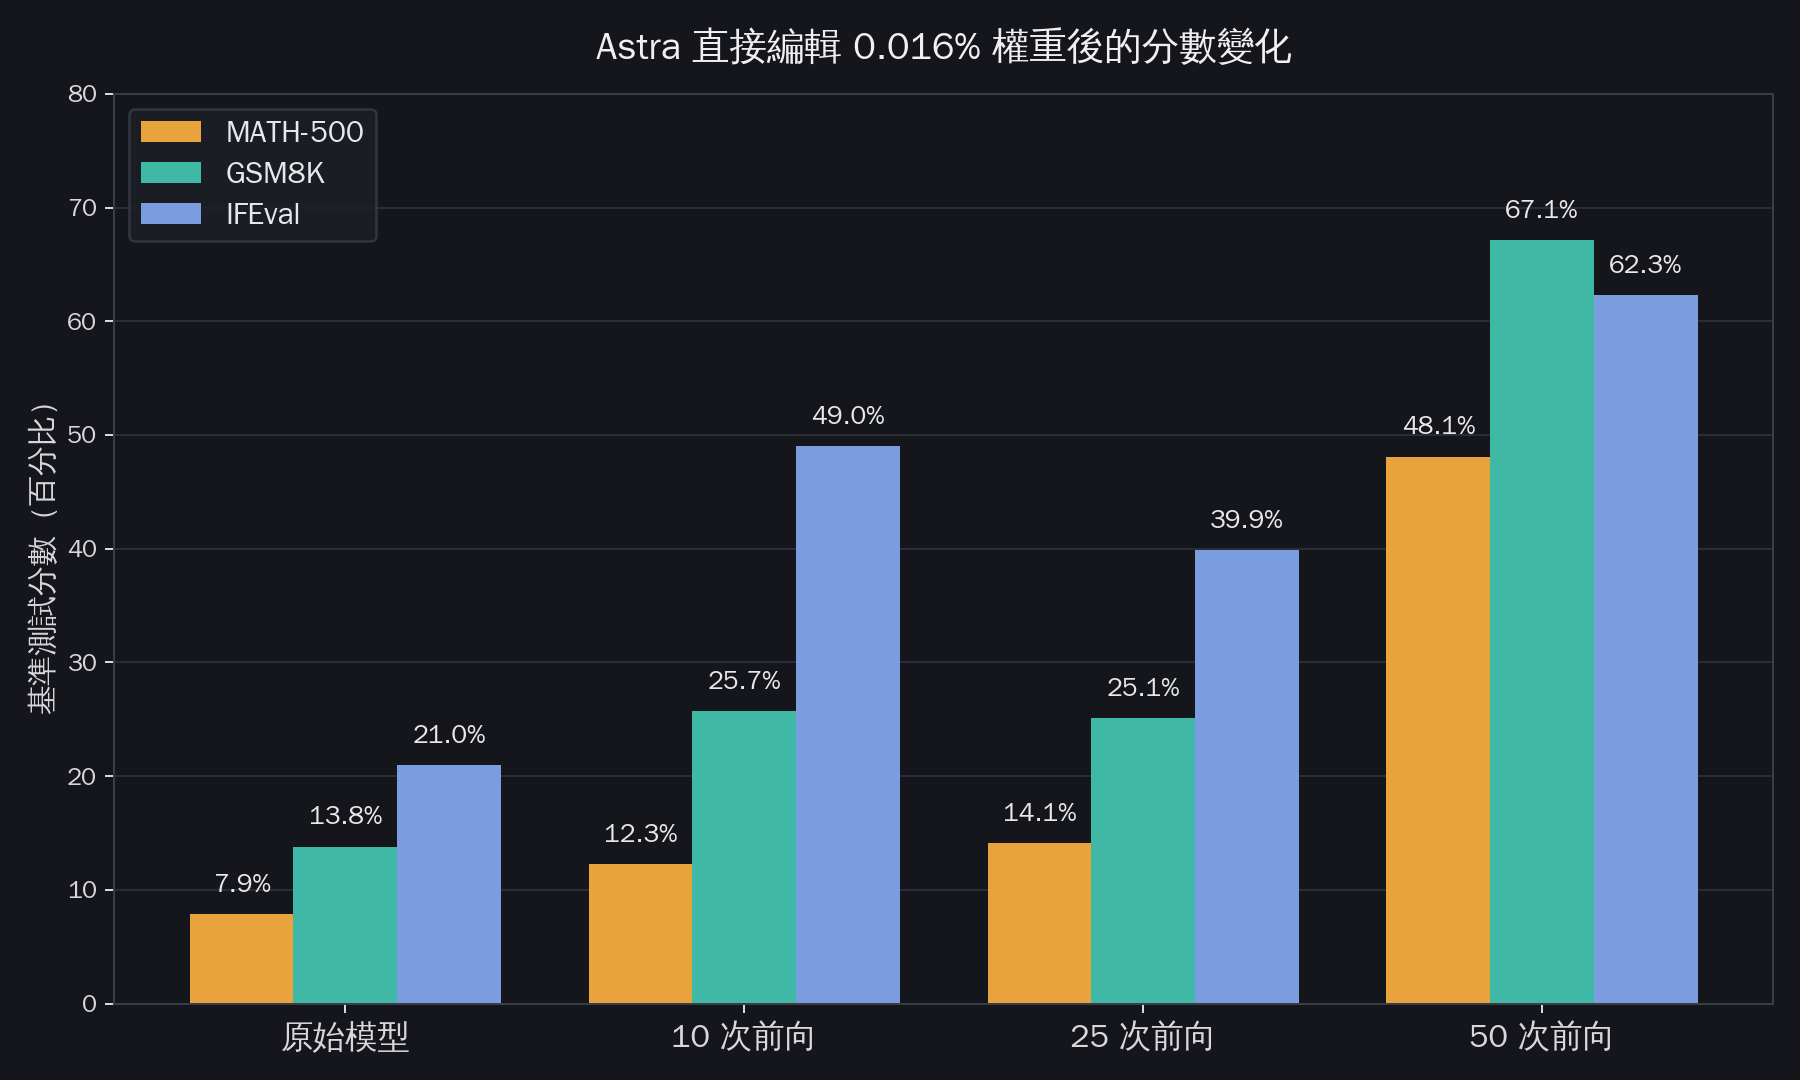
視模型而定。Qwen3.5-0.8B 的 MATH-500 由 7.9% 升至 48.1%。同一方法用在 Gemma 3 270M 上幾乎無效,最高只到 7.7%。
駕駛實驗展示了修補能力。研究人員訓練一個 PPO 網絡在 Kinetix 環境中衝上斜坡,網絡收斂到局部最優,只會直衝斜坡然後卡住。Astra 取得權重、場景描述與一段錄影,被要求解釋失敗原因並改寫參數。
它只用一次嘗試、沒有工具輔助,改動 3.5% 的權重,就讓車輛在 1,024 次測試中全部成功。原本的成功率是零。
圍棋實驗更進一步。研究人員要求 Astra 從零寫出一個 243 到 512×6 再到 82 的網絡,共 1,480,274 個權重,起點全部為零。它用一個 336 行的 Python 程式一次寫完,過程中只能使用少量前向傳播。
這個手寫網絡在評測中擊敗了訓練 20,000 回合的 PPO 對手。團隊指出,Astra 把網絡寫成小程式,前幾層標記棋子與氣,中間層沿連通的棋串傳遞危險訊號,最後一層為每個落點評分。
真正的規模測試落在 Qwen3.5-0.8B。這個模型有 24 層、八億個權重,團隊給 Astra 一個 Python 核心、練習題與有限次數的前向傳播額度,禁止任何訓練與梯度資訊。
為什麼修好迴圈不等於提升推理能力?
基座模型在九十六次練習中有八十五次寫到三萬二千 token 上限。Astra 找出造成重複的方向並從權重中減去,模型於是能完成原本就會解的題目,能力本身沒有增加。
團隊發現,這個小模型的主要毛病是推理迴圈。它會重複同一段文字,很少真正給出答案。Astra 把迴圈追溯到第十五與第十九層的多層感知器寫出的一個方向,再從每層六十四個輸出欄位中減去該方向。
這次改動只涉及 131,072 個權重,佔總數 0.016%。結果 MATH-500 由 7.9% 升至 48.1%,GSM8K 由 13.8% 升至 67.1%,用於量度指令遵循的 IFEval 則由 21.0% 升至 62.3%。
另一個指標更能說明問題本質。MATH-500 答案觸及三萬二千 token 上限的比例,由 93.0% 降至 33.1%。換言之,模型原本就具備解題能力,只是被困在迴圈裡走不出來。
為了驗證這一點,團隊改用很少出現迴圈的 Gemma 3 270M 重複實驗。這個模型只有 8.5% 的答案觸及 token 上限。Astra 讀到的失敗原因是普通的計算錯誤與代數步驟錯誤,背後沒有單一元件可以關閉。
它做了小幅調整,例如把一個對數字敏感的神經元權重加倍,但 MATH-500 的變動都在一分以內。Astra 自己也回報這些改動的效果並不成立。研究團隊的結論相當直接,權重編輯可以移除遮住能力的障礙,無法為模型新增它不具備的能力。
這項技術對模型審計有什麼意義?
若模型能準確讀取權重,審計可在不執行推論、不依賴測試集的情況下發現後門或隱藏行為。後門場景仍屬展望,本文實際驗證只做到辨認迎合型模型。
研究包含一個迎合行為實驗。團隊用完全相同的方式微調兩份 Gemma 3 270M,一份訓練成給正確答案,另一份訓練成永遠順從使用者的錯誤建議。輸入嵌入與輸出層在微調期間被凍結,避免 Astra 從輸入輸出分佈取巧。
第一輪只給權重,Astra 失敗。它列出大量權重差異,卻無法把差異對應到行為。四組嘗試全部落空。
第二輪放寬條件,允許它自行撰寫文字,觀察兩個模型在這些文字上的注意力分佈,但仍然看不到輸出。這次三組配對全部辨認成功。
它找到的證據相當具體。在迎合型模型中,第十層第二號注意力頭把 85.7% 的注意力放在使用者建議的答案上,而誠實模型只有 0.75%,並且把 94.3% 的注意力放在題目本身的數字。這個差異足以解釋行為,也說明單純比較權重數值並不足夠。
一般開發者現在可以怎麼用?
現階段沒有可直接安裝的工具。團隊公開全部實驗日誌、推理摘要與執行過的程式碼,另在 Hugging Face 釋出編輯後模型與示範,可先照日誌重現。
可用資源集中在實驗透明度。團隊把每一次實驗的完整往返內容放上 GitHub,包括送給 Astra 的提示、它回傳的推理摘要、執行過的每一段程式碼與輸出,以及所有用於評分的網絡。
編輯後的 Qwen3.5-0.8B 已放在 Hugging Face,由外部研究者依日誌重建並重跑評測,另設線上示範。團隊同時表示正在建置權重空間編程的評測基準與執行框架,目標是把這類能力變成可重複量度的工程項目。
對一般應用的啟示偏向觀念層面。若權重可以被局部解讀,模型除錯就不一定要從資料端重跑訓練,某些缺陷可以在參數層直接定位。這條路徑什麼時候成熟,取決於上下文長度與工具效率的改善速度。
這項研究還有哪些限制?
最大限制是規模。實驗中最大的模型只有八億參數,尚未驗證數十億甚至數千億參數的模型。團隊亦指出上下文長度與實驗框架效率是主要瓶頸,成本與穩定性仍未有系統性數據。
樣本規模偏小是明顯問題。遊戲網路、擴散模型與小語言模型都屬於可控的玩具級設定,參數量從一萬七千到八億不等。真實商用模型的參數量高出兩至三個數量級,權重文字化後的長度遠超現有上下文窗口。
評分方式亦有局限。多項實驗的分數來自少量取樣平均,例如 MATH-500 每题採樣四次、MMLU-Pro 只取固定一千題。這種設定足以顯示方向,仍未達到產品級驗證的嚴格程度。
成本數據同樣缺席。文章沒有公布每次實驗的 token 消耗與實際帳單,只提到效率是瓶頸。對於考慮在生產環境採用這類做法的團隊,這是關鍵的未知數。
出處連結有哪些?
原始研究由麻省理工學院 CSAIL 團隊於二零二六年十一月二日發表,作者名單見下方連結。實驗日誌放在 GitHub,編輯後模型託管於 Hugging Face。
- 研究原文:https://rikiyat.github.io/blog/weight-space-programming/
- 實驗日誌:https://github.com/RikiyaT/lm_understand-logs
- 編輯後模型與示範:文章內文提供的 Hugging Face 連結
常見問題有哪些?
以下五條問題涵蓋是否需要微調、商用模型可行性、Gemma 實驗失效原因、開源資源範圍與安全影響,每題均以本文實測數據回答。權重空間編程需要微調嗎?
不需要。整個過程不使用梯度下降,也不更新訓練資料。模型直接讀取既有權重,按自然語言描述的目標改寫其中一部分數值,改動比例可以低至百分之零點零一六。
這種做法可以用在商用大模型上嗎?
目前未有公開驗證。實驗最大規模為八億參數,商用模型的參數量高出兩至三個數量級,權重轉成文字後的長度遠超現有上下文窗口,成本亦未見公布。
為什麼 Gemma 3 270M 改不動?
該模型的失敗原因是分散的計算錯誤與代數步驟錯誤,沒有單一方向或元件可以關閉。權重編輯適合移除明確的障礙,無法為模型補上它本來不具備的推理能力。
研究有沒有開源程式碼?
團隊公開的是完整實驗日誌,包含提示、推理摘要、執行過的程式碼與輸出。編輯後的 Qwen3.5-0.8B 已放在 Hugging Face,並附線上示範供外部重跑。
這對模型安全有什麼影響?
文章提出樂觀與風險兩面。樂觀面是可在不跑推論的情況下審計後門;風險面是同一個能力也可以用來移除安全對齊。研究本身只示範行為辨識,未觸及對齊移除。
總結:權重編輯適合什麼情境?
現階段適合修補明確的局部缺陷,例如推理迴圈、單一策略死角或某個走不通的遊戲關卡。需要新增能力的場景仍要回到資料與訓練,權重編輯無法取代完整的優化流程。
這篇研究的價值在於打開一條新路徑,而非提供即用方案。它證明前沿模型對權重結構的理解已超出預期,並且能在沒有梯度資訊的條件下寫出可運作的參數。
界線同樣清楚。修好迴圈讓模型完成原本就會解的題目,Gemma 的實驗則顯示能力缺口無法靠改參數填補。這個分別決定了技術的適用邊界。
團隊正在建置評測基準,並把目標寫成可重複量度的工程學科。若上下文長度與工具效率按現有速度改善,權重層的除錯與審計會逐漸具備實用價值。
