Scrapy 是 Python 生態中歷史最久的網頁爬取框架之一,在 GitHub 累積 64,805 顆星標與 12,001 次複製。2026 年 9 月 10 日發布的 2.19.0 版本新增 RemoteControl 擴充功能與官方 MCP 伺服器,讓 AI 編碼代理可以連接本機正在執行的爬取任務,讀取統計數據、檢查排程器狀態並診斷效能問題。這個自 2010 年建立、長期由 Zyte(前稱 Scrapinghub)與社群共同維護的專案,因此直接接上當前的代理工作流程。本文整理其架構設計、版本演進、維護模式、安裝方式與授權條款。
Scrapy 是什麼?
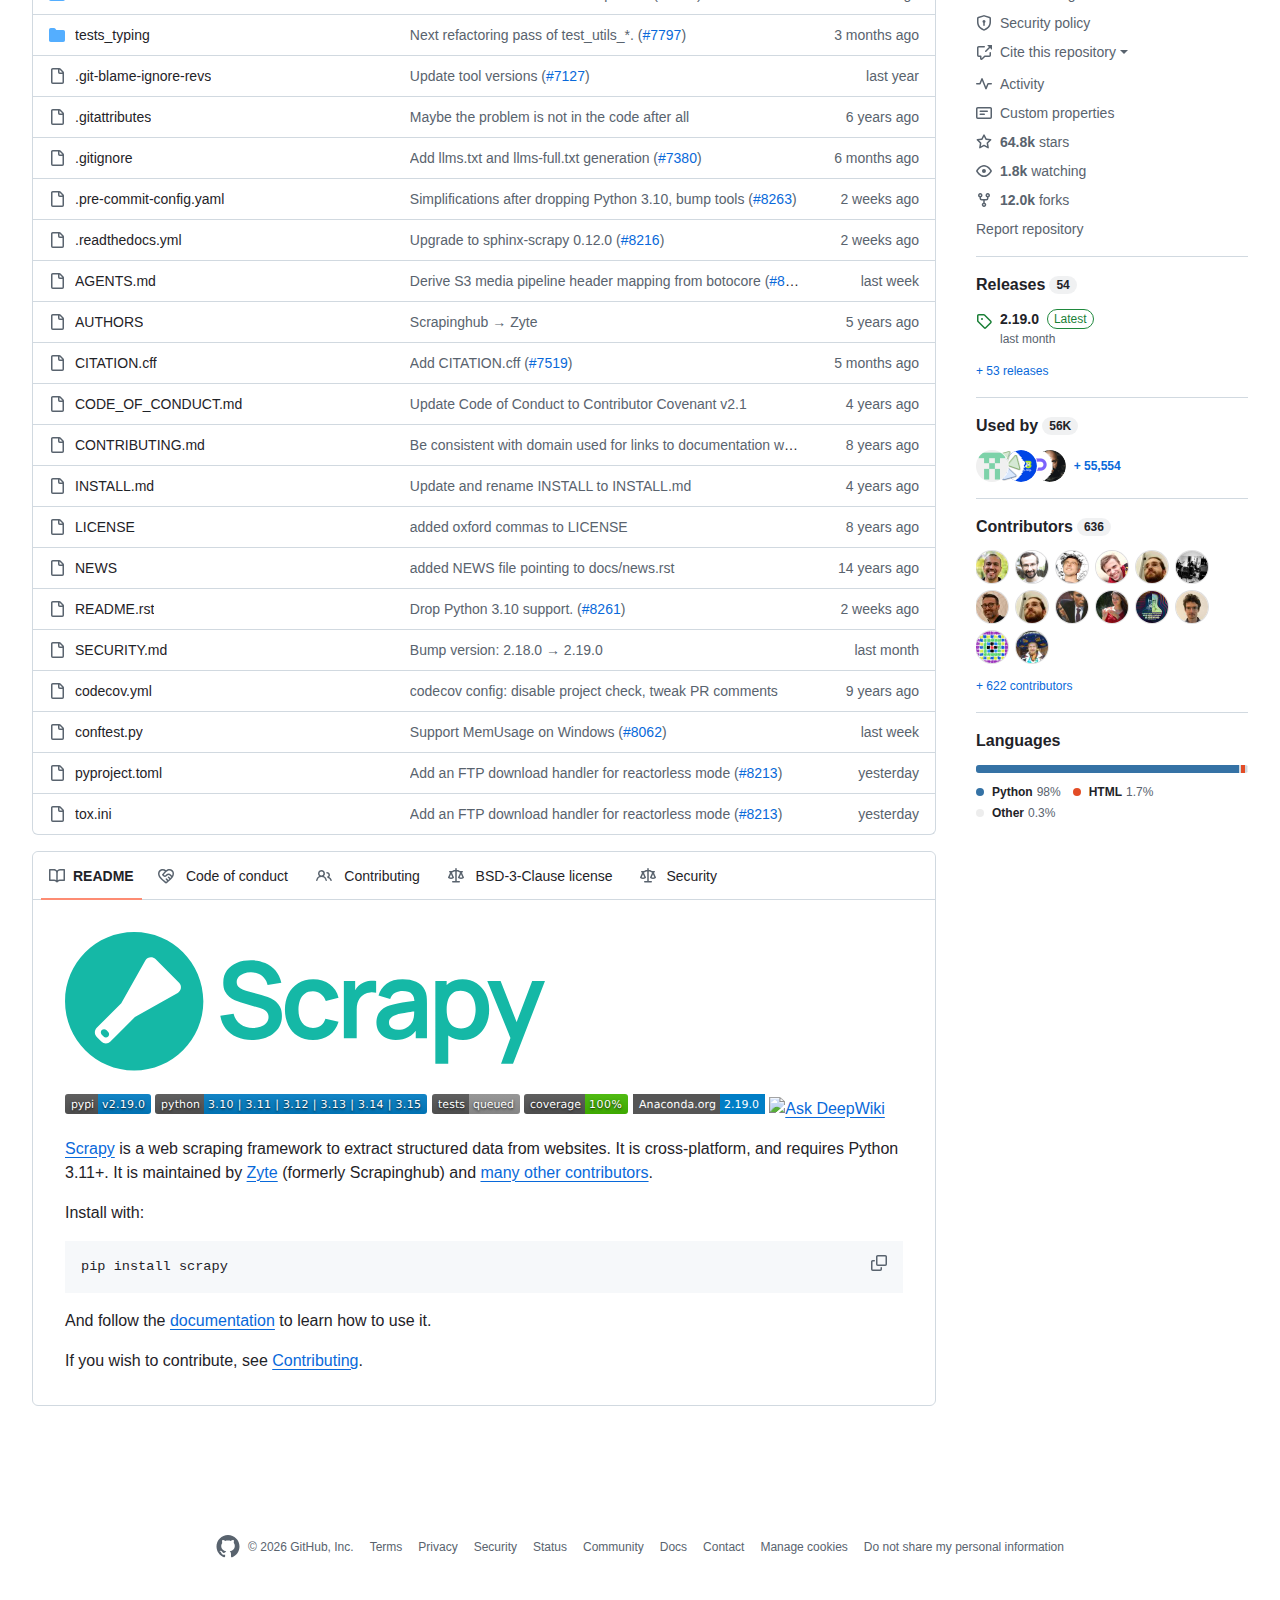
Scrapy 是一套以 Python 撰寫的開源爬取框架,能把網頁內容轉換為結構化資料,內建請求排程、選擇器、資料管線與中介軟體機制,並以 BSD 三條款授權釋出。
它是一套跨平台的爬取框架,核心工作是把非結構化的網頁內容轉換成可用的結構化資料。使用者以 Python 定義蜘蛛(Spider),描述起始網址與解析規則;框架接手排程請求、控制並行數量、重試失敗連線,並把擷取結果交由資料管線清洗與輸出。專案以 BSD 三條款授權釋出,原始碼公開於 GitHub,由 Zyte 與社群貢獻者共同維護。
定位上,它處理的是「如何穩定地把一批網站抓下來」,而不是單次抓取某個頁面。這使得它同時被用在資料工程、價格監控、學術研究與搜尋索引建置等場景,也讓專案的更新節奏長期圍繞著網路層的相容性與效能。
Scrapy 2.19.0 帶來哪些主要變化?
2.19.0 新增 RemoteControl 擴充功能,可透過 HTTP 檢視與控制執行中的爬取任務,並附上官方 MCP 伺服器,同時把 aiohttp 下載處理器設為預設。
官方版本說明指出,2.19.0 的核心新增項目是 RemoteControl 擴充功能,用來在爬取進行期間從外部檢視與控制任務。這項擴充功能同時是官方 MCP 伺服器的底層依賴,後者已在文件中獨立成章節「Using Scrapy with coding agents」。另一項變化與網路層有關:以 aiohttp 為基礎的下載處理器結束實驗階段,在未啟用反應器(reactor)的執行模式下成為預設選項。
這兩項調整指向同一個方向。爬取任務多半長時間執行,中途出錯的原因往往藏在執行時狀態而非程式碼本身;把內部狀態以標準介面開放出來,既能餵給除錯工具,也能餵給代理。
Scrapy 的 MCP 伺服器可以替 AI 代理做什麼?
官方 MCP 伺服器連接啟用 RemoteControl 的本機爬取任務,讓 AI 代理查看進度、找出變慢原因、檢視請求與輸出落差,並追蹤執行狀態隨時間的變化。
官方文件列出 MCP 伺服器可完成的幾類工作。第一類是進度掌握,代理可讀取統計數據的當前值,必要時直接檢查排程器這類核心物件。第二類是效能診斷,例如調查爬取為何變慢、為何發出請求卻沒有產出項目,做法是同時檢視執行時狀態、設定值與原始碼。第三類是記憶體與除錯,文件建議在同一段請求中以 asyncio.sleep 讀取兩次狀態,藉此觀察統計數據或佇列長度隨時間的變化。
安裝層面,官方另外提供一個代理外掛,指向外掛儲存庫即可讓編碼代理取得建置與排錯蜘蛛的技能,並自動配置 MCP 伺服器連線。這代表代理輔助開發已成為專案正式支援的使用情境,而非社群自行拼湊的旁支。
Scrapy 的核心架構有哪些組成部分?
架構由引擎、排程器、下載器、蜘蛛與資料管線組成,各元件透過中介軟體與訊號銜接,因此不需修改核心即可替換下載處理器或擴充輸出格式。
官方架構文件把系統拆成數個可替換的元件。引擎負責在各元件之間傳遞資料流,排程器管理待抓取的請求佇列,下載器執行實際的網路請求,蜘蛛定義解析邏輯,資料管線則負責清洗、驗證與輸出。選擇器模組處理 HTML 與 XML 的節點定位,讓解析規則可以寫得精簡。
擴充性建立在幾個掛載點上。下載器中間軟體可在請求送出與回應抵達前後介入,常見用途是換代理、改標頭或處理重試;蜘蛛中間軟體處理進入與離開解析函式的項目;擴充功能則掛上訊號,用於統計、日誌與遠端控制。2.18.0 起,項目匯出器改為依欄位宣告順序輸出,讓輸出格式更可預期。
Scrapy 近期的版本演進有哪些重點?
近四個版本集中更新下載層:補上 HTTP/2 與 SOCKS 代理支援、改用 httpx2、讓 brotli 與 Zstandard 成為內建能力,並修補安全性問題。
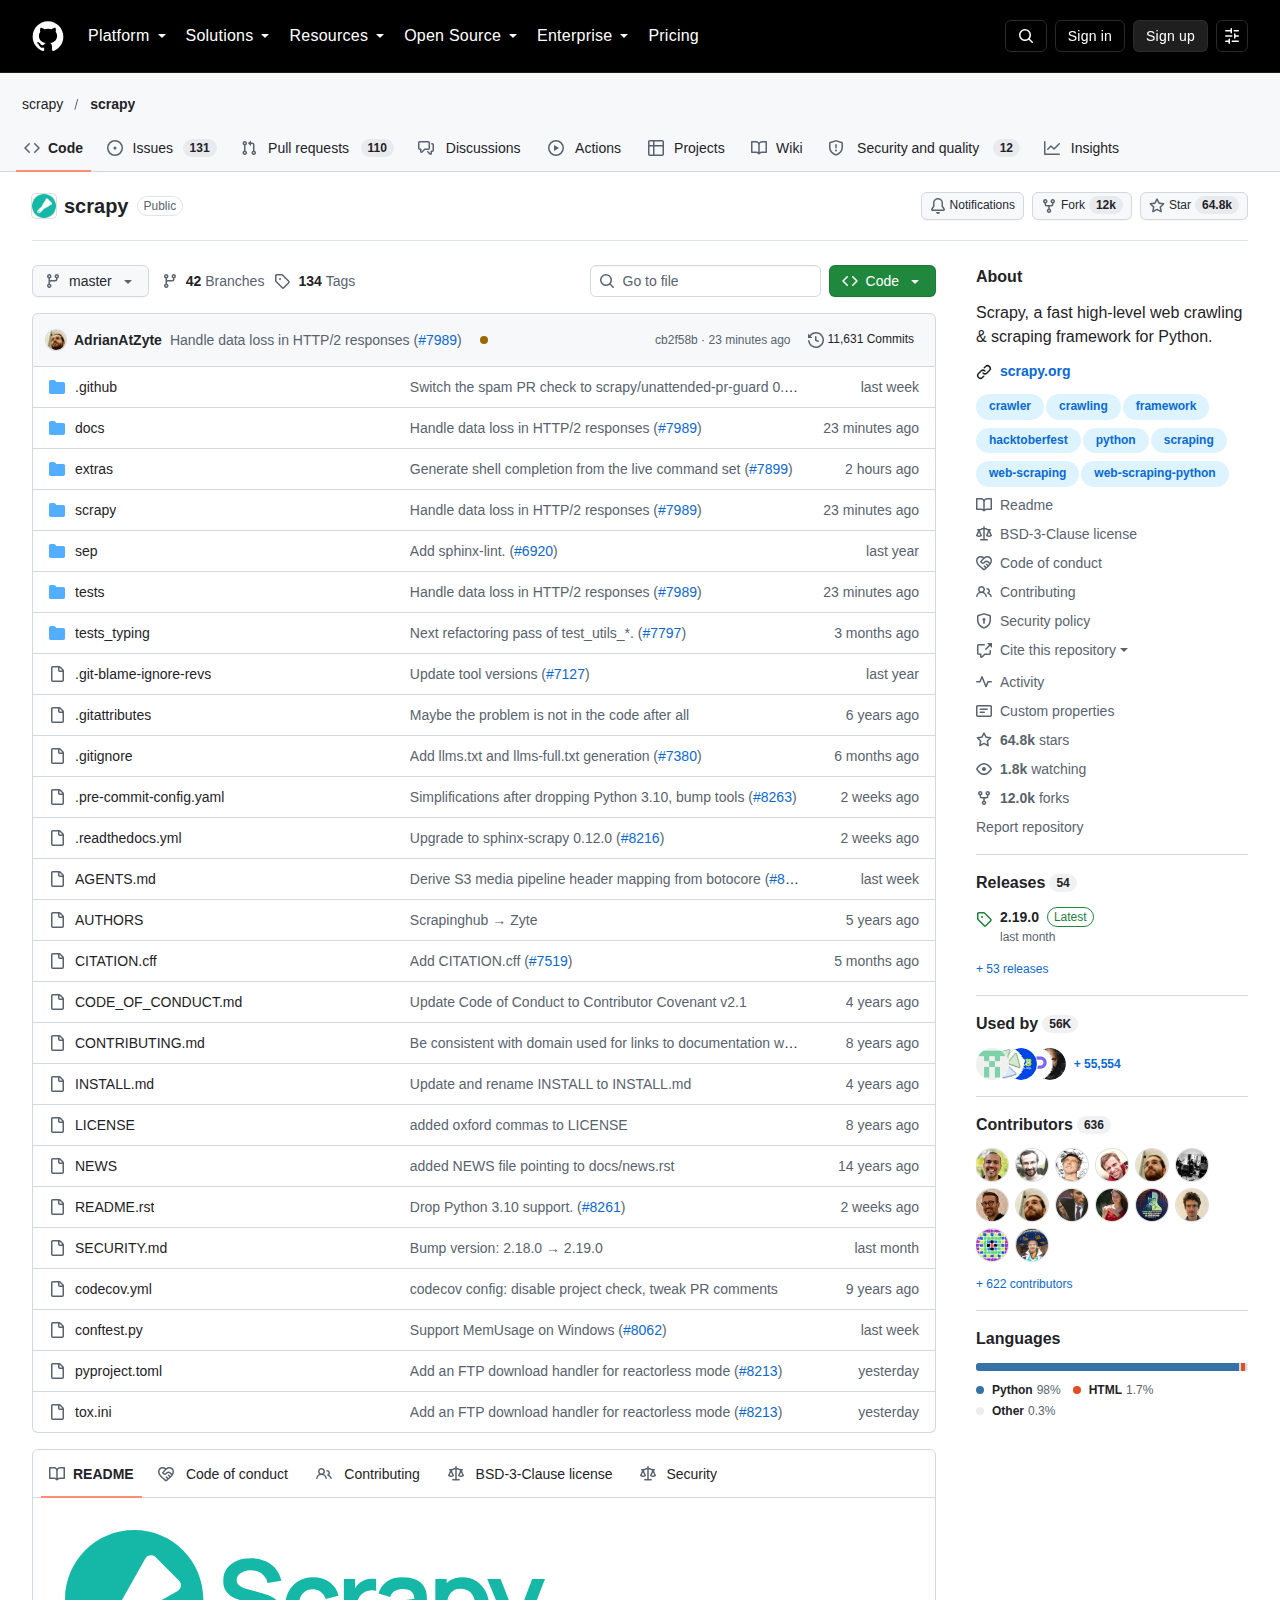
2.16.0 在 2026 年 5 月發布,重點是支援 Python 3.14 與較新的 Twisted 版本,屬於基礎相容性更新。2.17.0 於 7 月發布,內容包含安全性修正、為 httpx 下載處理器補上 HTTP/2 與 SOCKS 代理支援,並改進可允許 TLS 版本的設定方式。這一批修正的價值在於讓框架能配合持續收緊的網站傳輸設定。
2.18.0 於 8 月發布,把 Twisted 的 HTTP/2 下載處理器移出實驗階段,改用 httpx2,並讓 brotli 與 Zstandard 壓縮支援成為常態可用。同期加入的 MetaCopyDetectionMiddleware 用於辨識內容抄襲,項目匯出器也改為依宣告順序輸出欄位。9 月的 2.19.0 則把重心移回可觀測性與代理整合,形成一條從網路層走向執行時診斷的更新路徑。
Scrapy 的維護模式與生態現況如何?
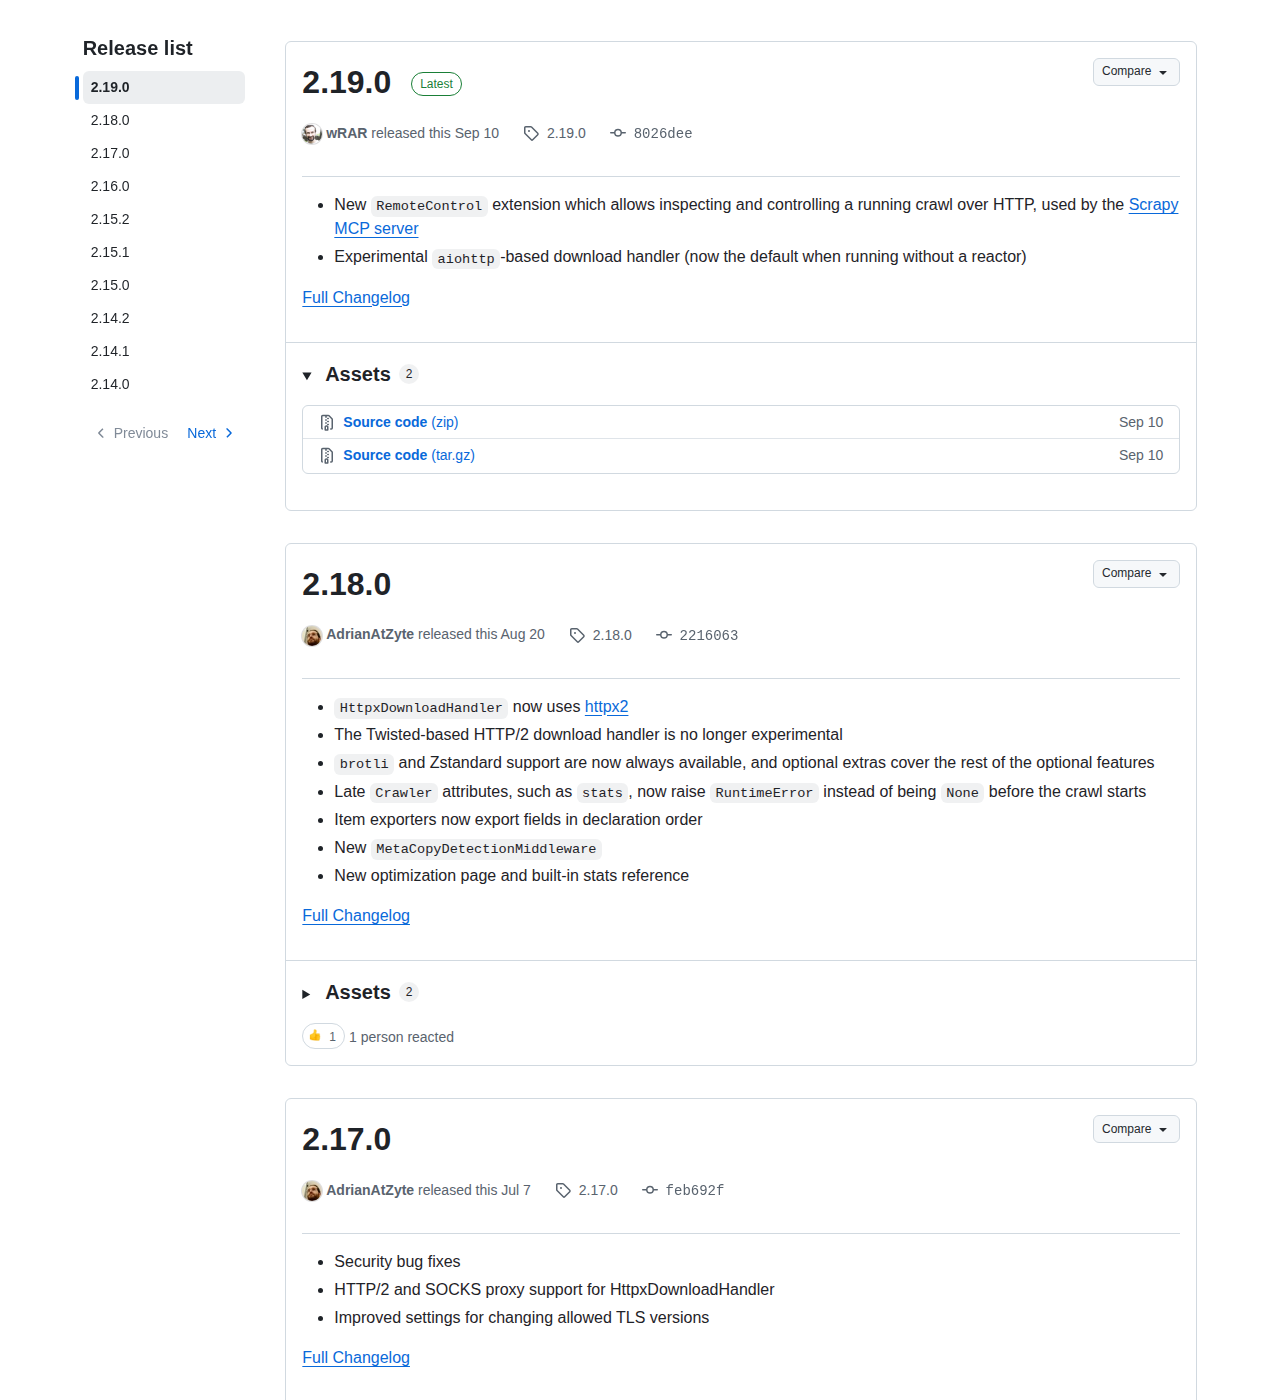
專案由 Zyte 與社群共同維護,累積 64,805 顆星標、12,001 次複製與 1,756 位觀察者,貢獻者名單超過七百人,未結議題維持在兩百餘個。
專案的維護責任由商業公司與社群分擔。Zyte 前身為 Scrapinghub,是長期的維護方,官方 README 同時指向一份貢獻者名單,並以「many other contributors」描述社群的規模。提交紀錄顯示,單一貢獻者累積提交數最高超過兩千次,前八名貢獻者的提交數合計接近八千次,說明專案已形成穩定的核心維護群。
採用面的訊號同樣具體。專案有 12,001 次複製與 1,756 位觀察者,未結議題約 241 個;從 GitHub 匿名統計可見超過七百名貢獻者曾留下提交,反映的是十餘年累積的參與基數,而非單一企業的內部專案。2.19.0 的發布頁面亦維持完整的版本紀錄,方便使用者評估升級風險。
Scrapy 如何安裝並開始第一個爬取任務?
可透過 pip 或 conda-forge 安裝,官方建議使用虛擬環境;以 startproject 建立專案並用 genspider 產生蜘蛛後即可執行爬取。
官方安裝文件列出兩條路徑:以 pip 安裝,或使用 Anaconda 與 Miniconda 從 conda-forge 通道安裝,後者在 Linux、Windows 與 macOS 都有維護中的套件。文件建議在虛擬環境中安裝,避免與系統套件互相干擾,並提醒部分作業系統需要額外的前置套件。
開始流程分成三步。先用 scrapy startproject 建立專案骨架,接著以 scrapy genspider 產生蜘蛛範本,填入起始網址與解析規則後執行 scrapy crawl 啟動。開發期間可用互動式 shell 載入頁面並逐句測試選擇器,減少反覆執行完整任務的成本。若要搭配編碼代理,官方建議改為指向外掛儲存庫安裝,由外掛負責配置 MCP 連線。
# 安裝
pip install scrapy

# 建立專案並產生蜘蛛
scrapy startproject myproject
cd myproject
scrapy genspider example example.com

# 執行爬取
scrapy crawl example -o output.json
Scrapy 常見問題有哪些?
以下整理 Scrapy 與其他爬取工具的差異、動態網頁的處理方式,以及商業專案使用時的授權與合規考量等常見疑問。
Scrapy 與其他爬取工具的主要差異是什麼?
差異在於它是完整框架而非單一函式庫。請求排程、並行控制、重試策略、資料管線與輸出格式都已內建,使用者只需描述抓取規則;代價是需要理解各元件的分工,學習曲線比單檔腳本高。對於一次性抓取少量頁面的任務,輕量工具通常更直接。
Scrapy 能處理需要 JavaScript 渲染的網頁嗎?
它本身不執行瀏覽器。官方文件另有章節說明如何配合瀏覽器的開發者工具分析請求,並提供處理動態載入內容的做法,常見方式是找出頁面背後的資料介面直接請求。若必須完整渲染,則需搭配外部瀏覽器服務或代理層,並自行控制成本。
商業專案使用 Scrapy 需要注意什麼?
授權層面相對寬鬆。專案以 BSD 三條款釋出,允許商用與修改,只需保留版權聲明。真正的風險落在抓取行為本身:網站的服務條款、robots 規範、個人資料保護法規與資料庫權利都可能限制可抓取的範圍與用途,商用前應先完成合規評估。
出處連結有哪些?
本文資訊整理自 Scrapy 的 GitHub 儲存庫、官方文件與 PyPI 套件頁面,涵蓋版本紀錄、架構說明、代理整合章節、安裝指引與授權條款。
- GitHub 儲存庫:https://github.com/scrapy/scrapy
- 官方文件:https://docs.scrapy.org/en/latest/
- 代理整合說明:https://docs.scrapy.org/en/latest/topics/agents.html
- 版本紀錄:https://github.com/scrapy/scrapy/releases
- PyPI 套件頁面:https://pypi.org/project/Scrapy/
總結:Scrapy 適合什麼團隊?
適合需要長期維運、規模化抓取與資料管線整合的技術團隊;若專案大量依賴瀏覽器渲染或需要現成商業支援,則須額外評估搭配方案。
Scrapy 的價值在於把變動頻繁的網路層與解析邏輯分開,並以可替換元件承接差異。64,805 顆星標、超過七百名貢獻者與十五年的提交紀錄,反映的是一套被長期維運的框架,而不是追逐單一技術熱潮的專案。
2.19.0 的 MCP 伺服器則說明另一件事實:在代理輔助開發成為主流工作方式之後,成熟工具選擇開放執行時狀態,讓代理直接參與除錯,而不是另建一套平行的工具鏈。對需要穩定抓取流程的團隊而言,這是值得追蹤的方向;對只想快速抓取少量頁面的使用者,輕量工具仍然是更合理的起點。
