PDFMathTranslate 於二零二四年九月開源,截至二零二六年十一月一日累積 38,100 顆星標、3,419 次分叉,是學術 PDF 翻譯領域最具規模的開源專案。它把版面偵測與機器翻譯串成單一流程,讓公式、圖表、目錄與註解留在原本位置,只把正文換成目標語言。
PDFMathTranslate 是什麼?
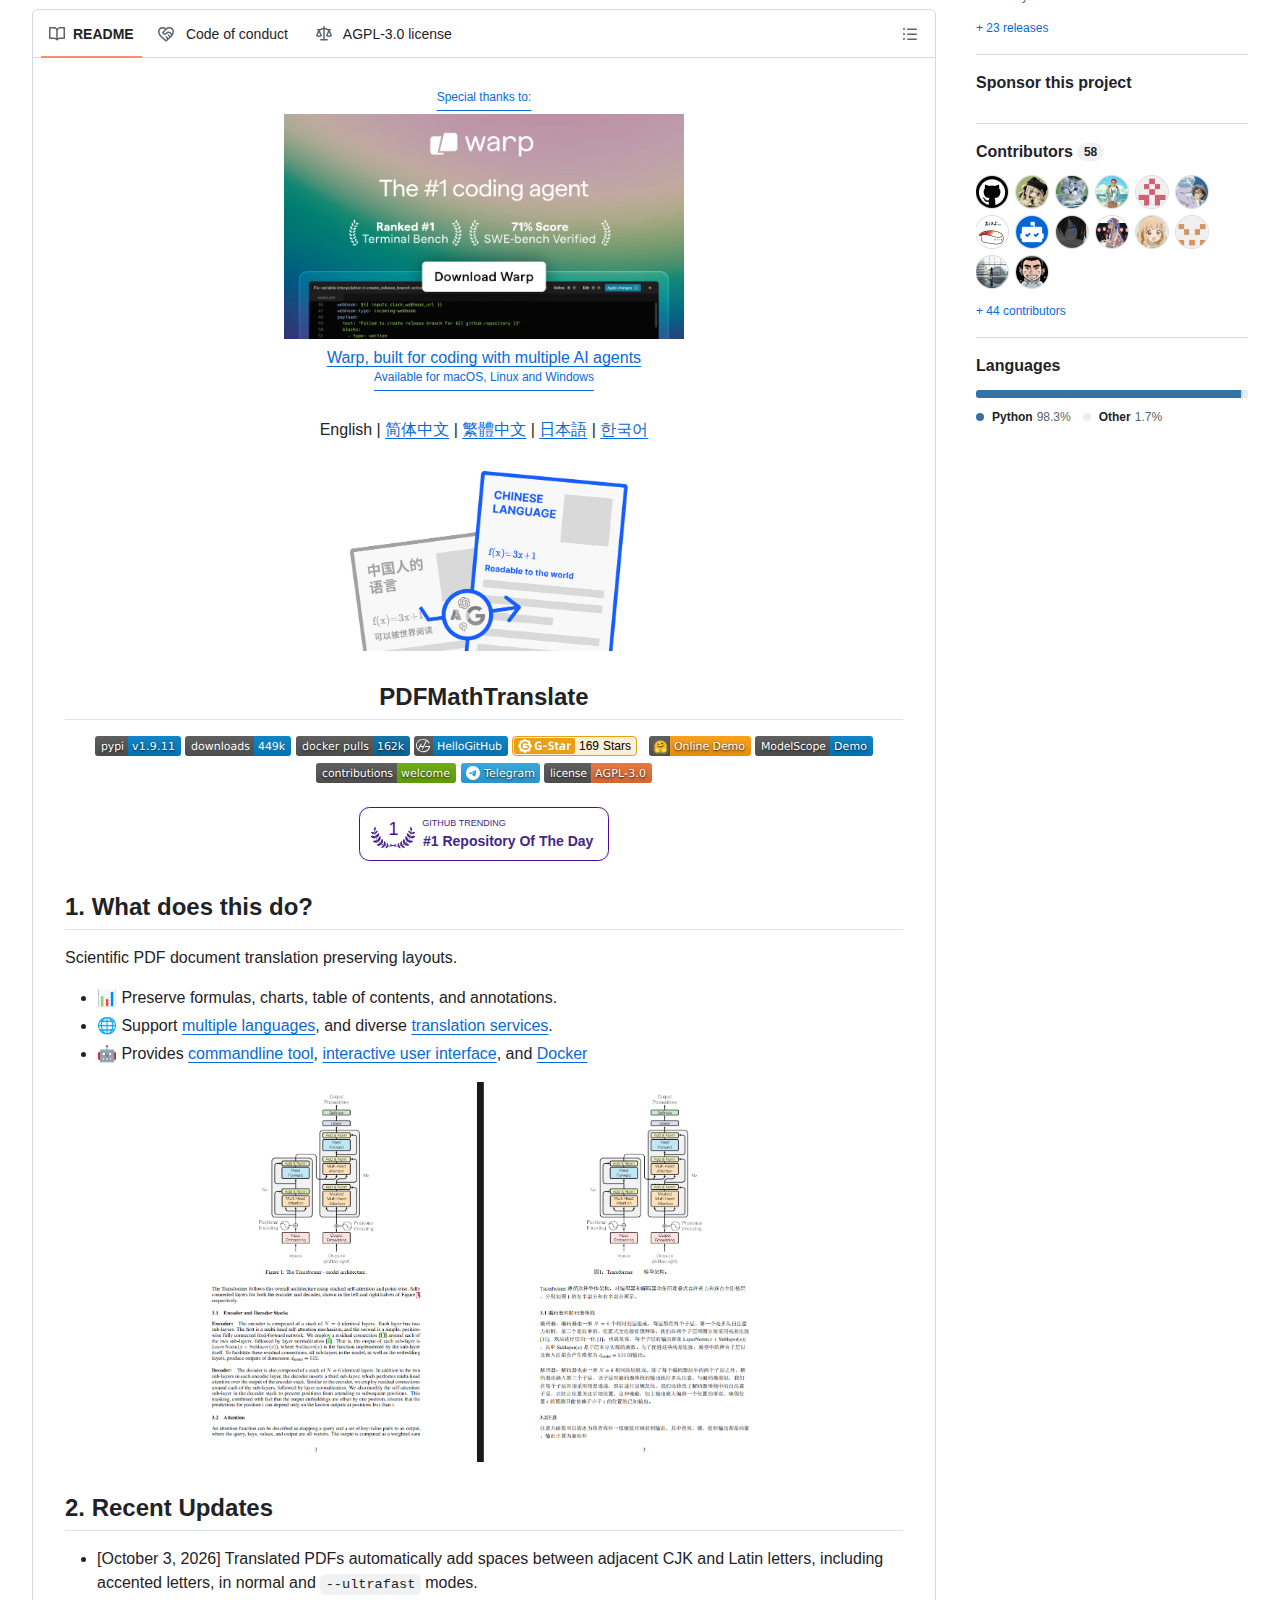
PDFMathTranslate 是保留版面的科學 PDF 翻譯工具,以 pdf2zh 套件發佈。它先偵測公式與段落區塊,再把譯文回填原位置,輸出單語與雙語兩份 PDF。
專案在 README 的自我定位相當直接:保留公式、圖表、目錄與註解的科學文件翻譯。它並非把 PDF 轉成純文字再重新排版,而是先理解頁面的幾何結構,再逐區塊替換文字內容。這種做法讓譯稿與原稿在視覺上幾乎一致,讀者翻頁時不會失去原本的閱讀位置感。
工具以 Python 撰寫,採 AGPL-3.0 授權,主要套件名稱為 pdf2zh。學術背書同樣明確:該專案獲 EMNLP 2025 系統演示環節收錄,論文編號為 aclanthology 的 emnlp-demos.71,頁次 918 至 924,作者為 Ouyang、Chu、Xin 與 Ma 四人。論文摘要提到,先前的翻譯工作大多忽略版面資訊,而該專案是首個以此為核心的開源軟體。
為什麼學術 PDF 翻譯容易破壞版面?
學術 PDF 的文字、公式與圖表是獨立繪製物件。一般翻譯流程取出文字後重新排版,公式與圖表便失去對應座標,雙欄結構與註腳也會錯位。
多數 PDF 並非由文字流構成,而是由繪製指令堆疊而成。一行文字的每個字元可能各自帶有座標,一個數學公式往往由數十個獨立字形與線段組成,跨行公式更是被切分成多段。當翻譯工具只抽取純文字,這些幾何資訊全部消失,譯文回到頁面時只能重新排版。
後果在雙欄論文中特別明顯。原本貼齊欄寬的段落被拉成單欄,圖表題註與圖片的對應關係斷開,參考文獻編號與正文的上標失去連結。讀者要在兩份文件之間反覆比對,閱讀成本大增。此專案選擇的解法是不重建頁面,而是把頁面當成容器,逐區塊替換內容。
它的版面保留技術如何運作?
流程分四步:解析 PDF 取得字元座標,用 DocLayout-YOLO 偵測版面區塊,把段落送交翻譯服務,最後按原區塊的字級與框線回填譯文。
技術堆疊由多個開源元件組成。文件解析依賴 PyMuPDF 與 pdfminer.six,版面偵測使用 openbmb 的 DocLayout-YOLO,並以 ONNX 格式的 DocStructBench 模型在本機推論。段落重組與字型處理交由 BabelDOC 後端,字型則選用 Go Noto Universal 以覆蓋多語系字元。
回填階段的設計值得注意。譯文段落由來源區塊的中位字級起算,超出框線時逐級縮小,直到塞回原本的方框。偵測到的圖表、表格與獨立公式維持原樣,不會被翻譯流程改動。這種「只換文字、不動結構」的策略,讓輸出檔在縮圖狀態下與原稿幾乎無法分辨。
Ultrafast 模式解決了什麼問題?
十月二日新增的 ultrafast 模式改用原生文字座標做版面推斷,跳過 ONNX 與 OCR。原生文字 PDF 的處理速度明顯提升,代價是輸出檔較大且不處理掃描頁。
標準模式要跑兩次版面與段落分析,還要載入 ONNX 模型,對已是原生文字的 PDF 而言屬於重複工作。ultrafast 模式改以 pdf-inspector 提供的字元座標做啟發式分組,整條路徑不再匯入 ONNX 或 OpenCV,首次啟動的等待時間因此縮短。
效能參數也有分工。ultrafast 模式使用整份文件共用的段落工作者池,預設十六個,可用 -t 覆寫;標準模式維持四個。說明文件提醒,ultrafast 不處理沒有原生文字的頁面,複雜表格與公式仍應回到標準模式,且此模式與 precise、babeldoc、伺服器、GUI 及 onnx 選項互斥。
字型子集化在該模式下自動略過,輸出檔因此較大。這個取捨對經常批次處理同批論文的讀者影響不大,但對需要分發檔案的場合就要留意體積。
它支援哪些翻譯服務與語言?
預設使用 Google 翻譯,另可切換 DeepL、OpenAI、Ollama 等服務,以 -s 參數指定。語言以 -li 與 -lo 控制,涵蓋中英日韓俄等主要語系。
服務選擇以命令列參數決定,寫法為 -s 加上服務代號。免費的 Google 端點適合快速預覽,DeepL 在歐語系表現較穩定,OpenAI 與 Ollama 則讓譯文可以套用自訂提示詞。三月二十二日的版本加入 MiniMax 支援,並同時修復多項 OpenAI 與 HTTP 連線問題。
語言控制分為來源與目標兩端,對應 -li 與 -lo 兩個參數。專案標籤列出中文、英文、日文、韓文與俄文等主要語系,字型覆蓋範圍足以處理混排內容。十月三日的更新處理了一個長期細節:譯文在中文與拉丁字母相鄰處會自動補上空格,連帶處理帶重音符號的字母,標準模式與 ultrafast 模式皆適用。
部分章節翻譯同樣可行。加上 -p 參數即可只翻指定頁碼,適合只想讀方法節或實驗節的讀者。例外規則可用 -f 與 -c 指定不翻譯的段落特徵,避免程式碼區塊或商標被誤譯。
OCR 與掃描檔的處理到什麼程度?
九月八日加入實驗性 OCR,僅針對純圖片頁面,使用 PyMuPDF 內建引擎與 Tesseract 語言資料。手寫文字與行內公式仍可能辨識錯誤,白底掃描件的效果最好。
OCR 功能的範圍寫得相當保守。快速模式在翻譯前會自動對選定的純圖片頁面執行本地辨識,原生文字頁、已有 OCR 層的頁面與空白頁一律跳過,雙語輸出中的原稿頁也保持不變。安裝時加上 ocr 額外依賴即可啟用,首次掃描會下載 Tesseract 的 tessdata_fast 4.1.0 語言資料到本機快取。
辨識後的處理比單純取字更進一步。文字會依偵測到的版面區域重新聚合成段落,折行與軟連字號先行合併,譯文再從來源中位字級起算並縮小以符合原框。圖表、表格與獨立公式維持不動。這種分段策略讓掃描件的譯文不至於變成一句一行的碎片。
限制同樣明確。目前只針對白底掃描件,已含文字的頁面若只部分掃描會被跳過,手寫文字與行內公式可能辨識錯誤。精確模式不受影響,行為與先前一致。對需要處理古籍或手稿的讀者而言,這條路仍未打通。
MCP 與 Zotero 整合帶來什麼改變?
專案內建 MCP 伺服器,以 –mcp 啟動 STDIO 模式、加上 –sse 改用 SSE 傳輸。代理工具可直接呼叫翻譯能力。另有 Zotero 外掛,把翻譯接進文獻管理流程。
MCP 通道是近期最實用的變化。加上 –mcp 參數後,程式以標準輸入輸出模式提供工具介面,編碼助理可直接呼叫翻譯與版面分析,不必再包一層腳本。若需要遠端呼叫,加上 –sse 即改用伺服器推送事件傳輸。這條路徑讓文獻處理從手動操作變成可編排的步驟。
Zotero 整合走另一條路。社群專案 zotero-pdf2zh 以外掛形式接入,使用者可在文獻庫內直接對附件發動翻譯,譯稿回到同一個條目之下。對長期整理參考文獻的研究者而言,這比切換視窗手動上傳更貼近實際工作流。
部署方式同樣齊備。命令列安裝以 pip 或 uv 完成,圖形介面以 pdf2zh -i 啟動,預設連接埠 7860。容器化提供 Docker Hub 與 GitHub Container Registry 兩個來源,另有 Heroku、Render、Zeabur、Sealos 與 Koyeb 的一鍵部署按鈕。若模型下載受阻,官方建議設定 HF_ENDPOINT 指向鏡像站。
專案數據與開發節奏如何?
儲存庫累積 38,100 顆星標、3,419 次分叉與 123 名訂閱者,待處理議題 170 項。專案自 2024 年 9 月建立,主線仍持續提交,貢獻者約五十六人。
- 38,100GitHub 星標
- 3,419分叉次數
- 123訂閱者
- 170待處理議題
星標與分叉的比例約為十一比一,略高於一般工具型專案,反映實際動手部署的比例不低。待處理議題一百七十項,對一個已有兩年歷史的專案屬於中等水位,多數集中在特定 PDF 的相容性與版面異常。
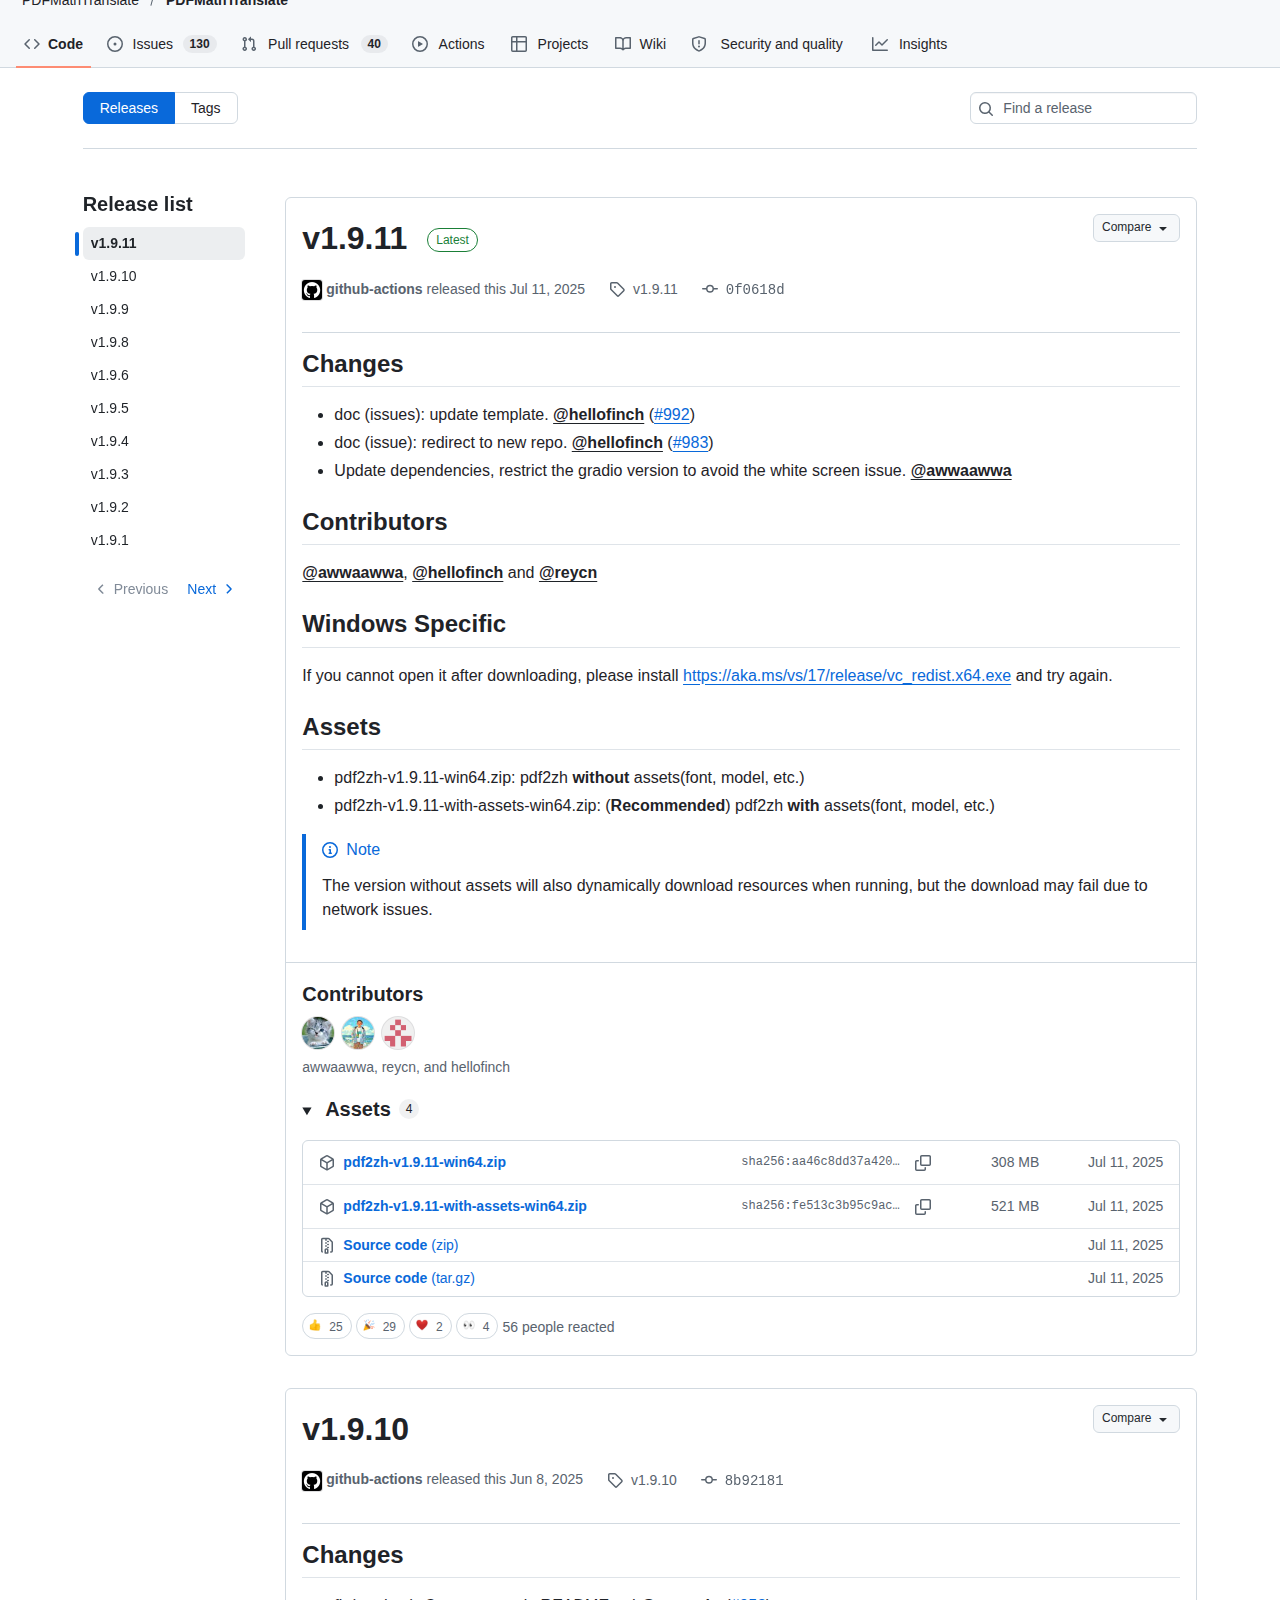
版本節奏值得留意。主線最後一個標記版本為 v1.9.11,發佈於二零二五年七月,之後的更新全部走提交而非正式版本。二點零系列已遷移至組織下的 PDFMathTranslate-next 儲存庫,該分支加入網頁介面並改善跨欄與跨頁的語意一致性,但官方註明它僅供開發使用,不處理相容性問題,也不接受社群貢獻。
這種雙軌結構在學術專案並不少見。穩定線維持既有行為,實驗線承擔新架構的風險。對生產環境而言,選擇穩定線較安全;對想試新功能的讀者,實驗線的功能更完整,但需要自行承擔版本漂移的成本。
授權是另一個必須看清的條件。AGPL-3.0 要求修改後的程式在提供網路服務時同樣開源,對想把翻譯能力包成商業服務的團隊構成實質限制。個人使用與內部部署不受影響,對外提供服務則需要重新評估。
出處連結有哪些?
原始碼、議題追蹤與多語系說明集中於 PDFMathTranslate 儲存庫,線上試用版位於 pdf2zh.com,學術引用資訊見 EMNLP 2025 論文頁。
本文數據取自 GitHub 儲存庫的公開統計、README 內容與版本頁面,功能描述對照官方說明文件。專案另設 Telegram 討論群與 HelloGitHub 推薦頁,線上試用服務由社群維護,運算資源有限。若需要引用,論文頁提供完整書目格式與摘要。
出處:https://github.com/PDFMathTranslate/PDFMathTranslate
常見問題有哪些?
常見疑問集中在安裝環境、翻譯品質、掃描件支援與商業使用四方面,以下依官方說明整理,實際效果仍受原檔結構與所選服務影響。
需要什麼環境才能執行?
需要 Python 3.11 至 3.12 版本。建議以 uv 安裝,指令為 uv tool install --python 3.12 pdf2zh,可避免相依套件衝突。若使用圖形介面,啟動後瀏覽器會自動開啟 7860 連接埠。
翻譯品質由什麼決定?
主要由所選的翻譯服務決定。預設的 Google 端點速度快但術語一致性普通,DeepL 在歐語系較穩定,OpenAI 與 Ollama 可透過自訂提示詞控制術語。版面保留與翻譯品質是兩件事,本專案負責前者。
掃描版 PDF 可以直接用嗎?
需要加上 ocr 額外依賴,且目前只支援白底掃描件。已含文字的頁面若只有部分區域是掃描圖,該頁會被跳過。手寫文字與行內公式可能辨識錯誤,建議先以單頁測試再批次處理。
可以用於商業用途嗎?
AGPL-3.0 允許商業使用與修改,但若把修改後的程式以網路服務形式對外提供,必須同樣開源。純內部使用或個人使用不受此限。封裝成產品的團隊應先諮詢法務。
兩個儲存庫應該選哪一個?
追求穩定選目前這個儲存庫,版本停在 v1.9.11 系列但行為可預期。想試網頁介面與新版翻譯核心,可看 PDFMathTranslate-next,該分支功能較多但官方註明不保證相容性。
總結:PDFMathTranslate 適合誰使用?
適合需要大量閱讀外語論文的研究者、研究生與技術文件讀者,也適合想把翻譯接進自動化流程的開發者。只偶爾翻譯一兩頁的使用者,線上服務已足夠。
這個專案解決的是一個長期被忽略的細節。機器翻譯早已能把論文正文轉成通順中文,真正讓人放棄的往往是翻完之後版面全散、公式對不上、圖表題註錯位。把版面當成第一等公民處理,才是它累積三萬八千顆星標的原因。
導入時的務實做法是先分辨檔案類型。原生文字的 PDF 用 ultrafast 模式批次處理,掃描件留給標準模式並先測試單頁,含複雜公式的檔案不要期待一次到位。需要接進既有流程的團隊,可由 MCP 通道起步,把翻譯變成可編排的步驟而非手動操作。
真正需要提前想清楚的是授權與維護。AGPL 對服務化的限制明確,雙軌儲存庫意味著功能更新與穩定性之間必須取捨。把這兩點寫進評估文件,比事後補救省事得多。
