Hugging Face 於 2026 年 11 月 13 日發布 Transformers 5.23.0,這個累積 168,953 顆星標的模型定義框架在單一版本內納入七款新模型,並把匯出器重寫成統一的 ExportedModel 介面。版本說明引用 236 個合併請求,列出 13 項破壞性變更,同時改寫專家平行的實作選項。
這個框架的版本節奏在近一個月明顯加快。10 月 15 日發布 5.20.0,10 月 26 日推出 5.21,10 月 29 日連續給出 5.22.0 與 5.21.1,11 月 13 日再推進到 5.23.0。相鄰版本之間相隔不足兩周,而每一次主版本變動都涉及模型支援與底層介面。
節奏加快的成因寫在版本說明裡。5.23 的變更清單包含七款新模型、四篇匯出器相關的合併請求、十三項破壞性變更,以及一百五十七條缺陷修正。這種密度意味着升級不再是單點替換,而是一次跨越模型層、匯出層與平行層的整體調整。
Transformers 5.23 是什麼?
Transformers 5.23.0 於 2026 年 11 月 13 日發布,Apache 2.0 授權,納入七款新模型並重寫匯出器介面。
這個專案由 Hugging Face 維護,自 2018 年 10 月建立以來已累積 35,191 個分支。它的定位是把最新研究模型轉為可載入、可訓練、可推論的統一定義,讓下游的推論服務、微調工具與應用框架不需要為每個模型重寫載入邏輯。
5.23.0 的具體範圍可分三層。模型層新增七款架構,涵蓋混合專家、視覺語言、決策頭與程式碼模型。匯出層把四個後端收進同一組介面,並提供可上傳至模型倉庫的封裝格式。平行層則把專家平行的實作方式改為可選,同時修正分散式訓練的梯度歸約時機。
Transformers 5.23 新增了哪些模型?
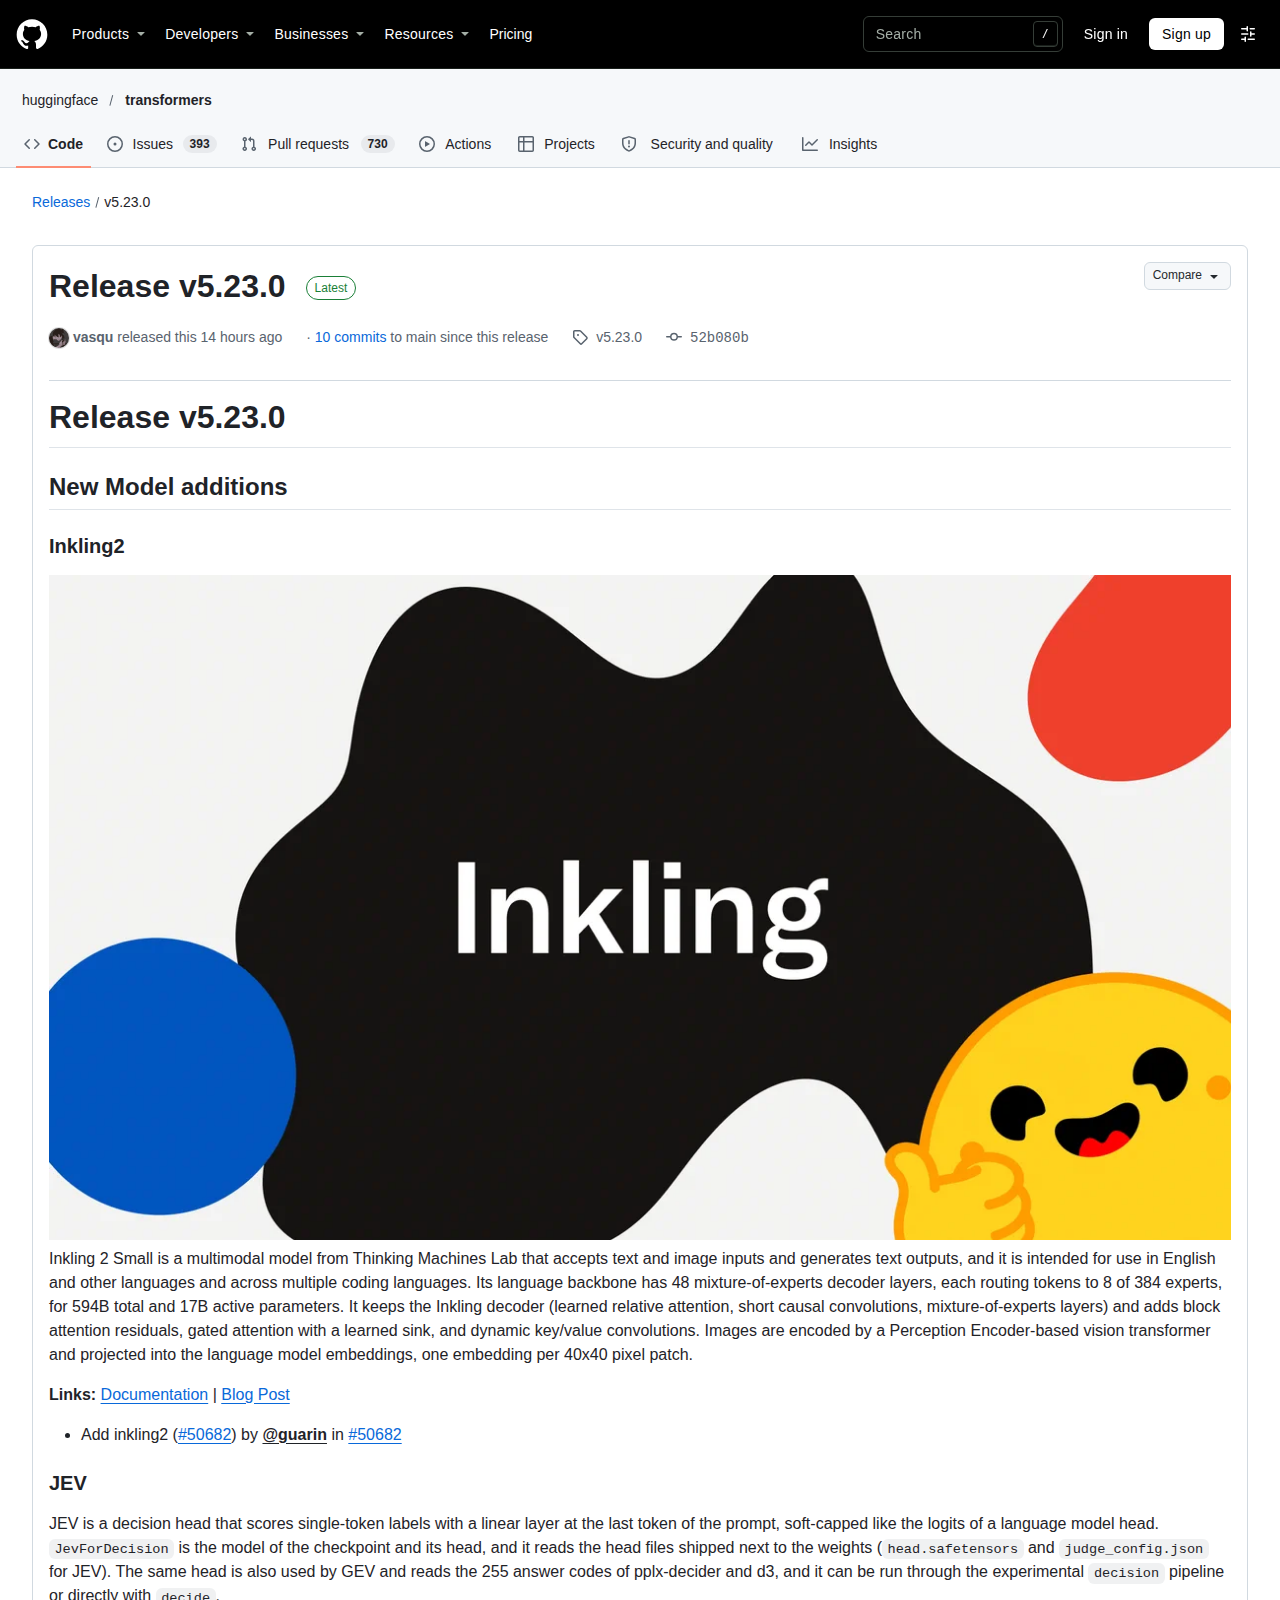
5.23 新增 Inkling2、LFM3、LFM3-VL、InternLM3、IQuestCoder、JEV 與 Dots 3 Note 七款模型。
份量最重的是 Thinking Machines Lab 的 Inkling 2 Small。它的語言主幹由四十八層混合專家解碼器組成,每個詞元從三百八十四位專家中路由八位,總參數五百九十四億級別而每詞元僅啟用十七億。架構沿用 Inkling 解碼器的學習式相對注意力、短因果卷積與混合專家層,另外加入區塊注意力殘差、帶學習匯點的门控注意力與動態鍵值卷積。圖像由感知編碼器衍生的視覺轉換器處理,每四十乘四十像素的圖像區塊投影為一個嵌入。
Liquid AI 在同版推出兩款。LFM3 是第三代液態基礎模型,採用門控短卷積與分組查詢注意力的混合結構,注意力層在全注意力與滑動視窗之間分配,並對查詢與鍵的頭部套用均方根歸一化,再以逐頭 Sigmoid 門控輸出。LFM3-VL 在其上加裝視覺路徑,以線性切塊器、門控深度可分二維卷積與雙向分組查詢注意力處理原生解析度的圖像與影片,投影器把二乘二的區塊特徵合併為單一語言詞元。
其餘四款各據一方。Dots 3 Note Preview 是接受文字、圖像、影片與音訊的混合專家因果模型,圖像與影片共用視覺編碼器,音訊則交由 Whisper 式編碼器,支援 BF16 與 FP8 推論。InternLM3 是上海人工智能實驗室的八十億參數指令模型,架構與 Llama 相同,差異集中在注意力偏置與前饋偏置的設定檔對應。IQuestCoder 提供七十億、一百四十億與四百億三個尺寸,各有基礎、指令與思考變體,其中循環結構的檢查點不被支援。
JEV 則是這批新增裡唯一的非生成式模型。它是一個決策頭,以線性層對提示最後詞元位置的單詞元標籤評分,並按語言模型頭的邏輯做軟上限。JevForDecision 會讀取權重旁的 head.safetensors 與 judge_config.json,官方明確標示此介面仍屬實驗階段,生產環境需審慎評估。
匯出器介面在 5.23 有什麼改動?
匯出流程改為統一 ExportedModel 物件,可上傳倉庫並載回,涵蓋 Dynamo、ONNX Runtime、OpenVINO 與 ExecuTorch。
舊流程的核心問題是產物無法沉澱。匯出後的模型只是一組檔案,既沒有統一的呼叫方式,也缺少可追溯的設定記錄。團隊每次部署都要重寫載入腳本,量化版本更要另外維護一套參數。
新介面把匯出結果變成可呼叫的物件。export() 回傳 ExportedModel,其參數與輸出類別與原始模型一致,可以推送到模型倉庫,也能用 from_pretrained 載回指定裝置執行。匯出時產生的 export.json 會記錄設定、輸入形狀、套件版本與輸入輸出名稱,量化匯出亦沿用同一套儲存與載入路徑。
融合時機也一併前移。OnnxConfig(ort_fusions="cpu") 可在匯出階段把注意力、鍵值快取上的分組查詢注意力、旋轉位置編碼、歸一化與混合專家改寫為 ONNX Runtime 的融合算子,可選目標包含 CPU、CUDA、WebGPU 與 DirectML。OpenVINO 的匯出則直接命中原生的融合核心,覆蓋注意力、旋轉位置編碼、混合專家與 int8 或 int4 壓縮權重。
代價是介面不相容。export() 的回傳型別改為 ExportedModel,ONNX 程式的型別變為 onnx_ir.Model,OnnxConfig 與 OpenVINOConfig 的 output_path 選項被移除,改由 save_pretrained 負責存檔。自訂後端需要透過 register_backend 註冊,舊有腳本若不改寫就會在匯出階段直接中斷。
上一個主版本的匯出器改動可與今次對照,Transformers 5.20 的版本內容仍屬舊介面,相隔不足一個月已再改一輪。
匯出後的實際效能提升有多少?
ONNX Runtime 搭配 TensorRT 在 A100 上比即時模式快 7.6 倍,OpenVINO 在 Xeon 平台解碼快 2.4 至 3.9 倍。
測試條件寫得相當具體。基準模型為 EmbeddingGemma2,批次八條各一百二十八個詞元。在 A100 上,ONNX Runtime 搭配 TensorRT 執行環境的延遲是即時 PyTorch 的七分之一點六,相對 torch.compile 亦快四成。
中央處理器一側的數字同樣可觀。在 Xeon Platinum 8570 上,OpenVINO 匯出的模型比即時模式快 4.1 倍,比 torch.compile 快 2.2 倍;若改用 int8 權重,兩個倍率分別升到 4.9 倍與 2.6 倍。這些改善並非來自演算法變動,而是把融合工作從執行期搬到匯出期,令圖優化可以在編譯階段一次完成。
對部署端的意義在於可預期性。過去的量化與融合往往在執行期才發現算子不支援,錯誤訊息指向後端內部;現在設定與輸入形狀一併寫入 export.json,問題可以在匯出階段就被攔下,也方便把匯出設定隨模型版本納入版本控制。
專家平行與分散式訓練有什麼進展?
專家平行改為可選實作,推論用全歸約、訓練用全對全;訓練器只在最後一個微批次歸約 FSDP 梯度,並修正詞元計數的正規化與 TPU 上的張量平行載入。
舊版只有單一實作路徑,推論與訓練被迫共用同一套通訊模式。5.23 加入 ep_implementation 選項,推論可選全歸約以配合 CUDA 圖捕獲,訓練則用全對全提高頻寬利用率。原本的 ep_router 樣式在此版移除,相關模型改走 ep_dispatch_experts。
新增的 deepgemm_megamoe 實作針對 DeepGEMM 的巨量專家路徑。混合專家模型的專家數量上升後,路由表與權重分派的開銷會壓過矩陣運算本身,這條路徑的做法是把分派與專家計算合併在同一核心內完成。
訓練器一側修正了梯度歸約的時機。舊版在每個微批次後都歸約 FSDP 與 HSDP 梯度,等於把通訊成本乘以累積步數;新版只在最後一個微批次歸約。詞元計數的正規化亦從整數除法改為真除法,避免長序列批次出現統計偏差。
張量平行的修正集中在邊界情況。注意力匯點在 Beam 搜尋下的切片、TPU 上綁定權重的比較,以及測試環境改為從 fork 伺服器分叉而非逐個生成程序,都屬於這一批。
升級到 Transformers 5.23 有哪些破壞性變更?
版本列出十三項破壞性變更,含移除 ep_router、音訊依賴精簡為 torchaudio 與 soundfile,並棄用語言模型解碼。
音訊依賴的變動影響範圍最廣。[audio] 額外依賴精簡為 torchaudio、soundfile 與 soxr,移除了 librosa 與 phonemizer。既有專案若在音訊前處理階段呼叫 librosa 的重採樣或載入函式,升級後會出現匯入錯誤,需要在專案內自行補上依賴。
第二項是語言模型解碼的棄用。Wav2Vec2ProcessorWithLM 與 pyctcdecode、kenlm 的語言模型解碼正式標記棄用,語音辨識流程若依賴這條路徑,需要改接新介面。此項與上一項合起來,等於把音訊管線的外部依賴壓縮到三個套件以內。
第三項是輸出結構。ModelOutput 移除了 rope deltas 欄位,任何直接讀取該欄位的自訂程式碼都會失效。第四項是處理預設值的歸屬,預設參數改由類別層級提供,而非實例化時動態收集,自訂處理器若依賴舊行為需同步調整。
其餘幾項影響較窄但容易忽略。kernels 的最低版本被提高,舊環境升版時需一併更新。伺服器端對 Mac 使用者的注意力實作有變動。pi0 模型的計算圖改為安全化處理,張量平行與專家平行與 FSDP 的計畫改為一次建構後展開,相關自訂流程需重新核對參數順序。
Transformers 的主要數據有哪些?
儲存庫累積 168,953 顆星標與 35,191 個分支,採 Apache 2.0 授權,主要語言為 Python。專案建立於 2018 年 10 月,最新版本為 5.23.0。
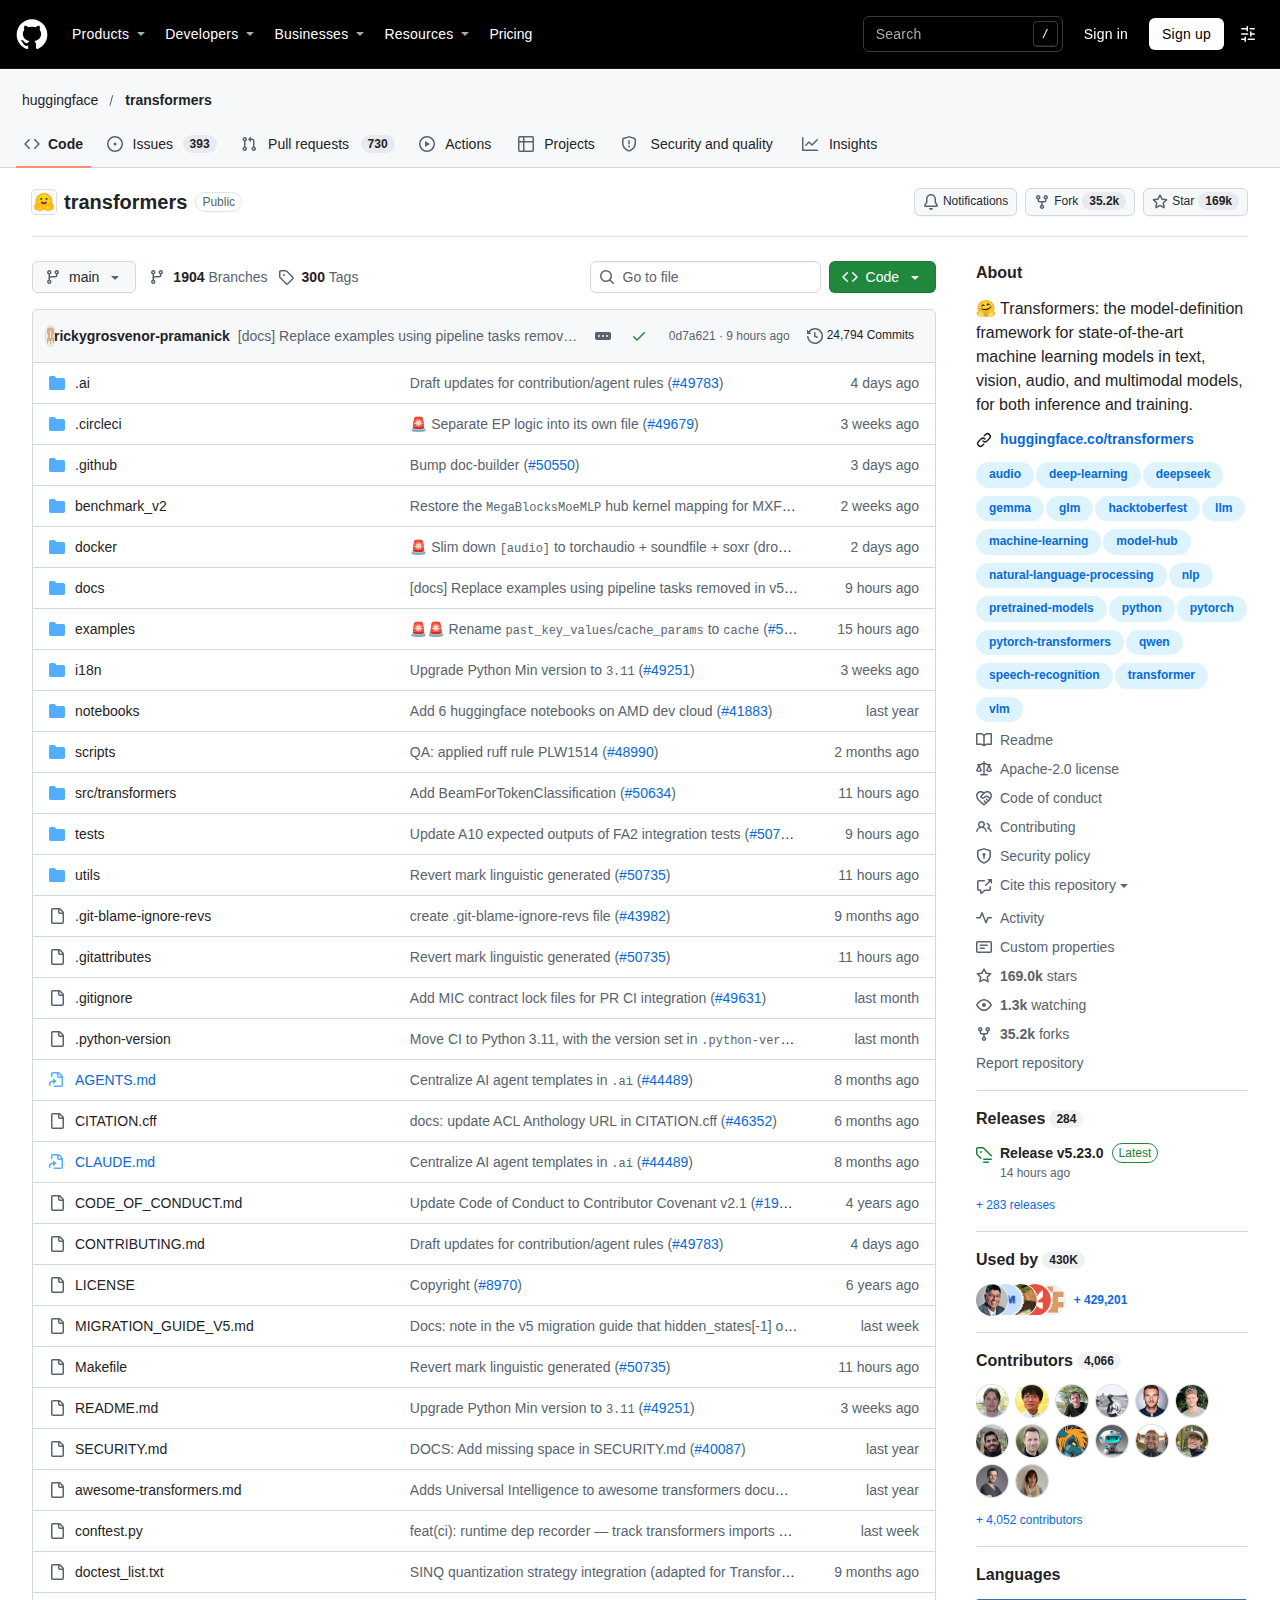
分頁數反映企業自維護的規模。三萬五千個分支意味着大量組織在自家分支上維護客製模型與內部修補,任何介面調整都會沿分支擴散。這也是匯出器改版以棄用而非靜默替換處理的原因。推論端若同時部署多個框架,可參考本地推論引擎 llama.cpp 1.0 的介面凍結做法,兩種專案對穩定性的處理方向並不相同。
版本節奏的數據同樣值得留意。5.22 系列在十月下旬連續推出三個版本,5.23 的變更清單包含一百五十七條缺陷修正。維護團隊對回歸問題的回應速度維持在高位,代價是升級窗口變得更短,延後一版的成本比過去更高。
出處連結有哪些?
本文數據取自 huggingface/transformers 官方儲存庫、5.23.0 版本說明與官方匯出器文件,資料讀取時間為 2026 年 11 月 14 日。
官方儲存庫:https://github.com/huggingface/transformers
版本說明的完整內容刊載於儲存庫的 Releases 頁面,逐項列出模型新增、破壞性變更、匯出器、視覺、平行化、快取、核心、注意力、生成、量化與音訊各層的調整。匯出器的使用範例與後端差異說明位於官方文件的匯出器章節。
總結:Transformers 5.23 適合什麼團隊?
需要快速評估新模型或部署到 ONNX Runtime 與 OpenVINO 的團隊適合升級;音訊依賴 librosa 的專案應先盤點相容性。
5.23 的價值集中在兩條線。模型線在單一版本內覆蓋多模態混合專家、視覺語言、程式碼生成與決策頭四個方向,把評估新架構的起步成本壓到最低。匯出線則用一個介面取代四個後端的各自腳本,並把量化與融合提前到編譯階段。
升級判斷可以簡化為兩點。若團隊的工作重心是緊跟模型發布節奏、或正為邊緣與雲端部署尋找統一的匯出路徑,這一版的介面值得直接採用。若專案深度改寫過音訊前處理、依賴語言模型解碼,或使用自訂匯出後端,則應先完成依賴清點與介面對照,再安排升級時機。
