Hugging Face 於 2026 年 10 月 15 日發布 Transformers 5.20.0,這是這個累積 167,955 顆星標的模型定義框架近期幅度最大的一次模型擴充。單一版本內同時納入七款新架構,涵蓋多模態混合專家模型、長文本 OCR、語音轉錄與雙向文字編碼器,並把量化壓縮正式整合進模型匯出流程。後續在 10 月 16 日與 10 月 19 日分別推出 5.20.1 與 5.20.2 兩個修補版本,主要處理多模態輸入型別轉換與專家平行訓練的梯度問題。
Transformers 5.20 是什麼?
Transformers 是 Hugging Face 的開源模型定義框架,統一載入文字、視覺、語音與多模態模型。5.20.0 於 2026 年 10 月 15 日發布。
這個專案的角色是模型與應用之間的中介層。研究者訓練完成的權重,只要在框架中實作對應的模型類別,就能透過統一的 from_pretrained 介面載入,不必為每個模型重寫推論程式。框架目前支援語言模型、視覺語言模型、語音模型、嵌入模型與獎勵模型等多種類別,官方文件記載的檢查點數量已達六位數字。
專案自 2018 年 10 月建立,採 Apache 2.0 授權,主要語言為 Python,分支數達 34,941 個。這個分支比例在開源專案中屬於偏高水準,通常反映企業在生產環境中維護自有分支的常態,而非單純的收藏行為。維護團隊在每個模型類別下設有獨立測試與慢速整合測試,這也是新模型能夠穩定合併的結構性原因。
5.20 系列的節奏值得留意。主版本在 10 月 15 日發布,10 月 16 日與 10 月 19 日各出一次修補,間隔不到一周。這種節奏說明主線變更的複雜度正在上升,尤其是多模態與分散式訓練兩塊的交集,測試覆蓋難以在單次發布中一次到位。
Transformers 5.20 新增了哪些模型?
5.20.0 一次納入七款新模型,涵蓋 Meta 的 816B 多模態模型、百度 3B 長文本 OCR 與德語推理模型。
最具分量的是 Meta 的 Muse Spark Open。這是一個總參數 816B、每詞元啟用 42B 的多模態混合專家模型,輸入可為文字、圖像、音訊與影片,上下文視窗達 1,048,576 個詞元,並針對多檔案編輯、除錯與工具呼叫等代理式編碼任務訓練。權重同時提供 BF16 與 NVFP4 兩種格式,對於需要在本地或私有雲部署大型代理模型的團隊,這是目前少數具備原生支援的選項。
InclusionAI 的 Ling 3.0 Flash 走的是另一條路線。它的解碼器具備混合注意力結構,每五層 Kimi Delta Attention 搭配一層多頭潛在注意力,前饋層則結合路由專家與共享專家。框架以 BailingHybridForCausalLM 原生支援,載入時不需要 trust_remote_code=True,這一點對供應鏈安全要求較高的環境特別實際。
其餘五款各據一方。Aleph Alpha 的 Kolibri1 是德語與英語導向的推理模型,五十層網路每層從 384 位專家中路由六位,並在滑動視窗注意力層套用旋轉位置編碼。OpenBMB 的 MiniCPM-V 4.7 以 canvas M-RoPE 取代單維視覺位置編號,讓同一張圖的切片保留二維空間關係。百度的 UnlimitedOcr 以 3B 參數處理長文本,把解碼器注意力全面改為參考滑動視窗注意力,使 KV 快取在解碼期間保持固定。UltraBERT 提供 150M 與 380M 兩個編碼器與一個嵌入版本,最長支援 32,768 個詞元。MOSS-Transcribe-Diarize 0.9B 則把轉錄與說話者分離整合進單次前向運算。
為何一次接入七款模型值得關注?
框架的原生支援決定模型能否被快速評估與部署。缺少原生實作時,團隊必須自行維護自訂程式碼,版本升級與安全修補都會被拖慢。
原生支援與社群實作的差別,體現在可維護性。透過 trust_remote_code=True 載入的模型,其程式碼由模型作者維護,與框架主線的測試體系脫鉤;一旦框架調整快取或注意力的內部介面,這類模型往往在下一次升級時失效。原生實作則納入主線測試,變更會在合併前被攔截。
對企業的實務影響是評估週期。當一個新模型發布,團隊通常需要兩到三周完成基準測試與硬體適配;若框架已原生支援,這段時間可以壓縮到數日。5.20 在單一版本內覆蓋多模態、OCR、語音與嵌入四個方向,等於同時降低了四類專案的起步成本。
硬體格式的支援也納入考量。Muse Spark Open 提供 NVFP4 格式權重,這種低位寬格式需要框架與核心函式庫同時支援才能發揮效果。5.20 同時把最低核心函式庫版本提高到 0.17.2,並加入核心載入失敗時回退至原始實作的機制,讓量化模型在缺少特定核心的環境仍可執行,只是效能不及預期。
Transformers 5.20 在量化匯出方面有什麼更新?
匯出流程現在支援在轉換階段直接量化,統一介面整合 PT2E、ONNX Runtime 與 NNCF 三種量化器,涵蓋靜態、動態與僅權重壓縮,並可設定校準流程。
過去的做法是兩段式。先把模型匯出為 ONNX、OpenVINO 或 ExecuTorch 格式,再以各後端自己的工具進行量化。這種流程的問題在於量化參數與前端圖結構經常對不上,出錯時難以判斷問題落在匯出或量化階段。
5.20 把量化移進匯出管線,並提供單一介面覆蓋 Dynamo、ONNX、OpenVINO 與 ExecuTorch 四個目標。支援範圍包含靜態量化、動態量化與僅權重的 INT8 或 INT4 壓縮,校準流程可自行設定。對需要在邊緣裝置部署模型的團隊,這減少了自建腳本的數量,也讓量化設定可以隨模型版本一起納入版本控制。
代價是介面仍在演進。官方文件把這一塊標示為新功能,舊有自訂匯出腳本若直接改接新介面,參數命名與回傳結構都需要重新核對。實務上建議先在單一模型上完成端到端驗證,再批量遷移。
Transformers 5.20 的分散式訓練支援有什麼進展?
FSDP 與張量平行的模型及優化器檢查點現在可以跨平行配置儲存與載入,專家平行的權重分派問題亦已修正,並修復 TPU 上的張量平行載入。
檢查點的可攜性是分散式訓練的長期痛點。過去以 FSDP 搭配張量平行訓練的模型,檢查點與特定的平行度綁定,換機器或調整 GPU 數量就無法載入。5.20 讓這類檢查點可以在不同平行配置之間搬移,對需要在租用算力與自有叢集之間切換的團隊,這是實質的減負。
修正項目集中在專家平行。此前的權重分派會把尚未完成的全對全通訊結果交給專家,導致數值不一致;新版本改為傳遞已接收的資料列。複合模型的綁定語言模型頭也取得獨立的張量平行計畫項目,避免與主體權重混淆。
仍需留意的問題寫在版本說明的首位。官方明確指出專家平行推論目前存在速度退化,正在修復中。若生產環境以專家平行方式提供推論服務,這一版不宜直接上線,應等待後續修補。
升級到 Transformers 5.20 需要注意什麼?
快取工具中已棄用的方法被移除、跨模型匯入被切斷、最低核心函式庫版本提高至 0.17.2,子設定改由 SubConfigSpec 集中初始化,舊有自訂設定需同步調整。
第一項是快取介面。cache_utils.py 中標記棄用的檢查與方法在此版刪除,直接影響 minimax_m3_vl 與 pi0 等模型。仍呼叫舊方法的程式碼會在建構快取時失敗,需要改用現行的快取 API。
第二項是匯入路徑。框架移除了模型檔案中對其他模型的意外匯入,模組化轉換器也不再產生這類跨模型引用。若專案曾透過某個模型模組間接取得其他模型的名稱,升級後會出現匯入錯誤,必須改從原始模組匯入。
第三項是設定初始化機制。新的 SubConfigSpec 把子設定的初始化集中到資料類別欄位,不再透過實例化類別收集預設值。自訂的巢狀設定需要宣告對應的子設定規格,否則預設值不會被正確套用。
其餘兩項影響範圍較窄但容易忽略。LUKE 與 mLUKE 的分詞器現在把 <ent> 等實體特殊符號視為真正的特殊符號,解碼輸出與過去的空白處理不同;最低核心函式庫版本提高到 0.17.2,舊環境升版時需一併更新,否則核心載入會直接報錯。
如何開始使用 Transformers 5.20?
以 pip 或 uv 安裝對應版本,使用 from_pretrained 載入模型即可。多模態專案建議一併安裝 torchcodec,圖片解碼已改由該套件負責。
安裝流程與前版一致,透過套件管理器指定 5.20 系列版本即可。需要特別注意的是影像處理的依賴變動:此版把圖片解碼改由 torchcodec 負責,處理圖像或影片輸入的專案必須補上該依賴,否則在讀取階段就會中斷。
載入新模型時建議先查閱對應的模型文件頁。Muse Spark Open 的 NVFP4 權重需要較新的顯示卡與核心支援,Kolibri1 與 Ling 3.0 Flash 則已在框架內建類別,不需要額外設定。對於既有專案,先以測試環境跑完整測試套件,再處理快取與匯入相關的相容性問題,會比直接在主線升級更省時間。
Transformers 的主要數據有哪些?
儲存庫累積 167,955 顆星標與 34,941 個分支,採 Apache 2.0 授權,主要語言為 Python。專案建立於 2018 年 10 月,最新修補版為 5.20.2。
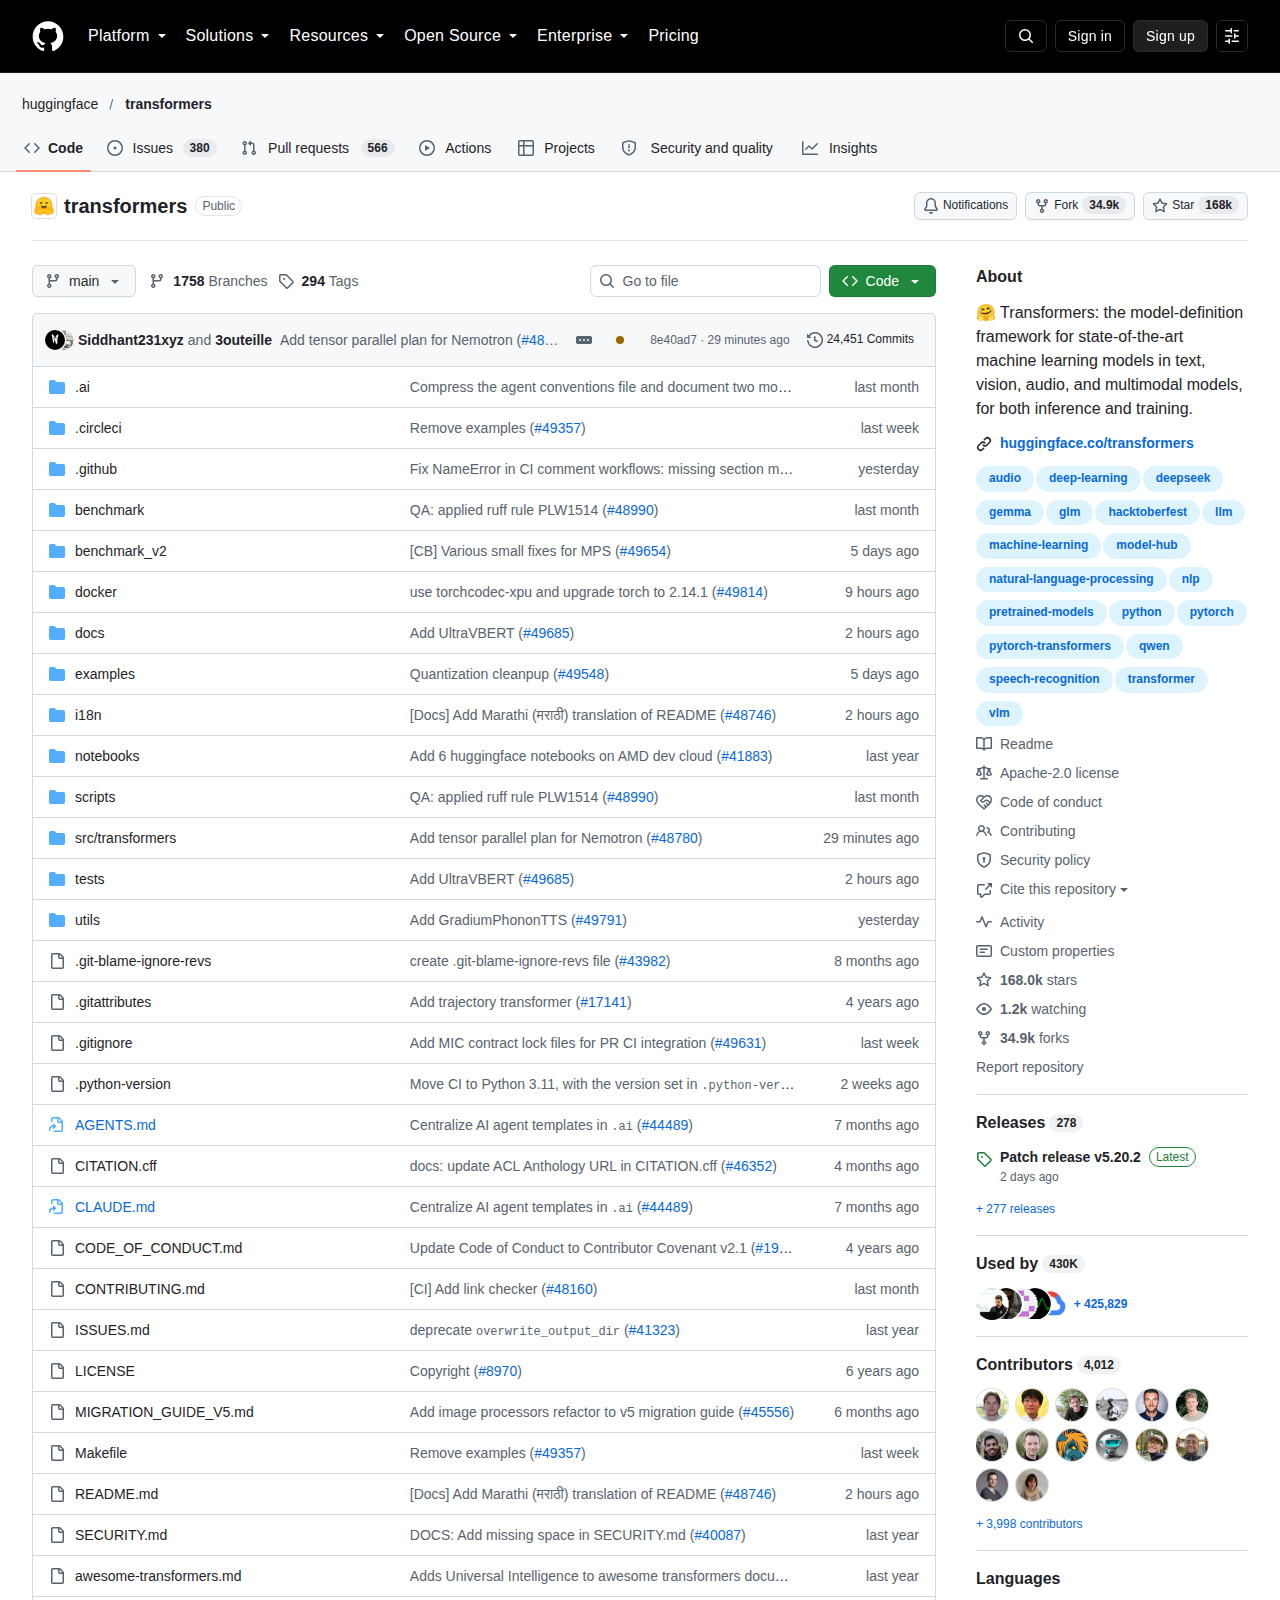
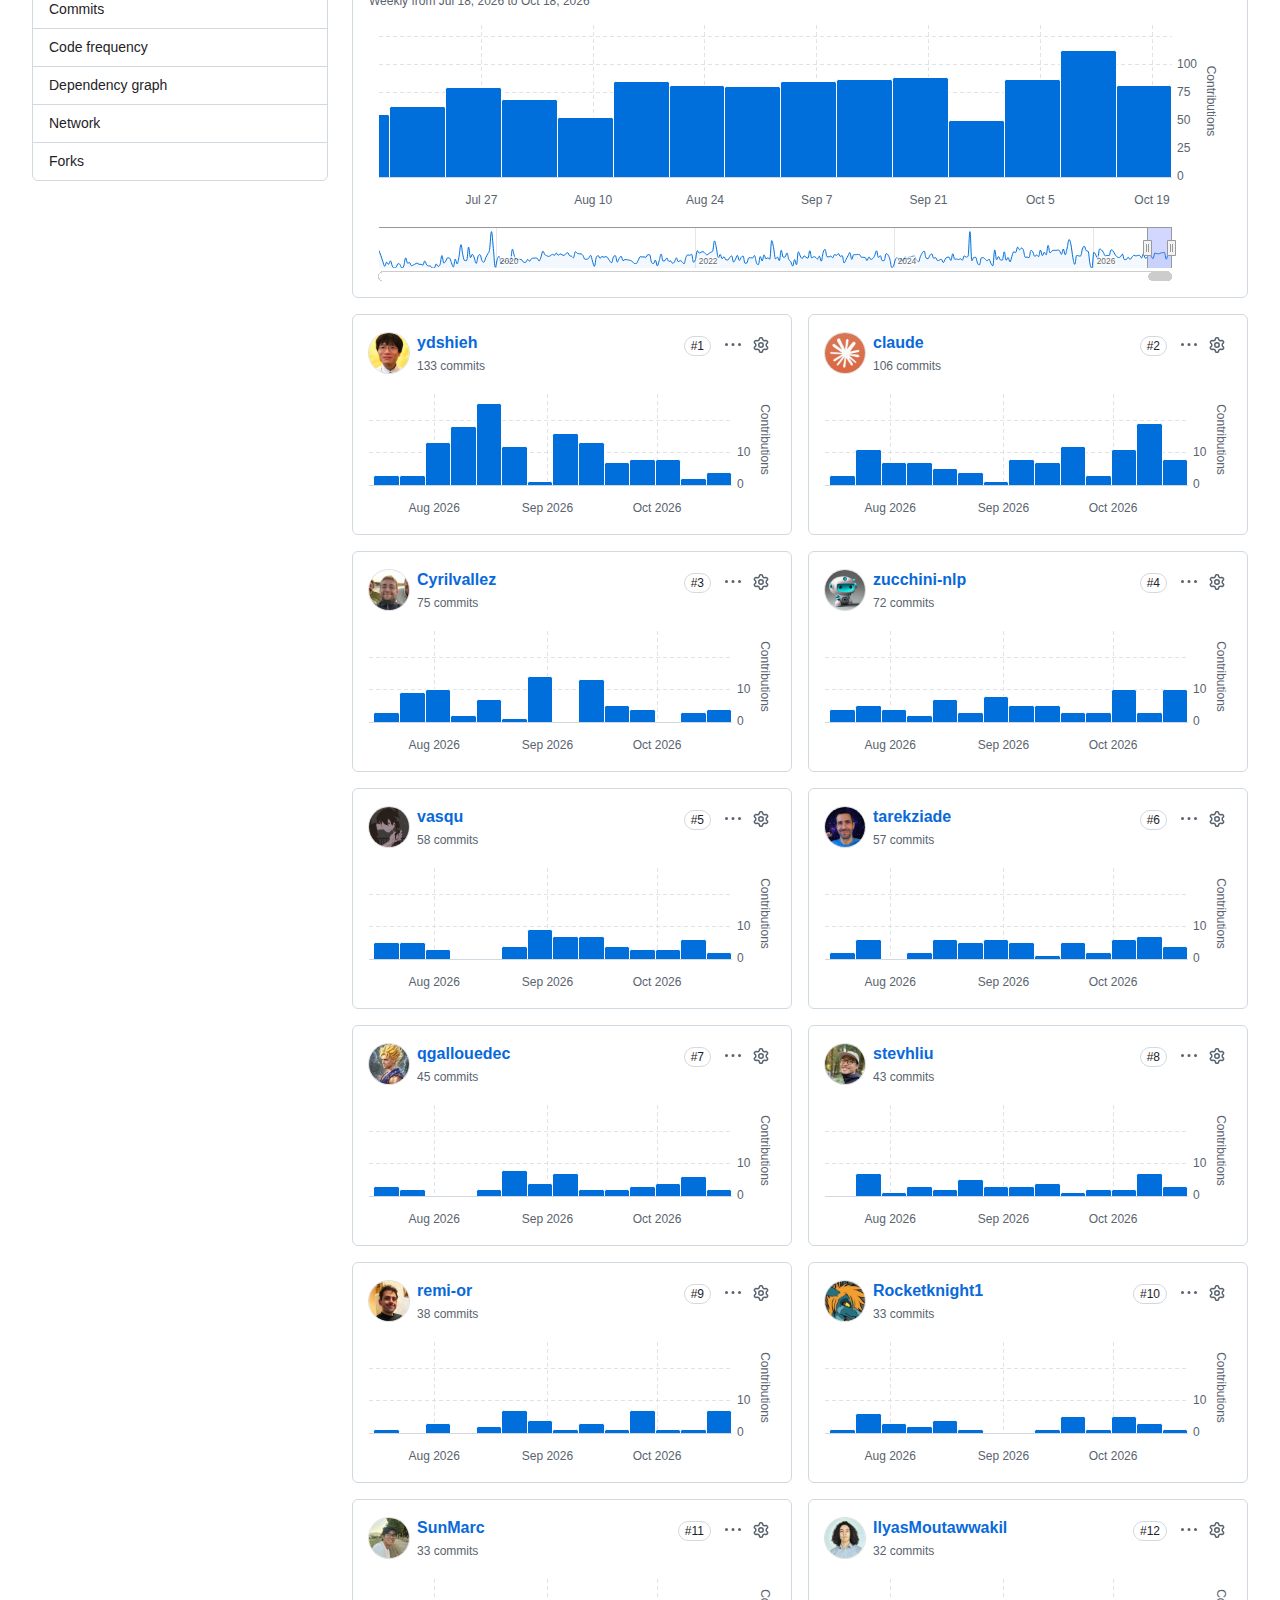
星標數在近半年穩定成長,反映框架在模型生態中的樞紐位置。34,941 個分支對應到大量企業自維護分支,這也解釋為何破壞性變更需要明確的棄用週期,任何介面調整都會沿著分支擴散到生產環境。
版本節奏則呈現加速。5.20.0 之後兩次修補集中在四天內完成,顯示維護團隊對回歸問題的回應速度,同時也說明主線變更的測試壓力正在上升。
出處連結有哪些?
本文數據取自 huggingface/transformers 官方儲存庫、5.20.0 至 5.20.2 版本說明與官方文件,資料讀取時間為 2026 年 10 月 22 日。
官方儲存庫:https://github.com/huggingface/transformers
版本說明的完整內容刊載於儲存庫的 Releases 頁面,逐項列出模型新增、破壞性變更、匯出器、平行化、生成、核心與快取各層的調整。模型文件位於 huggingface.co 的官方文件站,每個新模型都有獨立的文件頁與範例程式碼。
總結:Transformers 5.20 適合什麼團隊?
需要快速評估新開源模型的團隊最適合升級;生產環境若使用專家平行推論,建議等待速度退化問題修復。自訂快取或巢狀設定的專案,應先完成相容性測試。
5.20 的價值在於把模型支援、量化匯出與分散式訓練三條線同時推進。單一版本內接入七款涵蓋多模態、OCR、語音與嵌入的模型,讓評估新架構的時間成本明顯下降;量化整合進匯出流程,則解決了長期存在的兩段式工具鏈問題。
升級的判斷標準可以簡化為兩點。若團隊的工作重心是緊跟模型發布節奏、需要快速完成基準測試,這一版提供的原生支援直接可用。若生產環境依賴專家平行推論,或專案深度改寫過快取與巢狀設定,則應先完成相容性盤點,或在修補版本釋出後再行升級。
