Colibri 是一套以純 C 撰寫的開源推論引擎,在 GitHub 累積 42,713 顆星標。它的核心做法是把混合專家模型的專家權重保留在硬碟,只將密集層放入記憶體,因此在僅有 8 GB 記憶體的裝置上,仍可執行參數規模達 744B 的模型,而且不需要獨立顯示卡。
專案於 2026 年 7 月 1 日建立,以 Apache-2.0 授權釋出,主要語言為 C,截至目前已累積 20 次版本發布,最新版本 v2.0.0 於 10 月 6 日推出。同類工具過去多以記憶體容量作為能否執行的門檻,這套引擎則把門檻改寫成硬碟容量與讀取速度,讓硬體配置較為普通的機器也能參與大型模型的推論。
Colibri 是什麼?
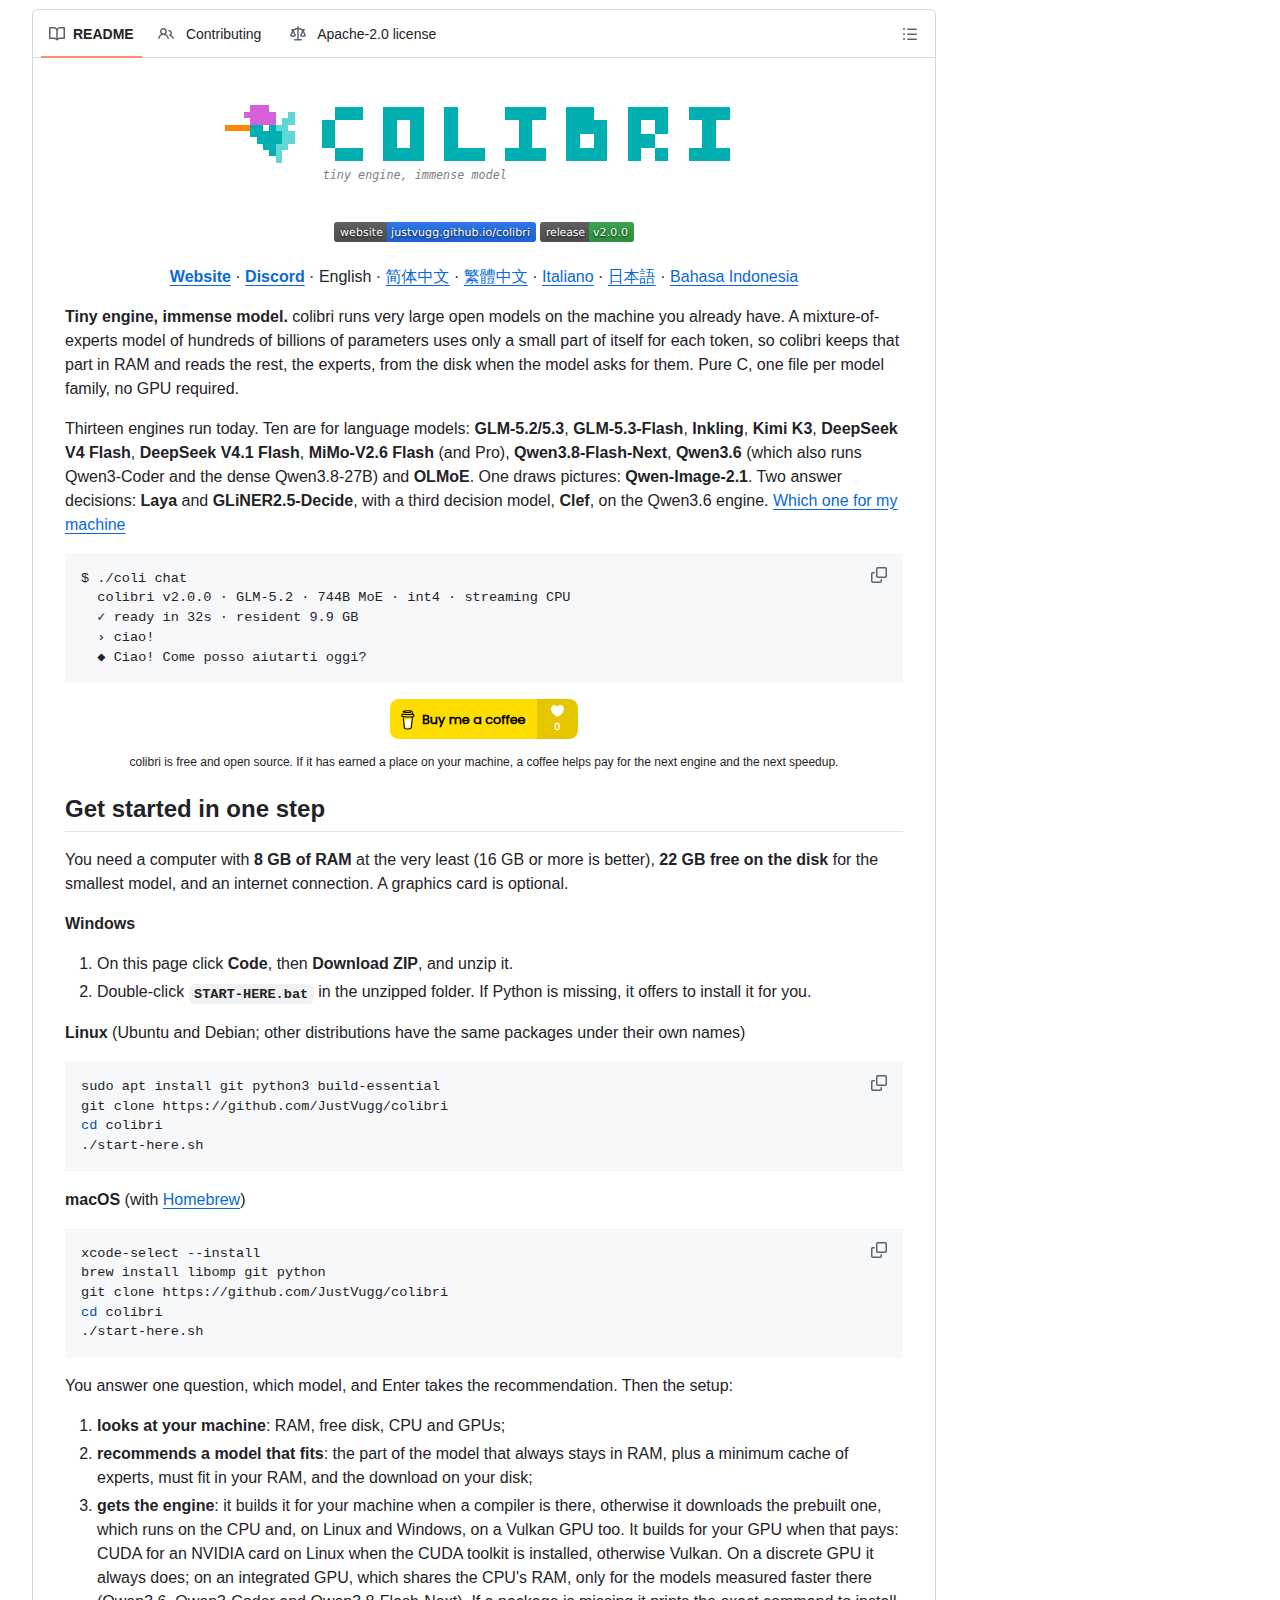
Colibri 是開源推論引擎,以純 C 撰寫、Apache-2.0 授權。它讓大型混合專家模型在一般個人電腦執行,不需顯示卡。
專案的定位是「極小的引擎、極大的模型」。混合專家模型的特性在於體積龐大但每次運算只用得上其中一小部分,例如 GLM-5.2 擁有 744B 參數,每個詞元實際啟用的部分約 40B,而其中真正會隨上下文變動的專家權重約 11 GB。Colibri 依賴這個稀疏特性,把模型的密集部分(注意力層、共享專家與嵌入層)常駐記憶體,把路由專家留在硬碟,等路由器指名時才讀取。
這種設計改變的是權重存放位置,而不是運算內容。官方文件明確指出,一個權重放在顯示卡記憶體、系統記憶體或硬碟,影響的只是回應速度,模型的路由決策與精度不會因此改變。專案亦把這項原則寫進預設行為,強調任何最佳化都不得悄悄更動模型精度或路由語意。
Colibri 如何在只有 8 GB 記憶體的機器上執行大型模型?
做法是把專家權重留在硬碟、密集層留在記憶體,硬碟讀取速度決定推論速度。官方列出最低門檻為 8 GB 記憶體與 22 GB 硬碟空間,顯示卡屬選配而非必需。
安裝流程被壓縮成單一步驟。使用者下載專案後執行啟動腳本,程式會先偵測機器的記憶體、可用硬碟與處理器與顯示卡,再推薦一個裝得下的模型,接著取得引擎、下載模型並開啟瀏覽器儀表板。設定過程只需要回答一個問題,其餘交給程式判斷。模型下載支援中斷續傳,重新執行同一道指令即可從已下載的位元組繼續。
專案提供 Windows、Linux 與 macOS 三種路徑,Windows 使用者可直接下載壓縮檔並執行批次檔,缺少 Python 時程式會主動提供安裝選項。在 WSL 環境中,官方特別提醒模型目錄應留在 Linux 磁碟而非 Windows 掛載路徑,理由是後者的讀取速度明顯較慢。硬體不足時,啟動腳本會列出每個模型與目前機器的對應關係,並說明某個模型無法執行原因。
Colibri 的專家分層架構有什麼特點?
架構以測量到的路由熱度決定專家存放層級,形成逐層的 LRU 快取與學習式常駐集合,並以單次預讀取出三個矩陣,同時讓載入器與運算重疊,避免重複等待硬碟。
專案把這套機制比喻成權重的即時編譯器。編譯器不會一次編譯整個程式,而是觀察實際執行的熱路徑;Colibri 對權重採取相同策略,由測量到的路由熱度決定哪些專家取得顯示卡記憶體、系統記憶體或硬碟的位置。除了逐層的最近最少使用快取之外,還有一組從使用者自身對話累積而來的常駐集合,記錄在專案目錄下的使用統計檔中,並在每一輪對話後更新。
硬碟存取盡量避免重複。單一專家的三個矩陣以一次預讀取出,一組載入執行緒會在常駐專家運算的同時讀取缺少的部分,同一批位置也只讀取每個專家一次。專案另有路由預讀執行緒可提前取得下一層所需的專家,官方量測顯示 GLM-5.2 的路由在一層之前的可預測率達 71.6%。對使用快速 NVMe 硬碟的環境,官方建議實測直接 I/O 選項,因為它在部分裝置上有明顯效益,在另一些裝置上則沒有差異甚至更差。
Colibri 支援哪些模型與硬體後端?
目前有十三種引擎,涵蓋 GLM-5.2、Kimi K3、DeepSeek V4 Flash 等語言模型,另有繪圖與決策模型,後端支援 CPU、Vulkan 與 CUDA。
模型清單以大型混合專家模型為主。語言模型涵蓋 GLM-5.2 與 GLM-5.3、GLM-5.3-Flash、Inkling、Kimi K3、DeepSeek V4 Flash 與 V4.1 Flash、MiMo-V2.6 Flash 與 Pro、Qwen3.8-Flash-Next、Qwen3.6 與 OLMoE;繪圖模型為 Qwen-Image-2.1;決策模型包含 Laya、GLiNER2.5-Decide 與 Clef。官方在文件中列出每個模型的下載容量、記憶體下限與實測速度,並標明量測所用的機器規格。
硬體後端以處理器為基準,其餘皆屬加速選項。所有引擎都能在純 CPU 環境執行,顯示卡的角色是存放較熱的權重。Vulkan 後端支援 AMD、Intel 與 NVIDIA 顯示卡,包含整合式晶片;CUDA 後端適用於部分引擎,並提供顯示卡記憶體專家層與密集層鏈兩種使用方式;Apple Silicon 則透過 Metal 後端在統一記憶體上運算。官方坦言尚未自行量測獨立顯示卡的完整表現,目前的第一組數字來自社群回報。
Colibri 與 llama.cpp、Ollama、vLLM 有何不同?
Llama.cpp 為 131,606 顆星標,Ollama 為 183,721 顆,vLLM 為 94,067 顆。Colibri 以硬碟串流專家權重,超出記憶體仍可執行。
差異來自假設條件不同。llama.cpp 以 131,606 顆星標與 MIT 授權長期作為本地推論的基礎工具,Ollama 以 183,721 顆星標提供更簡化的模型管理體驗,vLLM 以 94,067 顆星標與 Apache-2.0 授權主打伺服器端的高吞吐量。這些專案的共同前提,是模型權重需要放進可用的記憶體或顯示卡記憶體之中。
Colibri 針對的則是模型遠大於記憶體的情境。當權重無法全部載入,傳統做法會改用較小的模型或較低的量化精度,代價是能力下降;這套引擎選擇接受較慢的速度,換取模型完整執行。官方在效能說明中給出實測區間,GLM-5.2 在 128 GB 記憶體的處理器環境為每秒 1.83 個詞元,在六張 RTX 5090 且專家全部常駐時為每秒 9.0 至 9.2 個詞元,而在最初開發所用的 25 GB 筆記型電腦上,冷啟動僅每秒 0.05 至 0.1 個詞元。
Colibri 的專案數據與維護規模如何?
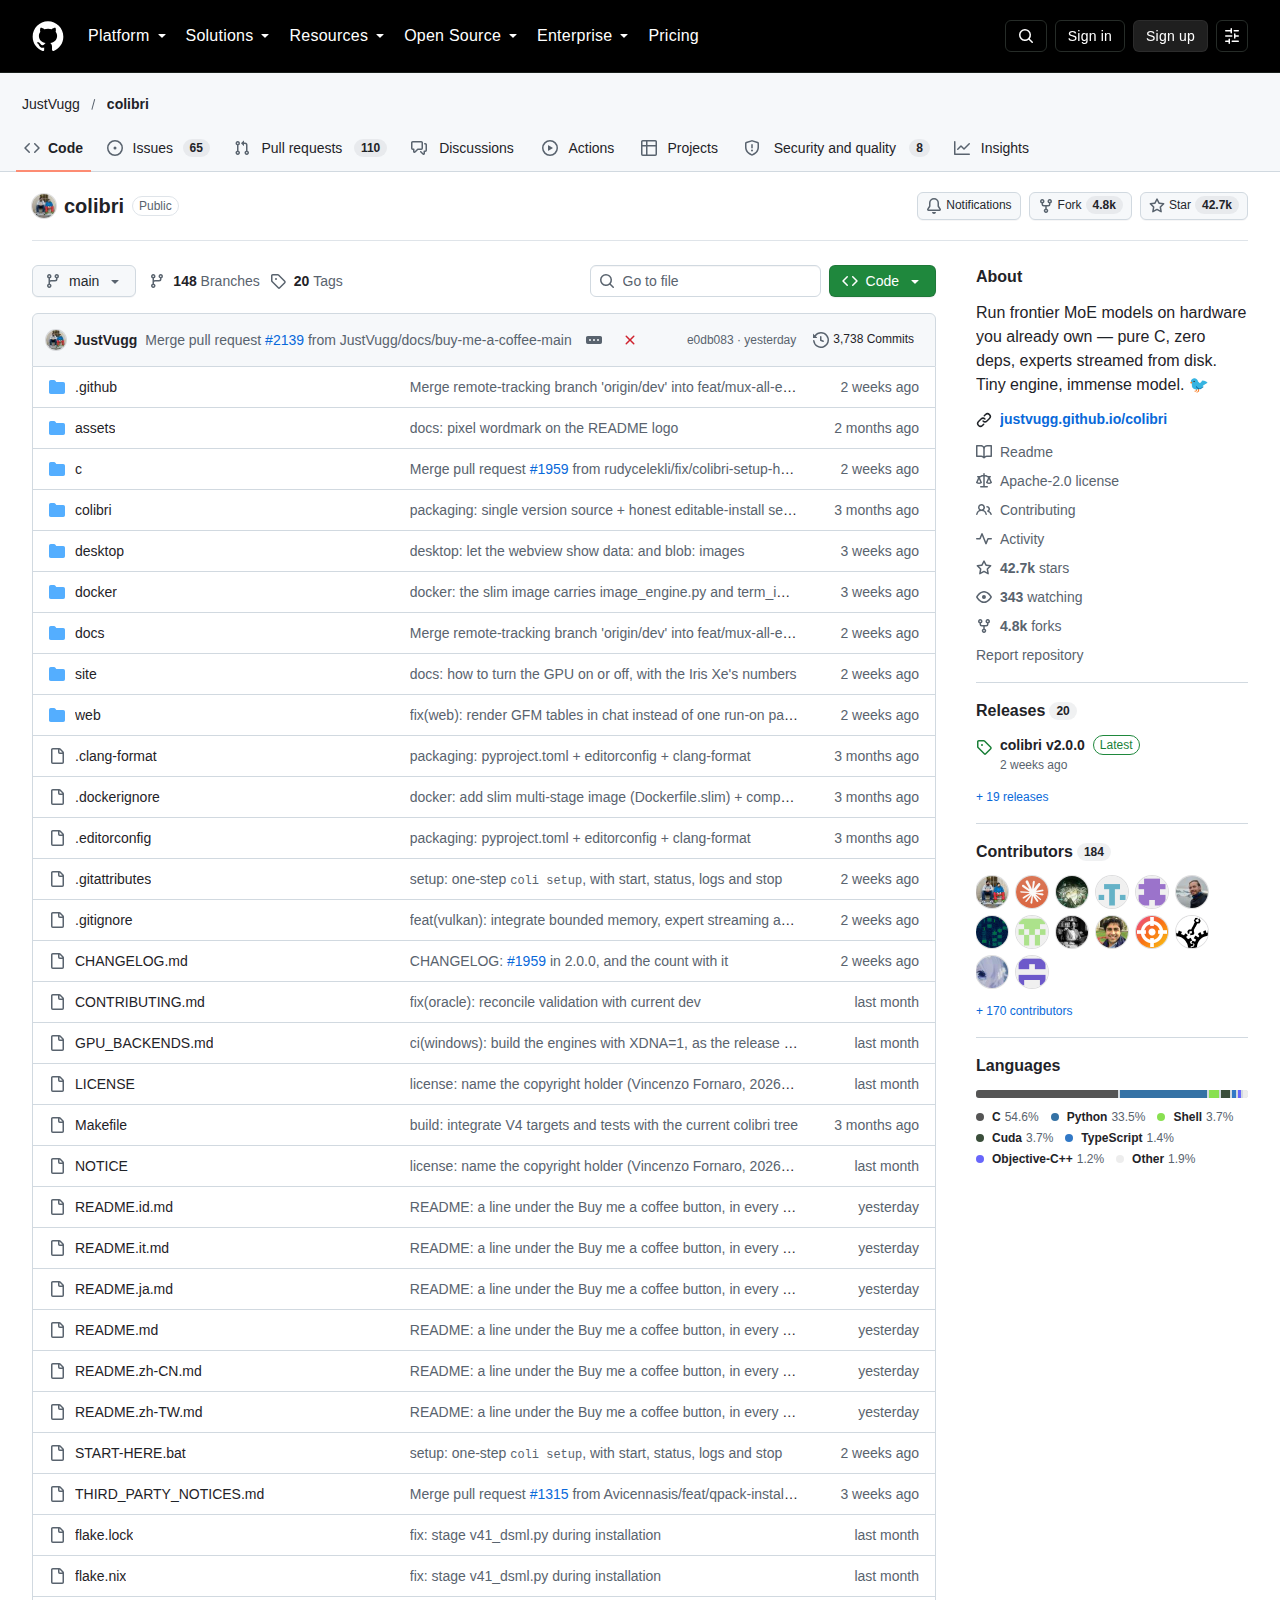
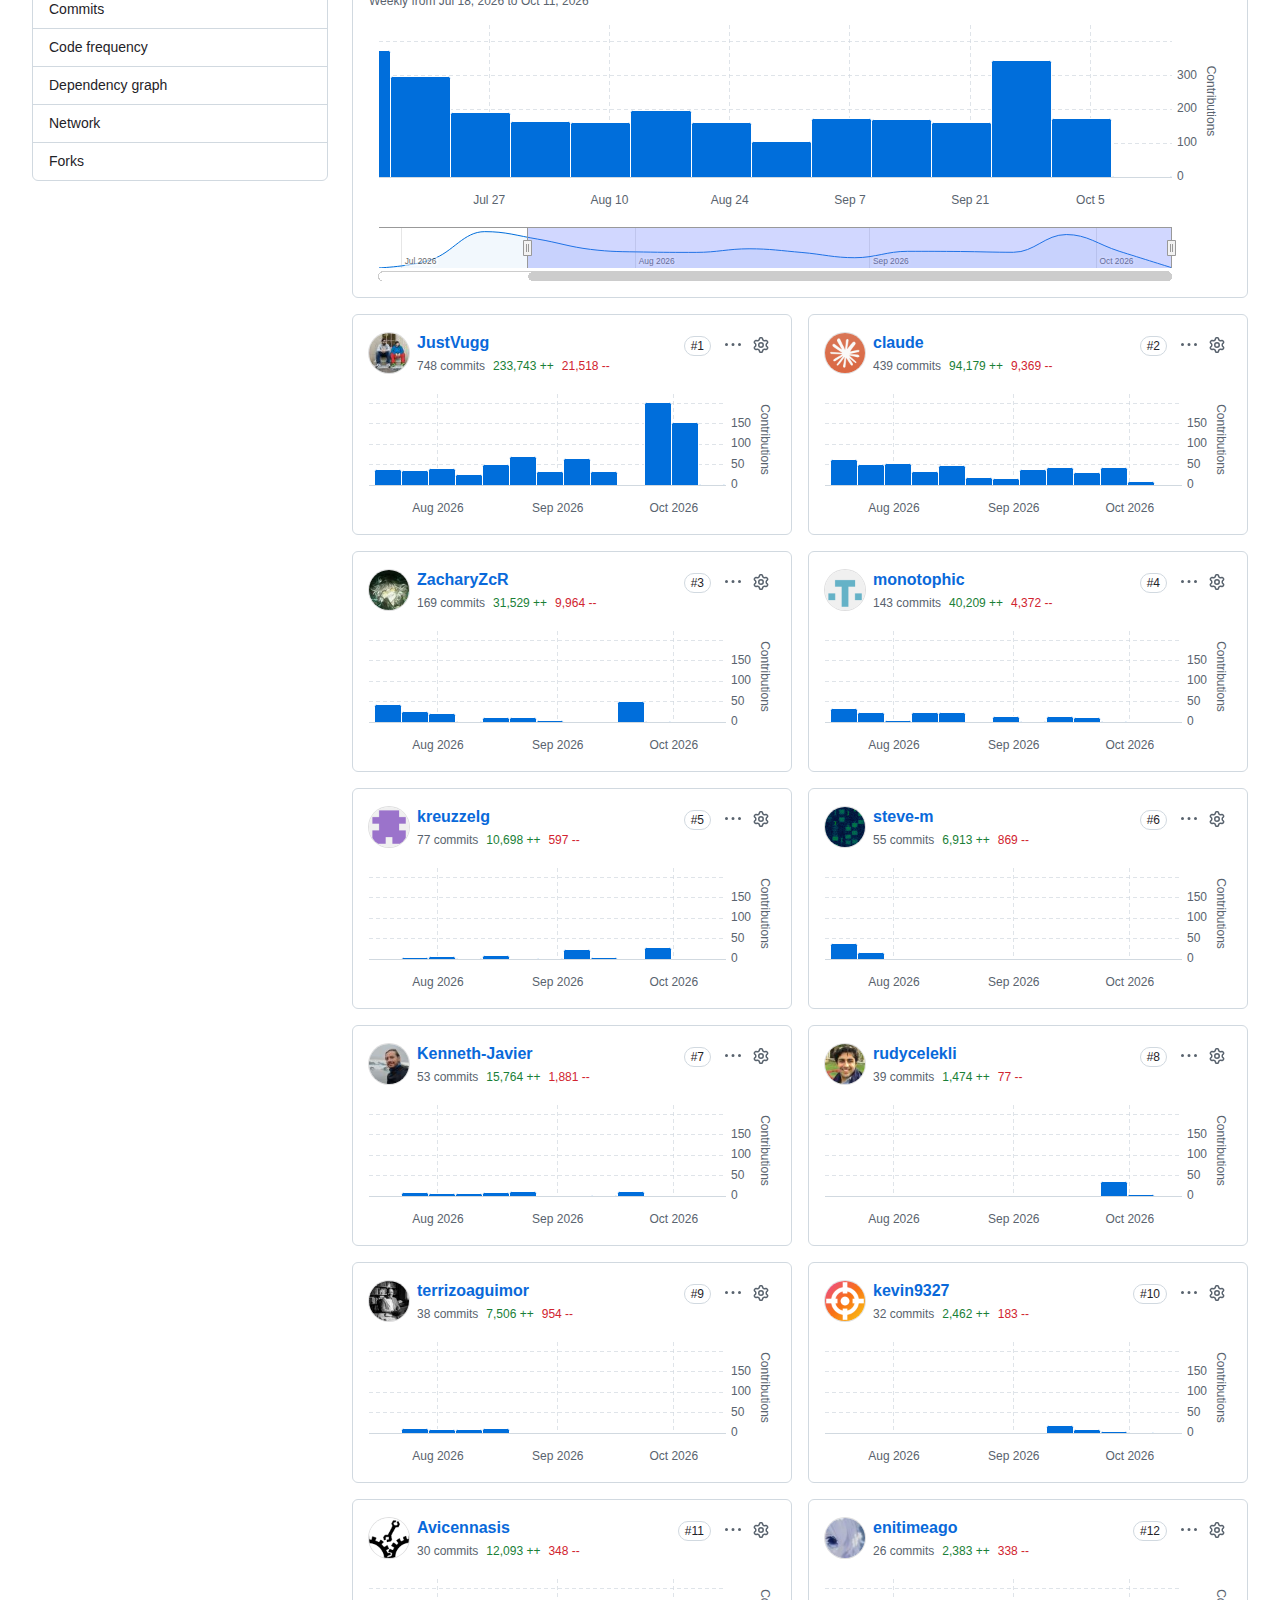
儲存庫累積 42,713 顆星標、4,775 次複製、3,738 次提交與 199 位貢獻者,以 Apache-2.0 授權釋出,撰寫語言為 C。
專案在三個多月內累積明顯的社群規模。儲存庫建立於 2026 年 7 月 1 日,至今有 4,775 次複製、343 位關注者與 199 位貢獻者,累積提交達 3,738 次,目前有 175 項未結議題,最近一次推送發生在 10 月 18 日。版本節奏偏快,20 次發布中最新一版 v2.0.0 於 10 月 6 日推出。
專案的技術選擇也反映在維護模式上。引擎以每個模型家族一個 C 檔案的方式組織,共用標頭檔,執行階段不使用 BLAS,也不依賴 Python;Python 只用於安裝程式、啟動器、轉換工具與 API 閘道。官方把專案同時定位為開放研究平台,主張任何最佳化都必須以可重現的端到端量測作為依據,並在文件中列出尚未驗證的假設與待完成的實驗。
出處連結有哪些?
本文資訊整理自 Colibri 的 GitHub 儲存庫與官方說明文件,內容涵蓋專案定位、安裝流程、專家分層架構、支援模型清單與實測效能數據。
- GitHub 儲存庫:https://github.com/JustVugg/colibri
- 專案網站:https://justvugg.github.io/colibri
- 版本發布紀錄:https://github.com/JustVugg/colibri/releases
- 快速入門文件:https://github.com/JustVugg/colibri/blob/main/docs/quickstart.md
- 效能量測表:https://github.com/JustVugg/colibri/blob/main/docs/benchmarks.md
總結:Colibri 適合什麼樣的使用者?
適合想在既有個人電腦上執行大型開源模型、且願意接受較慢速度的開發者與研究者;需要高吞吐量的正式服務環境,仍以 vLLM 等專用方案較為合適。
這套引擎的價值在於重新定義了可執行範圍。過去本地推論的實際門檻是記憶體容量,模型一旦超出就只能降級或放棄;把專家權重移到硬碟之後,門檻轉為硬碟容量與讀取速度,代價是回應變慢。對需要完整模型能力、又不具備高階硬體的使用者而言,這種交換具備實際意義。
選擇時仍需回到使用情境。若任務重視互動速度,較小的模型搭配顯示卡仍是效率較高的組合;若任務屬於批次處理、長文本分析或研究性質,能以時間換取模型規模的路線更為合理。專案目前仍在快速迭代階段,官方也公開列出多項待驗證假設,採用者宜同步關注版本更新與社群量測結果。
