LightRAG 是香港大學數據智能實驗室開源的圖譜檢索框架,在 GitHub 累積 40,312 顆星標與 5,721 個分支,採 MIT 授權。專案自 2024 年 10 月上線,論文入選 EMNLP 2025,最新穩定版為 2026 年 9 月 2 日的 v1.5.7,主打低呼叫成本與增量更新。
LightRAG 是什麼?
LightRAG 是香港大學團隊開源的圖譜檢索框架,把知識圖譜與向量索引放在同一套管線,以較少模型呼叫達到跨文件理解,並支援增量更新與選擇性刪除。
專案的自我描述是「輕量知識圖譜 RAG 框架,微軟 GraphRAG 的高效替代方案」。這句話點出兩個競爭軸線:一是成本,二是資料新鮮度。傳統向量檢索把文件切成片段,語意相近就取回,面對「整批合約的共同風險條款是什麼」這類需要全局視角的問題時,往往只能拼湊零散段落。圖譜路線改為先讓語言模型抽出實體與關係,建成網路,再沿關係鏈檢索,因此能回答跨文件、跨章節的問題。
代價原本很高。微軟 GraphRAG 的作法是對圖譜做社群偵測,再為每個社群生成摘要報告,索引階段需要大量模型呼叫,文件一改動就得重算。LightRAG 選擇不走這條路,改以雙層檢索與關鍵詞抽取取代社群摘要,把呼叫次數壓下來,同時讓局部更新成為可能。
LightRAG 的雙層架構如何運作?
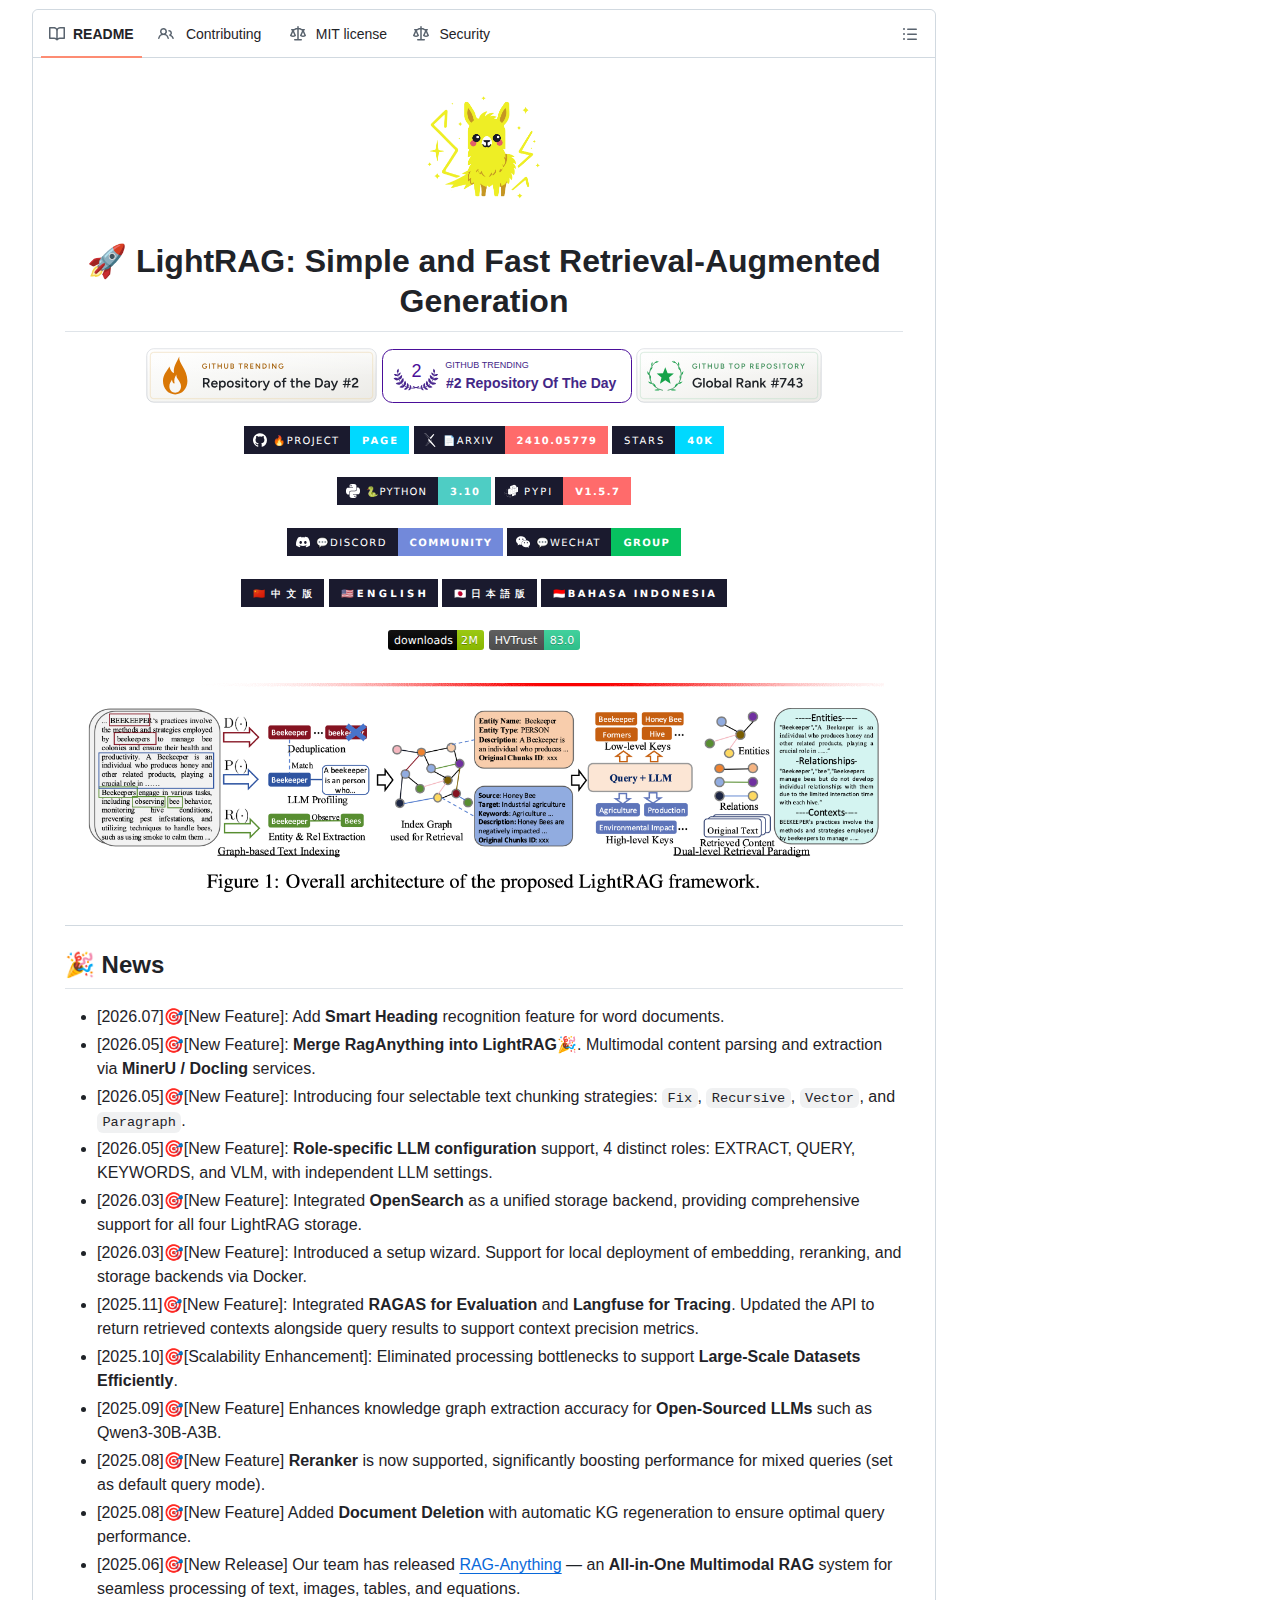
索引階段把文件切成塊,逐塊抽出實體與關係寫入知識圖譜,同時計算向量存入向量庫;查詢階段由低層取具體實體,高層取主題關聯,兩層結果合併後交給語言模型生成答案。
低層索引針對實體與其直接屬性,適合「這份報告提到的違約條款細節」這類指涉明確的問題。高層索引針對實體之間的關係鏈與主題分佈,適合「這批文件反映哪些監管趨勢」這類需要歸納的問題。兩層共用同一份抽取結果,因此索引只需執行一次。
檢索時系統會先用關鍵詞模型從提問中抽出關鍵詞,再分別在兩層圖譜與原始文本塊中查找,最後把候選內容一併交給查詢模型。這種設計讓檢索品質對嵌入模型的依賴降低,README 直言嵌入模型建議選用低維度、速度快的版本,本地部署可用 bge-m3。
文字切塊也影響圖譜品質。專案提供四種策略:固定長度、遞迴字元、向量語意、段落語意。其中段落語意為原生實作,會盡量讓切塊邊界對齊文件的標題、段落與表格,避免長表格被切斷後丟失表頭,這是實務上最常見的失敗點之一。
LightRAG 的增量更新與刪除如何處理?
新增文件只需處理新內容並併入既有圖譜;刪除文件時系統讀取索引階段留下的模型快取,重建受影響的實體與關係,不必整庫重算。
這正是圖譜 RAG 長期的痛點。社群式做法把實體聚成社群後生成摘要,一旦有文件變動,摘要就過期,重建成本隨資料量線性上升。LightRAG 把索引階段的模型輸出寫入快取,刪除時以快取為基礎反推受影響的節點,再局部修補。
對需要每日吸收新資料的場景,這個差異比參數規模更關鍵。法規追蹤、內部知識庫、客服文件庫都屬於持續變動的資料集,若每次更新都要重建索引,維運成本會迅速超過模型費用。
專案在 2025 年 11 月加入 RAGAS 評估與 Langfuse 追蹤,並讓介面在回傳答案時一併輸出檢索到的上下文,方便計算檢索精準度。這類可觀測性支援對生產環境的價值,往往高於新增功能。
LightRAG 有哪些查詢模式?
共五種:local 取局部實體、global 取宏觀關係、hybrid 合併兩者、naive 走純向量、mix 三者全開。預設 mix 品質最好,延遲略高於 naive。
local 模式適合明確對象的問答,例如查詢某項設備的保養週期。global 模式適合趨勢分析與跨文件歸納,代價是回傳內容較抽象。hybrid 把兩者結果併起來,適合問題同時包含具體名詞與宏觀判斷的情況。
naive 模式刻意繞過圖譜,只做向量相似度檢索,用途是提供對照基準,也讓使用者在圖譜抽取失敗時仍有退路。mix 模式則把三路結果全部合併,README 建議作為預設值,代價只是略高於 naive 的延遲。
實務上值得先確認的是索引是否真的建立成功。圖譜抽取依賴模型穩定輸出結構化 JSON,若模型在長文本中段開始漏欄位,圖譜會出現斷裂,此時查詢結果會退回接近 naive 的水準,而使用者難以察覺。
四種角色模型配置有什麼講究?
索引與查詢被拆成 EXTRACT、QUERY、KEYWORD、VLM 四個角色。抽取與關鍵詞必須用非思考型快速模型,查詢用更強的模型,視覺角色處理圖片與表格。
這種拆分是 LightRAG 與多數框架最大的操作差異。抽取角色對每一個文本塊都要執行一次,文件量大時呼叫次數可達數千次,README 明確要求關閉思考模式,並建議使用 GPT-5.6-luna、Claude Haiku、Gemini-mini 這類快速模型,本地部署則以 Qwen3-30B-A3B-Instruct 為合理下限。
查詢角色寫最終答案,面對的是大量且帶噪聲的檢索內容,因此需要比抽取模型更強的能力,思考型模型在此可以接受。關鍵詞角色只做短字串抽取,延遲敏感,必須用非思考模型。VLM 角色處理文件中的圖片與表格,本地可用 Qwen3.6-35B-A3B。
分角色配置的實際意義是可省下大量成本。若全流程都用同一顆旗艦模型,索引費用會放大數倍;把重複性最高的抽取步驟交給小模型,品質損失有限而費用顯著下降。這也解釋了為何該專案在只有 30B 級開源模型的條件下,仍能維持可用的檢索品質。
如何安裝與部署 LightRAG?
以 uv 安裝 lightrag-hku 的 api 版本,複製 env.example 為 .env 並填好模型設定,再啟動 lightrag-server,另備 Docker 路徑。
最短路徑是 uv tool install "lightrag-hku[api]",複製環境範本後啟動伺服器。若從原始碼建置,專案提供 make dev 一次安裝測試工具鏈與離線依賴,並建置前端;前端使用 bun,需另行安裝。
值得注意的是預設網路行為。伺服器預設綁定 0.0.0.0,且未設認證時所有端點皆公開,README 因此在安裝段落以顯眼方式提醒:在對外暴露前必須設定 LIGHTRAG_API_KEY,或改用 AUTH_ACCOUNTS 搭配 TOKEN_SECRET,否則應綁定 127.0.0.1 僅供本機存取。相容 Ollama 的 /api/* 路由預設保持開放以維持客戶端相容,若要一併加鎖需設定 WHITELIST_PATHS。
儲存後端的選擇也決定部署難度。預設的記憶體型鍵值、向量與圖譜儲存僅適合小規模測試,README 直接寫明不可用於生產。生產環境建議 PostgreSQL,亦可搭配 Neo4j、MongoDB、Milvus 或 OpenSearch;2026 年 3 月加入的 OpenSearch 支援四種儲存型態的統一後端,適合已在用該搜尋引擎的團隊。
與微軟 GraphRAG 相比差異在哪裡?
GraphRAG 以社群偵測加摘要換取全局理解,索引成本高且更新困難;LightRAG 改用雙層檢索與關鍵詞抽取,呼叫次數更少,並支援增量更新與選擇性刪除。
兩者都建立在「先把文件變成圖」的前提上,分歧在圖建成之後怎麼用。GraphRAG 會對圖譜做社群切分,再為每個社群產生一段摘要,查詢時先讀摘要再下鑽;這種分層摘要在處理「整個語料庫的主要議題」時表現突出,但摘要生成是索引階段最貴的一步。
LightRAG 保留圖譜但不生成社群摘要,改由實體與關係鏈直接回答。好處是索引輕、更新快、呼叫成本低;限制是面對極度宏觀的歸納問題時,缺少現成的摘要層可依賴,需要模型自行從關係鏈歸納。
生態位的差異也反映在維護狀態。微軟的 GraphRAG 已進入維護模式,不再接受新功能;LightRAG 則維持每月級別的版本節奏,2026 年 7 月至 9 月連續發布 v1.5.5 至 v1.5.7,近 30 日仍有 34 次提交。對需要長期跟隨的團隊,後者的活躍度是實際考量。
LightRAG 有哪些使用限制與風險?
嵌入模型一旦索引便不可更換,換模型需重建全部向量;抽取品質高度依賴模型穩定性,長文本易出現圖譜斷裂;預設部署無認證,直接對外暴露風險明確。
嵌入模型的鎖定是最容易被忽略的陷阱。README 明言嵌入模型必須在索引前確定,一旦變更需重新嵌入全部文本塊、實體與關係,而專案目前未提供重嵌入工具。部分後端如 PostgreSQL 在建表時就固定向量維度,換模型等同刪表重建。
圖譜抽取的穩定性則是品質上限。抽取步驟要求模型輸出結構化結果,模型能力不足或提示過長時容易漏掉欄位,圖譜就會出現缺口。專案建議對抽取角色關閉思考模式,並在大型資料集上調整併發與逾時設定,這些參數直接影響抽取完整度。
第三項風險是營運安全。專案具備檔案讀寫與系統操作能力,預設綁定所有介面且無認證,若部署在公網或內網多端可達的環境,可能被掃描器發現並觸發高風險操作。這與同類代理框架的通病一致,防護責任落在部署者身上。
星標與開發數據反映什麼?
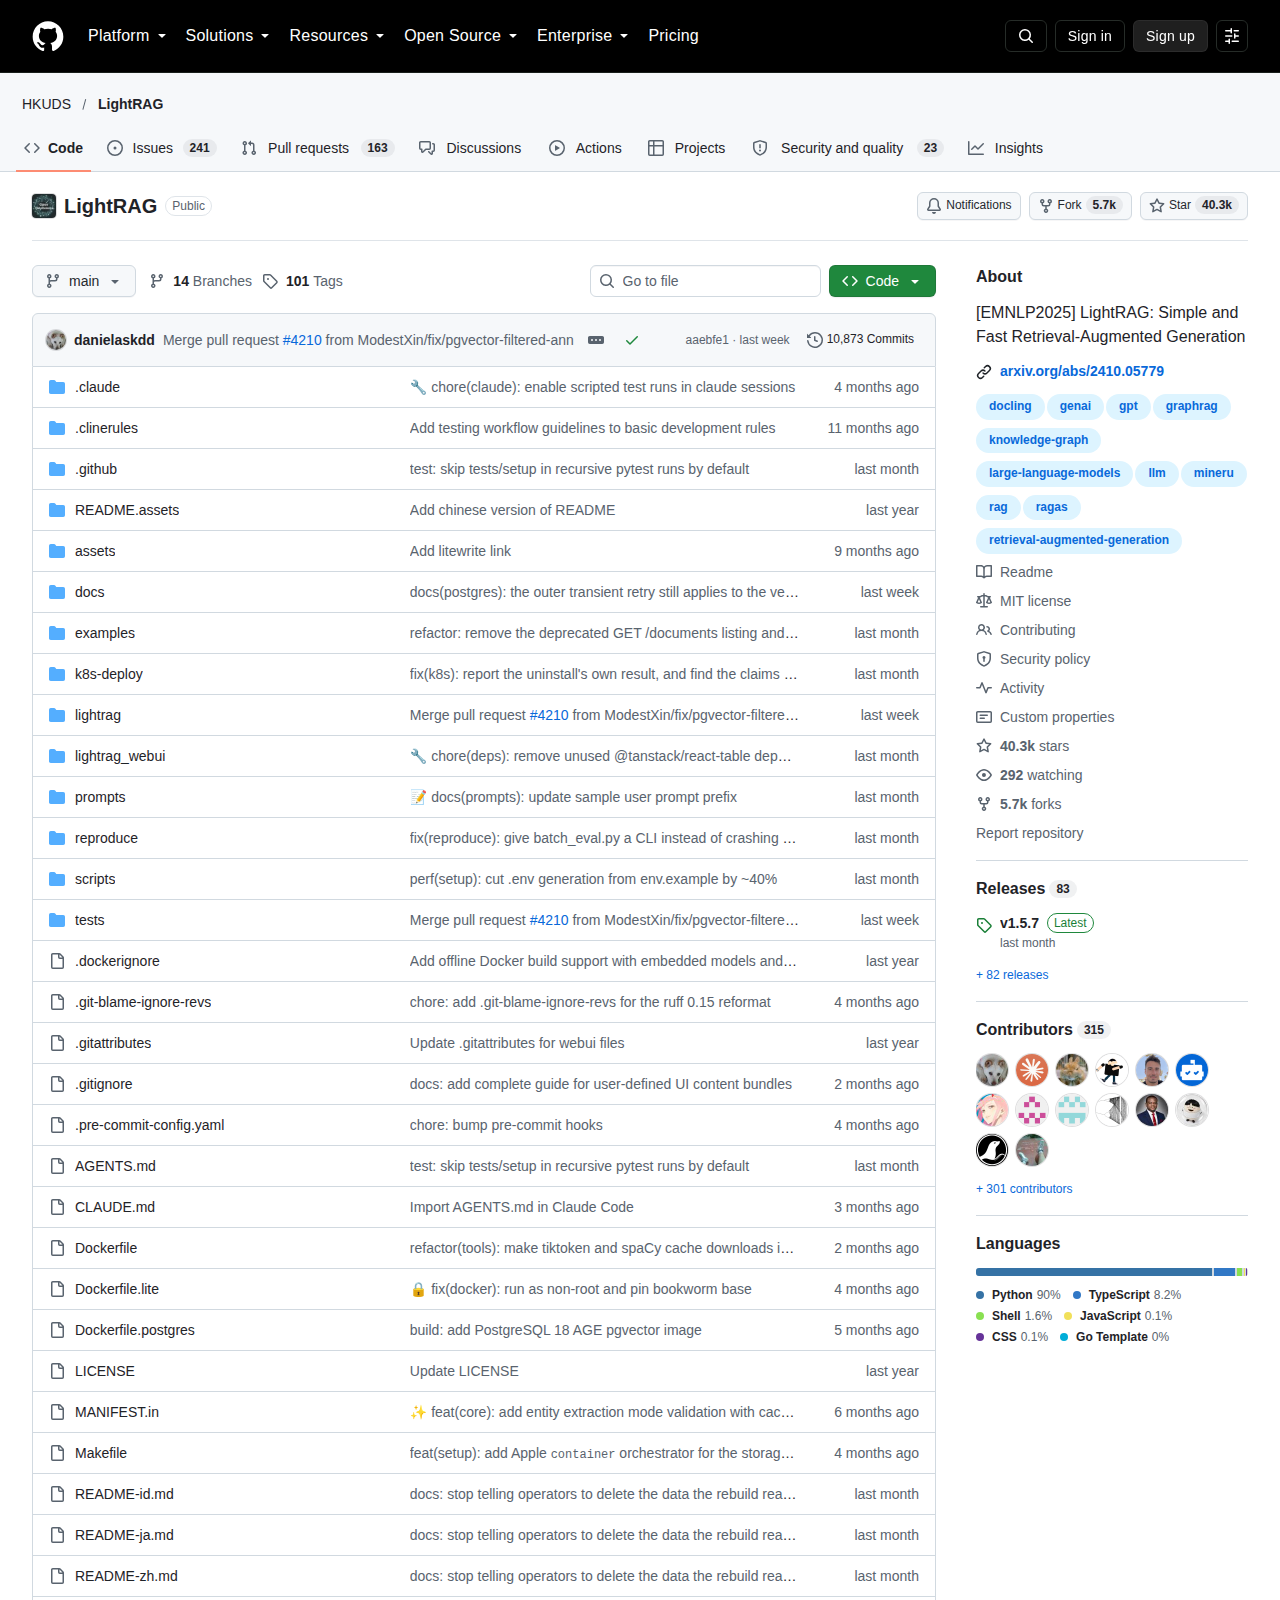
專案累積 40,312 顆星標、5,721 個分支與 292 位關注者,未結問題 404 項,近 30 日提交 34 次,315 位貢獻者,採 MIT 授權並以 Python 撰寫。
星標對分支比約為 7 比 1,明顯低於教學型專案常見的 20 比 1。這個比例說明大量使用者不只是按讚,而是實際分叉準備改造或內嵌到自家系統。對一個需要接上企業資料源的框架而言,這種使用深度是合理訊號。
貢獻者規模同樣值得注意。315 位貢獻者對應 40,312 顆星標,密度高於多數同星級專案,反映專案已形成穩定的外部回饋循環,而不是單一實驗室輸出。未結問題 404 項則顯示維護壓力存在,使用者在選型時應預期部分邊緣情境需要自行處理。
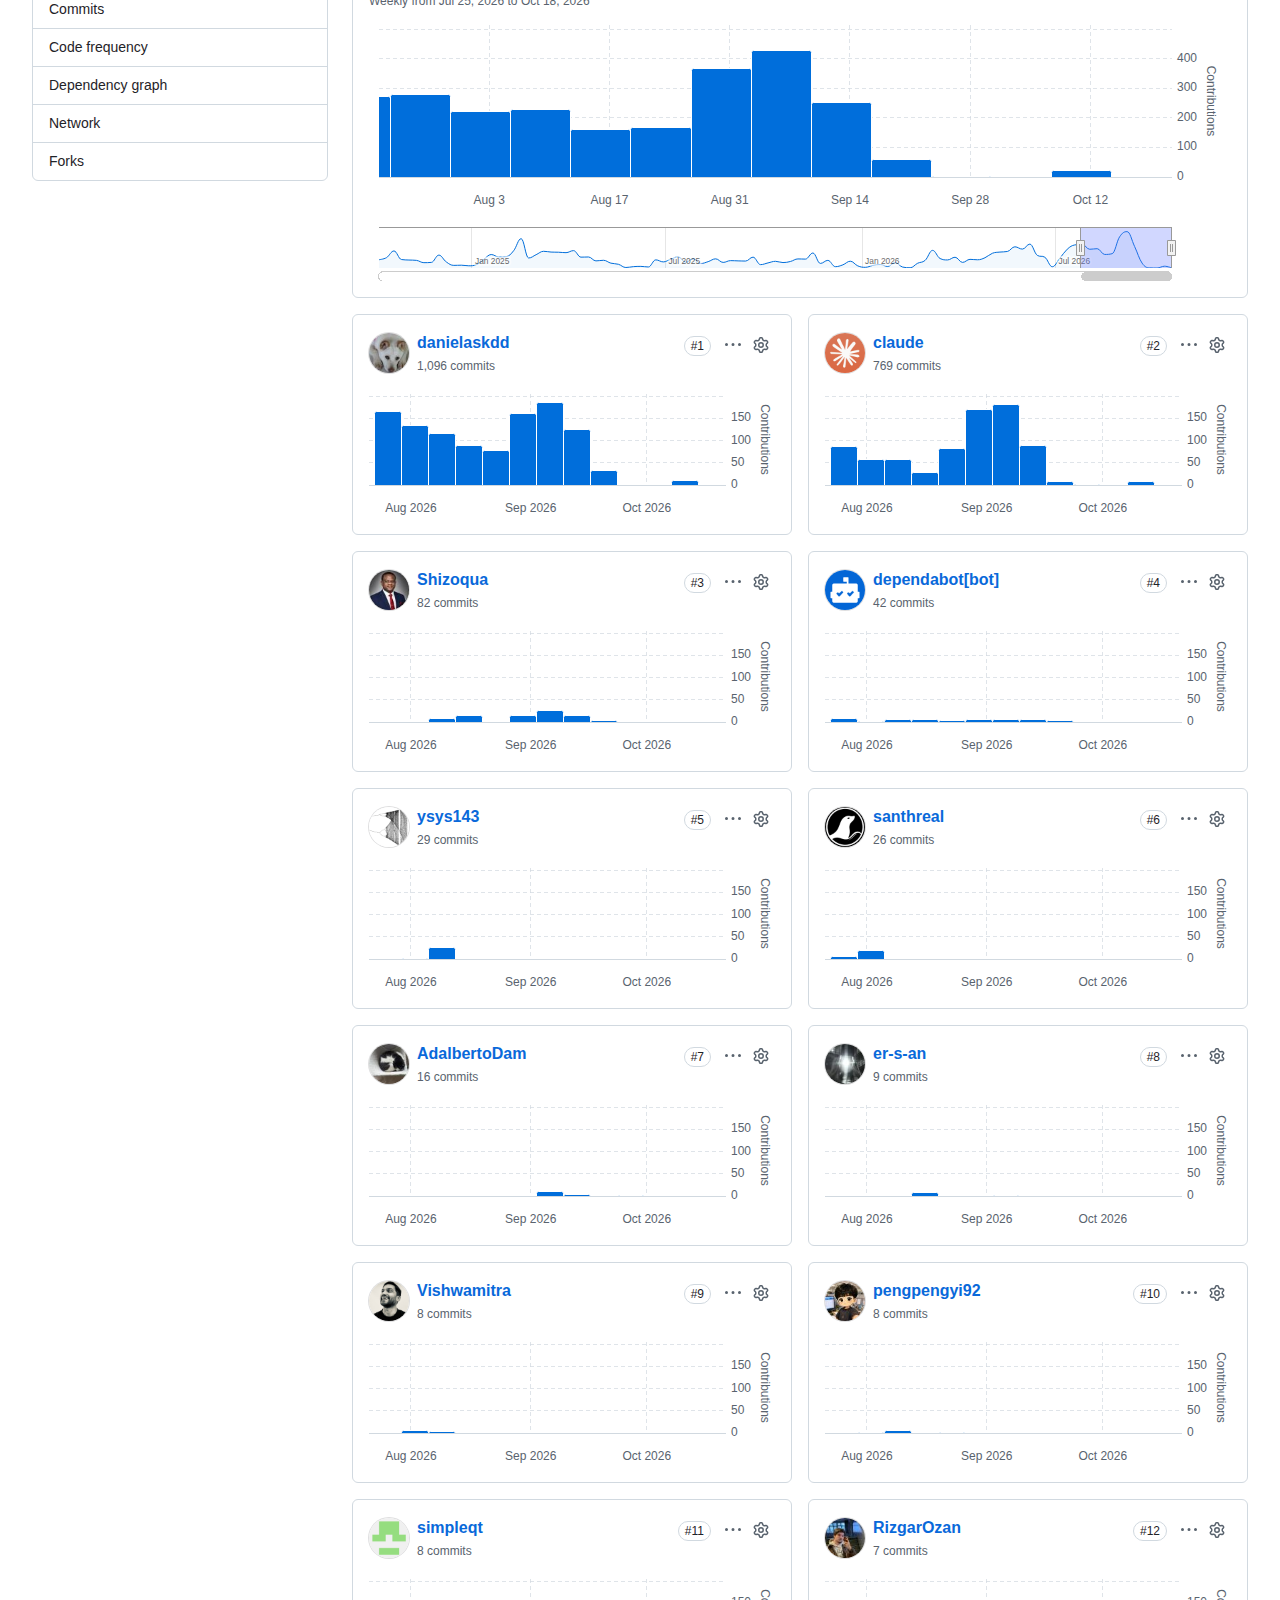
版本節奏亦提供訊號。2026 年 7 月底至 9 月初連續三個穩定版本,中間穿插兩個候選版,說明維護團隊採用先發候選、再收斂為穩定版的流程。這種節奏對需要評估升級風險的團隊較友善,可先在候選版驗證相容性。
出處連結有哪些?
原始碼在 GitHub 的 HKUDS/LightRAG,論文編號 arXiv 2410.05779,PyPI 套件名為 lightrag-hku。
主要入口是 GitHub 儲存庫 https://github.com/HKUDS/LightRAG,README 提供英文、中文、日文、印尼文四種版本。安裝套件名稱為 lightrag-hku,與儲存庫名稱不同,初次使用者常在此混淆。
技術細節可參考 EMNLP 2025 論文 arXiv 2410.05779,內容涵蓋雙層檢索的設計動機與基準測試。同實驗室另有 RAG-Anything、MiniRAG、VideoRAG 三個延伸專案,分別處理多模態文件、小模型場景與長影片理解,已在 v1.5 起併入主線的多模態管線。
總結:LightRAG 適合什麼團隊?
適合資料持續變動、需要跨文件理解又要控制模型成本的團隊;若追求開箱即用的託管服務或極簡部署,則此專案仍需自行處理儲存後端與抽取品質調校。
LightRAG 的價值不在功能數量,而在它對圖譜 RAG 成本結構的重新設計。把索引拆成可快取、可局部修補的步驟,讓知識圖譜從一次性研究專案變成可長期維運的資料資產,這是 40,312 顆星標背後的真實需求。
採用前應確認三件事:團隊是否具備 PostgreSQL 或等效儲存後端的維運能力、是否有可穩定輸出結構化結果的抽取模型、以及是否接受圖譜品質需要持續調校。若答案皆為肯定,此專案可顯著降低跨文件問答的單位成本;若期待零設定上線,商用託管方案仍是更省時的選擇。
