騰訊開源的 WeKnora 在 2026 年 10 月 23 日累積三萬五千零七十九顆星標,主要語言為 Go。它把企業文件處理拆成三個介面:以檢索增強生成回答問題、以代理執行多步任務、把文件整理成可瀏覽的 Wiki,三者共用同一套知識庫。最新版 v0.8.3 於 10 月 14 日發布,距上一版僅三週。
WeKnora 是什麼?
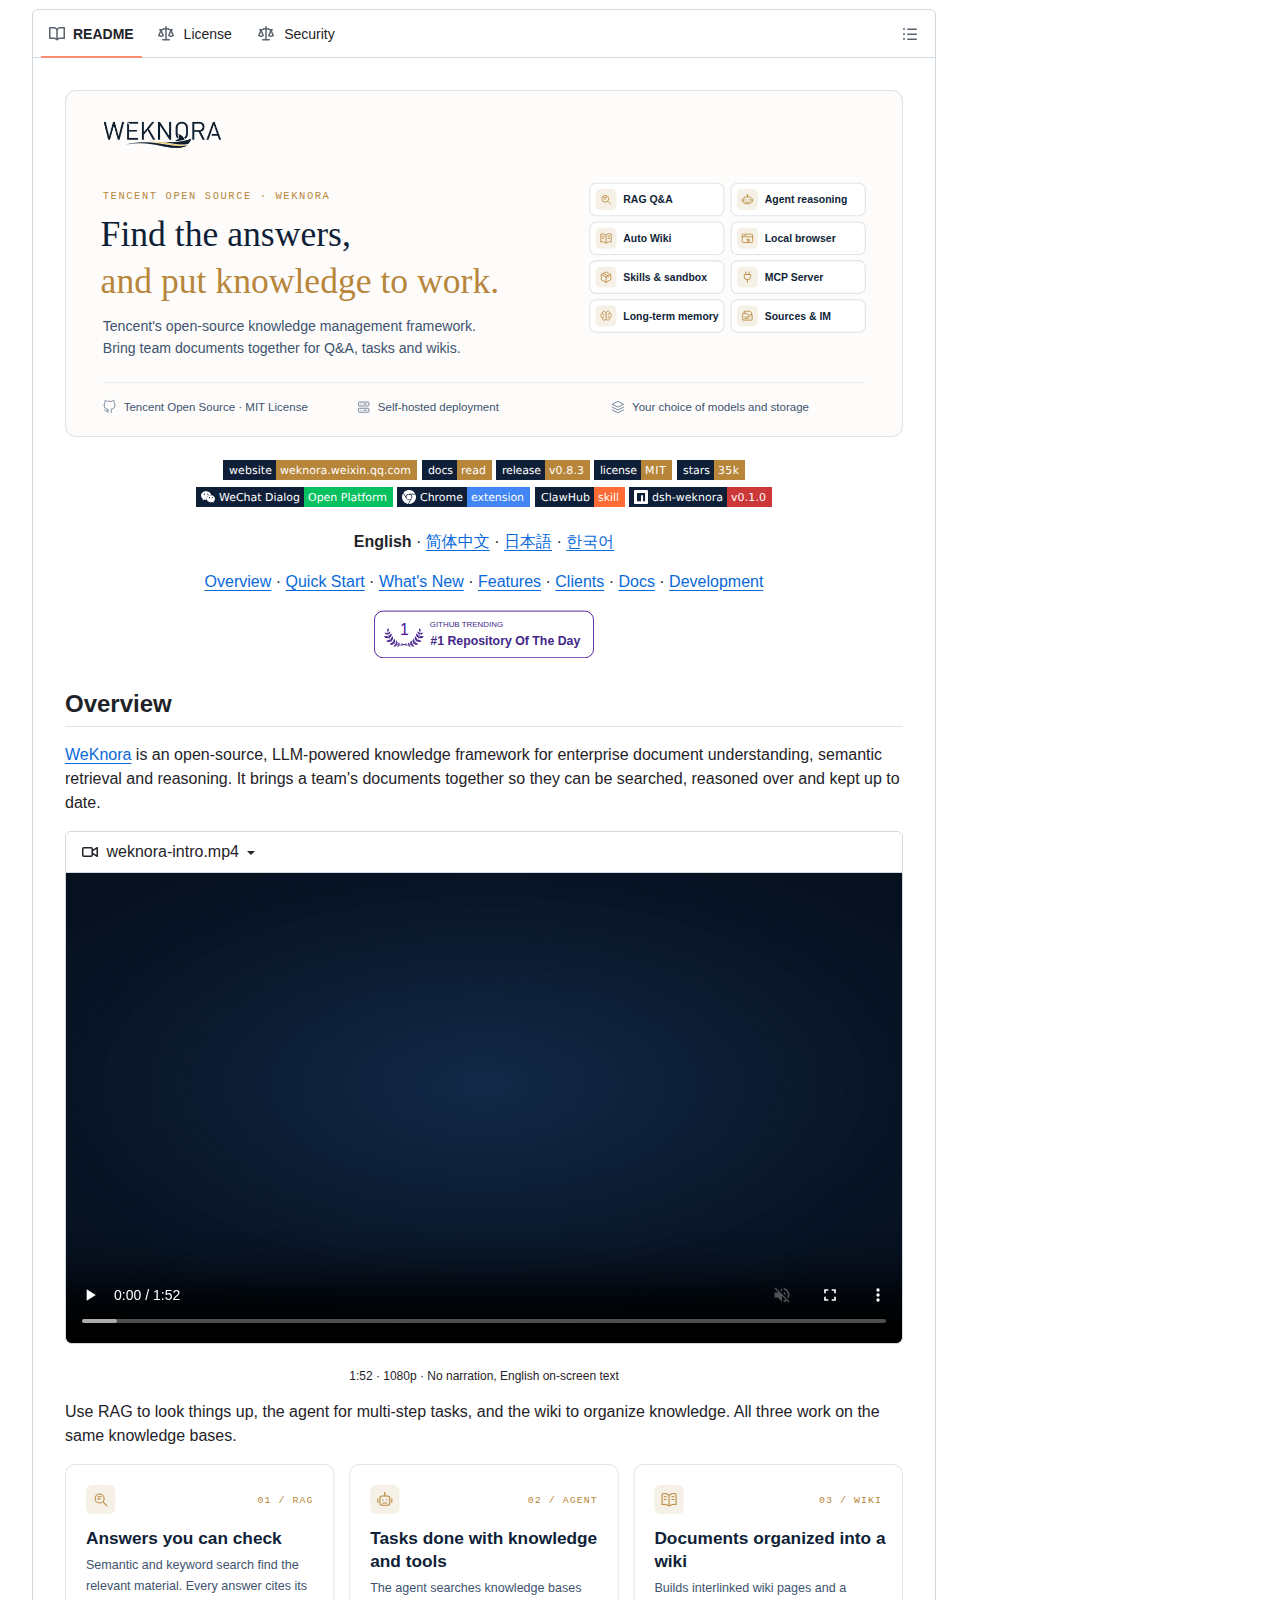
WeKnora 是騰訊開源的企業知識框架,以同一套知識庫同時支援 RAG 問答、代理推理與自動生成 Wiki,可部署於本地或私有雲,採 MIT 授權。
專案的自我定位是「以大型語言模型驅動的知識框架」,處理的對象是企業內部文件的理解、語意檢索與推理。它不把自己包裝成單一聊天應用,而是把文件解析、向量化、檢索與推論組成一條可替換元件的管線,並在這條管線上提供三種使用介面。
這個定位決定了它的設計取向。多數開源知識庫問答工具以「上傳文件、提出問題」為終點,WeKnora 則把後續的維護工作納入範圍:文件被檢索的同時,其中的實體與概念會被抽成 Wiki 條目,條目之間以知識圖譜連結,每次修改都可回滾。對於知識會持續變動的組織,這一點比單次問答的準確度更關鍵。
專案掛在騰訊的 GitHub 組織之下,官方網站使用 weixin.qq.com 網域,並同時提供微信對話開放平台的託管問答服務、企業微信與微信小程式的接入方式,顯示其設計場景與微信生態高度相關。儲存庫以 MIT 授權釋出,GitHub 的授權識別欄位顯示為「其他」,屬於系統未能自動歸類的情況,實際條款以儲存庫內的 LICENSE 檔為準。
WeKnora 為何把問答、代理與 Wiki 放在一起?
三者解決知識生命週期的不同階段:問答處理取用、代理處理執行、Wiki 處理整理。共用同一知識庫可避免文件重複上傳與版本分裂,答案、任務與條目都指向同一份來源。
知識管理系統的典型失敗並非檢索不準,而是文件進入系統後失去維護。問答層把文件當成只讀的語料,回答完即結束;文件改版之後,舊答案仍留在快取與對話記錄裡,錯誤於是被反覆引用。
WeKnora 的做法是讓三種模式共用一條解析管線。同一批文件在問答模式提供帶引用的答案,在代理模式作為工具與背景知識,在 Wiki 模式被拆解成有目錄結構的頁面。當文件更新,三處同時受影響,版本只有一份。
Wiki 模式值得單獨說明。系統從知識庫抽取人物、產品與概念,生成帶來源引用的頁面,頁面按目錄組織,並以知識圖譜呈現彼此的關係。使用者可以直接編輯頁面,每次變更都有差異比對與回滾。這使 Wiki 不只是文件的另一個視圖,而是一層由模型起草、由人校訂的中間結構。
代理模式則把知識庫接到工具鏈上。代理可以呼叫網路搜尋、MCP 服務、技能與使用者本機的瀏覽器,在需要時回頭查閱知識庫。官方文件把這個組合稱為推理式問答,與單純的檢索問答分開,差別在於代理會根據中間結果調整下一步,而不是一次取回就作答。
WeKnora 的技術架構有什麼特點?
架構以可替換元件為原則:模型、向量資料庫、物件儲存與解析器皆可獨立更換。核心服務以 Go 撰寫,前端以 TypeScript 開發,資料存於 PostgreSQL。
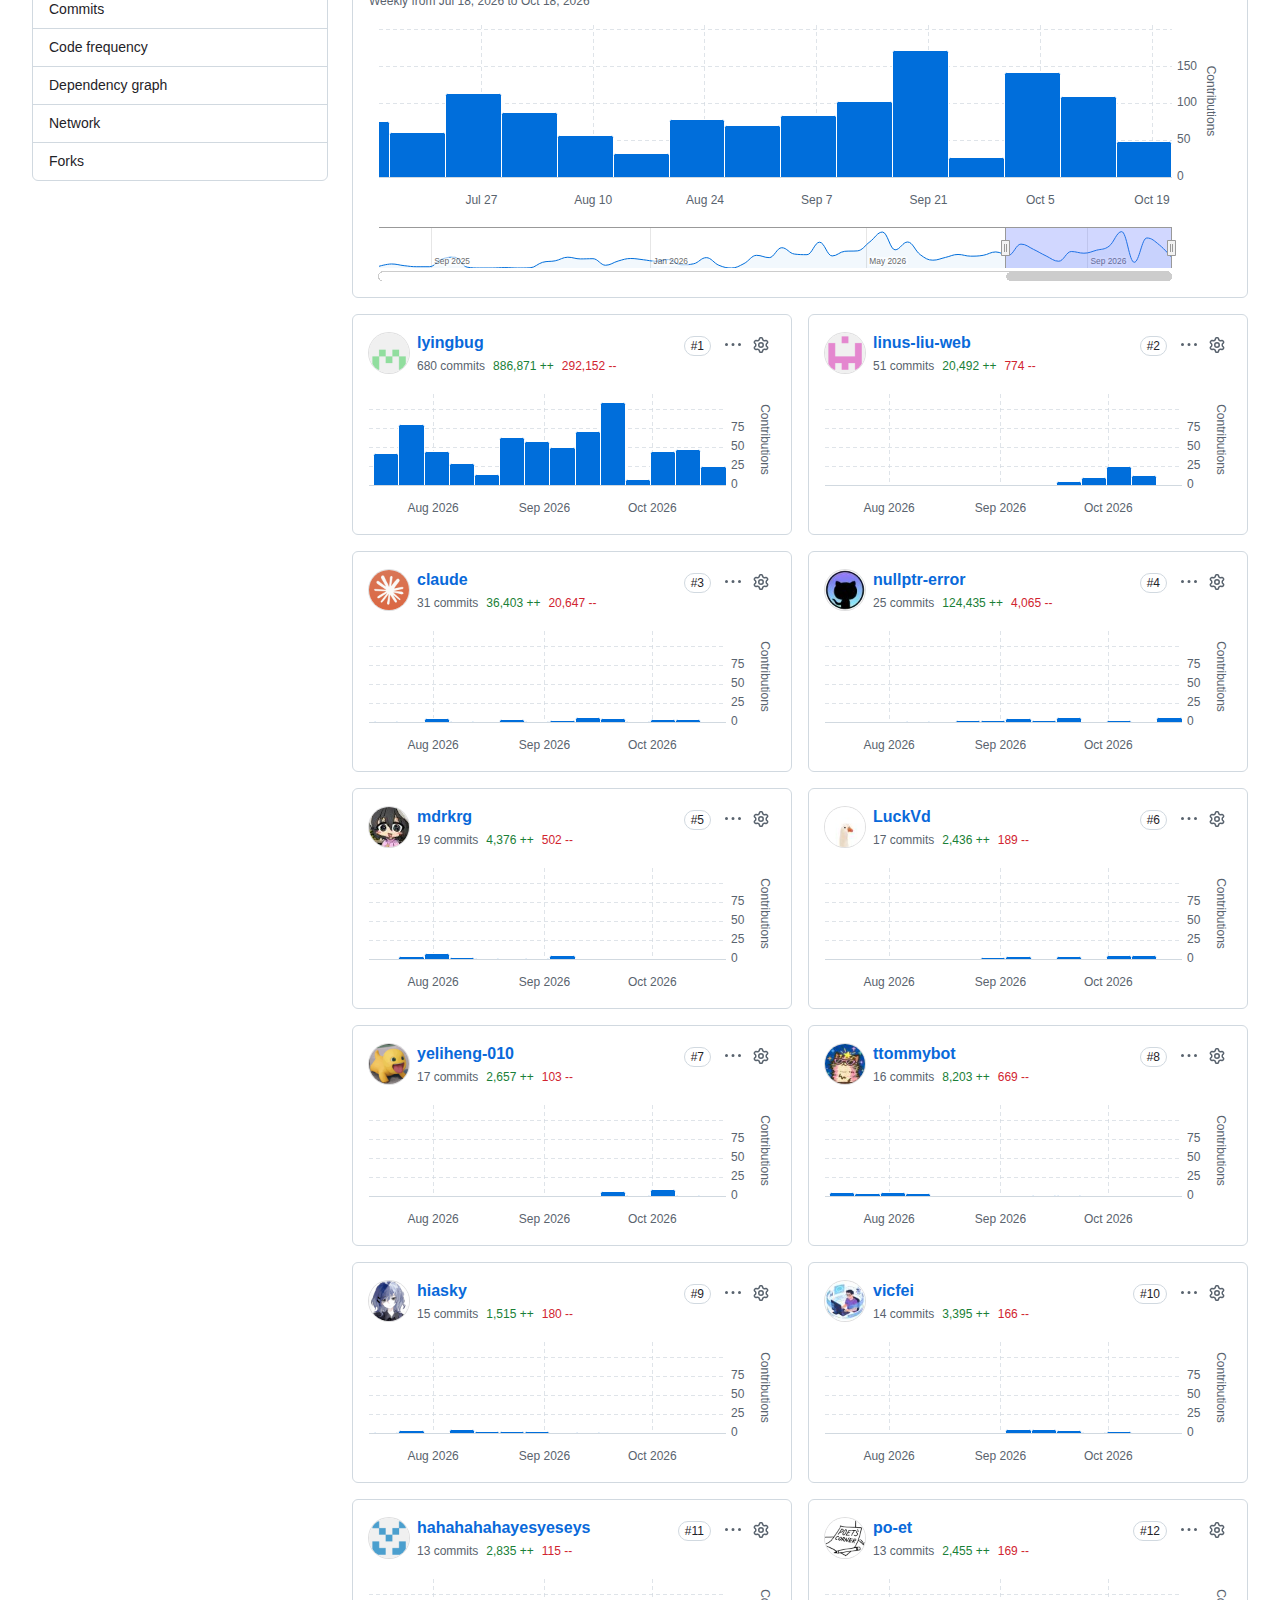
儲存庫語言組成反映出這個分工:Go 約三千六百萬位元組,TypeScript 約三千五百萬位元組,其餘為樣式、Rust 與前端資源。後端承擔解析、檢索與代理執行,前端承擔知識庫管理、對話與 Wiki 編輯介面,兩者規模相當,說明這是一個完整的應用而非函式庫。
可替換性是架構敘述中最反覆出現的主張。模型層內建 29 家供應商,包含 OpenAI、Azure OpenAI、Anthropic、DeepSeek、通義千問、智譜、混元、豆包、Gemini、MiniMax、NVIDIA、SiliconFlow、OpenRouter、LiteLLM 與 Ollama;嵌入層支援 Ollama、BGE、GTE、智譜與 OpenAI 相容介面;向量層可選 PostgreSQL 的 pgvector、Elasticsearch、OpenSearch、Milvus、Weaviate、Qdrant、Apache Doris 與騰訊自有的 VectorDB。
物件儲存同樣開放,涵蓋本地檔案系統、騰訊雲 COS、MinIO、AWS S3、火山引擎 TOS、阿里雲 OSS、金山雲 KS3 與華為雲 OBS。這種全面開放的做法在中國廠商主導的專案中並不常見,通常自建知識平台會把儲存與模型層綁定自家雲服務,WeKnora 則把綁定降為預設值而非唯一選項。
檢索層的設計值得細看。系統提供關鍵詞與向量的混合檢索、重排序、父子區塊切分,以及基於 Neo4j 的 GraphRAG。混合檢索解決的是單一向量檢索在專有名詞與編號上的弱點,父子切分則讓檢索以子區塊為單位提高精度,同時以父區塊為單位保留上下文。專案另附端到端評估,指標包含召回率與 BLEU、ROUGE,讓團隊可以在自己的語料上量化調整效果,而不是倚賴通用基準。
WeKnora 的 v0.8.3 帶來了哪些更新?
v0.8.3 加入多模態向量檢索、引用段落跳轉至原始檔,並補上平台使用者管理、邀請註冊、模型目錄主控台與繁體中文介面。
多模態檢索是這次更新中最具結構意義的一項。系統開始支援把文字與圖像編碼到同一向量空間的嵌入模型,包含騰訊自家的 WeMM-Embedding 與 Qwen3-VL-Embedding,並允許選擇性啟用圖像向量檢索、圖像感知重排序,以及為視覺模型提供圖像上下文。既有知識庫維持關閉,需明確開啟並重新解析文件才會生效,掃描版 PDF 頁面暫不納入。
引用導航解決的是另一個長期痛點。過去點擊引用只會顯示文字片段,現在可以直接在原始 PDF、Office 文件、Markdown、TXT 與 EPUB 中定位到被引用的段落,音訊引用會跳到對應時間戳。舊文件在重新解析前仍以文字比對退回,這種漸進式遷移減少了升級阻力。
維運面的補強同樣明顯。平台使用者管理讓管理員可以列出使用者、建立帳號、停用帳號、重設密碼與指派系統管理員,停用會即時撤銷工作階段,並拒絕自我停用與停用最後一位管理員。邀請註冊模式則把「僅限邀請」與「邀請可註冊」兩種語義分開,解決舊版本中邀請制與公開註冊混用的問題。
介面語系新增繁體中文,範圍包含 Seafile 連接器的翻譯。對繁體中文使用團隊而言,這是一個實際的採用門檻降低,因為知識庫產品的設定項密集,英文介面會讓非技術成員難以參與維護。
WeKnora 支援哪些部署方式與模型選擇?
支援 Docker Compose、Helm 與單一執行檔的 Lite 版三種部署,可完全離線。模型可接 29 家雲端供應商,也可用 Ollama 本地模型,資料留在自有環境。
最簡部署路徑是三個步驟:複製儲存庫、複製環境變數範本、啟動容器。啟動後開啟本機位址即可進入引導流程,Web 介面位於 80 埠,後端 API 位於 8080 埠,選用的 Langfuse 追蹤服務位於 3000 埠。官方另提供 Helm 章程供 Kubernetes 叢集部署,以及單一二進位檔的 Lite 版與桌面應用程式。
模型配置是採用過程中最容易低估的一環。專案文件覆蓋約一百五十個環境變數與約三百六十個 API 端點,官方也坦言設定項密集。對只想快速驗證的團隊,建議先以單一雲端模型與 pgvector 起步,確認解析與檢索流程順暢後再擴充;對資料不能出境的組織,則可用 Ollama 搭配本地嵌入模型,整套流程在內網完成。
資料來源的接入範圍決定了導入成本。系統支援飛書 Wiki 與雲端硬碟、Confluence、GitLab、騰訊 IMA、Notion、語雀、釘釘文件、Seafile 與 RSS 的自動同步,其中 Confluence 支援目錄層級與私有圖片,語雀支援目錄樹層級,Seafile 支援增量檢查點與可選的刪除對帳。對文件散落在多個協作平台的組織,這一層往往比模型選擇更影響實際成效。
頻道整合則處理最後一哩。問答可直接在企業微信、飛書、Slack、Telegram、釘釘、Mattermost、QQ 機器人與微信中進行,另有網站嵌入元件、內建 MCP 伺服器供 Cursor 與 Claude 等工具取用知識庫,以及附範圍控制的 API 金鑰供程式化存取。
WeKnora 與同類知識平台有何分別?
同類方案多以工作流程編排或純檢索為核心,WeKnora 的重心在文件生命週期:同一知識庫同時產出答案、任務與可編輯條目,並具備四角色權限與稽核記錄。
開源知識庫領域大致分成三類路線。第一類以工作流程編排為核心,讓使用者以視覺化方式串接節點,優點是彈性高,缺點是知識庫本身較薄。第二類以純檢索為核心,專注解析與召回品質,不做應用層。第三類是應用型方案,功能完整但綁定特定模型或雲服務。
WeKnora 站在第三類但試圖避開綁定。它的差異點在於把企業維運需求當成第一等公民:四種角色的工作區權限、逐資源的擁有者、逐工作區的稽核記錄、AES-256-GCM 憑證加密、帶白名單模式的 SSRF 防護出站請求,以及可同時掛載多個儲存實例。這些功能在個人專案導向的開源工具中通常缺席。
另一個差異是任務佇列的可觀測性。系統提供文件解析時間軸,逐階段顯示進度與失敗原因,並有任務佇列儀表板列出排隊與失敗的任務,搭配 worker pool 治理。當知識庫規模上升到數萬份文件,解析失敗若無從定位,整個專案就會停擺;把這層做成介面而非日誌,是企業場景的必要條件。
需要說明的是,功能廣度本身也構成取捨。同類方案在單一環節的深度可能更高,例如專注解析品質的工具在複雜表格與掃描檔上更成熟,專注編排的工具在流程分支上更靈活。WeKnora 的優勢在於把這些環節串成可維運的整體,代價是每個環節的預設值未必是市場最強。
WeKnora 有哪些限制與風險?
設定項密集,約一百五十個環境變數對小團隊形成門檻;七百七十二個待處理議題反映節奏緊湊;商用前應核對授權條款;完整文件以中文為主。
第一項限制是複雜度。完整部署涉及關聯式資料庫、快取、物件儲存與向量引擎,官方雖提供 Lite 版與桌面應用,但企業功能如多工作區權限、稽核與資料來源同步仍以完整部署為前提。對只有數百份文件的小團隊,這套架構的多數能力處於閒置狀態。
第二項是專案節奏帶來的穩定性成本。v0.8.2 到 v0.8.3 之間有二百八十二次提交,版本說明列出大量行為變更,其中包含邀請註冊語義調整、工具清單空值的語義改變,以及資料庫遷移編號的推進。這種速度對跟進最新功能有利,但對需要長期穩定的生產環境,升級前必須詳讀升級說明並先在測試環境驗證。
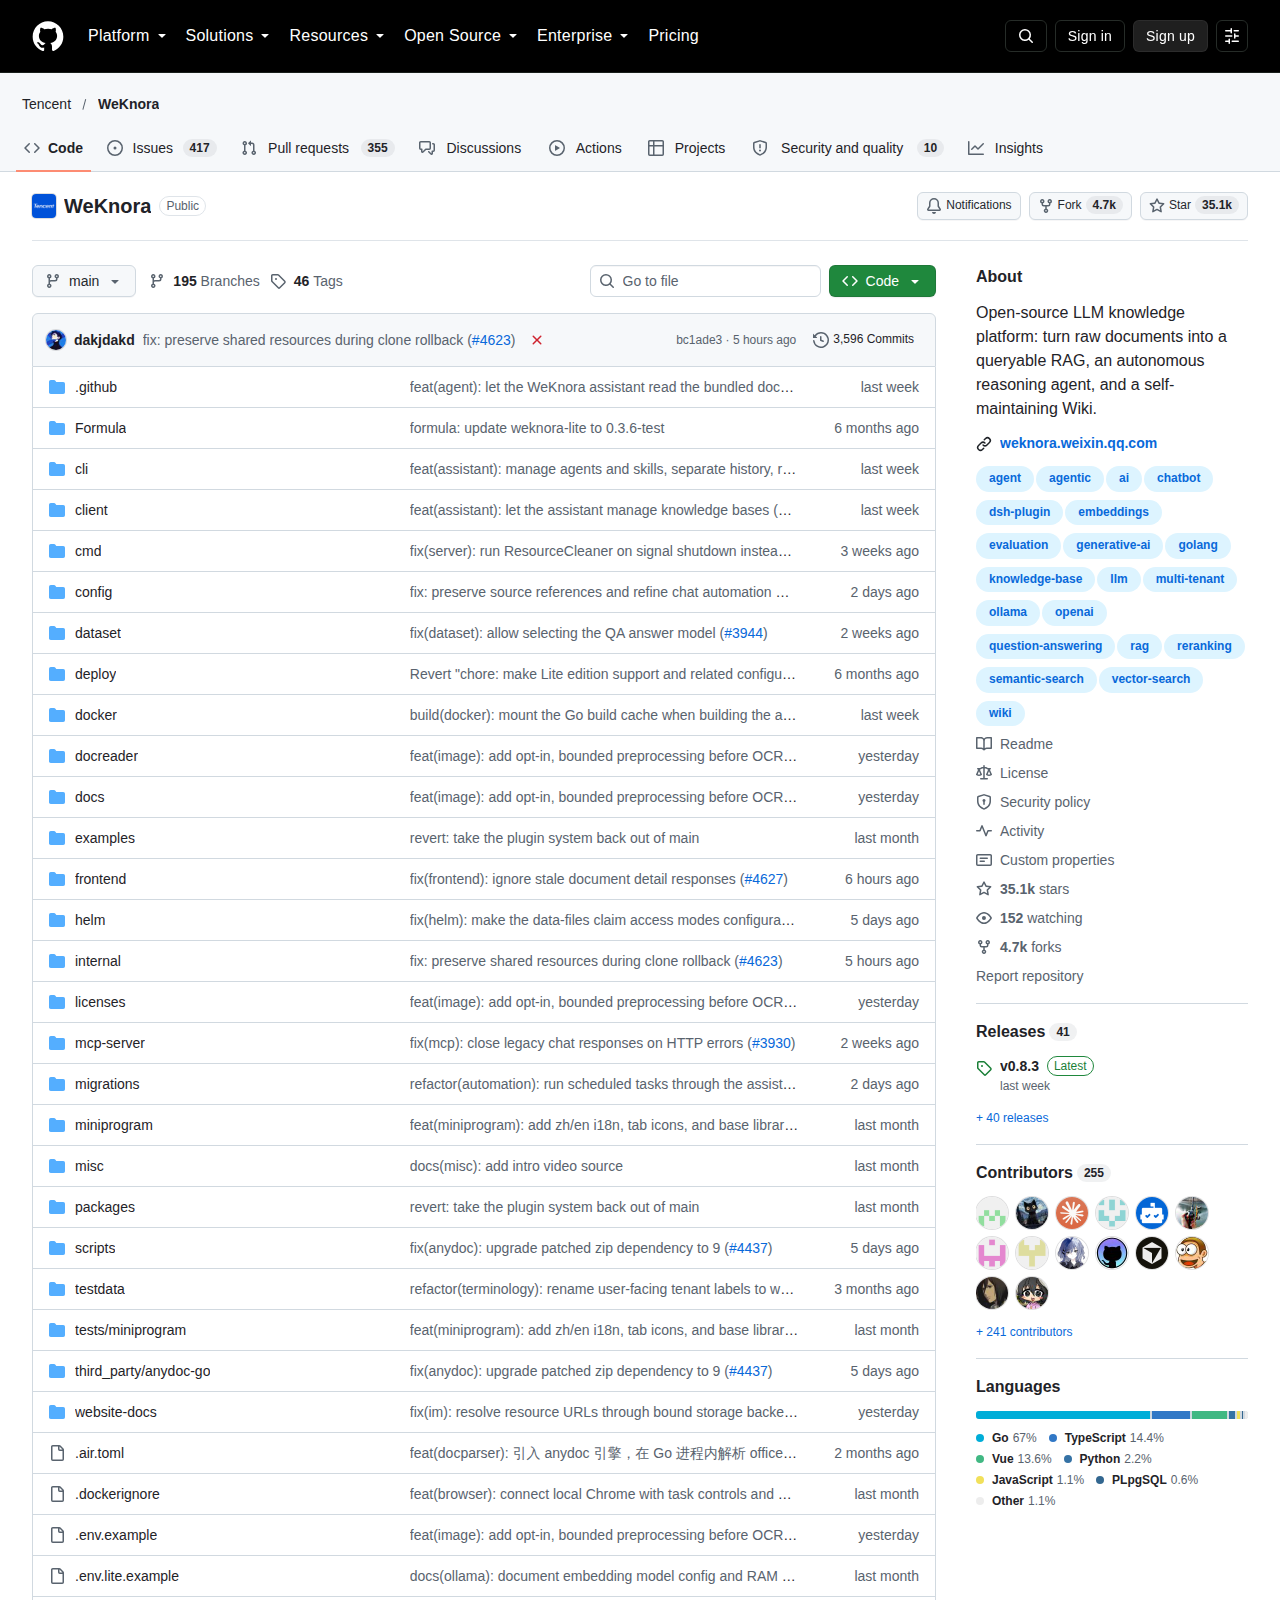
第三項是議題負荷。儲存庫目前有七百七十二個待處理議題與約三百一十三位貢獻者,核心維護集中在少數帳號。專案同時提供託管服務與雲端部署範本,商業模式清晰,但也意味著部分需求會優先服務雲端路線。
第四項是文件語言分佈。完整產品文件以中文為主,英文 README 只覆蓋概覽與快速開始,日文、韓文與俄文版本更精簡。對非中文團隊,深入設定仍需依賴翻譯或原始碼閱讀,這是採用時應預留的時間成本。
WeKnora 適合哪些團隊使用?
適合文件量大、來源分散且需要內部問答的組織,例如法務、技術支援與研究團隊;資料不能出境的機構亦適用。文件量少於數百份時,輕量工具更划算。
最直接對應的場景是技術支援與客服。產品手冊、故障排除文件與歷史工單散落在多個平台,值班人員需要在一分鐘內找到正確條款;帶引用的檢索問答能把答案與出處一併給出,Wiki 模式則讓重複出現的問題逐步沉澱為條目。
法務與合規是第二類場景,需求集中在引用精度與權限控管。四角色權限與稽核記錄讓敏感文件只對特定角色可見,逐資源擁有者則避免文件在工作區之間被無意共享;引用跳轉至原始檔的功能,讓每次回答都能回到條文核對。
研究與顧問團隊的需求偏向長篇文件的交叉比對。GraphRAG 與知識圖譜在這一類場景提供額外價值,因為答案往往藏在實體關係裡,而非單一頁面。多模態檢索開啟後,簡報與掃描圖表中的資訊也能進入檢索範圍。
反向來看,三類團隊應先評估其他方案。文件量在數百份以內、且只需偶爾問答的團隊,導入成本高於收益;完全沒有維運人力的團隊,難以承擔資料庫、向量引擎與升級維護;需要廠商 SLA 與責任承擔的關鍵業務,則應直接考慮官方託管服務,而非自建。
如何快速開始使用 WeKnora?
以 Docker Compose 複製儲存庫、複製環境變數範本並啟動容器,開啟本機位址即進入引導。先接一個雲端模型與 pgvector 驗證流程,再擴充資料來源。
git clone https://github.com/Tencent/WeKnora.git
cd WeKnora
cp .env.example .env    # 依檔案註解調整
docker compose pull
docker compose up -d
啟動後開啟本機位址,依引導建立第一個知識庫並上傳文件。若使用本機 Ollama 模型,需先啟動服務,並在設定中把基礎位址指向主機;容器內的 localhost 指向容器本身,連線到主機服務時需改用主機閘道位址。
驗證順序建議由小到大:先上傳一份結構清晰的 PDF,確認解析、切塊與引用都正常,再導入整個資料夾並觀察解析時間軸;接著接入一個真實資料來源,確認增量同步與刪除對帳的行為符合預期;最後才調整向量引擎與重排序參數。這個順序能把問題侷限在單一環節,避免一次導入全部元件後難以定位。
對需要在程式中呼叫的團隊,官方提供 Go SDK 與 agent-first 的 CLI。CLI 每個指令預設輸出穩定的 JSON 封套,錯誤碼對應退出碼,適合放進自動化流程;另有內建 MCP 伺服器,可把知識庫發佈給 Cursor、Claude 等支援 MCP 的工具。
出處連結有哪些?
本文資料來源為騰訊的 WeKnora 儲存庫、v0.8.3 版本說明與更新日誌,以及官方網站上的產品文件與架構說明。
- GitHub 儲存庫:https://github.com/Tencent/WeKnora
- 官方網站:https://weknora.weixin.qq.com
- 產品文件:https://weknora.weixin.qq.com/docs/
- v0.8.3 版本說明:https://weknora.weixin.qq.com/docs/07-releases/v0.8.3
- 命令列工具:https://github.com/Tencent/WeKnora/tree/main/cli
總結:WeKnora 適合什麼團隊?
WeKnora 把知識的取用、執行與整理放在同一條管線上,適合已有文件規模且具備維運能力的組織。若只求快速問答或缺乏維運人力,輕量工具更合適。
三萬五千餘顆星標與每三至四週一個版本的節奏,說明這個專案已走出實驗階段。它選擇的路線並非在單一環節追求極致,而是把解析、檢索、代理、Wiki 與企業維運串成一個可替換元件的整體;這個選擇讓它在同類方案中具備少見的完整度,也讓導入門檻相應提高。
真正的評估重點不在功能清單,而在知識的更新頻率。若組織的文件一年只更新數次,任何檢索方案都能應付;若文件每週變動、且答案錯誤會帶來實際成本,那麼把 Wiki 與回滾機制納入設計的價值就會顯現。這也是 WeKnora 與多數開源知識庫問答工具最根本的分野。
對正在評估自建知識平台的團隊,務實的做法是先以 Docker Compose 跑一遍真實語料,量測解析成功率與引用準確度,再決定是否投入維運人力。專案的 MIT 授權降低了試用成本,但長期成本取決於團隊能否跟上它的版本節奏。
