serviette 是由 Pathway 團隊開源的無程式碼檢索增強生成(RAG)伺服器,在程式碼託管平台累積 58,791 顆星標與 1,511 次複製,採 MIT 授權。此專案以一份 YAML 設定檔取代程式碼,讓文件問答系統與向量資料庫之間的同步由資料流引擎處理,文件的新增、修改與刪除會在數秒內反映到答案之中。本文依據儲存庫公開說明、官方文件與專案公布的基準測試結果整理,說明其架構、檢索設計、實測數據與部署限制。
serviette 是什麼?
它是 Pathway 團隊開源的無程式碼 RAG 伺服器,以單一 YAML 設定串接文件與向量資料庫,問答隨文件變動即時更新,採 MIT 授權,累積 58,791 顆星標。
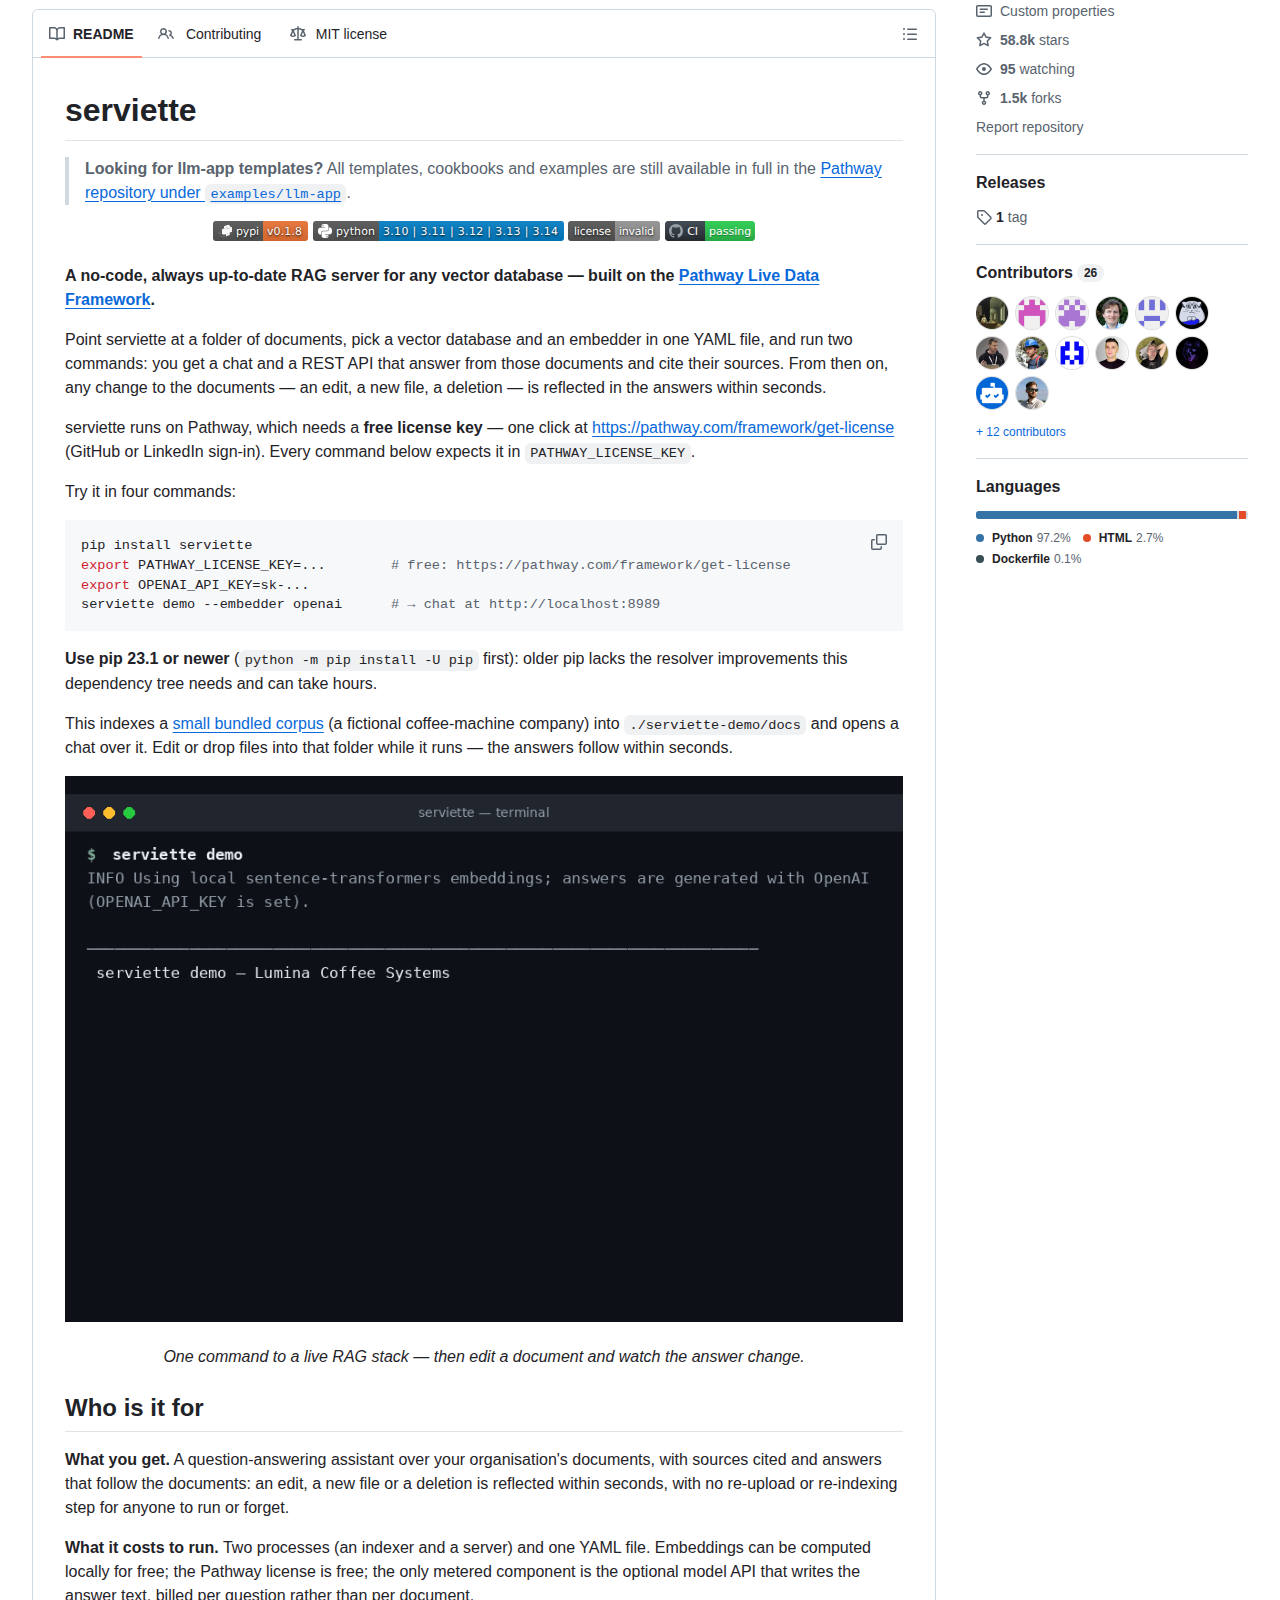
此專案的定位是為組織內部文件提供一套可自行維運的問答服務。使用者把 serviette 指向一個文件資料夾,在設定檔中指定向量資料庫與嵌入模型,啟動後即可取得聊天介面與 REST API,兩者都能依據文件內容回答並附上來源。專案強調的不是提示工程,而是資料的即時性:文件一旦被編輯、新增或刪除,答案會在數秒內跟著改變,過程中沒有需要人工執行的重新上傳或重建索引步驟。
專案本身並非從零建構的引擎,而是一層薄包裝。它建立在 Pathway Live Data Framework 之上,把監看檔案、解析內容、產生嵌入與寫入向量資料庫等工作交給該框架的差異化資料流引擎處理。這種做法讓 serviette 專注在設定、路由與服務層,也讓它的成熟度與底層引擎的發展歷程連動。
儲存庫建立於 2023 年 7 月,早期以 Pathway 儲存庫中的 llm-app 範本形式存在,其後獨立為專案並改以設定檔驅動。目前預設分支為 main,最新標籤為 v0.1.8,未結議題 8 個,並開放討論區供使用者提問。
serviette 的架構有什麼特別之處?
索引器與 API 伺服器是兩個獨立程序,僅以向量資料庫作為介面。伺服器無狀態可水平擴展,索引器可用多個 worker 分片,任一方重啟都不影響另一方運作。
系統被切成寫入路徑與讀取路徑兩半,兩者互不溝通。索引器負責監看來源、解析文件、計算嵌入並寫入向量資料庫;伺服器則在收到問題時計算查詢嵌入、檢索候選段落並產生答案。由於只有資料庫是共同契約,索引器停止運作時服務仍可依最後同步的資料回答,伺服器停止時索引仍持續更新。
這種切分同時帶來擴展與隔離的效果。伺服器是無狀態且唯讀的,可以在負載平衡器後執行多個實例,每個實例也一併提供聊天介面;索引器則可透過一行設定指定 worker 數量,讓大量重建作業不至於拖慢查詢服務。專案在基準測試中以八個 worker 程序執行,並指出任一方都能獨立重啟,索引器會從既有的持久化狀態續跑而不重新嵌入。
資料庫的所有權是另一項設計取向。向量以明文且有文件記載的結構存放於使用者自行選擇的儲存後端,其他工具可以直接讀取同一份集合,專案不將資料鎖在自己的格式內。唯一的例外是內嵌的 DuckDB 後端,它以單一檔案換取零安裝成本,代價是單一寫入者與較低的並行能力。
它支援哪些向量資料庫與資料來源?
支援八種向量後端,含預設的內嵌 DuckDB 與 pgvector、Qdrant、Pinecone 等;來源涵蓋本機檔案、Google Drive 與 S3。
後端清單包含 DuckDB、pgvector、Qdrant、Milvus、ChromaDB、Weaviate、Pinecone 與 MongoDB Atlas Vector Search。所有後端都經由底層框架的原生連接器寫入,因此檔案的編輯與刪除會轉換為實際的更新與刪除操作,而不是僅新增版本。DuckDB 是預設選項,以單一的本機檔案提供內建向量搜尋,不需要另外安裝或執行外部服務,適合筆電與展示情境。
Pinecone 是清單中唯一的例外。由於該服務無法列舉已儲存的向量,專案在其上不提供程序內混合檢索,設定啟用時會在啟動階段直接失敗並提示原因,官方說明伺服器端的原生稀疏索引支援仍在規劃中。這項限制對需要關鍵字與向量混合檢索的語料而言,屬於選擇後端時必須先確認的條件。
資料來源同樣以連接器方式擴充。除了本機檔案系統,還包含 Google Drive、S3 或 MinIO 與 SharePoint,並可透過 PyFilesystem 開啟 FTP、SFTP、WebDAV 甚至壓縮檔。多種來源可以在同一份設定中混用,且都受到即時監看,檔案變動後數秒內即可被檢索。
多模態與檢索品質方面有什麼設計?
所有格式預設啟用,PDF、Office 與掃描影像使用本機解析器,音訊與影片在具備金鑰時啟用。檢索端提供混合檢索、重排序、自適應檢索與查詢分解等策略。
解析器的選擇以不需金鑰為優先。文字與 Markdown 直接讀取,PDF 內建 pypdf,需要版面與表格理解時可改裝 Docling;Office 格式由 Unstructured 處理,掃描影像使用 PaddleOCR。這些路徑完全在本機執行,不產生 API 費用。音訊在具備 OpenAI 金鑰時交由 Whisper 轉錄,影片則在具備 TwelveLabs 金鑰時產生可檢索的文字描述,昂貴的解析結果會快取於磁碟,重啟不需重算。
檢索與回答預設為純向量模式,另有五種以設定行數啟用的強化策略。混合檢索把向量相似度與程序內的 BM25 關鍵字索引以倒數排名融合,對含人名、日期與識別碼的語料特別有效;重排序以本機的交叉編碼器或語言模型對候選段落重新評分;自適應檢索會在模型回報資訊不足時擴大上下文並重新提問;查詢分解會把多跳問題拆成子查詢分別檢索;MMR 則在相關性與重複度之間取得平衡。
另有一類設計處理針對文件的提問。例如詢問文件總數、某份檔案的內容,或兩個版本之間的差異,這些問題無法由段落檢索回答,專案改以文件目錄與整份檔案因應:指名檔案的提問會直接導向該檔案,版本比較則由伺服器計算行級差異,讓模型只讀取變動部分。
RAG 常見的資料同步痛點如何被解決?
傳統做法需人工重建索引,容易停在舊版本。serviette 以增量計算處理變動,檔案增刪改會經原生連接器反映到向量庫,數秒內可被引用。
多數 RAG 系統的失效點並非模型能力,而是索引與實際文件之間的落差。當文件更新而索引未同步,系統會以過期內容作答,而修補方式通常是重新執行整批嵌入流程。serviette 把這一步交給底層的差異化資料流計算:文件在管線中流動而非累積,只有變動的部分被重新處理,因此大型語料在記憶體中的占用不會隨總量線性膨脹。
監看機制保留了每個受監看檔案的詮釋資料,用於偵測編輯與刪除,其成本取決於檔案數量而非內容長度。官方基準測試以約 361 位元組作為每個檔案的估算斜率,並註明該數字取自連接器 worker 的額外私有記憶體,屬於近似值而非隔離量測。對於動輒數百萬檔案的語料,這項成本需要納入容量規劃。
可觀察性也围绕同步狀態設計。聊天介面標題會顯示索引最後寫入距今的時間,編輯來源文件時可以直接看到計數器歸零重算;API 端提供統計端點回報後端類型、已索引段落數與新鮮度;引擎另可透過設定啟用 Prometheus 指標,輸出各 worker 的輸入輸出延遲與運算子列數。
serviette 與同類 RAG 框架有何分別?
多數框架要求以程式碼組裝檢索鏈,或透過視覺化流程編排代理;serviette 以設定檔取代程式碼,重心放在資料同步,定位偏向文件問答服務。
市面上常見的路線有三類。第一類是以程式庫形式提供元件的框架,使用者以程式碼串接載入器、切分器、向量庫與檢索鏈,彈性最大但需要自行維護同步邏輯;第二類是以視覺化流程編排為主的平台,適合建立多步驟代理與工作流程;第三類是強調文件理解與版面解析的系統,處理複雜 PDF 與表格的能力較強。
serviette 的取向介於其中,它不尝试成為通用編排平台,而是把設定、解析、同步與服務固定成受支援的路徑,讓使用者以一份設定檔描述需求。這種設計降低了起步門檻,代價是自訂空間相對受限,例如專案明確指出解析、切分與嵌入器一律沿用底層框架的實作,本身不另行實作。
功能邊界亦需一併理解。專案說明目前一次回答一個問題,且以文件當下狀態為準;對話記憶、使用者帳號與託管服務均尚未內建。對於需要多輪對話脈絡或多人權限管理的場景,這些能力需要自行在外部補上,或選擇其他方案。
它的技術數據與授權條款是什麼?
專案以 Python 撰寫,累積 58,791 顆星標、1,511 次複製、24 位貢獻者與 258 次提交,採 MIT 授權,最新標籤為 v0.1.8,最近推送在 2026 年 10 月。
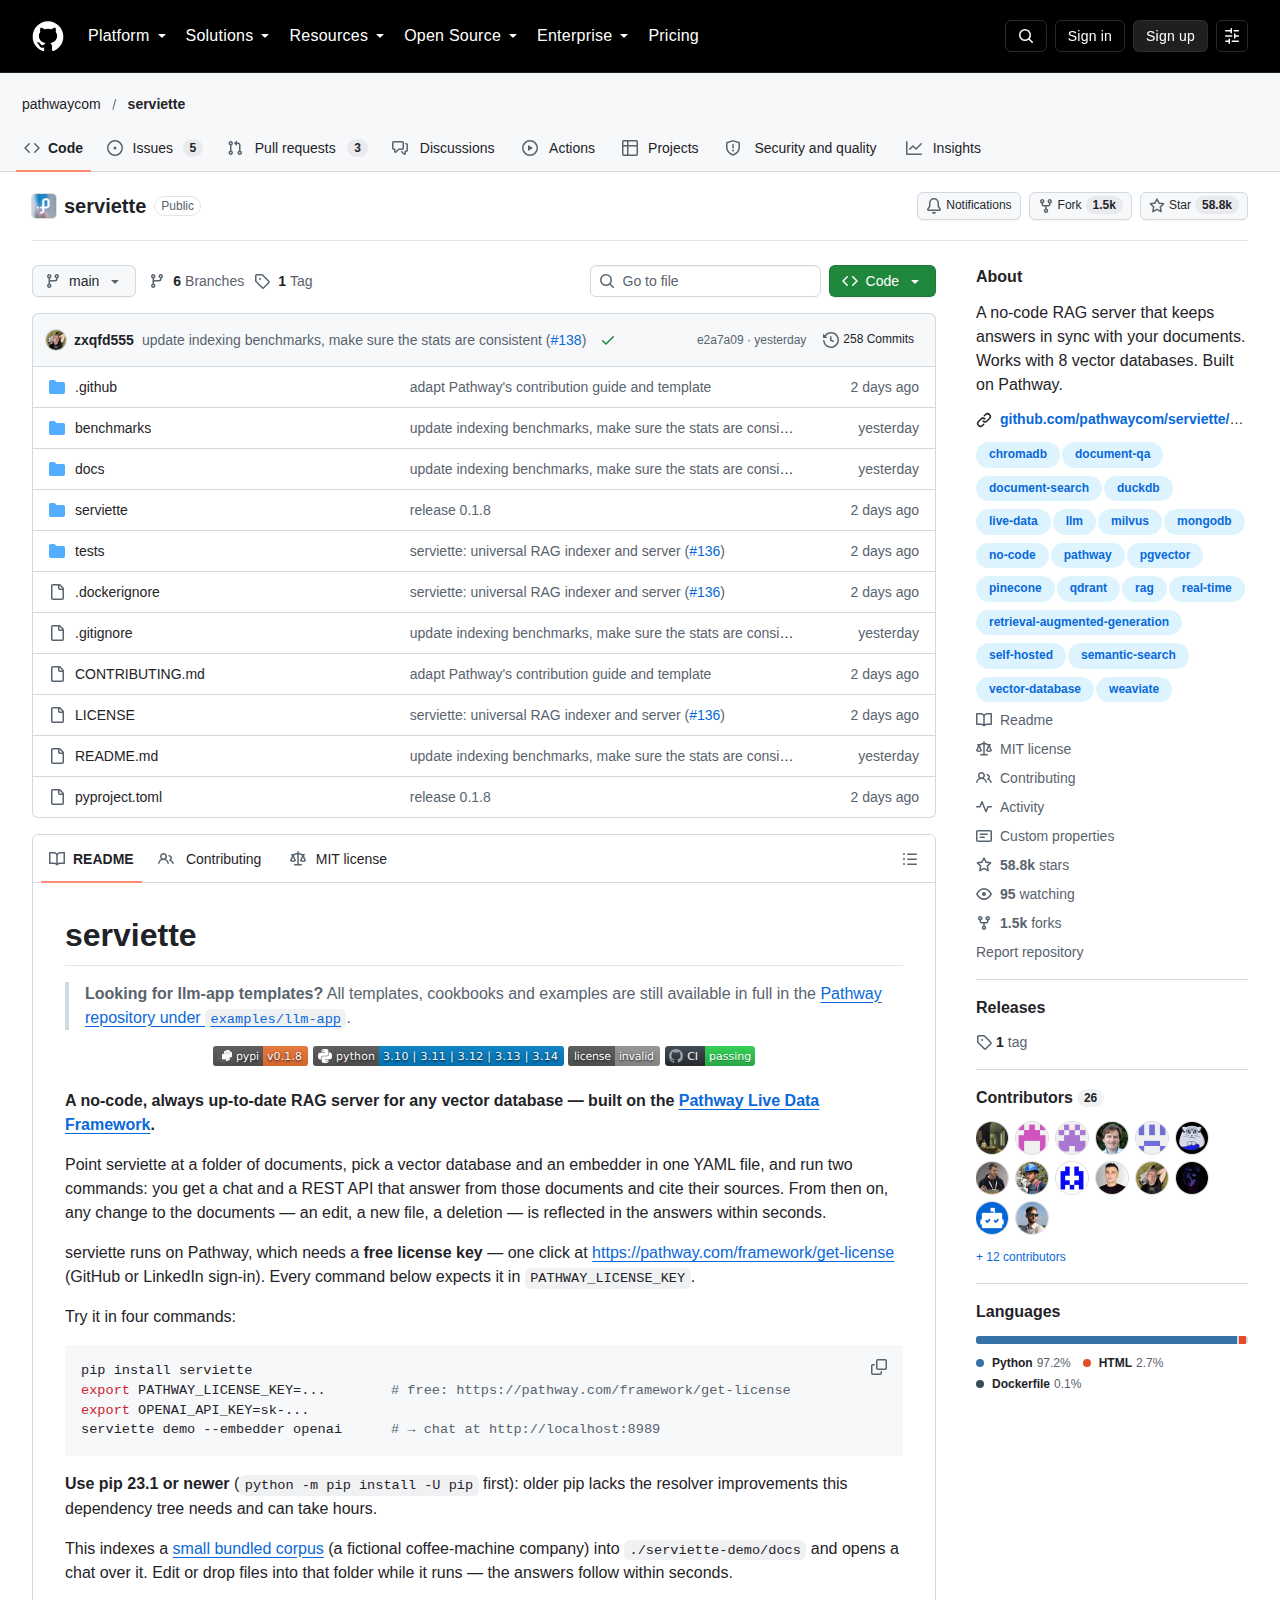
程式語言組成以 Python 為主,約 78.7 萬位元組,另有 HTML 與 Dockerfile 少量內容。專案累積 258 次提交、24 位貢獻者與 8 個未結議題,設有 20 個主題標籤涵蓋向量資料庫、檢索增強生成與自我託管等關鍵詞。
索引效能的量測結果以語料規模呈現。在八個 worker、程序內本機嵌入與 Qdrant 的設定下,50 GB 純文字語料(約 2,621 萬頁、1,708 萬個檔案)的索引時間為 6.0 小時,峰值記憶體 14.65 GiB,向量庫占用 84.45 GiB;對照 100 MB 語料的 44 秒與 6.86 GiB,輸入目標放大 500 倍的峰值記憶體成長約 2.1 倍。專案同時註明這些數字來自六次執行、以容器內索引器的取樣峰值計算,未涵蓋向量庫與伺服器本身的記憶體。
檢索品質則以 FRAMES 基準評估,該基準包含 824 道需從 2 至 15 篇維基百科文章彙整答案的多跳問題。專案報告的黃金文章召回率為 0.50,高於論文中 BM25 基線公布的 0.15;在相同模型與評分程序下,加入 serviette 檢索後正確率提升 5.2 個百分點,自適應檢索在受限情境下把準確率由 41.3% 推升到 52.8%。作者亦說明絕對分數受 2026 年生成模型本身的無檢索基線影響,因此主指標採用成對差距。
如何快速開始使用 serviette?
安裝後可執行示範指令體驗完整流程,或以精靈產生設定檔再用 up 指令啟動索引器與伺服器。介面與 API 預設在 8989 埠,執行前需設定免費授權金鑰。
起步路徑有兩條:直接以套件安裝並執行示範,或複製儲存庫後建立虛擬環境。示範會把語料放進專案目錄下可見的工作資料夾,內容為虛構咖啡機公司的少量文件,使用者可以在執行期間把自有檔案放入同一資料夾,數秒後即可提問。
pip install serviette
export PATHWAY_LICENSE_KEY=...        # 免費授權:https://pathway.com/framework/get-license
export OPENAI_API_KEY=sk-...          # 省略時改以引述檢索段落作答
serviette demo --embedder openai      # 聊天介面:http://localhost:8989
正式環境的流程是先產生設定檔再啟動服務。精靈會詢問資料來源、向量後端與嵌入器,輸出成一份 YAML;serviette up 會同時監督索引器與伺服器,生產環境則建議改為分別執行兩個指令。伺服器在同一個埠上提供網頁聊天介面與版本化的 REST API,檢索端點可直接以 POST 呼叫。
嵌入器的選擇影響安裝體積與費用。使用 OpenAI 或 Gemini 等 API 嵌入器時安裝最輕,但每個被索引的字符都會計費;改用程序內的本機嵌入器則需要安裝 PyTorch,指定 CPU 版本約 0.8 GB,未指定時 Linux 預設會拉入含 CUDA 函式庫的版本,約 5 GB。本機路線在語料規模放大後不再產生嵌入費用,官方建議大型語料優先採用。
使用時有哪些限制與注意事項?
伺服器預設只監聽本機且沒有內建身分驗證,對外開放需自行加上驗證用的反向代理。執行需要免費的 Pathway 授權金鑰,且目前不支援對話記憶、使用者帳號與託管服務。
安全性方面的預設值偏保守,但也意味著使用者必須自行處理暴露問題。伺服器僅在本機介面監聽,專案不含任何內建的認證機制;若要對外提供服務,需把監聽位址改為全域並在前方加上具備認證能力的反向代理,官方文件提供五行的 Caddy 設定範例。
授權與環境條件同樣需要先行確認。執行時必須在環境變數中提供 Pathway 的免費授權金鑰,該金鑰可在官網以一鍵方式取得;Python 版本要求 3.10 以上,官方建議使用 3.12。部分後端與模態需要額外套件或金鑰,例如 OCR 需安裝對應擴充,影片解析需 TwelveLabs 金鑰。缺乏金鑰的模態會被跳過並顯示警告,而非中斷整個流程。
功能邊界則影響導入範圍的評估。專案現階段一次回答一個問題,沒有對話記憶、使用者帳號與官方託管版本;官方說明這些能力與現有架構的距離不遠,但目前仍需由使用者在外部實作,或直接聯絡維護團隊洽談客製方案。
出處連結有哪些?
本文資訊整理自 serviette 的 GitHub 儲存庫、官方文件與專案內公布的基準測試報告,完整設定說明、量測方法與限制條件可由下列來源查證。
官方儲存庫位於 https://github.com/pathwaycom/serviette,內含完整設定說明、貢獻指南與整合測試。底層框架 Pathway 位於 https://github.com/pathwaycom/pathway,授權金鑰申請頁面為 https://pathway.com/framework/get-license。索引資源基準測試見 https://github.com/pathwaycom/serviette/tree/main/benchmarks/realtime-data-indexing,FRAMES 檢索品質報告見 https://github.com/pathwaycom/serviette/blob/main/benchmarks/frames/REPORT.md,評測資料集論文見 https://arxiv.org/abs/2409.12941。
常見問題有哪些?
常見疑問集中在三處:與底層框架 Pathway 的分工、文件是否需要上傳到雲端,以及免費授權金鑰的用途,以下逐項說明。
serviette 與 Pathway 之間的分工是什麼?
serviette 是設定與服務層,負責解析路由、檢索策略與 API 服務;Pathway 是底層的即時資料框架,負責監看來源、解析檔案、計算嵌入與寫入向量資料庫。專案說明其解析器、切分器與嵌入器一律沿用 Pathway 的 LLM 擴充套件,本身不另行實作,因此前者的功能與後者的版本推進直接相關。
使用 serviette 時文件需要上傳到雲端嗎?
不需要。在預設的本機嵌入器設定下,文件、其向量與索引都留在本機或使用者選擇的資料庫中,唯一的對外傳輸是為了回答問題而檢索出的少數段落,而這僅在設定外部模型 API 時發生。若改用 API 嵌入器,文件內容會一併經由該 API 處理,資料流向因此改變。
免費的 Pathway 授權金鑰有什麼用途?
金鑰用於執行底層的資料流引擎,缺少時服務無法啟動。取得方式是透過 GitHub 或 LinkedIn 登入後一鍵申請,本身不收費;專案說明唯一的計量成本來自可選的模型 API,且以問題數而非文件量計費。若要完全避免費用,可搭配本機嵌入器與不需金鑰的解析器運行。
總結:serviette 適合什麼團隊?
適合需要讓問答系統緊跟內部文件變動、且偏好自行維運與掌握資料位置的團隊;若需求包含對話記憶、多人權限或代管服務,現階段仍須自行補上或另尋方案。
此專案把 RAG 的主要風險重新定位。多數同類工具強調檢索鏈的組裝彈性,serviette 選擇以設定檔固定路徑,並把工程重心放在資料同步與程序分離上。八種向量後端、四類資料來源與本機優先的解析器,讓它在既有基礎架構中的落點相對靈活;索引器與伺服器的解耦,則讓擴展與故障隔離成為架構預設而非額外工程。
採用前需要確認三項條件。資料層面要接受向量存放於自有儲存並可被其他工具讀取,同時理解 DuckDB 後端的單一寫入者限制;功能層面要確認對話記憶與權限管理不在現有範圍內,需自行在外部補齊;維運層面則要為免費授權金鑰、Python 版本與對外暴露時的認證代理預作安排。
就維護狀況而言,專案由 Pathway 團隊持續推進,最近一次推送為 2026 年 10 月,並公布可重現的索引與檢索量測方法及限制說明。對於文件會持續變動、又希望自行掌握資料流向的組織,它提供了一條設定驅動且可稽核的導入路徑,但功能邊界與後端限制仍需在評估階段逐一確認。
